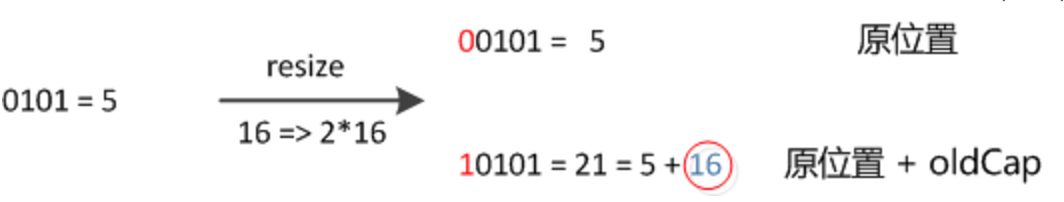<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>Everything Will Work Out Just Fine</title>
  
  <subtitle>later equals never</subtitle>
  <link href="/atom.xml" rel="self"/>
  
  <link href="https://zrbac.github.io/"/>
  <updated>2020-09-25T01:50:04.826Z</updated>
  <id>https://zrbac.github.io/</id>
  
  <author>
    <name>ZrBac</name>
    
  </author>
  
  <generator uri="https://hexo.io/">Hexo</generator>
  
  <entry>
    <title>Java-8-HashMap</title>
    <link href="https://zrbac.github.io/2020/09/25/Java-8-HashMap/"/>
    <id>https://zrbac.github.io/2020/09/25/Java-8-HashMap/</id>
    <published>2020-09-25T01:49:16.000Z</published>
    <updated>2020-09-25T01:50:04.826Z</updated>
    
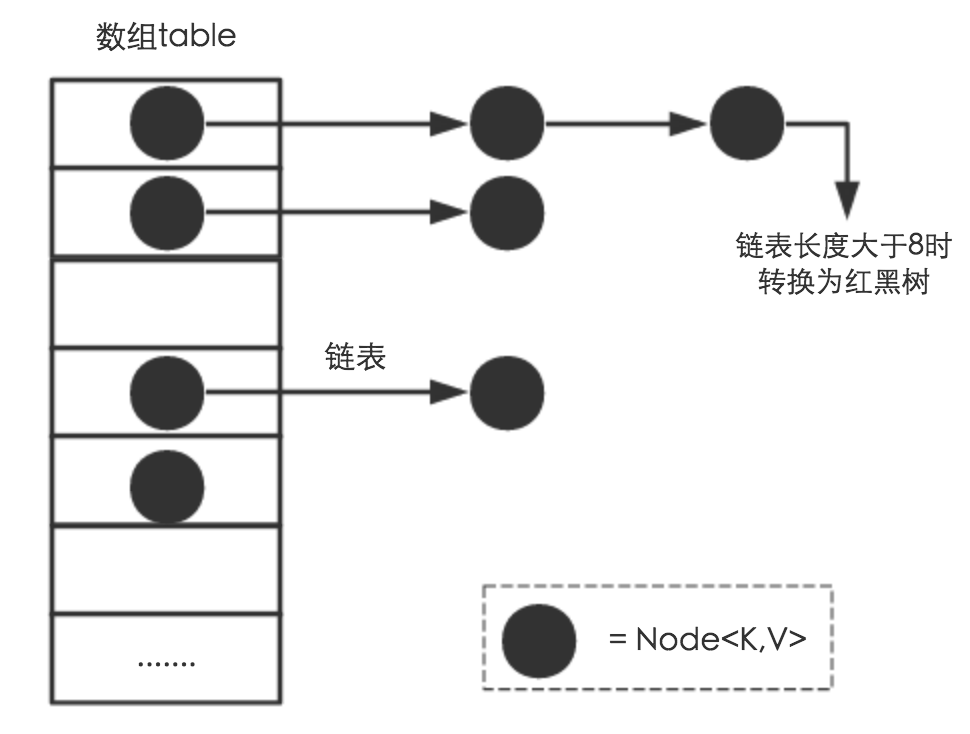
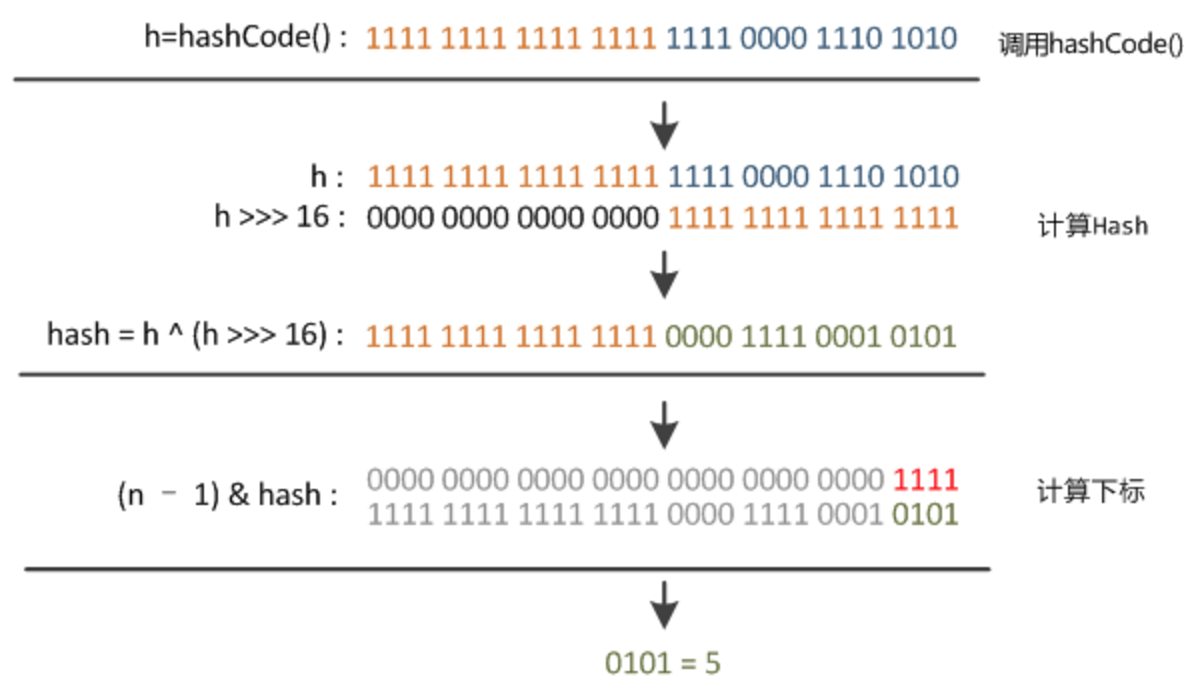
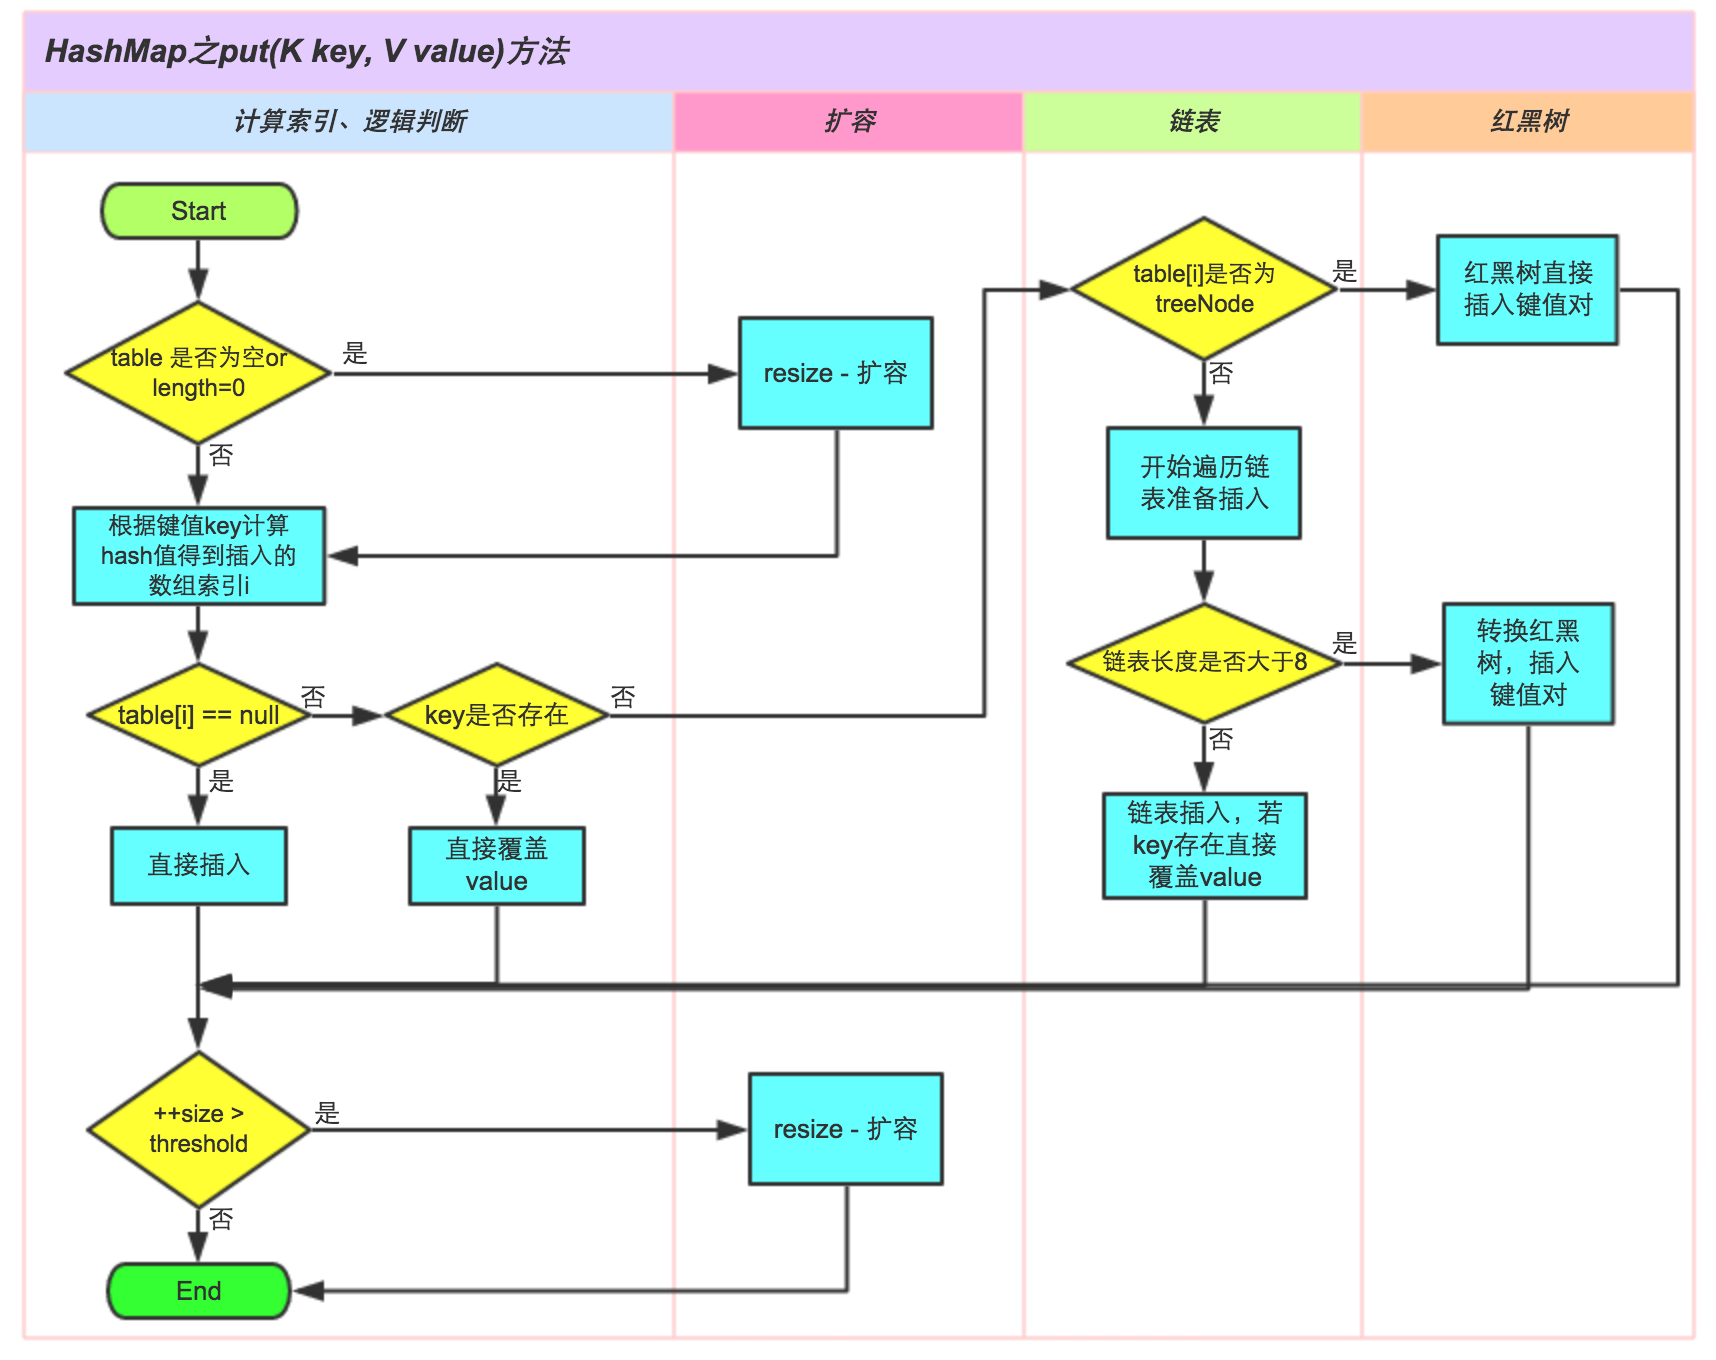
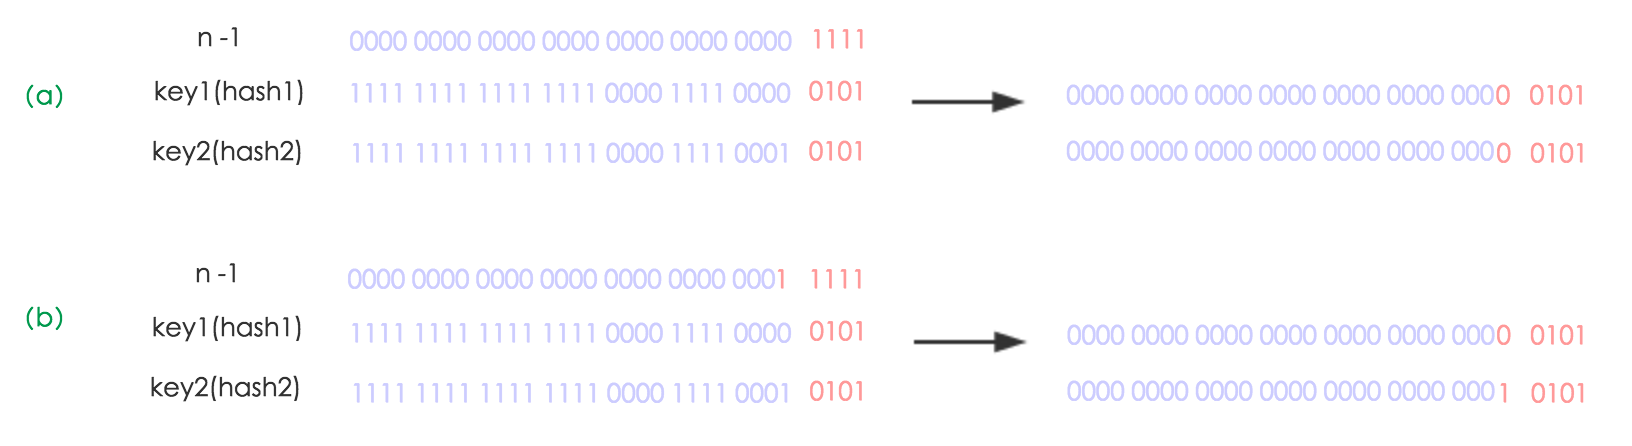
    <content type="html"><![CDATA[<h1 id="Java-8系列之重新认识HashMap"><a href="#Java-8系列之重新认识HashMap" class="headerlink" title="Java 8系列之重新认识HashMap"></a><a href="https://tech.meituan.com/2016/06/24/java-hashmap.html" target="_blank" rel="noopener">Java 8系列之重新认识HashMap</a></h1><p>HashMap是Java程序员使用频率最高的用于映射(键值对)处理的数据类型。随着JDK（Java Developmet Kit）版本的更新，JDK1.8对HashMap底层的实现进行了优化，例如引入红黑树的数据结构和扩容的优化等。本文结合JDK1.7和JDK1.8的区别，深入探讨HashMap的结构实现和功能原理。</p><p>Java为数据结构中的映射定义了一个接口java.util.Map，此接口主要有四个常用的实现类，分别是HashMap、Hashtable、LinkedHashMap和TreeMap，类继承关系如下图所示：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/f7fe16a2.png" alt="img"></p><a id="more"></a><p>下面针对各个实现类的特点做一些说明：</p><p>(1) HashMap：它根据键的hashCode值存储数据，大多数情况下可以直接定位到它的值，因而具有很快的访问速度，但遍历顺序却是不确定的。 HashMap最多只允许一条记录的键为null，允许多条记录的值为null。HashMap非线程安全，即任一时刻可以有多个线程同时写HashMap，可能会导致数据的不一致。如果需要满足线程安全，可以用 Collections的synchronizedMap方法使HashMap具有线程安全的能力，或者使用ConcurrentHashMap。</p><p>(2) Hashtable：Hashtable是遗留类，很多映射的常用功能与HashMap类似，不同的是它承自Dictionary类，并且是线程安全的，任一时间只有一个线程能写Hashtable，并发性不如ConcurrentHashMap，因为ConcurrentHashMap引入了分段锁。Hashtable不建议在新代码中使用，不需要线程安全的场合可以用HashMap替换，需要线程安全的场合可以用ConcurrentHashMap替换。</p><p>(3) LinkedHashMap：LinkedHashMap是HashMap的一个子类，保存了记录的插入顺序，在用Iterator遍历LinkedHashMap时，先得到的记录肯定是先插入的，也可以在构造时带参数，按照访问次序排序。</p><p>(4) TreeMap：TreeMap实现SortedMap接口，能够把它保存的记录根据键排序，默认是按键值的升序排序，也可以指定排序的比较器，当用Iterator遍历TreeMap时，得到的记录是排过序的。如果使用排序的映射，建议使用TreeMap。在使用TreeMap时，key必须实现Comparable接口或者在构造TreeMap传入自定义的Comparator，否则会在运行时抛出java.lang.ClassCastException类型的异常。</p><p>对于上述四种Map类型的类，要求映射中的key是不可变对象。不可变对象是该对象在创建后它的哈希值不会被改变。如果对象的哈希值发生变化，Map对象很可能就定位不到映射的位置了。</p><p>通过上面的比较，我们知道了HashMap是Java的Map家族中一个普通成员，鉴于它可以满足大多数场景的使用条件，所以是使用频度最高的一个。下文我们主要结合源码，从存储结构、常用方法分析、扩容以及安全性等方面深入讲解HashMap的工作原理。</p><p>搞清楚HashMap，首先需要知道HashMap是什么，即它的存储结构-字段；其次弄明白它能干什么，即它的功能实现-方法。下面我们针对这两个方面详细展开讲解。</p><h2 id="存储结构-字段"><a href="#存储结构-字段" class="headerlink" title="存储结构-字段"></a>存储结构-字段</h2><p>从结构实现来讲，HashMap是数组+链表+红黑树（JDK1.8增加了红黑树部分）实现的，如下如所示。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/e4a19398.png" alt></p><p>这里需要讲明白两个问题：数据底层具体存储的是什么？这样的存储方式有什么优点呢？</p><p>(1) 从源码可知，HashMap类中有一个非常重要的字段，就是 Node[] table，即哈希桶数组，明显它是一个Node的数组。我们来看Node[JDK1.8]是何物。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">static</span> <span class="class"><span class="keyword">class</span> <span class="title">Node</span>&lt;<span class="title">K</span>,<span class="title">V</span>&gt; <span class="keyword">implements</span> <span class="title">Map</span>.<span class="title">Entry</span>&lt;<span class="title">K</span>,<span class="title">V</span>&gt; </span>&#123;</span><br><span class="line">        <span class="keyword">final</span> <span class="keyword">int</span> hash;    <span class="comment">//用来定位数组索引位置</span></span><br><span class="line">        <span class="keyword">final</span> K key;</span><br><span class="line">        V value;</span><br><span class="line">        Node&lt;K,V&gt; next;   <span class="comment">//链表的下一个node</span></span><br><span class="line"></span><br><span class="line">        Node(<span class="keyword">int</span> hash, K key, V value, Node&lt;K,V&gt; next) &#123; ... &#125;</span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> K <span class="title">getKey</span><span class="params">()</span></span>&#123; ... &#125;</span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> V <span class="title">getValue</span><span class="params">()</span> </span>&#123; ... &#125;</span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> String <span class="title">toString</span><span class="params">()</span> </span>&#123; ... &#125;</span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">int</span> <span class="title">hashCode</span><span class="params">()</span> </span>&#123; ... &#125;</span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> V <span class="title">setValue</span><span class="params">(V newValue)</span> </span>&#123; ... &#125;</span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">equals</span><span class="params">(Object o)</span> </span>&#123; ... &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>Node是HashMap的一个内部类，实现了Map.Entry接口，本质是就是一个映射(键值对)。上图中的每个黑色圆点就是一个Node对象。</p><p>(2) HashMap就是使用哈希表来存储的。哈希表为解决冲突，可以采用开放地址法和链地址法等来解决问题，Java中HashMap采用了链地址法。链地址法，简单来说，就是数组加链表的结合。在每个数组元素上都一个链表结构，当数据被Hash后，得到数组下标，把数据放在对应下标元素的链表上。例如程序执行下面代码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">map.put(<span class="string">"美团"</span>,<span class="string">"小美"</span>);</span><br></pre></td></tr></table></figure><p>系统将调用”美团”这个key的hashCode()方法得到其hashCode 值（该方法适用于每个Java对象），然后再通过Hash算法的后两步运算（高位运算和取模运算，下文有介绍）来定位该键值对的存储位置，有时两个key会定位到相同的位置，表示发生了Hash碰撞。当然Hash算法计算结果越分散均匀，Hash碰撞的概率就越小，map的存取效率就会越高。</p><p>如果哈希桶数组很大，即使较差的Hash算法也会比较分散，如果哈希桶数组数组很小，即使好的Hash算法也会出现较多碰撞，所以就需要在空间成本和时间成本之间权衡，其实就是在根据实际情况确定哈希桶数组的大小，并在此基础上设计好的hash算法减少Hash碰撞。那么通过什么方式来控制map使得Hash碰撞的概率又小，哈希桶数组（Node[] table）占用空间又少呢？答案就是好的Hash算法和扩容机制。</p><p>在理解Hash和扩容流程之前，我们得先了解下HashMap的几个字段。从HashMap的默认构造函数源码可知，构造函数就是对下面几个字段进行初始化，源码如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">int</span> threshold;             <span class="comment">// 所能容纳的key-value对极限 </span></span><br><span class="line"><span class="keyword">final</span> <span class="keyword">float</span> loadFactor;    <span class="comment">// 负载因子</span></span><br><span class="line"><span class="keyword">int</span> modCount;  </span><br><span class="line"><span class="keyword">int</span> size;</span><br></pre></td></tr></table></figure><p>首先，Node[] table的初始化长度length(默认值是16)，Load factor为负载因子(默认值是0.75)，threshold是HashMap所能容纳的最大数据量的Node(键值对)个数。threshold = length * Load factor。也就是说，在数组定义好长度之后，负载因子越大，所能容纳的键值对个数越多。</p><p>结合负载因子的定义公式可知，threshold就是在此Load factor和length(数组长度)对应下允许的最大元素数目，超过这个数目就重新resize(扩容)，扩容后的HashMap容量是之前容量的两倍。默认的负载因子0.75是对空间和时间效率的一个平衡选择，建议大家不要修改，除非在时间和空间比较特殊的情况下，如果内存空间很多而又对时间效率要求很高，可以降低负载因子Load factor的值；相反，如果内存空间紧张而对时间效率要求不高，可以增加负载因子loadFactor的值，这个值可以大于1。</p><p>size这个字段其实很好理解，就是HashMap中实际存在的键值对数量。注意和table的长度length、容纳最大键值对数量threshold的区别。而modCount字段主要用来记录HashMap内部结构发生变化的次数，主要用于迭代的快速失败。强调一点，内部结构发生变化指的是结构发生变化，例如put新键值对，但是某个key对应的value值被覆盖不属于结构变化。</p><p>在HashMap中，哈希桶数组table的长度length大小必须为2的n次方(一定是合数)，这是一种非常规的设计，常规的设计是把桶的大小设计为素数。相对来说素数导致冲突的概率要小于合数，具体证明可以参考<a href="http://blog.csdn.net/liuqiyao_01/article/details/14475159，Hashtable初始化桶大小为11，就是桶大小设计为素数的应用（Hashtable扩容后不能保证还是素数）。HashMap采用这种非常规设计，主要是为了在取模和扩容时做优化，同时为了减少冲突，HashMap定位哈希桶索引位置时，也加入了高位参与运算的过程。" target="_blank" rel="noopener">http://blog.csdn.net/liuqiyao_01/article/details/14475159，Hashtable初始化桶大小为11，就是桶大小设计为素数的应用（Hashtable扩容后不能保证还是素数）。HashMap采用这种非常规设计，主要是为了在取模和扩容时做优化，同时为了减少冲突，HashMap定位哈希桶索引位置时，也加入了高位参与运算的过程。</a></p><p>这里存在一个问题，即使负载因子和Hash算法设计的再合理，也免不了会出现拉链过长的情况，一旦出现拉链过长，则会严重影响HashMap的性能。于是，在JDK1.8版本中，对数据结构做了进一步的优化，引入了红黑树。而当链表长度太长（默认超过8）时，链表就转换为红黑树，利用红黑树快速增删改查的特点提高HashMap的性能，其中会用到红黑树的插入、删除、查找等算法。本文不再对红黑树展开讨论，想了解更多红黑树数据结构的工作原理可以参考<a href="http://blog.csdn.net/v_july_v/article/details/6105630。" target="_blank" rel="noopener">http://blog.csdn.net/v_july_v/article/details/6105630。</a></p><h2 id="功能实现-方法"><a href="#功能实现-方法" class="headerlink" title="功能实现-方法"></a>功能实现-方法</h2><p>HashMap的内部功能实现很多，本文主要从根据key获取哈希桶数组索引位置、put方法的详细执行、扩容过程三个具有代表性的点深入展开讲解。</p><h3 id="1-确定哈希桶数组索引位置"><a href="#1-确定哈希桶数组索引位置" class="headerlink" title="1. 确定哈希桶数组索引位置"></a>1. 确定哈希桶数组索引位置</h3><p>不管增加、删除、查找键值对，定位到哈希桶数组的位置都是很关键的第一步。前面说过HashMap的数据结构是数组和链表的结合，所以我们当然希望这个HashMap里面的元素位置尽量分布均匀些，尽量使得每个位置上的元素数量只有一个，那么当我们用hash算法求得这个位置的时候，马上就可以知道对应位置的元素就是我们要的，不用遍历链表，大大优化了查询的效率。HashMap定位数组索引位置，直接决定了hash方法的离散性能。先看看源码的实现(方法一+方法二):</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line">方法一：</span><br><span class="line"><span class="function"><span class="keyword">static</span> <span class="keyword">final</span> <span class="keyword">int</span> <span class="title">hash</span><span class="params">(Object key)</span> </span>&#123;   <span class="comment">//jdk1.8 &amp; jdk1.7</span></span><br><span class="line">     <span class="keyword">int</span> h;</span><br><span class="line">     <span class="comment">// h = key.hashCode() 为第一步 取hashCode值</span></span><br><span class="line">     <span class="comment">// h ^ (h &gt;&gt;&gt; 16)  为第二步 高位参与运算</span></span><br><span class="line">     <span class="keyword">return</span> (key == <span class="keyword">null</span>) ? <span class="number">0</span> : (h = key.hashCode()) ^ (h &gt;&gt;&gt; <span class="number">16</span>);</span><br><span class="line">&#125;</span><br><span class="line">方法二：</span><br><span class="line"><span class="function"><span class="keyword">static</span> <span class="keyword">int</span> <span class="title">indexFor</span><span class="params">(<span class="keyword">int</span> h, <span class="keyword">int</span> length)</span> </span>&#123;  <span class="comment">//jdk1.7的源码，jdk1.8没有这个方法，但是实现原理一样的</span></span><br><span class="line">     <span class="keyword">return</span> h &amp; (length-<span class="number">1</span>);  <span class="comment">//第三步 取模运算</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这里的Hash算法本质上就是三步：<strong>取key的hashCode值、高位运算、取模运算</strong>。</p><p>对于任意给定的对象，只要它的hashCode()返回值相同，那么程序调用方法一所计算得到的Hash码值总是相同的。我们首先想到的就是把hash值对数组长度取模运算，这样一来，元素的分布相对来说是比较均匀的。但是，模运算的消耗还是比较大的，在HashMap中是这样做的：调用方法二来计算该对象应该保存在table数组的哪个索引处。</p><p>这个方法非常巧妙，它通过h &amp; (table.length -1)来得到该对象的保存位，而HashMap底层数组的长度总是2的n次方，这是HashMap在速度上的优化。当length总是2的n次方时，h&amp; (length-1)运算等价于对length取模，也就是h%length，但是&amp;比%具有更高的效率。</p><p>在JDK1.8的实现中，优化了高位运算的算法，通过hashCode()的高16位异或低16位实现的：(h = k.hashCode()) ^ (h &gt;&gt;&gt; 16)，主要是从速度、功效、质量来考虑的，这么做可以在数组table的length比较小的时候，也能保证考虑到高低Bit都参与到Hash的计算中，同时不会有太大的开销。</p><p>下面举例说明下，n为table的长度。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/45205ec2.png" alt></p><h3 id="2-分析HashMap的put方法"><a href="#2-分析HashMap的put方法" class="headerlink" title="2. 分析HashMap的put方法"></a>2. 分析HashMap的put方法</h3><p>HashMap的put方法执行过程可以通过下图来理解，自己有兴趣可以去对比源码更清楚地研究学习。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/d669d29c.png" alt></p><p>①.判断键值对数组table[i]是否为空或为null，否则执行resize()进行扩容；</p><p>②.根据键值key计算hash值得到插入的数组索引i，如果table[i]==null，直接新建节点添加，转向⑥，如果table[i]不为空，转向③；</p><p>③.判断table[i]的首个元素是否和key一样，如果相同直接覆盖value，否则转向④，这里的相同指的是hashCode以及equals；</p><p>④.判断table[i] 是否为treeNode，即table[i] 是否是红黑树，如果是红黑树，则直接在树中插入键值对，否则转向⑤；</p><p>⑤.遍历table[i]，判断链表长度是否大于8，大于8的话把链表转换为红黑树，在红黑树中执行插入操作，否则进行链表的插入操作；遍历过程中若发现key已经存在直接覆盖value即可；</p><p>⑥.插入成功后，判断实际存在的键值对数量size是否超多了最大容量threshold，如果超过，进行扩容。</p><p>JDK1.8HashMap的put方法源码如下:</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br></pre></td><td class="code"><pre><span class="line"> <span class="number">1</span> <span class="function"><span class="keyword">public</span> V <span class="title">put</span><span class="params">(K key, V value)</span> </span>&#123;</span><br><span class="line"> <span class="number">2</span>     <span class="comment">// 对key的hashCode()做hash</span></span><br><span class="line"> <span class="number">3</span>     <span class="keyword">return</span> putVal(hash(key), key, value, <span class="keyword">false</span>, <span class="keyword">true</span>);</span><br><span class="line"> <span class="number">4</span> &#125;</span><br><span class="line"> <span class="number">5</span> </span><br><span class="line"> <span class="number">6</span> <span class="function"><span class="keyword">final</span> V <span class="title">putVal</span><span class="params">(<span class="keyword">int</span> hash, K key, V value, <span class="keyword">boolean</span> onlyIfAbsent,</span></span></span><br><span class="line"><span class="function"><span class="params"> <span class="number">7</span>                <span class="keyword">boolean</span> evict)</span> </span>&#123;</span><br><span class="line"> <span class="number">8</span>     Node&lt;K,V&gt;[] tab; Node&lt;K,V&gt; p; <span class="keyword">int</span> n, i;</span><br><span class="line"> <span class="number">9</span>     <span class="comment">// 步骤①：tab为空则创建</span></span><br><span class="line"><span class="number">10</span>     <span class="keyword">if</span> ((tab = table) == <span class="keyword">null</span> || (n = tab.length) == <span class="number">0</span>)</span><br><span class="line"><span class="number">11</span>         n = (tab = resize()).length;</span><br><span class="line"><span class="number">12</span>     <span class="comment">// 步骤②：计算index，并对null做处理 </span></span><br><span class="line"><span class="number">13</span>     <span class="keyword">if</span> ((p = tab[i = (n - <span class="number">1</span>) &amp; hash]) == <span class="keyword">null</span>) </span><br><span class="line"><span class="number">14</span>         tab[i] = newNode(hash, key, value, <span class="keyword">null</span>);</span><br><span class="line"><span class="number">15</span>     <span class="keyword">else</span> &#123;</span><br><span class="line"><span class="number">16</span>         Node&lt;K,V&gt; e; K k;</span><br><span class="line"><span class="number">17</span>         <span class="comment">// 步骤③：节点key存在，直接覆盖value</span></span><br><span class="line"><span class="number">18</span>         <span class="keyword">if</span> (p.hash == hash &amp;&amp;</span><br><span class="line"><span class="number">19</span>             ((k = p.key) == key || (key != <span class="keyword">null</span> &amp;&amp; key.equals(k))))</span><br><span class="line"><span class="number">20</span>             e = p;</span><br><span class="line"><span class="number">21</span>         <span class="comment">// 步骤④：判断该链为红黑树</span></span><br><span class="line"><span class="number">22</span>         <span class="keyword">else</span> <span class="keyword">if</span> (p <span class="keyword">instanceof</span> TreeNode)</span><br><span class="line"><span class="number">23</span>             e = ((TreeNode&lt;K,V&gt;)p).putTreeVal(<span class="keyword">this</span>, tab, hash, key, value);</span><br><span class="line"><span class="number">24</span>         <span class="comment">// 步骤⑤：该链为链表</span></span><br><span class="line"><span class="number">25</span>         <span class="keyword">else</span> &#123;</span><br><span class="line"><span class="number">26</span>             <span class="keyword">for</span> (<span class="keyword">int</span> binCount = <span class="number">0</span>; ; ++binCount) &#123;</span><br><span class="line"><span class="number">27</span>                 <span class="keyword">if</span> ((e = p.next) == <span class="keyword">null</span>) &#123;</span><br><span class="line"><span class="number">28</span>                     p.next = newNode(hash, key,value,<span class="keyword">null</span>);</span><br><span class="line">                        <span class="comment">//链表长度大于8转换为红黑树进行处理</span></span><br><span class="line"><span class="number">29</span>                     <span class="keyword">if</span> (binCount &gt;= TREEIFY_THRESHOLD - <span class="number">1</span>) <span class="comment">// -1 for 1st  </span></span><br><span class="line"><span class="number">30</span>                         treeifyBin(tab, hash);</span><br><span class="line"><span class="number">31</span>                     <span class="keyword">break</span>;</span><br><span class="line"><span class="number">32</span>                 &#125;</span><br><span class="line">                    <span class="comment">// key已经存在直接覆盖value</span></span><br><span class="line"><span class="number">33</span>                 <span class="keyword">if</span> (e.hash == hash &amp;&amp;</span><br><span class="line"><span class="number">34</span>                     ((k = e.key) == key || (key != <span class="keyword">null</span> &amp;&amp; key.equals(k)))) </span><br><span class="line"><span class="number">35</span><span class="keyword">break</span>;</span><br><span class="line"><span class="number">36</span>                 p = e;</span><br><span class="line"><span class="number">37</span>             &#125;</span><br><span class="line"><span class="number">38</span>         &#125;</span><br><span class="line"><span class="number">39</span>         </span><br><span class="line"><span class="number">40</span>         <span class="keyword">if</span> (e != <span class="keyword">null</span>) &#123; <span class="comment">// existing mapping for key</span></span><br><span class="line"><span class="number">41</span>             V oldValue = e.value;</span><br><span class="line"><span class="number">42</span>             <span class="keyword">if</span> (!onlyIfAbsent || oldValue == <span class="keyword">null</span>)</span><br><span class="line"><span class="number">43</span>                 e.value = value;</span><br><span class="line"><span class="number">44</span>             afterNodeAccess(e);</span><br><span class="line"><span class="number">45</span>             <span class="keyword">return</span> oldValue;</span><br><span class="line"><span class="number">46</span>         &#125;</span><br><span class="line"><span class="number">47</span>     &#125;</span><br><span class="line"></span><br><span class="line"><span class="number">48</span>     ++modCount;</span><br><span class="line"><span class="number">49</span>     <span class="comment">// 步骤⑥：超过最大容量 就扩容</span></span><br><span class="line"><span class="number">50</span>     <span class="keyword">if</span> (++size &gt; threshold)</span><br><span class="line"><span class="number">51</span>         resize();</span><br><span class="line"><span class="number">52</span>     afterNodeInsertion(evict);</span><br><span class="line"><span class="number">53</span>     <span class="keyword">return</span> <span class="keyword">null</span>;</span><br><span class="line"><span class="number">54</span> &#125;</span><br></pre></td></tr></table></figure><h3 id="3-扩容机制"><a href="#3-扩容机制" class="headerlink" title="3. 扩容机制"></a>3. 扩容机制</h3><p>扩容(resize)就是重新计算容量，向HashMap对象里不停的添加元素，而HashMap对象内部的数组无法装载更多的元素时，对象就需要扩大数组的长度，以便能装入更多的元素。当然Java里的数组是无法自动扩容的，方法是使用一个新的数组代替已有的容量小的数组，就像我们用一个小桶装水，如果想装更多的水，就得换大水桶。</p><p>我们分析下resize的源码，鉴于JDK1.8融入了红黑树，较复杂，为了便于理解我们仍然使用JDK1.7的代码，好理解一些，本质上区别不大，具体区别后文再说。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"> <span class="number">1</span> <span class="function"><span class="keyword">void</span> <span class="title">resize</span><span class="params">(<span class="keyword">int</span> newCapacity)</span> </span>&#123;   <span class="comment">//传入新的容量</span></span><br><span class="line"> <span class="number">2</span>     Entry[] oldTable = table;    <span class="comment">//引用扩容前的Entry数组</span></span><br><span class="line"> <span class="number">3</span>     <span class="keyword">int</span> oldCapacity = oldTable.length;         </span><br><span class="line"> <span class="number">4</span>     <span class="keyword">if</span> (oldCapacity == MAXIMUM_CAPACITY) &#123;  <span class="comment">//扩容前的数组大小如果已经达到最大(2^30)了</span></span><br><span class="line"> <span class="number">5</span>         threshold = Integer.MAX_VALUE; <span class="comment">//修改阈值为int的最大值(2^31-1)，这样以后就不会扩容了</span></span><br><span class="line"> <span class="number">6</span>         <span class="keyword">return</span>;</span><br><span class="line"> <span class="number">7</span>     &#125;</span><br><span class="line"> <span class="number">8</span>  </span><br><span class="line"> <span class="number">9</span>     Entry[] newTable = <span class="keyword">new</span> Entry[newCapacity];  <span class="comment">//初始化一个新的Entry数组</span></span><br><span class="line"><span class="number">10</span>     transfer(newTable);                         <span class="comment">//！！将数据转移到新的Entry数组里</span></span><br><span class="line"><span class="number">11</span>     table = newTable;                           <span class="comment">//HashMap的table属性引用新的Entry数组</span></span><br><span class="line"><span class="number">12</span>     threshold = (<span class="keyword">int</span>)(newCapacity * loadFactor);<span class="comment">//修改阈值</span></span><br><span class="line"><span class="number">13</span> &#125;</span><br></pre></td></tr></table></figure><p>这里就是使用一个容量更大的数组来代替已有的容量小的数组，transfer()方法将原有Entry数组的元素拷贝到新的Entry数组里。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"> <span class="number">1</span> <span class="function"><span class="keyword">void</span> <span class="title">transfer</span><span class="params">(Entry[] newTable)</span> </span>&#123;</span><br><span class="line"> <span class="number">2</span>     Entry[] src = table;                   <span class="comment">//src引用了旧的Entry数组</span></span><br><span class="line"> <span class="number">3</span>     <span class="keyword">int</span> newCapacity = newTable.length;</span><br><span class="line"> <span class="number">4</span>     <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">0</span>; j &lt; src.length; j++) &#123; <span class="comment">//遍历旧的Entry数组</span></span><br><span class="line"> <span class="number">5</span>         Entry&lt;K,V&gt; e = src[j];             <span class="comment">//取得旧Entry数组的每个元素</span></span><br><span class="line"> <span class="number">6</span>         <span class="keyword">if</span> (e != <span class="keyword">null</span>) &#123;</span><br><span class="line"> <span class="number">7</span>             src[j] = <span class="keyword">null</span>;<span class="comment">//释放旧Entry数组的对象引用（for循环后，旧的Entry数组不再引用任何对象）</span></span><br><span class="line"> <span class="number">8</span>             <span class="keyword">do</span> &#123;</span><br><span class="line"> <span class="number">9</span>                 Entry&lt;K,V&gt; next = e.next;</span><br><span class="line"><span class="number">10</span>                 <span class="keyword">int</span> i = indexFor(e.hash, newCapacity); <span class="comment">//！！重新计算每个元素在数组中的位置</span></span><br><span class="line"><span class="number">11</span>                 e.next = newTable[i]; <span class="comment">//标记[1]</span></span><br><span class="line"><span class="number">12</span>                 newTable[i] = e;      <span class="comment">//将元素放在数组上</span></span><br><span class="line"><span class="number">13</span>                 e = next;             <span class="comment">//访问下一个Entry链上的元素</span></span><br><span class="line"><span class="number">14</span>             &#125; <span class="keyword">while</span> (e != <span class="keyword">null</span>);</span><br><span class="line"><span class="number">15</span>         &#125;</span><br><span class="line"><span class="number">16</span>     &#125;</span><br><span class="line"><span class="number">17</span> &#125;</span><br></pre></td></tr></table></figure><p>newTable[i]的引用赋给了e.next，也就是使用了单链表的头插入方式，同一位置上新元素总会被放在链表的头部位置；这样先放在一个索引上的元素终会被放到Entry链的尾部(如果发生了hash冲突的话），这一点和Jdk1.8有区别，下文详解。在旧数组中同一条Entry链上的元素，通过重新计算索引位置后，有可能被放到了新数组的不同位置上。</p><p>下面举个例子说明下扩容过程。假设了我们的hash算法就是简单的用key mod 一下表的大小（也就是数组的长度）。其中的哈希桶数组table的size=2， 所以key = 3、7、5，put顺序依次为 5、7、3。在mod 2以后都冲突在table[1]这里了。这里假设负载因子 loadFactor=1，即当键值对的实际大小size 大于 table的实际大小时进行扩容。接下来的三个步骤是哈希桶数组 resize成4，然后所有的Node重新rehash的过程。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/b2330062.png" alt></p><p>下面我们讲解下JDK1.8做了哪些优化。经过观测可以发现，我们使用的是2次幂的扩展(指长度扩为原来2倍)，所以，元素的位置要么是在原位置，要么是在原位置再移动2次幂的位置。看下图可以明白这句话的意思，n为table的长度，图（a）表示扩容前的key1和key2两种key确定索引位置的示例，图（b）表示扩容后key1和key2两种key确定索引位置的示例，其中hash1是key1对应的哈希与高位运算结果。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/4d8022db.png" alt></p><p>元素在重新计算hash之后，因为n变为2倍，那么n-1的mask范围在高位多1bit(红色)，因此新的index就会发生这样的变化：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/d773f86e.png" alt></p><p>因此，我们在扩充HashMap的时候，不需要像JDK1.7的实现那样重新计算hash，只需要看看原来的hash值新增的那个bit是1还是0就好了，是0的话索引没变，是1的话索引变成“原索引+oldCap”，可以看看下图为16扩充为32的resize示意图：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/3cc9813a.png" alt="img"></p><p>这个设计确实非常的巧妙，既省去了重新计算hash值的时间，而且同时，由于新增的1bit是0还是1可以认为是随机的，因此resize的过程，均匀的把之前的冲突的节点分散到新的bucket了。这一块就是JDK1.8新增的优化点。有一点注意区别，JDK1.7中rehash的时候，旧链表迁移新链表的时候，如果在新表的数组索引位置相同，则链表元素会倒置，但是从上图可以看出，JDK1.8不会倒置。有兴趣的同学可以研究下JDK1.8的resize源码，写的很赞，如下:</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br></pre></td><td class="code"><pre><span class="line"> <span class="number">1</span> <span class="keyword">final</span> Node&lt;K,V&gt;[] resize() &#123;</span><br><span class="line"> <span class="number">2</span>     Node&lt;K,V&gt;[] oldTab = table;</span><br><span class="line"> <span class="number">3</span>     <span class="keyword">int</span> oldCap = (oldTab == <span class="keyword">null</span>) ? <span class="number">0</span> : oldTab.length;</span><br><span class="line"> <span class="number">4</span>     <span class="keyword">int</span> oldThr = threshold;</span><br><span class="line"> <span class="number">5</span>     <span class="keyword">int</span> newCap, newThr = <span class="number">0</span>;</span><br><span class="line"> <span class="number">6</span>     <span class="keyword">if</span> (oldCap &gt; <span class="number">0</span>) &#123;</span><br><span class="line"> <span class="number">7</span>         <span class="comment">// 超过最大值就不再扩充了，就只好随你碰撞去吧</span></span><br><span class="line"> <span class="number">8</span>         <span class="keyword">if</span> (oldCap &gt;= MAXIMUM_CAPACITY) &#123;</span><br><span class="line"> <span class="number">9</span>             threshold = Integer.MAX_VALUE;</span><br><span class="line"><span class="number">10</span>             <span class="keyword">return</span> oldTab;</span><br><span class="line"><span class="number">11</span>         &#125;</span><br><span class="line"><span class="number">12</span>         <span class="comment">// 没超过最大值，就扩充为原来的2倍</span></span><br><span class="line"><span class="number">13</span>         <span class="keyword">else</span> <span class="keyword">if</span> ((newCap = oldCap &lt;&lt; <span class="number">1</span>) &lt; MAXIMUM_CAPACITY &amp;&amp;</span><br><span class="line"><span class="number">14</span>                  oldCap &gt;= DEFAULT_INITIAL_CAPACITY)</span><br><span class="line"><span class="number">15</span>             newThr = oldThr &lt;&lt; <span class="number">1</span>; <span class="comment">// double threshold</span></span><br><span class="line"><span class="number">16</span>     &#125;</span><br><span class="line"><span class="number">17</span>     <span class="keyword">else</span> <span class="keyword">if</span> (oldThr &gt; <span class="number">0</span>) <span class="comment">// initial capacity was placed in threshold</span></span><br><span class="line"><span class="number">18</span>         newCap = oldThr;</span><br><span class="line"><span class="number">19</span>     <span class="keyword">else</span> &#123;               <span class="comment">// zero initial threshold signifies using defaults</span></span><br><span class="line"><span class="number">20</span>         newCap = DEFAULT_INITIAL_CAPACITY;</span><br><span class="line"><span class="number">21</span>         newThr = (<span class="keyword">int</span>)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);</span><br><span class="line"><span class="number">22</span>     &#125;</span><br><span class="line"><span class="number">23</span>     <span class="comment">// 计算新的resize上限</span></span><br><span class="line"><span class="number">24</span>     <span class="keyword">if</span> (newThr == <span class="number">0</span>) &#123;</span><br><span class="line"><span class="number">25</span> </span><br><span class="line"><span class="number">26</span>         <span class="keyword">float</span> ft = (<span class="keyword">float</span>)newCap * loadFactor;</span><br><span class="line"><span class="number">27</span>         newThr = (newCap &lt; MAXIMUM_CAPACITY &amp;&amp; ft &lt; (<span class="keyword">float</span>)MAXIMUM_CAPACITY ?</span><br><span class="line"><span class="number">28</span>                   (<span class="keyword">int</span>)ft : Integer.MAX_VALUE);</span><br><span class="line"><span class="number">29</span>     &#125;</span><br><span class="line"><span class="number">30</span>     threshold = newThr;</span><br><span class="line"><span class="number">31</span>     <span class="meta">@SuppressWarnings</span>(&#123;<span class="string">"rawtypes"</span>，<span class="string">"unchecked"</span>&#125;)</span><br><span class="line"><span class="number">32</span>         Node&lt;K,V&gt;[] newTab = (Node&lt;K,V&gt;[])<span class="keyword">new</span> Node[newCap];</span><br><span class="line"><span class="number">33</span>     table = newTab;</span><br><span class="line"><span class="number">34</span>     <span class="keyword">if</span> (oldTab != <span class="keyword">null</span>) &#123;</span><br><span class="line"><span class="number">35</span>         <span class="comment">// 把每个bucket都移动到新的buckets中</span></span><br><span class="line"><span class="number">36</span>         <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">0</span>; j &lt; oldCap; ++j) &#123;</span><br><span class="line"><span class="number">37</span>             Node&lt;K,V&gt; e;</span><br><span class="line"><span class="number">38</span>             <span class="keyword">if</span> ((e = oldTab[j]) != <span class="keyword">null</span>) &#123;</span><br><span class="line"><span class="number">39</span>                 oldTab[j] = <span class="keyword">null</span>;</span><br><span class="line"><span class="number">40</span>                 <span class="keyword">if</span> (e.next == <span class="keyword">null</span>)</span><br><span class="line"><span class="number">41</span>                     newTab[e.hash &amp; (newCap - <span class="number">1</span>)] = e;</span><br><span class="line"><span class="number">42</span>                 <span class="keyword">else</span> <span class="keyword">if</span> (e <span class="keyword">instanceof</span> TreeNode)</span><br><span class="line"><span class="number">43</span>                     ((TreeNode&lt;K,V&gt;)e).split(<span class="keyword">this</span>, newTab, j, oldCap);</span><br><span class="line"><span class="number">44</span>                 <span class="keyword">else</span> &#123; <span class="comment">// 链表优化重hash的代码块</span></span><br><span class="line"><span class="number">45</span>                     Node&lt;K,V&gt; loHead = <span class="keyword">null</span>, loTail = <span class="keyword">null</span>;</span><br><span class="line"><span class="number">46</span>                     Node&lt;K,V&gt; hiHead = <span class="keyword">null</span>, hiTail = <span class="keyword">null</span>;</span><br><span class="line"><span class="number">47</span>                     Node&lt;K,V&gt; next;</span><br><span class="line"><span class="number">48</span>                     <span class="keyword">do</span> &#123;</span><br><span class="line"><span class="number">49</span>                         next = e.next;</span><br><span class="line"><span class="number">50</span>                         <span class="comment">// 原索引</span></span><br><span class="line"><span class="number">51</span>                         <span class="keyword">if</span> ((e.hash &amp; oldCap) == <span class="number">0</span>) &#123;</span><br><span class="line"><span class="number">52</span>                             <span class="keyword">if</span> (loTail == <span class="keyword">null</span>)</span><br><span class="line"><span class="number">53</span>                                 loHead = e;</span><br><span class="line"><span class="number">54</span>                             <span class="keyword">else</span></span><br><span class="line"><span class="number">55</span>                                 loTail.next = e;</span><br><span class="line"><span class="number">56</span>                             loTail = e;</span><br><span class="line"><span class="number">57</span>                         &#125;</span><br><span class="line"><span class="number">58</span>                         <span class="comment">// 原索引+oldCap</span></span><br><span class="line"><span class="number">59</span>                         <span class="keyword">else</span> &#123;</span><br><span class="line"><span class="number">60</span>                             <span class="keyword">if</span> (hiTail == <span class="keyword">null</span>)</span><br><span class="line"><span class="number">61</span>                                 hiHead = e;</span><br><span class="line"><span class="number">62</span>                             <span class="keyword">else</span></span><br><span class="line"><span class="number">63</span>                                 hiTail.next = e;</span><br><span class="line"><span class="number">64</span>                             hiTail = e;</span><br><span class="line"><span class="number">65</span>                         &#125;</span><br><span class="line"><span class="number">66</span>                     &#125; <span class="keyword">while</span> ((e = next) != <span class="keyword">null</span>);</span><br><span class="line"><span class="number">67</span>                     <span class="comment">// 原索引放到bucket里</span></span><br><span class="line"><span class="number">68</span>                     <span class="keyword">if</span> (loTail != <span class="keyword">null</span>) &#123;</span><br><span class="line"><span class="number">69</span>                         loTail.next = <span class="keyword">null</span>;</span><br><span class="line"><span class="number">70</span>                         newTab[j] = loHead;</span><br><span class="line"><span class="number">71</span>                     &#125;</span><br><span class="line"><span class="number">72</span>                     <span class="comment">// 原索引+oldCap放到bucket里</span></span><br><span class="line"><span class="number">73</span>                     <span class="keyword">if</span> (hiTail != <span class="keyword">null</span>) &#123;</span><br><span class="line"><span class="number">74</span>                         hiTail.next = <span class="keyword">null</span>;</span><br><span class="line"><span class="number">75</span>                         newTab[j + oldCap] = hiHead;</span><br><span class="line"><span class="number">76</span>                     &#125;</span><br><span class="line"><span class="number">77</span>                 &#125;</span><br><span class="line"><span class="number">78</span>             &#125;</span><br><span class="line"><span class="number">79</span>         &#125;</span><br><span class="line"><span class="number">80</span>     &#125;</span><br><span class="line"><span class="number">81</span>     <span class="keyword">return</span> newTab;</span><br><span class="line"><span class="number">82</span> &#125;</span><br></pre></td></tr></table></figure><p>在多线程使用场景中，应该尽量避免使用线程不安全的HashMap，而使用线程安全的ConcurrentHashMap。那么为什么说HashMap是线程不安全的，下面举例子说明在并发的多线程使用场景中使用HashMap可能造成死循环。代码例子如下(便于理解，仍然使用JDK1.7的环境)：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">HashMapInfiniteLoop</span> </span>&#123;  </span><br><span class="line"></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">static</span> HashMap&lt;Integer,String&gt; map = <span class="keyword">new</span> HashMap&lt;Integer,String&gt;(<span class="number">2</span>，<span class="number">0.75f</span>);  </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;  </span><br><span class="line">        map.put(<span class="number">5</span>， <span class="string">"C"</span>);  </span><br><span class="line"></span><br><span class="line">        <span class="keyword">new</span> Thread(<span class="string">"Thread1"</span>) &#123;  </span><br><span class="line">            <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">run</span><span class="params">()</span> </span>&#123;  </span><br><span class="line">                map.put(<span class="number">7</span>, <span class="string">"B"</span>);  </span><br><span class="line">                System.out.println(map);  </span><br><span class="line">            &#125;;  </span><br><span class="line">        &#125;.start();  </span><br><span class="line">        <span class="keyword">new</span> Thread(<span class="string">"Thread2"</span>) &#123;  </span><br><span class="line">            <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">run</span><span class="params">()</span> </span>&#123;  </span><br><span class="line">                map.put(<span class="number">3</span>, <span class="string">"A);  </span></span><br><span class="line"><span class="string">                System.out.println(map);  </span></span><br><span class="line"><span class="string">            &#125;;  </span></span><br><span class="line"><span class="string">        &#125;.start();        </span></span><br><span class="line"><span class="string">    &#125;  </span></span><br><span class="line"><span class="string">&#125;</span></span><br></pre></td></tr></table></figure><p>其中，map初始化为一个长度为2的数组，loadFactor=0.75，threshold=2*0.75=1，也就是说当put第二个key的时候，map就需要进行resize。</p><p>通过设置断点让线程1和线程2同时debug到transfer方法(3.3小节代码块)的首行。注意此时两个线程已经成功添加数据。放开thread1的断点至transfer方法的“Entry next = e.next;” 这一行；然后放开线程2的的断点，让线程2进行resize。结果如下图。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/7df99266.png" alt></p><p>注意，Thread1的 e 指向了key(3)，而next指向了key(7)，其在线程二rehash后，指向了线程二重组后的链表。</p><p>线程一被调度回来执行，先是执行 newTalbe[i] = e， 然后是e = next，导致了e指向了key(7)，而下一次循环的next = e.next导致了next指向了key(3)。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/4c3c28fb.png" alt></p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/6c8d086a.png" alt></p><p>e.next = newTable[i] 导致 key(3).next 指向了 key(7)。注意：此时的key(7).next 已经指向了key(3)， 环形链表就这样出现了。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/6eed9aaf.png" alt></p><p>于是，当我们用线程一调用map.get(11)时，悲剧就出现了——Infinite Loop。</p><p>HashMap中，如果key经过hash算法得出的数组索引位置全部不相同，即Hash算法非常好，那样的话，getKey方法的时间复杂度就是O(1)，如果Hash算法技术的结果碰撞非常多，假如Hash算极其差，所有的Hash算法结果得出的索引位置一样，那样所有的键值对都集中到一个桶中，或者在一个链表中，或者在一个红黑树中，时间复杂度分别为O(n)和O(lgn)。 鉴于JDK1.8做了多方面的优化，总体性能优于JDK1.7，下面我们从两个方面用例子证明这一点。</p><h2 id="Hash较均匀的情况"><a href="#Hash较均匀的情况" class="headerlink" title="Hash较均匀的情况"></a>Hash较均匀的情况</h2><p>为了便于测试，我们先写一个类Key，如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Key</span> <span class="keyword">implements</span> <span class="title">Comparable</span>&lt;<span class="title">Key</span>&gt; </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">final</span> <span class="keyword">int</span> value;</span><br><span class="line"></span><br><span class="line">    Key(<span class="keyword">int</span> value) &#123;</span><br><span class="line">        <span class="keyword">this</span>.value = value;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">compareTo</span><span class="params">(Key o)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> Integer.compare(<span class="keyword">this</span>.value, o.value);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">equals</span><span class="params">(Object o)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span> (<span class="keyword">this</span> == o) <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        <span class="keyword">if</span> (o == <span class="keyword">null</span> || getClass() != o.getClass())</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        Key key = (Key) o;</span><br><span class="line">        <span class="keyword">return</span> value == key.value;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">hashCode</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> value;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这个类复写了equals方法，并且提供了相当好的hashCode函数，任何一个值的hashCode都不会相同，因为直接使用value当做hashcode。为了避免频繁的GC，我将不变的Key实例缓存了起来，而不是一遍一遍的创建它们。代码如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Keys</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">final</span> <span class="keyword">int</span> MAX_KEY = <span class="number">10_000_000</span>;</span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">final</span> Key[] KEYS_CACHE = <span class="keyword">new</span> Key[MAX_KEY];</span><br><span class="line"></span><br><span class="line">    <span class="keyword">static</span> &#123;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; MAX_KEY; ++i) &#123;</span><br><span class="line">            KEYS_CACHE[i] = <span class="keyword">new</span> Key(i);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> Key <span class="title">of</span><span class="params">(<span class="keyword">int</span> value)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> KEYS_CACHE[value];</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>现在开始我们的试验，测试需要做的仅仅是，创建不同size的HashMap（1、10、100、……10000000），屏蔽了扩容的情况，代码如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">static</span> <span class="keyword">void</span> <span class="title">test</span><span class="params">(<span class="keyword">int</span> mapSize)</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">     HashMap&lt;Key, Integer&gt; map = <span class="keyword">new</span> HashMap&lt;Key,Integer&gt;(mapSize);</span><br><span class="line">     <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; mapSize; ++i) &#123;</span><br><span class="line">         map.put(Keys.of(i), i);</span><br><span class="line">     &#125;</span><br><span class="line"></span><br><span class="line">     <span class="keyword">long</span> beginTime = System.nanoTime(); <span class="comment">//获取纳秒</span></span><br><span class="line">     <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; mapSize; i++) &#123;</span><br><span class="line">         map.get(Keys.of(i));</span><br><span class="line">     &#125;</span><br><span class="line">     <span class="keyword">long</span> endTime = System.nanoTime();</span><br><span class="line">     System.out.println(endTime - beginTime);</span><br><span class="line"> &#125;</span><br><span class="line"></span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">     <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">10</span>;i&lt;= <span class="number">1000</span> <span class="number">0000</span>;i*= <span class="number">10</span>)&#123;</span><br><span class="line">         test(i);</span><br><span class="line">     &#125;</span><br><span class="line"> &#125;</span><br></pre></td></tr></table></figure><p>在测试中会查找不同的值，然后度量花费的时间，为了计算getKey的平均时间，我们遍历所有的get方法，计算总的时间，除以key的数量，计算一个平均值，主要用来比较，绝对值可能会受很多环境因素的影响。结果如下：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/377effbf.png" alt="img"></p><p>通过观测测试结果可知，JDK1.8的性能要高于JDK1.7 15%以上，在某些size的区域上，甚至高于100%。由于Hash算法较均匀，JDK1.8引入的红黑树效果不明显，下面我们看看Hash不均匀的的情况。</p><h2 id="Hash极不均匀的情况"><a href="#Hash极不均匀的情况" class="headerlink" title="Hash极不均匀的情况"></a>Hash极不均匀的情况</h2><p>假设我们又一个非常差的Key，它们所有的实例都返回相同的hashCode值。这是使用HashMap最坏的情况。代码修改如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Key</span> <span class="keyword">implements</span> <span class="title">Comparable</span>&lt;<span class="title">Key</span>&gt; </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="comment">//...</span></span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">hashCode</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> <span class="number">1</span>;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>仍然执行main方法，得出的结果如下表所示：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/bd20c215.png" alt></p><p>从表中结果中可知，随着size的变大，JDK1.7的花费时间是增长的趋势，而JDK1.8是明显的降低趋势，并且呈现对数增长稳定。当一个链表太长的时候，HashMap会动态的将它替换成一个红黑树，这话的话会将时间复杂度从O(n)降为O(logn)。hash算法均匀和不均匀所花费的时间明显也不相同，这两种情况的相对比较，可以说明一个好的hash算法的重要性。</p><p>   测试环境：处理器为2.2 GHz Intel Core i7，内存为16 GB 1600 MHz DDR3，SSD硬盘，使用默认的JVM参数，运行在64位的OS X 10.10.1上。</p><p>(1) 扩容是一个特别耗性能的操作，所以当程序员在使用HashMap的时候，估算map的大小，初始化的时候给一个大致的数值，避免map进行频繁的扩容。</p><p>(2) 负载因子是可以修改的，也可以大于1，但是建议不要轻易修改，除非情况非常特殊。</p><p>(3) HashMap是线程不安全的，不要在并发的环境中同时操作HashMap，建议使用ConcurrentHashMap。</p><p>(4) JDK1.8引入红黑树大程度优化了HashMap的性能。</p><p>(5) 还没升级JDK1.8的，现在开始升级吧。HashMap的性能提升仅仅是JDK1.8的冰山一角。</p><ol><li>JDK1.7&amp;JDK1.8 源码。</li><li>CSDN博客频道，<a href="http://blog.csdn.net/xuefeng0707/article/details/40797085" target="_blank" rel="noopener">HashMap多线程死循环问题</a>，2014。</li><li>红黑联盟，<a href="http://www.2cto.com/kf/201505/401433.html" target="_blank" rel="noopener">Java类集框架之HashMap(JDK1.8)源码剖析</a>，2015。</li><li>CSDN博客频道，<a href="http://blog.csdn.net/v_july_v/article/details/6105630" target="_blank" rel="noopener"> 教你初步了解红黑树</a>，2010。</li><li>Java Code Geeks，<a href="http://www.javacodegeeks.com/2014/04/hashmap-performance-improvements-in-java-8.html" target="_blank" rel="noopener">HashMap performance improvements in Java 8</a>，2014。</li><li>Importnew，<a href="http://www.importnew.com/13384.html" target="_blank" rel="noopener">危险！在HashMap中将可变对象用作Key</a>，2014。</li><li>CSDN博客频道，<a href="http://blog.csdn.net/liuqiyao_01/article/details/14475159" target="_blank" rel="noopener">为什么一般hashtable的桶数会取一个素数</a>，2013。</li></ol>]]></content>
    
    <summary type="html">
    
      &lt;h1 id=&quot;Java-8系列之重新认识HashMap&quot;&gt;&lt;a href=&quot;#Java-8系列之重新认识HashMap&quot; class=&quot;headerlink&quot; title=&quot;Java 8系列之重新认识HashMap&quot;&gt;&lt;/a&gt;&lt;a href=&quot;https://tech.meituan.com/2016/06/24/java-hashmap.html&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;Java 8系列之重新认识HashMap&lt;/a&gt;&lt;/h1&gt;&lt;p&gt;HashMap是Java程序员使用频率最高的用于映射(键值对)处理的数据类型。随着JDK（Java Developmet Kit）版本的更新，JDK1.8对HashMap底层的实现进行了优化，例如引入红黑树的数据结构和扩容的优化等。本文结合JDK1.7和JDK1.8的区别，深入探讨HashMap的结构实现和功能原理。&lt;/p&gt;
&lt;p&gt;Java为数据结构中的映射定义了一个接口java.util.Map，此接口主要有四个常用的实现类，分别是HashMap、Hashtable、LinkedHashMap和TreeMap，类继承关系如下图所示：&lt;/p&gt;
&lt;p&gt;&lt;img src=&quot;https://awps-assets.meituan.net/mit-x/blog-images-bundle-2016/f7fe16a2.png&quot; alt=&quot;img&quot;&gt;&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>AQS原理及应用</title>
    <link href="https://zrbac.github.io/2020/09/15/AQS%E5%8E%9F%E7%90%86%E5%8F%8A%E5%BA%94%E7%94%A8/"/>
    <id>https://zrbac.github.io/2020/09/15/AQS%E5%8E%9F%E7%90%86%E5%8F%8A%E5%BA%94%E7%94%A8/</id>
    <published>2020-09-15T05:04:10.000Z</published>
    <updated>2020-09-15T05:05:48.915Z</updated>
    
    <content type="html"><![CDATA[<h1 id="从ReentrantLock的实现看AQS的原理及应用"><a href="#从ReentrantLock的实现看AQS的原理及应用" class="headerlink" title="从ReentrantLock的实现看AQS的原理及应用"></a><a href="https://tech.meituan.com/2019/12/05/aqs-theory-and-apply.html" target="_blank" rel="noopener">从ReentrantLock的实现看AQS的原理及应用</a></h1><h2 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h2><p>Java中的大部分同步类（Lock、Semaphore、ReentrantLock等）都是基于AbstractQueuedSynchronizer（简称为AQS）实现的。AQS是一种提供了原子式管理同步状态、阻塞和唤醒线程功能以及队列模型的简单框架。本文会从应用层逐渐深入到原理层，并通过ReentrantLock的基本特性和ReentrantLock与AQS的关联，来深入解读AQS相关独占锁的知识点，同时采取问答的模式来帮助大家理解AQS。由于篇幅原因，本篇文章主要阐述AQS中独占锁的逻辑和Sync Queue，不讲述包含共享锁和Condition Queue的部分（本篇文章核心为AQS原理剖析，只是简单介绍了ReentrantLock，感兴趣同学可以阅读一下ReentrantLock的源码）。</p><p>下面列出本篇文章的大纲和思路，以便于大家更好地理解：</p><p><img src="https://p1.meituan.net/travelcube/9d182d944e0889c304ef529ba50a4fcd205214.png" alt="img"></p><a id="more"></a><h2 id="1-ReentrantLock"><a href="#1-ReentrantLock" class="headerlink" title="1 ReentrantLock"></a>1 ReentrantLock</h2><h3 id="1-1-ReentrantLock特性概览"><a href="#1-1-ReentrantLock特性概览" class="headerlink" title="1.1 ReentrantLock特性概览"></a>1.1 ReentrantLock特性概览</h3><p>ReentrantLock意思为可重入锁，指的是一个线程能够对一个临界资源重复加锁。为了帮助大家更好地理解ReentrantLock的特性，我们先将ReentrantLock跟常用的Synchronized进行比较，其特性如下（蓝色部分为本篇文章主要剖析的点）：</p><p><img src="https://p0.meituan.net/travelcube/412d294ff5535bbcddc0d979b2a339e6102264.png" alt="img"></p><p>下面通过伪代码，进行更加直观的比较：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// **************************Synchronized的使用方式**************************</span></span><br><span class="line"><span class="comment">// 1.用于代码块</span></span><br><span class="line"><span class="keyword">synchronized</span> (<span class="keyword">this</span>) &#123;&#125;</span><br><span class="line"><span class="comment">// 2.用于对象</span></span><br><span class="line"><span class="keyword">synchronized</span> (object) &#123;&#125;</span><br><span class="line"><span class="comment">// 3.用于方法</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">synchronized</span> <span class="keyword">void</span> <span class="title">test</span> <span class="params">()</span> </span>&#123;&#125;</span><br><span class="line"><span class="comment">// 4.可重入</span></span><br><span class="line"><span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; <span class="number">100</span>; i++) &#123;</span><br><span class="line"><span class="keyword">synchronized</span> (<span class="keyword">this</span>) &#123;&#125;</span><br><span class="line">&#125;</span><br><span class="line"><span class="comment">// **************************ReentrantLock的使用方式**************************</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">test</span> <span class="params">()</span> throw Exception </span>&#123;</span><br><span class="line"><span class="comment">// 1.初始化选择公平锁、非公平锁</span></span><br><span class="line">ReentrantLock lock = <span class="keyword">new</span> ReentrantLock(<span class="keyword">true</span>);</span><br><span class="line"><span class="comment">// 2.可用于代码块</span></span><br><span class="line">lock.lock();</span><br><span class="line"><span class="keyword">try</span> &#123;</span><br><span class="line"><span class="keyword">try</span> &#123;</span><br><span class="line"><span class="comment">// 3.支持多种加锁方式，比较灵活; 具有可重入特性</span></span><br><span class="line"><span class="keyword">if</span>(lock.tryLock(<span class="number">100</span>, TimeUnit.MILLISECONDS))&#123; &#125;</span><br><span class="line">&#125; <span class="keyword">finally</span> &#123;</span><br><span class="line"><span class="comment">// 4.手动释放锁</span></span><br><span class="line">lock.unlock()</span><br><span class="line">&#125;</span><br><span class="line">&#125; <span class="keyword">finally</span> &#123;</span><br><span class="line">lock.unlock();</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="1-2-ReentrantLock与AQS的关联"><a href="#1-2-ReentrantLock与AQS的关联" class="headerlink" title="1.2 ReentrantLock与AQS的关联"></a>1.2 ReentrantLock与AQS的关联</h3><p>通过上文我们已经了解，ReentrantLock支持公平锁和非公平锁（关于公平锁和非公平锁的原理分析，可参考《<a href="https://mp.weixin.qq.com/s?__biz=MjM5NjQ5MTI5OA==&mid=2651749434&idx=3&sn=5ffa63ad47fe166f2f1a9f604ed10091&chksm=bd12a5778a652c61509d9e718ab086ff27ad8768586ea9b38c3dcf9e017a8e49bcae3df9bcc8&scene=38#wechat_redirect" target="_blank" rel="noopener">不可不说的Java“锁”事</a>》），并且ReentrantLock的底层就是由AQS来实现的。那么ReentrantLock是如何通过公平锁和非公平锁与AQS关联起来呢？ 我们着重从这两者的加锁过程来理解一下它们与AQS之间的关系（加锁过程中与AQS的关联比较明显，解锁流程后续会介绍）。</p><p>非公平锁源码中的加锁流程如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.ReentrantLock#NonfairSync</span></span><br><span class="line"></span><br><span class="line"><span class="comment">// 非公平锁</span></span><br><span class="line"><span class="keyword">static</span> <span class="keyword">final</span> <span class="class"><span class="keyword">class</span> <span class="title">NonfairSync</span> <span class="keyword">extends</span> <span class="title">Sync</span> </span>&#123;</span><br><span class="line">...</span><br><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">void</span> <span class="title">lock</span><span class="params">()</span> </span>&#123;</span><br><span class="line"><span class="keyword">if</span> (compareAndSetState(<span class="number">0</span>, <span class="number">1</span>))</span><br><span class="line">setExclusiveOwnerThread(Thread.currentThread());</span><br><span class="line"><span class="keyword">else</span></span><br><span class="line">acquire(<span class="number">1</span>);</span><br><span class="line">&#125;</span><br><span class="line">  ...</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这块代码的含义为：</p><ul><li>若通过CAS设置变量State（同步状态）成功，也就是获取锁成功，则将当前线程设置为独占线程。</li><li>若通过CAS设置变量State（同步状态）失败，也就是获取锁失败，则进入Acquire方法进行后续处理。</li></ul><p>第一步很好理解，但第二步获取锁失败后，后续的处理策略是怎么样的呢？这块可能会有以下思考：</p><ul><li>某个线程获取锁失败的后续流程是什么呢？有以下两种可能：</li></ul><p>(1) 将当前线程获锁结果设置为失败，获取锁流程结束。这种设计会极大降低系统的并发度，并不满足我们实际的需求。所以就需要下面这种流程，也就是AQS框架的处理流程。</p><p>(2) 存在某种排队等候机制，线程继续等待，仍然保留获取锁的可能，获取锁流程仍在继续。</p><ul><li>对于问题1的第二种情况，既然说到了排队等候机制，那么就一定会有某种队列形成，这样的队列是什么数据结构呢？</li><li>处于排队等候机制中的线程，什么时候可以有机会获取锁呢？</li><li>如果处于排队等候机制中的线程一直无法获取锁，还是需要一直等待吗，还是有别的策略来解决这一问题？</li></ul><p>带着非公平锁的这些问题，再看下公平锁源码中获锁的方式：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.ReentrantLock#FairSync</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">static</span> <span class="keyword">final</span> <span class="class"><span class="keyword">class</span> <span class="title">FairSync</span> <span class="keyword">extends</span> <span class="title">Sync</span> </span>&#123;</span><br><span class="line">  ...  </span><br><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">void</span> <span class="title">lock</span><span class="params">()</span> </span>&#123;</span><br><span class="line">acquire(<span class="number">1</span>);</span><br><span class="line">&#125;</span><br><span class="line">  ...</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>看到这块代码，我们可能会存在这种疑问：Lock函数通过Acquire方法进行加锁，但是具体是如何加锁的呢？</p><p>结合公平锁和非公平锁的加锁流程，虽然流程上有一定的不同，但是都调用了Acquire方法，而Acquire方法是FairSync和UnfairSync的父类AQS中的核心方法。</p><p>对于上边提到的问题，其实在ReentrantLock类源码中都无法解答，而这些问题的答案，都是位于Acquire方法所在的类AbstractQueuedSynchronizer中，也就是本文的核心——AQS。下面我们会对AQS以及ReentrantLock和AQS的关联做详细介绍（相关问题答案会在2.3.5小节中解答）。</p><h2 id="2-AQS"><a href="#2-AQS" class="headerlink" title="2 AQS"></a>2 AQS</h2><p>首先，我们通过下面的架构图来整体了解一下AQS框架：</p><p><img src="https://p1.meituan.net/travelcube/82077ccf14127a87b77cefd1ccf562d3253591.png" alt="img"></p><ul><li>上图中有颜色的为Method，无颜色的为Attribution。</li><li>总的来说，AQS框架共分为五层，自上而下由浅入深，从AQS对外暴露的API到底层基础数据。</li><li>当有自定义同步器接入时，只需重写第一层所需要的部分方法即可，不需要关注底层具体的实现流程。当自定义同步器进行加锁或者解锁操作时，先经过第一层的API进入AQS内部方法，然后经过第二层进行锁的获取，接着对于获取锁失败的流程，进入第三层和第四层的等待队列处理，而这些处理方式均依赖于第五层的基础数据提供层。</li></ul><p>下面我们会从整体到细节，从流程到方法逐一剖析AQS框架，主要分析过程如下：</p><p><img src="https://p1.meituan.net/travelcube/d2f7f7fffdc30d85d17b44266c3ab05323338.png" alt="img"></p><h3 id="2-1-原理概览"><a href="#2-1-原理概览" class="headerlink" title="2.1 原理概览"></a>2.1 原理概览</h3><p>AQS核心思想是，如果被请求的共享资源空闲，那么就将当前请求资源的线程设置为有效的工作线程，将共享资源设置为锁定状态；如果共享资源被占用，就需要一定的阻塞等待唤醒机制来保证锁分配。这个机制主要用的是CLH队列的变体实现的，将暂时获取不到锁的线程加入到队列中。</p><p>CLH：Craig、Landin and Hagersten队列，是单向链表，AQS中的队列是CLH变体的虚拟双向队列（FIFO），AQS是通过将每条请求共享资源的线程封装成一个节点来实现锁的分配。</p><p>主要原理图如下：</p><p><img src="https://p0.meituan.net/travelcube/7132e4cef44c26f62835b197b239147b18062.png" alt="img"></p><p>AQS使用一个Volatile的int类型的成员变量来表示同步状态，通过内置的FIFO队列来完成资源获取的排队工作，通过CAS完成对State值的修改。</p><h4 id="2-1-1-AQS数据结构"><a href="#2-1-1-AQS数据结构" class="headerlink" title="2.1.1 AQS数据结构"></a>2.1.1 AQS数据结构</h4><p>先来看下AQS中最基本的数据结构——Node，Node即为上面CLH变体队列中的节点。</p><p><img src="https://p1.meituan.net/travelcube/960271cf2b5c8a185eed23e98b72c75538637.png" alt="img"></p><p>解释一下几个方法和属性值的含义：</p><table><thead><tr><th align="left">方法和属性值</th><th align="left">含义</th></tr></thead><tbody><tr><td align="left">waitStatus</td><td align="left">当前节点在队列中的状态</td></tr><tr><td align="left">thread</td><td align="left">表示处于该节点的线程</td></tr><tr><td align="left">prev</td><td align="left">前驱指针</td></tr><tr><td align="left">predecessor</td><td align="left">返回前驱节点，没有的话抛出npe</td></tr><tr><td align="left">nextWaiter</td><td align="left">指向下一个处于CONDITION状态的节点（由于本篇文章不讲述Condition Queue队列，这个指针不多介绍）</td></tr><tr><td align="left">next</td><td align="left">后继指针</td></tr></tbody></table><p>线程两种锁的模式：</p><table><thead><tr><th align="left">模式</th><th align="left">含义</th></tr></thead><tbody><tr><td align="left">SHARED</td><td align="left">表示线程以共享的模式等待锁</td></tr><tr><td align="left">EXCLUSIVE</td><td align="left">表示线程正在以独占的方式等待锁</td></tr></tbody></table><p>waitStatus有下面几个枚举值：</p><table><thead><tr><th align="left">枚举</th><th align="left">含义</th></tr></thead><tbody><tr><td align="left">0</td><td align="left">当一个Node被初始化的时候的默认值</td></tr><tr><td align="left">CANCELLED</td><td align="left">为1，表示线程获取锁的请求已经取消了</td></tr><tr><td align="left">CONDITION</td><td align="left">为-2，表示节点在等待队列中，节点线程等待唤醒</td></tr><tr><td align="left">PROPAGATE</td><td align="left">为-3，当前线程处在SHARED情况下，该字段才会使用</td></tr><tr><td align="left">SIGNAL</td><td align="left">为-1，表示线程已经准备好了，就等资源释放了</td></tr></tbody></table><h4 id="2-1-2-同步状态State"><a href="#2-1-2-同步状态State" class="headerlink" title="2.1.2 同步状态State"></a>2.1.2 同步状态State</h4><p>在了解数据结构后，接下来了解一下AQS的同步状态——State。AQS中维护了一个名为state的字段，意为同步状态，是由Volatile修饰的，用于展示当前临界资源的获锁情况。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">private</span> <span class="keyword">volatile</span> <span class="keyword">int</span> state;</span><br></pre></td></tr></table></figure><p>下面提供了几个访问这个字段的方法：</p><table><thead><tr><th align="left">方法名</th><th align="left">描述</th></tr></thead><tbody><tr><td align="left">protected final int getState()</td><td align="left">获取State的值</td></tr><tr><td align="left">protected final void setState(int newState)</td><td align="left">设置State的值</td></tr><tr><td align="left">protected final boolean compareAndSetState(int expect, int update)</td><td align="left">使用CAS方式更新State</td></tr></tbody></table><p>这几个方法都是Final修饰的，说明子类中无法重写它们。我们可以通过修改State字段表示的同步状态来实现多线程的独占模式和共享模式（加锁过程）。</p><p><img src="https://p0.meituan.net/travelcube/27605d483e8935da683a93be015713f331378.png" alt="img">)<img src="https://p0.meituan.net/travelcube/3f1e1a44f5b7d77000ba4f9476189b2e32806.png" alt="img"></p><p>对于我们自定义的同步工具，需要自定义获取同步状态和释放状态的方式，也就是AQS架构图中的第一层：API层。</p><h2 id="2-2-AQS重要方法与ReentrantLock的关联"><a href="#2-2-AQS重要方法与ReentrantLock的关联" class="headerlink" title="2.2 AQS重要方法与ReentrantLock的关联"></a>2.2 AQS重要方法与ReentrantLock的关联</h2><p>从架构图中可以得知，AQS提供了大量用于自定义同步器实现的Protected方法。自定义同步器实现的相关方法也只是为了通过修改State字段来实现多线程的独占模式或者共享模式。自定义同步器需要实现以下方法（ReentrantLock需要实现的方法如下，并不是全部）：</p><table><thead><tr><th align="left">方法名</th><th align="left">描述</th></tr></thead><tbody><tr><td align="left">protected boolean isHeldExclusively()</td><td align="left">该线程是否正在独占资源。只有用到Condition才需要去实现它。</td></tr><tr><td align="left">protected boolean tryAcquire(int arg)</td><td align="left">独占方式。arg为获取锁的次数，尝试获取资源，成功则返回True，失败则返回False。</td></tr><tr><td align="left">protected boolean tryRelease(int arg)</td><td align="left">独占方式。arg为释放锁的次数，尝试释放资源，成功则返回True，失败则返回False。</td></tr><tr><td align="left">protected int tryAcquireShared(int arg)</td><td align="left">共享方式。arg为获取锁的次数，尝试获取资源。负数表示失败；0表示成功，但没有剩余可用资源；正数表示成功，且有剩余资源。</td></tr><tr><td align="left">protected boolean tryReleaseShared(int arg)</td><td align="left">共享方式。arg为释放锁的次数，尝试释放资源，如果释放后允许唤醒后续等待结点返回True，否则返回False。</td></tr></tbody></table><p>一般来说，自定义同步器要么是独占方式，要么是共享方式，它们也只需实现tryAcquire-tryRelease、tryAcquireShared-tryReleaseShared中的一种即可。AQS也支持自定义同步器同时实现独占和共享两种方式，如ReentrantReadWriteLock。ReentrantLock是独占锁，所以实现了tryAcquire-tryRelease。</p><p>以非公平锁为例，这里主要阐述一下非公平锁与AQS之间方法的关联之处，具体每一处核心方法的作用会在文章后面详细进行阐述。</p><p><img src="https://p1.meituan.net/travelcube/b8b53a70984668bc68653efe9531573e78636.png" alt="img"></p><p>为了帮助大家理解ReentrantLock和AQS之间方法的交互过程，以非公平锁为例，我们将加锁和解锁的交互流程单独拎出来强调一下，以便于对后续内容的理解。</p><p><img src="https://p1.meituan.net/travelcube/7aadb272069d871bdee8bf3a218eed8136919.png" alt="img"></p><p>加锁：</p><ul><li>通过ReentrantLock的加锁方法Lock进行加锁操作。</li><li>会调用到内部类Sync的Lock方法，由于Sync#lock是抽象方法，根据ReentrantLock初始化选择的公平锁和非公平锁，执行相关内部类的Lock方法，本质上都会执行AQS的Acquire方法。</li><li>AQS的Acquire方法会执行tryAcquire方法，但是由于tryAcquire需要自定义同步器实现，因此执行了ReentrantLock中的tryAcquire方法，由于ReentrantLock是通过公平锁和非公平锁内部类实现的tryAcquire方法，因此会根据锁类型不同，执行不同的tryAcquire。</li><li>tryAcquire是获取锁逻辑，获取失败后，会执行框架AQS的后续逻辑，跟ReentrantLock自定义同步器无关。</li></ul><p>解锁：</p><ul><li>通过ReentrantLock的解锁方法Unlock进行解锁。</li><li>Unlock会调用内部类Sync的Release方法，该方法继承于AQS。</li><li>Release中会调用tryRelease方法，tryRelease需要自定义同步器实现，tryRelease只在ReentrantLock中的Sync实现，因此可以看出，释放锁的过程，并不区分是否为公平锁。</li><li>释放成功后，所有处理由AQS框架完成，与自定义同步器无关。</li></ul><p>通过上面的描述，大概可以总结出ReentrantLock加锁解锁时API层核心方法的映射关系。</p><p><img src="https://p0.meituan.net/travelcube/f30c631c8ebbf820d3e8fcb6eee3c0ef18748.png" alt="img"></p><h2 id="2-3-通过ReentrantLock理解AQS"><a href="#2-3-通过ReentrantLock理解AQS" class="headerlink" title="2.3 通过ReentrantLock理解AQS"></a>2.3 通过ReentrantLock理解AQS</h2><p>ReentrantLock中公平锁和非公平锁在底层是相同的，这里以非公平锁为例进行分析。</p><p>在非公平锁中，有一段这样的代码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.ReentrantLock</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">static</span> <span class="keyword">final</span> <span class="class"><span class="keyword">class</span> <span class="title">NonfairSync</span> <span class="keyword">extends</span> <span class="title">Sync</span> </span>&#123;</span><br><span class="line">...</span><br><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">void</span> <span class="title">lock</span><span class="params">()</span> </span>&#123;</span><br><span class="line"><span class="keyword">if</span> (compareAndSetState(<span class="number">0</span>, <span class="number">1</span>))</span><br><span class="line">setExclusiveOwnerThread(Thread.currentThread());</span><br><span class="line"><span class="keyword">else</span></span><br><span class="line">acquire(<span class="number">1</span>);</span><br><span class="line">&#125;</span><br><span class="line">  ...</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>看一下这个Acquire是怎么写的：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">void</span> <span class="title">acquire</span><span class="params">(<span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line"><span class="keyword">if</span> (!tryAcquire(arg) &amp;&amp; acquireQueued(addWaiter(Node.EXCLUSIVE), arg))</span><br><span class="line">selfInterrupt();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>再看一下tryAcquire方法：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">protected</span> <span class="keyword">boolean</span> <span class="title">tryAcquire</span><span class="params">(<span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line"><span class="keyword">throw</span> <span class="keyword">new</span> UnsupportedOperationException();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>可以看出，这里只是AQS的简单实现，具体获取锁的实现方法是由各自的公平锁和非公平锁单独实现的（以ReentrantLock为例）。如果该方法返回了True，则说明当前线程获取锁成功，就不用往后执行了；如果获取失败，就需要加入到等待队列中。下面会详细解释线程是何时以及怎样被加入进等待队列中的。</p><h3 id="2-3-1-线程加入等待队列"><a href="#2-3-1-线程加入等待队列" class="headerlink" title="2.3.1 线程加入等待队列"></a>2.3.1 线程加入等待队列</h3><h4 id="2-3-1-1-加入队列的时机"><a href="#2-3-1-1-加入队列的时机" class="headerlink" title="2.3.1.1 加入队列的时机"></a>2.3.1.1 加入队列的时机</h4><p>当执行Acquire(1)时，会通过tryAcquire获取锁。在这种情况下，如果获取锁失败，就会调用addWaiter加入到等待队列中去。</p><h4 id="2-3-1-2-如何加入队列"><a href="#2-3-1-2-如何加入队列" class="headerlink" title="2.3.1.2 如何加入队列"></a>2.3.1.2 如何加入队列</h4><p>获取锁失败后，会执行addWaiter(Node.EXCLUSIVE)加入等待队列，具体实现方法如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> Node <span class="title">addWaiter</span><span class="params">(Node mode)</span> </span>&#123;</span><br><span class="line">Node node = <span class="keyword">new</span> Node(Thread.currentThread(), mode);</span><br><span class="line"><span class="comment">// Try the fast path of enq; backup to full enq on failure</span></span><br><span class="line">Node pred = tail;</span><br><span class="line"><span class="keyword">if</span> (pred != <span class="keyword">null</span>) &#123;</span><br><span class="line">node.prev = pred;</span><br><span class="line"><span class="keyword">if</span> (compareAndSetTail(pred, node)) &#123;</span><br><span class="line">pred.next = node;</span><br><span class="line"><span class="keyword">return</span> node;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line">enq(node);</span><br><span class="line"><span class="keyword">return</span> node;</span><br><span class="line">&#125;</span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">compareAndSetTail</span><span class="params">(Node expect, Node update)</span> </span>&#123;</span><br><span class="line"><span class="keyword">return</span> unsafe.compareAndSwapObject(<span class="keyword">this</span>, tailOffset, expect, update);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>主要的流程如下：</p><ul><li>通过当前的线程和锁模式新建一个节点。</li><li>Pred指针指向尾节点Tail。</li><li>将New中Node的Prev指针指向Pred。</li><li>通过compareAndSetTail方法，完成尾节点的设置。这个方法主要是对tailOffset和Expect进行比较，如果tailOffset的Node和Expect的Node地址是相同的，那么设置Tail的值为Update的值。</li></ul><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">static</span> &#123;</span><br><span class="line"><span class="keyword">try</span> &#123;</span><br><span class="line">stateOffset = unsafe.objectFieldOffset(AbstractQueuedSynchronizer.class.getDeclaredField(<span class="string">"state"</span>));</span><br><span class="line">headOffset = unsafe.objectFieldOffset(AbstractQueuedSynchronizer.class.getDeclaredField(<span class="string">"head"</span>));</span><br><span class="line">tailOffset = unsafe.objectFieldOffset(AbstractQueuedSynchronizer.class.getDeclaredField(<span class="string">"tail"</span>));</span><br><span class="line">waitStatusOffset = unsafe.objectFieldOffset(Node.class.getDeclaredField(<span class="string">"waitStatus"</span>));</span><br><span class="line">nextOffset = unsafe.objectFieldOffset(Node.class.getDeclaredField(<span class="string">"next"</span>));</span><br><span class="line">&#125; <span class="keyword">catch</span> (Exception ex) &#123; </span><br><span class="line">    <span class="keyword">throw</span> <span class="keyword">new</span> Error(ex); </span><br><span class="line">  &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>从AQS的静态代码块可以看出，都是获取一个对象的属性相对于该对象在内存当中的偏移量，这样我们就可以根据这个偏移量在对象内存当中找到这个属性。tailOffset指的是tail对应的偏移量，所以这个时候会将new出来的Node置为当前队列的尾节点。同时，由于是双向链表，也需要将前一个节点指向尾节点。</p><ul><li>如果Pred指针是Null（说明等待队列中没有元素），或者当前Pred指针和Tail指向的位置不同（说明被别的线程已经修改），就需要看一下Enq的方法。</li></ul><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> Node <span class="title">enq</span><span class="params">(<span class="keyword">final</span> Node node)</span> </span>&#123;</span><br><span class="line"><span class="keyword">for</span> (;;) &#123;</span><br><span class="line">Node t = tail;</span><br><span class="line"><span class="keyword">if</span> (t == <span class="keyword">null</span>) &#123; <span class="comment">// Must initialize</span></span><br><span class="line"><span class="keyword">if</span> (compareAndSetHead(<span class="keyword">new</span> Node()))</span><br><span class="line">tail = head;</span><br><span class="line">&#125; <span class="keyword">else</span> &#123;</span><br><span class="line">node.prev = t;</span><br><span class="line"><span class="keyword">if</span> (compareAndSetTail(t, node)) &#123;</span><br><span class="line">t.next = node;</span><br><span class="line"><span class="keyword">return</span> t;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>如果没有被初始化，需要进行初始化一个头结点出来。但请注意，初始化的头结点并不是当前线程节点，而是调用了无参构造函数的节点。如果经历了初始化或者并发导致队列中有元素，则与之前的方法相同。其实，addWaiter就是一个在双端链表添加尾节点的操作，需要注意的是，双端链表的头结点是一个无参构造函数的头结点。</p><p>总结一下，线程获取锁的时候，过程大体如下：</p><ol><li>当没有线程获取到锁时，线程1获取锁成功。</li><li>线程2申请锁，但是锁被线程1占有。</li></ol><p><img src="https://p0.meituan.net/travelcube/e9e385c3c68f62c67c8d62ab0adb613921117.png" alt="img"></p><ol><li>如果再有线程要获取锁，依次在队列中往后排队即可。</li></ol><p>回到上边的代码，hasQueuedPredecessors是公平锁加锁时判断等待队列中是否存在有效节点的方法。如果返回False，说明当前线程可以争取共享资源；如果返回True，说明队列中存在有效节点，当前线程必须加入到等待队列中。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.ReentrantLock</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">hasQueuedPredecessors</span><span class="params">()</span> </span>&#123;</span><br><span class="line"><span class="comment">// The correctness of this depends on head being initialized</span></span><br><span class="line"><span class="comment">// before tail and on head.next being accurate if the current</span></span><br><span class="line"><span class="comment">// thread is first in queue.</span></span><br><span class="line">Node t = tail; <span class="comment">// Read fields in reverse initialization order</span></span><br><span class="line">Node h = head;</span><br><span class="line">Node s;</span><br><span class="line"><span class="keyword">return</span> h != t &amp;&amp; ((s = h.next) == <span class="keyword">null</span> || s.thread != Thread.currentThread());</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>看到这里，我们理解一下h != t &amp;&amp; ((s = h.next) == null || s.thread != Thread.currentThread());为什么要判断的头结点的下一个节点？第一个节点储存的数据是什么？</p><blockquote><p>双向链表中，第一个节点为虚节点，其实并不存储任何信息，只是占位。真正的第一个有数据的节点，是在第二个节点开始的。当h != t时： 如果(s = h.next) == null，等待队列正在有线程进行初始化，但只是进行到了Tail指向Head，没有将Head指向Tail，此时队列中有元素，需要返回True（这块具体见下边代码分析）。 如果(s = h.next) != null，说明此时队列中至少有一个有效节点。如果此时s.thread == Thread.currentThread()，说明等待队列的第一个有效节点中的线程与当前线程相同，那么当前线程是可以获取资源的；如果s.thread != Thread.currentThread()，说明等待队列的第一个有效节点线程与当前线程不同，当前线程必须加入进等待队列。</p></blockquote><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer#enq</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> (t == <span class="keyword">null</span>) &#123; <span class="comment">// Must initialize</span></span><br><span class="line"><span class="keyword">if</span> (compareAndSetHead(<span class="keyword">new</span> Node()))</span><br><span class="line">tail = head;</span><br><span class="line">&#125; <span class="keyword">else</span> &#123;</span><br><span class="line">node.prev = t;</span><br><span class="line"><span class="keyword">if</span> (compareAndSetTail(t, node)) &#123;</span><br><span class="line">t.next = node;</span><br><span class="line"><span class="keyword">return</span> t;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>节点入队不是原子操作，所以会出现短暂的head != tail，此时Tail指向最后一个节点，而且Tail指向Head。如果Head没有指向Tail（可见5、6、7行），这种情况下也需要将相关线程加入队列中。所以这块代码是为了解决极端情况下的并发问题。</p><h4 id="2-3-1-3-等待队列中线程出队列时机"><a href="#2-3-1-3-等待队列中线程出队列时机" class="headerlink" title="2.3.1.3 等待队列中线程出队列时机"></a>2.3.1.3 等待队列中线程出队列时机</h4><p>回到最初的源码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">void</span> <span class="title">acquire</span><span class="params">(<span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line"><span class="keyword">if</span> (!tryAcquire(arg) &amp;&amp; acquireQueued(addWaiter(Node.EXCLUSIVE), arg))</span><br><span class="line">selfInterrupt();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>上文解释了addWaiter方法，这个方法其实就是把对应的线程以Node的数据结构形式加入到双端队列里，返回的是一个包含该线程的Node。而这个Node会作为参数，进入到acquireQueued方法中。acquireQueued方法可以对排队中的线程进行“获锁”操作。</p><p>总的来说，一个线程获取锁失败了，被放入等待队列，acquireQueued会把放入队列中的线程不断去获取锁，直到获取成功或者不再需要获取（中断）。</p><p>下面我们从“何时出队列？”和“如何出队列？”两个方向来分析一下acquireQueued源码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">acquireQueued</span><span class="params">(<span class="keyword">final</span> Node node, <span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line"><span class="comment">// 标记是否成功拿到资源</span></span><br><span class="line"><span class="keyword">boolean</span> failed = <span class="keyword">true</span>;</span><br><span class="line"><span class="keyword">try</span> &#123;</span><br><span class="line"><span class="comment">// 标记等待过程中是否中断过</span></span><br><span class="line"><span class="keyword">boolean</span> interrupted = <span class="keyword">false</span>;</span><br><span class="line"><span class="comment">// 开始自旋，要么获取锁，要么中断</span></span><br><span class="line"><span class="keyword">for</span> (;;) &#123;</span><br><span class="line"><span class="comment">// 获取当前节点的前驱节点</span></span><br><span class="line"><span class="keyword">final</span> Node p = node.predecessor();</span><br><span class="line"><span class="comment">// 如果p是头结点，说明当前节点在真实数据队列的首部，就尝试获取锁（别忘了头结点是虚节点）</span></span><br><span class="line"><span class="keyword">if</span> (p == head &amp;&amp; tryAcquire(arg)) &#123;</span><br><span class="line"><span class="comment">// 获取锁成功，头指针移动到当前node</span></span><br><span class="line">setHead(node);</span><br><span class="line">p.next = <span class="keyword">null</span>; <span class="comment">// help GC</span></span><br><span class="line">failed = <span class="keyword">false</span>;</span><br><span class="line"><span class="keyword">return</span> interrupted;</span><br><span class="line">&#125;</span><br><span class="line"><span class="comment">// 说明p为头节点且当前没有获取到锁（可能是非公平锁被抢占了）或者是p不为头结点，这个时候就要判断当前node是否要被阻塞（被阻塞条件：前驱节点的waitStatus为-1），防止无限循环浪费资源。具体两个方法下面细细分析</span></span><br><span class="line"><span class="keyword">if</span> (shouldParkAfterFailedAcquire(p, node) &amp;&amp; parkAndCheckInterrupt())</span><br><span class="line">interrupted = <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br><span class="line">&#125; <span class="keyword">finally</span> &#123;</span><br><span class="line"><span class="keyword">if</span> (failed)</span><br><span class="line">cancelAcquire(node);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>注：setHead方法是把当前节点置为虚节点，但并没有修改waitStatus，因为它是一直需要用的数据。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">setHead</span><span class="params">(Node node)</span> </span>&#123;</span><br><span class="line">head = node;</span><br><span class="line">node.thread = <span class="keyword">null</span>;</span><br><span class="line">node.prev = <span class="keyword">null</span>;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="comment">// 靠前驱节点判断当前线程是否应该被阻塞</span></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">boolean</span> <span class="title">shouldParkAfterFailedAcquire</span><span class="params">(Node pred, Node node)</span> </span>&#123;</span><br><span class="line"><span class="comment">// 获取头结点的节点状态</span></span><br><span class="line"><span class="keyword">int</span> ws = pred.waitStatus;</span><br><span class="line"><span class="comment">// 说明头结点处于唤醒状态</span></span><br><span class="line"><span class="keyword">if</span> (ws == Node.SIGNAL)</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">true</span>; </span><br><span class="line"><span class="comment">// 通过枚举值我们知道waitStatus&gt;0是取消状态</span></span><br><span class="line"><span class="keyword">if</span> (ws &gt; <span class="number">0</span>) &#123;</span><br><span class="line"><span class="keyword">do</span> &#123;</span><br><span class="line"><span class="comment">// 循环向前查找取消节点，把取消节点从队列中剔除</span></span><br><span class="line">node.prev = pred = pred.prev;</span><br><span class="line">&#125; <span class="keyword">while</span> (pred.waitStatus &gt; <span class="number">0</span>);</span><br><span class="line">pred.next = node;</span><br><span class="line">&#125; <span class="keyword">else</span> &#123;</span><br><span class="line"><span class="comment">// 设置前任节点等待状态为SIGNAL</span></span><br><span class="line">compareAndSetWaitStatus(pred, ws, Node.SIGNAL);</span><br><span class="line">&#125;</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>parkAndCheckInterrupt主要用于挂起当前线程，阻塞调用栈，返回当前线程的中断状态。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">parkAndCheckInterrupt</span><span class="params">()</span> </span>&#123;</span><br><span class="line">    LockSupport.park(<span class="keyword">this</span>);</span><br><span class="line">    <span class="keyword">return</span> Thread.interrupted();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>上述方法的流程图如下：</p><p><img src="https://p0.meituan.net/travelcube/c124b76dcbefb9bdc778458064703d1135485.png" alt="img"></p><p>从上图可以看出，跳出当前循环的条件是当“前置节点是头结点，且当前线程获取锁成功”。为了防止因死循环导致CPU资源被浪费，我们会判断前置节点的状态来决定是否要将当前线程挂起，具体挂起流程用流程图表示如下（shouldParkAfterFailedAcquire流程）：</p><p><img src="https://p0.meituan.net/travelcube/9af16e2481ad85f38ca322a225ae737535740.png" alt="img"></p><p>从队列中释放节点的疑虑打消了，那么又有新问题了：</p><ul><li>shouldParkAfterFailedAcquire中取消节点是怎么生成的呢？什么时候会把一个节点的waitStatus设置为-1？</li><li>是在什么时间释放节点通知到被挂起的线程呢？</li></ul><h3 id="2-3-2-CANCELLED状态节点生成"><a href="#2-3-2-CANCELLED状态节点生成" class="headerlink" title="2.3.2 CANCELLED状态节点生成"></a>2.3.2 CANCELLED状态节点生成</h3><p>acquireQueued方法中的Finally代码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">acquireQueued</span><span class="params">(<span class="keyword">final</span> Node node, <span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line"><span class="keyword">boolean</span> failed = <span class="keyword">true</span>;</span><br><span class="line"><span class="keyword">try</span> &#123;</span><br><span class="line">    ...</span><br><span class="line"><span class="keyword">for</span> (;;) &#123;</span><br><span class="line"><span class="keyword">final</span> Node p = node.predecessor();</span><br><span class="line"><span class="keyword">if</span> (p == head &amp;&amp; tryAcquire(arg)) &#123;</span><br><span class="line">...</span><br><span class="line">failed = <span class="keyword">false</span>;</span><br><span class="line">        ...</span><br><span class="line">&#125;</span><br><span class="line">...</span><br><span class="line">&#125; <span class="keyword">finally</span> &#123;</span><br><span class="line"><span class="keyword">if</span> (failed)</span><br><span class="line">cancelAcquire(node);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>通过cancelAcquire方法，将Node的状态标记为CANCELLED。接下来，我们逐行来分析这个方法的原理：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">cancelAcquire</span><span class="params">(Node node)</span> </span>&#123;</span><br><span class="line">  <span class="comment">// 将无效节点过滤</span></span><br><span class="line"><span class="keyword">if</span> (node == <span class="keyword">null</span>)</span><br><span class="line"><span class="keyword">return</span>;</span><br><span class="line">  <span class="comment">// 设置该节点不关联任何线程，也就是虚节点</span></span><br><span class="line">node.thread = <span class="keyword">null</span>;</span><br><span class="line">Node pred = node.prev;</span><br><span class="line">  <span class="comment">// 通过前驱节点，跳过取消状态的node</span></span><br><span class="line"><span class="keyword">while</span> (pred.waitStatus &gt; <span class="number">0</span>)</span><br><span class="line">node.prev = pred = pred.prev;</span><br><span class="line">  <span class="comment">// 获取过滤后的前驱节点的后继节点</span></span><br><span class="line">Node predNext = pred.next;</span><br><span class="line">  <span class="comment">// 把当前node的状态设置为CANCELLED</span></span><br><span class="line">node.waitStatus = Node.CANCELLED;</span><br><span class="line">  <span class="comment">// 如果当前节点是尾节点，将从后往前的第一个非取消状态的节点设置为尾节点</span></span><br><span class="line">  <span class="comment">// 更新失败的话，则进入else，如果更新成功，将tail的后继节点设置为null</span></span><br><span class="line"><span class="keyword">if</span> (node == tail &amp;&amp; compareAndSetTail(node, pred)) &#123;</span><br><span class="line">compareAndSetNext(pred, predNext, <span class="keyword">null</span>);</span><br><span class="line">&#125; <span class="keyword">else</span> &#123;</span><br><span class="line"><span class="keyword">int</span> ws;</span><br><span class="line">    <span class="comment">// 如果当前节点不是head的后继节点，1:判断当前节点前驱节点的是否为SIGNAL，2:如果不是，则把前驱节点设置为SINGAL看是否成功</span></span><br><span class="line">    <span class="comment">// 如果1和2中有一个为true，再判断当前节点的线程是否为null</span></span><br><span class="line">    <span class="comment">// 如果上述条件都满足，把当前节点的前驱节点的后继指针指向当前节点的后继节点</span></span><br><span class="line"><span class="keyword">if</span> (pred != head &amp;&amp; ((ws = pred.waitStatus) == Node.SIGNAL || (ws &lt;= <span class="number">0</span> &amp;&amp; compareAndSetWaitStatus(pred, ws, Node.SIGNAL))) &amp;&amp; pred.thread != <span class="keyword">null</span>) &#123;</span><br><span class="line">Node next = node.next;</span><br><span class="line"><span class="keyword">if</span> (next != <span class="keyword">null</span> &amp;&amp; next.waitStatus &lt;= <span class="number">0</span>)</span><br><span class="line">compareAndSetNext(pred, predNext, next);</span><br><span class="line">&#125; <span class="keyword">else</span> &#123;</span><br><span class="line">      <span class="comment">// 如果当前节点是head的后继节点，或者上述条件不满足，那就唤醒当前节点的后继节点</span></span><br><span class="line">unparkSuccessor(node);</span><br><span class="line">&#125;</span><br><span class="line">node.next = node; <span class="comment">// help GC</span></span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>当前的流程：</p><ul><li>获取当前节点的前驱节点，如果前驱节点的状态是CANCELLED，那就一直往前遍历，找到第一个waitStatus &lt;= 0的节点，将找到的Pred节点和当前Node关联，将当前Node设置为CANCELLED。</li><li>根据当前节点的位置，考虑以下三种情况：</li></ul><p>(1) 当前节点是尾节点。</p><p>(2) 当前节点是Head的后继节点。</p><p>(3) 当前节点不是Head的后继节点，也不是尾节点。</p><p>根据上述第二条，我们来分析每一种情况的流程。</p><p>当前节点是尾节点。</p><p><img src="https://p1.meituan.net/travelcube/b845211ced57561c24f79d56194949e822049.png" alt="img"></p><p>当前节点是Head的后继节点。</p><p><img src="https://p1.meituan.net/travelcube/ab89bfec875846e5028a4f8fead32b7117975.png" alt="img"></p><p>当前节点不是Head的后继节点，也不是尾节点。</p><p><img src="https://p0.meituan.net/travelcube/45d0d9e4a6897eddadc4397cf53d6cd522452.png" alt="img"></p><p>通过上面的流程，我们对于CANCELLED节点状态的产生和变化已经有了大致的了解，但是为什么所有的变化都是对Next指针进行了操作，而没有对Prev指针进行操作呢？什么情况下会对Prev指针进行操作？</p><blockquote><p>执行cancelAcquire的时候，当前节点的前置节点可能已经从队列中出去了（已经执行过Try代码块中的shouldParkAfterFailedAcquire方法了），如果此时修改Prev指针，有可能会导致Prev指向另一个已经移除队列的Node，因此这块变化Prev指针不安全。 shouldParkAfterFailedAcquire方法中，会执行下面的代码，其实就是在处理Prev指针。shouldParkAfterFailedAcquire是获取锁失败的情况下才会执行，进入该方法后，说明共享资源已被获取，当前节点之前的节点都不会出现变化，因此这个时候变更Prev指针比较安全。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">&gt; <span class="keyword">do</span> &#123;</span><br><span class="line">&gt; node.prev = pred = pred.prev;</span><br><span class="line">&gt; &#125; <span class="keyword">while</span> (pred.waitStatus &gt; <span class="number">0</span>);</span><br><span class="line">&gt;</span><br></pre></td></tr></table></figure></blockquote><h3 id="2-3-3-如何解锁"><a href="#2-3-3-如何解锁" class="headerlink" title="2.3.3 如何解锁"></a>2.3.3 如何解锁</h3><p>我们已经剖析了加锁过程中的基本流程，接下来再对解锁的基本流程进行分析。由于ReentrantLock在解锁的时候，并不区分公平锁和非公平锁，所以我们直接看解锁的源码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.ReentrantLock</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">unlock</span><span class="params">()</span> </span>&#123;</span><br><span class="line">sync.release(<span class="number">1</span>);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>可以看到，本质释放锁的地方，是通过框架来完成的。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">release</span><span class="params">(<span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line"><span class="keyword">if</span> (tryRelease(arg)) &#123;</span><br><span class="line">Node h = head;</span><br><span class="line"><span class="keyword">if</span> (h != <span class="keyword">null</span> &amp;&amp; h.waitStatus != <span class="number">0</span>)</span><br><span class="line">unparkSuccessor(h);</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>在ReentrantLock里面的公平锁和非公平锁的父类Sync定义了可重入锁的释放锁机制。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.ReentrantLock.Sync</span></span><br><span class="line"></span><br><span class="line"><span class="comment">// 方法返回当前锁是不是没有被线程持有</span></span><br><span class="line"><span class="function"><span class="keyword">protected</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">tryRelease</span><span class="params">(<span class="keyword">int</span> releases)</span> </span>&#123;</span><br><span class="line"><span class="comment">// 减少可重入次数</span></span><br><span class="line"><span class="keyword">int</span> c = getState() - releases;</span><br><span class="line"><span class="comment">// 当前线程不是持有锁的线程，抛出异常</span></span><br><span class="line"><span class="keyword">if</span> (Thread.currentThread() != getExclusiveOwnerThread())</span><br><span class="line"><span class="keyword">throw</span> <span class="keyword">new</span> IllegalMonitorStateException();</span><br><span class="line"><span class="keyword">boolean</span> free = <span class="keyword">false</span>;</span><br><span class="line"><span class="comment">// 如果持有线程全部释放，将当前独占锁所有线程设置为null，并更新state</span></span><br><span class="line"><span class="keyword">if</span> (c == <span class="number">0</span>) &#123;</span><br><span class="line">free = <span class="keyword">true</span>;</span><br><span class="line">setExclusiveOwnerThread(<span class="keyword">null</span>);</span><br><span class="line">&#125;</span><br><span class="line">setState(c);</span><br><span class="line"><span class="keyword">return</span> free;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>我们来解释下述源码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">release</span><span class="params">(<span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line"><span class="comment">// 上边自定义的tryRelease如果返回true，说明该锁没有被任何线程持有</span></span><br><span class="line"><span class="keyword">if</span> (tryRelease(arg)) &#123;</span><br><span class="line"><span class="comment">// 获取头结点</span></span><br><span class="line">Node h = head;</span><br><span class="line"><span class="comment">// 头结点不为空并且头结点的waitStatus不是初始化节点情况，解除线程挂起状态</span></span><br><span class="line"><span class="keyword">if</span> (h != <span class="keyword">null</span> &amp;&amp; h.waitStatus != <span class="number">0</span>)</span><br><span class="line">unparkSuccessor(h);</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这里的判断条件为什么是h != null &amp;&amp; h.waitStatus != 0？</p><blockquote><p>h == null Head还没初始化。初始情况下，head == null，第一个节点入队，Head会被初始化一个虚拟节点。所以说，这里如果还没来得及入队，就会出现head == null 的情况。</p><p>h != null &amp;&amp; waitStatus == 0 表明后继节点对应的线程仍在运行中，不需要唤醒。</p><p>h != null &amp;&amp; waitStatus &lt; 0 表明后继节点可能被阻塞了，需要唤醒。</p></blockquote><p>再看一下unparkSuccessor方法：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">unparkSuccessor</span><span class="params">(Node node)</span> </span>&#123;</span><br><span class="line"><span class="comment">// 获取头结点waitStatus</span></span><br><span class="line"><span class="keyword">int</span> ws = node.waitStatus;</span><br><span class="line"><span class="keyword">if</span> (ws &lt; <span class="number">0</span>)</span><br><span class="line">compareAndSetWaitStatus(node, ws, <span class="number">0</span>);</span><br><span class="line"><span class="comment">// 获取当前节点的下一个节点</span></span><br><span class="line">Node s = node.next;</span><br><span class="line"><span class="comment">// 如果下个节点是null或者下个节点被cancelled，就找到队列最开始的非cancelled的节点</span></span><br><span class="line"><span class="keyword">if</span> (s == <span class="keyword">null</span> || s.waitStatus &gt; <span class="number">0</span>) &#123;</span><br><span class="line">s = <span class="keyword">null</span>;</span><br><span class="line"><span class="comment">// 就从尾部节点开始找，到队首，找到队列第一个waitStatus&lt;0的节点。</span></span><br><span class="line"><span class="keyword">for</span> (Node t = tail; t != <span class="keyword">null</span> &amp;&amp; t != node; t = t.prev)</span><br><span class="line"><span class="keyword">if</span> (t.waitStatus &lt;= <span class="number">0</span>)</span><br><span class="line">s = t;</span><br><span class="line">&#125;</span><br><span class="line"><span class="comment">// 如果当前节点的下个节点不为空，而且状态&lt;=0，就把当前节点unpark</span></span><br><span class="line"><span class="keyword">if</span> (s != <span class="keyword">null</span>)</span><br><span class="line">LockSupport.unpark(s.thread);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>为什么要从后往前找第一个非Cancelled的节点呢？原因如下。</p><p>之前的addWaiter方法：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> Node <span class="title">addWaiter</span><span class="params">(Node mode)</span> </span>&#123;</span><br><span class="line">Node node = <span class="keyword">new</span> Node(Thread.currentThread(), mode);</span><br><span class="line"><span class="comment">// Try the fast path of enq; backup to full enq on failure</span></span><br><span class="line">Node pred = tail;</span><br><span class="line"><span class="keyword">if</span> (pred != <span class="keyword">null</span>) &#123;</span><br><span class="line">node.prev = pred;</span><br><span class="line"><span class="keyword">if</span> (compareAndSetTail(pred, node)) &#123;</span><br><span class="line">pred.next = node;</span><br><span class="line"><span class="keyword">return</span> node;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line">enq(node);</span><br><span class="line"><span class="keyword">return</span> node;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>我们从这里可以看到，节点入队并不是原子操作，也就是说，node.prev = pred; compareAndSetTail(pred, node) 这两个地方可以看作Tail入队的原子操作，但是此时pred.next = node;还没执行，如果这个时候执行了unparkSuccessor方法，就没办法从前往后找了，所以需要从后往前找。还有一点原因，在产生CANCELLED状态节点的时候，先断开的是Next指针，Prev指针并未断开，因此也是必须要从后往前遍历才能够遍历完全部的Node。</p><p>综上所述，如果是从前往后找，由于极端情况下入队的非原子操作和CANCELLED节点产生过程中断开Next指针的操作，可能会导致无法遍历所有的节点。所以，唤醒对应的线程后，对应的线程就会继续往下执行。继续执行acquireQueued方法以后，中断如何处理？</p><h3 id="2-3-4-中断恢复后的执行流程"><a href="#2-3-4-中断恢复后的执行流程" class="headerlink" title="2.3.4 中断恢复后的执行流程"></a>2.3.4 中断恢复后的执行流程</h3><p>唤醒后，会执行return Thread.interrupted();，这个函数返回的是当前执行线程的中断状态，并清除。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">parkAndCheckInterrupt</span><span class="params">()</span> </span>&#123;</span><br><span class="line">LockSupport.park(<span class="keyword">this</span>);</span><br><span class="line"><span class="keyword">return</span> Thread.interrupted();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>再回到acquireQueued代码，当parkAndCheckInterrupt返回True或者False的时候，interrupted的值不同，但都会执行下次循环。如果这个时候获取锁成功，就会把当前interrupted返回。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">acquireQueued</span><span class="params">(<span class="keyword">final</span> Node node, <span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line"><span class="keyword">boolean</span> failed = <span class="keyword">true</span>;</span><br><span class="line"><span class="keyword">try</span> &#123;</span><br><span class="line"><span class="keyword">boolean</span> interrupted = <span class="keyword">false</span>;</span><br><span class="line"><span class="keyword">for</span> (;;) &#123;</span><br><span class="line"><span class="keyword">final</span> Node p = node.predecessor();</span><br><span class="line"><span class="keyword">if</span> (p == head &amp;&amp; tryAcquire(arg)) &#123;</span><br><span class="line">setHead(node);</span><br><span class="line">p.next = <span class="keyword">null</span>; <span class="comment">// help GC</span></span><br><span class="line">failed = <span class="keyword">false</span>;</span><br><span class="line"><span class="keyword">return</span> interrupted;</span><br><span class="line">&#125;</span><br><span class="line"><span class="keyword">if</span> (shouldParkAfterFailedAcquire(p, node) &amp;&amp; parkAndCheckInterrupt())</span><br><span class="line">interrupted = <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br><span class="line">&#125; <span class="keyword">finally</span> &#123;</span><br><span class="line"><span class="keyword">if</span> (failed)</span><br><span class="line">cancelAcquire(node);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>如果acquireQueued为True，就会执行selfInterrupt方法。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">static</span> <span class="keyword">void</span> <span class="title">selfInterrupt</span><span class="params">()</span> </span>&#123;</span><br><span class="line">Thread.currentThread().interrupt();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>该方法其实是为了中断线程。但为什么获取了锁以后还要中断线程呢？这部分属于Java提供的协作式中断知识内容，感兴趣同学可以查阅一下。这里简单介绍一下：</p><ol><li>当中断线程被唤醒时，并不知道被唤醒的原因，可能是当前线程在等待中被中断，也可能是释放了锁以后被唤醒。因此我们通过Thread.interrupted()方法检查中断标记（该方法返回了当前线程的中断状态，并将当前线程的中断标识设置为False），并记录下来，如果发现该线程被中断过，就再中断一次。</li><li>线程在等待资源的过程中被唤醒，唤醒后还是会不断地去尝试获取锁，直到抢到锁为止。也就是说，在整个流程中，并不响应中断，只是记录中断记录。最后抢到锁返回了，那么如果被中断过的话，就需要补充一次中断。</li></ol><p>这里的处理方式主要是运用线程池中基本运作单元Worder中的runWorker，通过Thread.interrupted()进行额外的判断处理，感兴趣的同学可以看下ThreadPoolExecutor源码。</p><h3 id="2-3-5-小结"><a href="#2-3-5-小结" class="headerlink" title="2.3.5 小结"></a>2.3.5 小结</h3><p>我们在1.3小节中提出了一些问题，现在来回答一下。</p><blockquote><p>Q：某个线程获取锁失败的后续流程是什么呢？</p><p>A：存在某种排队等候机制，线程继续等待，仍然保留获取锁的可能，获取锁流程仍在继续。</p><p>Q：既然说到了排队等候机制，那么就一定会有某种队列形成，这样的队列是什么数据结构呢？</p><p>A：是CLH变体的FIFO双端队列。</p><p>Q：处于排队等候机制中的线程，什么时候可以有机会获取锁呢？</p><p>A：可以详细看下2.3.1.3小节。</p><p>Q：如果处于排队等候机制中的线程一直无法获取锁，需要一直等待么？还是有别的策略来解决这一问题？</p><p>A：线程所在节点的状态会变成取消状态，取消状态的节点会从队列中释放，具体可见2.3.2小节。</p><p>Q：Lock函数通过Acquire方法进行加锁，但是具体是如何加锁的呢？</p><p>A：AQS的Acquire会调用tryAcquire方法，tryAcquire由各个自定义同步器实现，通过tryAcquire完成加锁过程。</p></blockquote><h2 id="3-AQS应用"><a href="#3-AQS应用" class="headerlink" title="3 AQS应用"></a>3 AQS应用</h2><h3 id="3-1-ReentrantLock的可重入应用"><a href="#3-1-ReentrantLock的可重入应用" class="headerlink" title="3.1 ReentrantLock的可重入应用"></a>3.1 ReentrantLock的可重入应用</h3><p>ReentrantLock的可重入性是AQS很好的应用之一，在了解完上述知识点以后，我们很容易得知ReentrantLock实现可重入的方法。在ReentrantLock里面，不管是公平锁还是非公平锁，都有一段逻辑。</p><p>公平锁：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.ReentrantLock.FairSync#tryAcquire</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> (c == <span class="number">0</span>) &#123;</span><br><span class="line"><span class="keyword">if</span> (!hasQueuedPredecessors() &amp;&amp; compareAndSetState(<span class="number">0</span>, acquires)) &#123;</span><br><span class="line">setExclusiveOwnerThread(current);</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"><span class="keyword">else</span> <span class="keyword">if</span> (current == getExclusiveOwnerThread()) &#123;</span><br><span class="line"><span class="keyword">int</span> nextc = c + acquires;</span><br><span class="line"><span class="keyword">if</span> (nextc &lt; <span class="number">0</span>)</span><br><span class="line"><span class="keyword">throw</span> <span class="keyword">new</span> Error(<span class="string">"Maximum lock count exceeded"</span>);</span><br><span class="line">setState(nextc);</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>非公平锁：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.ReentrantLock.Sync#nonfairTryAcquire</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> (c == <span class="number">0</span>) &#123;</span><br><span class="line"><span class="keyword">if</span> (compareAndSetState(<span class="number">0</span>, acquires))&#123;</span><br><span class="line">setExclusiveOwnerThread(current);</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"><span class="keyword">else</span> <span class="keyword">if</span> (current == getExclusiveOwnerThread()) &#123;</span><br><span class="line"><span class="keyword">int</span> nextc = c + acquires;</span><br><span class="line"><span class="keyword">if</span> (nextc &lt; <span class="number">0</span>) <span class="comment">// overflow</span></span><br><span class="line"><span class="keyword">throw</span> <span class="keyword">new</span> Error(<span class="string">"Maximum lock count exceeded"</span>);</span><br><span class="line">setState(nextc);</span><br><span class="line"><span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>从上面这两段都可以看到，有一个同步状态State来控制整体可重入的情况。State是Volatile修饰的，用于保证一定的可见性和有序性。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// java.util.concurrent.locks.AbstractQueuedSynchronizer</span></span><br><span class="line"></span><br><span class="line"><span class="keyword">private</span> <span class="keyword">volatile</span> <span class="keyword">int</span> state;</span><br></pre></td></tr></table></figure><p>接下来看State这个字段主要的过程：</p><ol><li>State初始化的时候为0，表示没有任何线程持有锁。</li><li>当有线程持有该锁时，值就会在原来的基础上+1，同一个线程多次获得锁是，就会多次+1，这里就是可重入的概念。</li><li>解锁也是对这个字段-1，一直到0，此线程对锁释放。</li></ol><h3 id="3-2-JUC中的应用场景"><a href="#3-2-JUC中的应用场景" class="headerlink" title="3.2 JUC中的应用场景"></a>3.2 JUC中的应用场景</h3><p>除了上边ReentrantLock的可重入性的应用，AQS作为并发编程的框架，为很多其他同步工具提供了良好的解决方案。下面列出了JUC中的几种同步工具，大体介绍一下AQS的应用场景：</p><table><thead><tr><th align="left">同步工具</th><th align="left">同步工具与AQS的关联</th></tr></thead><tbody><tr><td align="left">ReentrantLock</td><td align="left">使用AQS保存锁重复持有的次数。当一个线程获取锁时，ReentrantLock记录当前获得锁的线程标识，用于检测是否重复获取，以及错误线程试图解锁操作时异常情况的处理。</td></tr><tr><td align="left">Semaphore</td><td align="left">使用AQS同步状态来保存信号量的当前计数。tryRelease会增加计数，acquireShared会减少计数。</td></tr><tr><td align="left">CountDownLatch</td><td align="left">使用AQS同步状态来表示计数。计数为0时，所有的Acquire操作（CountDownLatch的await方法）才可以通过。</td></tr><tr><td align="left">ReentrantReadWriteLock</td><td align="left">使用AQS同步状态中的16位保存写锁持有的次数，剩下的16位用于保存读锁的持有次数。</td></tr><tr><td align="left">ThreadPoolExecutor</td><td align="left">Worker利用AQS同步状态实现对独占线程变量的设置（tryAcquire和tryRelease）。</td></tr></tbody></table><h3 id="3-3-自定义同步工具"><a href="#3-3-自定义同步工具" class="headerlink" title="3.3 自定义同步工具"></a>3.3 自定义同步工具</h3><p>了解AQS基本原理以后，按照上面所说的AQS知识点，自己实现一个同步工具。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">LeeLock</span>  </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">static</span> <span class="class"><span class="keyword">class</span> <span class="title">Sync</span> <span class="keyword">extends</span> <span class="title">AbstractQueuedSynchronizer</span> </span>&#123;</span><br><span class="line">        <span class="meta">@Override</span></span><br><span class="line">        <span class="function"><span class="keyword">protected</span> <span class="keyword">boolean</span> <span class="title">tryAcquire</span> <span class="params">(<span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line">            <span class="keyword">return</span> compareAndSetState(<span class="number">0</span>, <span class="number">1</span>);</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="meta">@Override</span></span><br><span class="line">        <span class="function"><span class="keyword">protected</span> <span class="keyword">boolean</span> <span class="title">tryRelease</span> <span class="params">(<span class="keyword">int</span> arg)</span> </span>&#123;</span><br><span class="line">            setState(<span class="number">0</span>);</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="meta">@Override</span></span><br><span class="line">        <span class="function"><span class="keyword">protected</span> <span class="keyword">boolean</span> <span class="title">isHeldExclusively</span> <span class="params">()</span> </span>&#123;</span><br><span class="line">            <span class="keyword">return</span> getState() == <span class="number">1</span>;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="keyword">private</span> Sync sync = <span class="keyword">new</span> Sync();</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">lock</span> <span class="params">()</span> </span>&#123;</span><br><span class="line">        sync.acquire(<span class="number">1</span>);</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">unlock</span> <span class="params">()</span> </span>&#123;</span><br><span class="line">        sync.release(<span class="number">1</span>);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>通过我们自己定义的Lock完成一定的同步功能。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">LeeMain</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">static</span> <span class="keyword">int</span> count = <span class="number">0</span>;</span><br><span class="line">    <span class="keyword">static</span> LeeLock leeLock = <span class="keyword">new</span> LeeLock();</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span> <span class="params">(String[] args)</span> <span class="keyword">throws</span> InterruptedException </span>&#123;</span><br><span class="line"></span><br><span class="line">        Runnable runnable = <span class="keyword">new</span> Runnable() &#123;</span><br><span class="line">            <span class="meta">@Override</span></span><br><span class="line">            <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">run</span> <span class="params">()</span> </span>&#123;</span><br><span class="line">                <span class="keyword">try</span> &#123;</span><br><span class="line">                    leeLock.lock();</span><br><span class="line">                    <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; <span class="number">10000</span>; i++) &#123;</span><br><span class="line">                        count++;</span><br><span class="line">                    &#125;</span><br><span class="line">                &#125; <span class="keyword">catch</span> (Exception e) &#123;</span><br><span class="line">                    e.printStackTrace();</span><br><span class="line">                &#125; <span class="keyword">finally</span> &#123;</span><br><span class="line">                    leeLock.unlock();</span><br><span class="line">                &#125;</span><br><span class="line"></span><br><span class="line">            &#125;</span><br><span class="line">        &#125;;</span><br><span class="line">        Thread thread1 = <span class="keyword">new</span> Thread(runnable);</span><br><span class="line">        Thread thread2 = <span class="keyword">new</span> Thread(runnable);</span><br><span class="line">        thread1.start();</span><br><span class="line">        thread2.start();</span><br><span class="line">        thread1.join();</span><br><span class="line">        thread2.join();</span><br><span class="line">        System.out.println(count);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>上述代码每次运行结果都会是20000。通过简单的几行代码就能实现同步功能，这就是AQS的强大之处。</p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>我们日常开发中使用并发的场景太多，但是对并发内部的基本框架原理了解的人却不多。由于篇幅原因，本文仅介绍了可重入锁ReentrantLock的原理和AQS原理，希望能够成为大家了解AQS和ReentrantLock等同步器的“敲门砖”。</p><h2 id="参考资料"><a href="#参考资料" class="headerlink" title="参考资料"></a>参考资料</h2><ul><li>Lea D. The java. util. concurrent synchronizer framework[J]. Science of Computer Programming, 2005, 58(3): 293-309.</li><li>《Java并发编程实战》</li><li><a href="https://tech.meituan.com/2018/11/15/java-lock.html" target="_blank" rel="noopener">不可不说的Java“锁”事</a></li></ul>]]></content>
    
    <summary type="html">
    
      &lt;h1 id=&quot;从ReentrantLock的实现看AQS的原理及应用&quot;&gt;&lt;a href=&quot;#从ReentrantLock的实现看AQS的原理及应用&quot; class=&quot;headerlink&quot; title=&quot;从ReentrantLock的实现看AQS的原理及应用&quot;&gt;&lt;/a&gt;&lt;a href=&quot;https://tech.meituan.com/2019/12/05/aqs-theory-and-apply.html&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;从ReentrantLock的实现看AQS的原理及应用&lt;/a&gt;&lt;/h1&gt;&lt;h2 id=&quot;前言&quot;&gt;&lt;a href=&quot;#前言&quot; class=&quot;headerlink&quot; title=&quot;前言&quot;&gt;&lt;/a&gt;前言&lt;/h2&gt;&lt;p&gt;Java中的大部分同步类（Lock、Semaphore、ReentrantLock等）都是基于AbstractQueuedSynchronizer（简称为AQS）实现的。AQS是一种提供了原子式管理同步状态、阻塞和唤醒线程功能以及队列模型的简单框架。本文会从应用层逐渐深入到原理层，并通过ReentrantLock的基本特性和ReentrantLock与AQS的关联，来深入解读AQS相关独占锁的知识点，同时采取问答的模式来帮助大家理解AQS。由于篇幅原因，本篇文章主要阐述AQS中独占锁的逻辑和Sync Queue，不讲述包含共享锁和Condition Queue的部分（本篇文章核心为AQS原理剖析，只是简单介绍了ReentrantLock，感兴趣同学可以阅读一下ReentrantLock的源码）。&lt;/p&gt;
&lt;p&gt;下面列出本篇文章的大纲和思路，以便于大家更好地理解：&lt;/p&gt;
&lt;p&gt;&lt;img src=&quot;https://p1.meituan.net/travelcube/9d182d944e0889c304ef529ba50a4fcd205214.png&quot; alt=&quot;img&quot;&gt;&lt;/p&gt;
    
    </summary>
    
    
      <category term="多线程" scheme="https://zrbac.github.io/categories/%E5%A4%9A%E7%BA%BF%E7%A8%8B/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>Java锁相关</title>
    <link href="https://zrbac.github.io/2020/09/11/Java%E9%94%81%E7%9B%B8%E5%85%B3/"/>
    <id>https://zrbac.github.io/2020/09/11/Java%E9%94%81%E7%9B%B8%E5%85%B3/</id>
    <published>2020-09-11T00:48:52.000Z</published>
    <updated>2020-09-11T00:50:09.294Z</updated>
    
    <content type="html"><![CDATA[<h2 id="前言"><a href="#前言" class="headerlink" title="前言"></a>前言</h2><p>Java提供了种类丰富的锁，每种锁因其特性的不同，在适当的场景下能够展现出非常高的效率。本文旨在对锁相关源码（本文中的源码来自JDK 8和Netty 3.10.6）、使用场景进行举例，为读者介绍主流锁的知识点，以及不同的锁的适用场景。</p><p>Java中往往是按照是否含有某一特性来定义锁，我们通过特性将锁进行分组归类，再使用对比的方式进行介绍，帮助大家更快捷的理解相关知识。下面给出本文内容的总体分类目录：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/7f749fc8.png" alt="img"></p><a id="more"></a><h3 id="1-乐观锁-VS-悲观锁"><a href="#1-乐观锁-VS-悲观锁" class="headerlink" title="1. 乐观锁 VS 悲观锁"></a>1. 乐观锁 VS 悲观锁</h3><p>乐观锁与悲观锁是一种广义上的概念，体现了看待线程同步的不同角度。在Java和数据库中都有此概念对应的实际应用。</p><p>先说概念。对于同一个数据的并发操作，悲观锁认为自己在使用数据的时候一定有别的线程来修改数据，因此在获取数据的时候会先加锁，确保数据不会被别的线程修改。Java中，synchronized关键字和Lock的实现类都是悲观锁。</p><p>而乐观锁认为自己在使用数据时不会有别的线程修改数据，所以不会添加锁，只是在更新数据的时候去判断之前有没有别的线程更新了这个数据。如果这个数据没有被更新，当前线程将自己修改的数据成功写入。如果数据已经被其他线程更新，则根据不同的实现方式执行不同的操作（例如报错或者自动重试）。</p><p>乐观锁在Java中是通过使用无锁编程来实现，最常采用的是CAS算法，Java原子类中的递增操作就通过CAS自旋实现的。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/c8703cd9.png" alt="img"></p><p>根据从上面的概念描述我们可以发现：</p><ul><li>悲观锁适合写操作多的场景，先加锁可以保证写操作时数据正确。</li><li>乐观锁适合读操作多的场景，不加锁的特点能够使其读操作的性能大幅提升。</li></ul><p>光说概念有些抽象，我们来看下乐观锁和悲观锁的调用方式示例：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// ------------------------- 悲观锁的调用方式 -------------------------</span></span><br><span class="line"><span class="comment">// synchronized</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">synchronized</span> <span class="keyword">void</span> <span class="title">testMethod</span><span class="params">()</span> </span>&#123;</span><br><span class="line"><span class="comment">// 操作同步资源</span></span><br><span class="line">&#125;</span><br><span class="line"><span class="comment">// ReentrantLock</span></span><br><span class="line"><span class="keyword">private</span> ReentrantLock lock = <span class="keyword">new</span> ReentrantLock(); <span class="comment">// 需要保证多个线程使用的是同一个锁</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">modifyPublicResources</span><span class="params">()</span> </span>&#123;</span><br><span class="line">lock.lock();</span><br><span class="line"><span class="comment">// 操作同步资源</span></span><br><span class="line">lock.unlock();</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="comment">// ------------------------- 乐观锁的调用方式 -------------------------</span></span><br><span class="line"><span class="keyword">private</span> AtomicInteger atomicInteger = <span class="keyword">new</span> AtomicInteger();  <span class="comment">// 需要保证多个线程使用的是同一个AtomicInteger</span></span><br><span class="line">atomicInteger.incrementAndGet(); <span class="comment">//执行自增1</span></span><br></pre></td></tr></table></figure><p>通过调用方式示例，我们可以发现悲观锁基本都是在显式的锁定之后再操作同步资源，而乐观锁则直接去操作同步资源。那么，为何乐观锁能够做到不锁定同步资源也可以正确的实现线程同步呢？我们通过介绍乐观锁的主要实现方式 “CAS” 的技术原理来为大家解惑。</p><p>CAS全称 Compare And Swap（比较与交换），是一种无锁算法。在不使用锁（没有线程被阻塞）的情况下实现多线程之间的变量同步。java.util.concurrent包中的原子类就是通过CAS来实现了乐观锁。</p><p>CAS算法涉及到三个操作数：</p><ul><li>需要读写的内存值 V。</li><li>进行比较的值 A。</li><li>要写入的新值 B。</li></ul><p>当且仅当 V 的值等于 A 时，CAS通过原子方式用新值B来更新V的值（“比较+更新”整体是一个原子操作），否则不会执行任何操作。一般情况下，“更新”是一个不断重试的操作。</p><p>之前提到java.util.concurrent包中的原子类，就是通过CAS来实现了乐观锁，那么我们进入原子类AtomicInteger的源码，看一下AtomicInteger的定义：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/feda866e.png" alt="img"></p><p>根据定义我们可以看出各属性的作用：</p><ul><li>unsafe： 获取并操作内存的数据。</li><li>valueOffset： 存储value在AtomicInteger中的偏移量。</li><li>value： 存储AtomicInteger的int值，该属性需要借助volatile关键字保证其在线程间是可见的。</li></ul><p>接下来，我们查看AtomicInteger的自增函数incrementAndGet()的源码时，发现自增函数底层调用的是unsafe.getAndAddInt()。但是由于JDK本身只有Unsafe.class，只通过class文件中的参数名，并不能很好的了解方法的作用，所以我们通过OpenJDK 8 来查看Unsafe的源码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// ------------------------- JDK 8 -------------------------</span></span><br><span class="line"><span class="comment">// AtomicInteger 自增方法</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">int</span> <span class="title">incrementAndGet</span><span class="params">()</span> </span>&#123;</span><br><span class="line">  <span class="keyword">return</span> unsafe.getAndAddInt(<span class="keyword">this</span>, valueOffset, <span class="number">1</span>) + <span class="number">1</span>;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="comment">// Unsafe.class</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">int</span> <span class="title">getAndAddInt</span><span class="params">(Object var1, <span class="keyword">long</span> var2, <span class="keyword">int</span> var4)</span> </span>&#123;</span><br><span class="line">  <span class="keyword">int</span> var5;</span><br><span class="line">  <span class="keyword">do</span> &#123;</span><br><span class="line">      var5 = <span class="keyword">this</span>.getIntVolatile(var1, var2);</span><br><span class="line">  &#125; <span class="keyword">while</span>(!<span class="keyword">this</span>.compareAndSwapInt(var1, var2, var5, var5 + var4));</span><br><span class="line">  <span class="keyword">return</span> var5;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="comment">// ------------------------- OpenJDK 8 -------------------------</span></span><br><span class="line"><span class="comment">// Unsafe.java</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">int</span> <span class="title">getAndAddInt</span><span class="params">(Object o, <span class="keyword">long</span> offset, <span class="keyword">int</span> delta)</span> </span>&#123;</span><br><span class="line">   <span class="keyword">int</span> v;</span><br><span class="line">   <span class="keyword">do</span> &#123;</span><br><span class="line">       v = getIntVolatile(o, offset);</span><br><span class="line">   &#125; <span class="keyword">while</span> (!compareAndSwapInt(o, offset, v, v + delta));</span><br><span class="line">   <span class="keyword">return</span> v;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>根据OpenJDK 8的源码我们可以看出，getAndAddInt()循环获取给定对象o中的偏移量处的值v，然后判断内存值是否等于v。如果相等则将内存值设置为 v + delta，否则返回false，继续循环进行重试，直到设置成功才能退出循环，并且将旧值返回。整个“比较+更新”操作封装在compareAndSwapInt()中，在JNI里是借助于一个CPU指令完成的，属于原子操作，可以保证多个线程都能够看到同一个变量的修改值。</p><p>后续JDK通过CPU的cmpxchg指令，去比较寄存器中的 A 和 内存中的值 V。如果相等，就把要写入的新值 B 存入内存中。如果不相等，就将内存值 V 赋值给寄存器中的值 A。然后通过Java代码中的while循环再次调用cmpxchg指令进行重试，直到设置成功为止。</p><p>CAS虽然很高效，但是它也存在三大问题，这里也简单说一下：</p><ol><li><p>ABA问题</p><p>。CAS需要在操作值的时候检查内存值是否发生变化，没有发生变化才会更新内存值。但是如果内存值原来是A，后来变成了B，然后又变成了A，那么CAS进行检查时会发现值没有发生变化，但是实际上是有变化的。ABA问题的解决思路就是在变量前面添加版本号，每次变量更新的时候都把版本号加一，这样变化过程就从“A－B－A”变成了“1A－2B－3A”。</p><ul><li>JDK从1.5开始提供了AtomicStampedReference类来解决ABA问题，具体操作封装在compareAndSet()中。compareAndSet()首先检查当前引用和当前标志与预期引用和预期标志是否相等，如果都相等，则以原子方式将引用值和标志的值设置为给定的更新值。</li></ul></li><li><p><strong>循环时间长开销大</strong>。CAS操作如果长时间不成功，会导致其一直自旋，给CPU带来非常大的开销。</p></li><li><p>只能保证一个共享变量的原子操作</p><p>。对一个共享变量执行操作时，CAS能够保证原子操作，但是对多个共享变量操作时，CAS是无法保证操作的原子性的。</p><ul><li>Java从1.5开始JDK提供了AtomicReference类来保证引用对象之间的原子性，可以把多个变量放在一个对象里来进行CAS操作。</li></ul></li></ol><h3 id="2-自旋锁-VS-适应性自旋锁"><a href="#2-自旋锁-VS-适应性自旋锁" class="headerlink" title="2. 自旋锁 VS 适应性自旋锁"></a>2. 自旋锁 VS 适应性自旋锁</h3><p>在介绍自旋锁前，我们需要介绍一些前提知识来帮助大家明白自旋锁的概念。</p><p>阻塞或唤醒一个Java线程需要操作系统切换CPU状态来完成，这种状态转换需要耗费处理器时间。如果同步代码块中的内容过于简单，状态转换消耗的时间有可能比用户代码执行的时间还要长。</p><p>在许多场景中，同步资源的锁定时间很短，为了这一小段时间去切换线程，线程挂起和恢复现场的花费可能会让系统得不偿失。如果物理机器有多个处理器，能够让两个或以上的线程同时并行执行，我们就可以让后面那个请求锁的线程不放弃CPU的执行时间，看看持有锁的线程是否很快就会释放锁。</p><p>而为了让当前线程“稍等一下”，我们需让当前线程进行自旋，如果在自旋完成后前面锁定同步资源的线程已经释放了锁，那么当前线程就可以不必阻塞而是直接获取同步资源，从而避免切换线程的开销。这就是自旋锁。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/452a3363.png" alt="img"></p><p>自旋锁本身是有缺点的，它不能代替阻塞。自旋等待虽然避免了线程切换的开销，但它要占用处理器时间。如果锁被占用的时间很短，自旋等待的效果就会非常好。反之，如果锁被占用的时间很长，那么自旋的线程只会白浪费处理器资源。所以，自旋等待的时间必须要有一定的限度，如果自旋超过了限定次数（默认是10次，可以使用-XX:PreBlockSpin来更改）没有成功获得锁，就应当挂起线程。</p><p>自旋锁的实现原理同样也是CAS，AtomicInteger中调用unsafe进行自增操作的源码中的do-while循环就是一个自旋操作，如果修改数值失败则通过循环来执行自旋，直至修改成功。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/83b3f85e.png" alt="img"></p><p>自旋锁在JDK1.4.2中引入，使用-XX:+UseSpinning来开启。JDK 6中变为默认开启，并且引入了自适应的自旋锁（适应性自旋锁）。</p><p>自适应意味着自旋的时间（次数）不再固定，而是由前一次在同一个锁上的自旋时间及锁的拥有者的状态来决定。如果在同一个锁对象上，自旋等待刚刚成功获得过锁，并且持有锁的线程正在运行中，那么虚拟机就会认为这次自旋也是很有可能再次成功，进而它将允许自旋等待持续相对更长的时间。如果对于某个锁，自旋很少成功获得过，那在以后尝试获取这个锁时将可能省略掉自旋过程，直接阻塞线程，避免浪费处理器资源。</p><p>在自旋锁中 另有三种常见的锁形式:TicketLock、CLHlock和MCSlock，本文中仅做名词介绍，不做深入讲解，感兴趣的同学可以自行查阅相关资料。</p><h3 id="3-无锁-VS-偏向锁-VS-轻量级锁-VS-重量级锁"><a href="#3-无锁-VS-偏向锁-VS-轻量级锁-VS-重量级锁" class="headerlink" title="3. 无锁 VS 偏向锁 VS 轻量级锁 VS 重量级锁"></a>3. 无锁 VS 偏向锁 VS 轻量级锁 VS 重量级锁</h3><p>这四种锁是指锁的状态，专门针对synchronized的。在介绍这四种锁状态之前还需要介绍一些额外的知识。</p><p>首先为什么Synchronized能实现线程同步？</p><p>在回答这个问题之前我们需要了解两个重要的概念：“Java对象头”、“Monitor”。</p><h4 id="Java对象头"><a href="#Java对象头" class="headerlink" title="Java对象头"></a>Java对象头</h4><p>synchronized是悲观锁，在操作同步资源之前需要给同步资源先加锁，这把锁就是存在Java对象头里的，而Java对象头又是什么呢？</p><p>我们以Hotspot虚拟机为例，Hotspot的对象头主要包括两部分数据：Mark Word（标记字段）、Klass Pointer（类型指针）。</p><p><strong>Mark Word</strong>：默认存储对象的HashCode，分代年龄和锁标志位信息。这些信息都是与对象自身定义无关的数据，所以Mark Word被设计成一个非固定的数据结构以便在极小的空间内存存储尽量多的数据。它会根据对象的状态复用自己的存储空间，也就是说在运行期间Mark Word里存储的数据会随着锁标志位的变化而变化。</p><p><strong>Klass Point</strong>：对象指向它的类元数据的指针，虚拟机通过这个指针来确定这个对象是哪个类的实例。</p><h4 id="Monitor"><a href="#Monitor" class="headerlink" title="Monitor"></a>Monitor</h4><p>Monitor可以理解为一个同步工具或一种同步机制，通常被描述为一个对象。每一个Java对象就有一把看不见的锁，称为内部锁或者Monitor锁。</p><p>Monitor是线程私有的数据结构，每一个线程都有一个可用monitor record列表，同时还有一个全局的可用列表。每一个被锁住的对象都会和一个monitor关联，同时monitor中有一个Owner字段存放拥有该锁的线程的唯一标识，表示该锁被这个线程占用。</p><p>现在话题回到synchronized，synchronized通过Monitor来实现线程同步，Monitor是依赖于底层的操作系统的Mutex Lock（互斥锁）来实现的线程同步。</p><p>如同我们在自旋锁中提到的“阻塞或唤醒一个Java线程需要操作系统切换CPU状态来完成，这种状态转换需要耗费处理器时间。如果同步代码块中的内容过于简单，状态转换消耗的时间有可能比用户代码执行的时间还要长”。这种方式就是synchronized最初实现同步的方式，这就是JDK 6之前synchronized效率低的原因。这种依赖于操作系统Mutex Lock所实现的锁我们称之为“重量级锁”，JDK 6中为了减少获得锁和释放锁带来的性能消耗，引入了“偏向锁”和“轻量级锁”。</p><p>所以目前锁一共有4种状态，级别从低到高依次是：无锁、偏向锁、轻量级锁和重量级锁。锁状态只能升级不能降级。</p><p>通过上面的介绍，我们对synchronized的加锁机制以及相关知识有了一个了解，那么下面我们给出四种锁状态对应的的Mark Word内容，然后再分别讲解四种锁状态的思路以及特点：</p><table><thead><tr><th align="left">锁状态</th><th align="left">存储内容</th><th align="left">存储内容</th></tr></thead><tbody><tr><td align="left">无锁</td><td align="left">对象的hashCode、对象分代年龄、是否是偏向锁（0）</td><td align="left">01</td></tr><tr><td align="left">偏向锁</td><td align="left">偏向线程ID、偏向时间戳、对象分代年龄、是否是偏向锁（1）</td><td align="left">01</td></tr><tr><td align="left">轻量级锁</td><td align="left">指向栈中锁记录的指针</td><td align="left">00</td></tr><tr><td align="left">重量级锁</td><td align="left">指向互斥量（重量级锁）的指针</td><td align="left">10</td></tr></tbody></table><p><strong>无锁</strong></p><p>无锁没有对资源进行锁定，所有的线程都能访问并修改同一个资源，但同时只有一个线程能修改成功。</p><p>无锁的特点就是修改操作在循环内进行，线程会不断的尝试修改共享资源。如果没有冲突就修改成功并退出，否则就会继续循环尝试。如果有多个线程修改同一个值，必定会有一个线程能修改成功，而其他修改失败的线程会不断重试直到修改成功。上面我们介绍的CAS原理及应用即是无锁的实现。无锁无法全面代替有锁，但无锁在某些场合下的性能是非常高的。</p><p><strong>偏向锁</strong></p><p>偏向锁是指一段同步代码一直被一个线程所访问，那么该线程会自动获取锁，降低获取锁的代价。</p><p>在大多数情况下，锁总是由同一线程多次获得，不存在多线程竞争，所以出现了偏向锁。其目标就是在只有一个线程执行同步代码块时能够提高性能。</p><p>当一个线程访问同步代码块并获取锁时，会在Mark Word里存储锁偏向的线程ID。在线程进入和退出同步块时不再通过CAS操作来加锁和解锁，而是检测Mark Word里是否存储着指向当前线程的偏向锁。引入偏向锁是为了在无多线程竞争的情况下尽量减少不必要的轻量级锁执行路径，因为轻量级锁的获取及释放依赖多次CAS原子指令，而偏向锁只需要在置换ThreadID的时候依赖一次CAS原子指令即可。</p><p>偏向锁只有遇到其他线程尝试竞争偏向锁时，持有偏向锁的线程才会释放锁，线程不会主动释放偏向锁。偏向锁的撤销，需要等待全局安全点（在这个时间点上没有字节码正在执行），它会首先暂停拥有偏向锁的线程，判断锁对象是否处于被锁定状态。撤销偏向锁后恢复到无锁（标志位为“01”）或轻量级锁（标志位为“00”）的状态。</p><p>偏向锁在JDK 6及以后的JVM里是默认启用的。可以通过JVM参数关闭偏向锁：-XX:-UseBiasedLocking=false，关闭之后程序默认会进入轻量级锁状态。</p><p><strong>轻量级锁</strong></p><p>是指当锁是偏向锁的时候，被另外的线程所访问，偏向锁就会升级为轻量级锁，其他线程会通过自旋的形式尝试获取锁，不会阻塞，从而提高性能。</p><p>在代码进入同步块的时候，如果同步对象锁状态为无锁状态（锁标志位为“01”状态，是否为偏向锁为“0”），虚拟机首先将在当前线程的栈帧中建立一个名为锁记录（Lock Record）的空间，用于存储锁对象目前的Mark Word的拷贝，然后拷贝对象头中的Mark Word复制到锁记录中。</p><p>拷贝成功后，虚拟机将使用CAS操作尝试将对象的Mark Word更新为指向Lock Record的指针，并将Lock Record里的owner指针指向对象的Mark Word。</p><p>如果这个更新动作成功了，那么这个线程就拥有了该对象的锁，并且对象Mark Word的锁标志位设置为“00”，表示此对象处于轻量级锁定状态。</p><p>如果轻量级锁的更新操作失败了，虚拟机首先会检查对象的Mark Word是否指向当前线程的栈帧，如果是就说明当前线程已经拥有了这个对象的锁，那就可以直接进入同步块继续执行，否则说明多个线程竞争锁。</p><p>若当前只有一个等待线程，则该线程通过自旋进行等待。但是当自旋超过一定的次数，或者一个线程在持有锁，一个在自旋，又有第三个来访时，轻量级锁升级为重量级锁。</p><p><strong>重量级锁</strong></p><p>升级为重量级锁时，锁标志的状态值变为“10”，此时Mark Word中存储的是指向重量级锁的指针，此时等待锁的线程都会进入阻塞状态。</p><p>整体的锁状态升级流程如下：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/8afdf6f2.png" alt="img"></p><p>综上，偏向锁通过对比Mark Word解决加锁问题，避免执行CAS操作。而轻量级锁是通过用CAS操作和自旋来解决加锁问题，避免线程阻塞和唤醒而影响性能。重量级锁是将除了拥有锁的线程以外的线程都阻塞。</p><h3 id="4-公平锁-VS-非公平锁"><a href="#4-公平锁-VS-非公平锁" class="headerlink" title="4. 公平锁 VS 非公平锁"></a>4. 公平锁 VS 非公平锁</h3><p>公平锁是指多个线程按照申请锁的顺序来获取锁，线程直接进入队列中排队，队列中的第一个线程才能获得锁。公平锁的优点是等待锁的线程不会饿死。缺点是整体吞吐效率相对非公平锁要低，等待队列中除第一个线程以外的所有线程都会阻塞，CPU唤醒阻塞线程的开销比非公平锁大。</p><p>非公平锁是多个线程加锁时直接尝试获取锁，获取不到才会到等待队列的队尾等待。但如果此时锁刚好可用，那么这个线程可以无需阻塞直接获取到锁，所以非公平锁有可能出现后申请锁的线程先获取锁的场景。非公平锁的优点是可以减少唤起线程的开销，整体的吞吐效率高，因为线程有几率不阻塞直接获得锁，CPU不必唤醒所有线程。缺点是处于等待队列中的线程可能会饿死，或者等很久才会获得锁。</p><p>直接用语言描述可能有点抽象，这里作者用从别处看到的一个例子来讲述一下公平锁和非公平锁。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/a23d746a.png" alt="img"></p><p>如上图所示，假设有一口水井，有管理员看守，管理员有一把锁，只有拿到锁的人才能够打水，打完水要把锁还给管理员。每个过来打水的人都要管理员的允许并拿到锁之后才能去打水，如果前面有人正在打水，那么这个想要打水的人就必须排队。管理员会查看下一个要去打水的人是不是队伍里排最前面的人，如果是的话，才会给你锁让你去打水；如果你不是排第一的人，就必须去队尾排队，这就是公平锁。</p><p>但是对于非公平锁，管理员对打水的人没有要求。即使等待队伍里有排队等待的人，但如果在上一个人刚打完水把锁还给管理员而且管理员还没有允许等待队伍里下一个人去打水时，刚好来了一个插队的人，这个插队的人是可以直接从管理员那里拿到锁去打水，不需要排队，原本排队等待的人只能继续等待。如下图所示：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/4499559e.png" alt="img"></p><p>接下来我们通过ReentrantLock的源码来讲解公平锁和非公平锁。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/6edea205.png" alt="img"></p><p>根据代码可知，ReentrantLock里面有一个内部类Sync，Sync继承AQS（AbstractQueuedSynchronizer），添加锁和释放锁的大部分操作实际上都是在Sync中实现的。它有公平锁FairSync和非公平锁NonfairSync两个子类。ReentrantLock默认使用非公平锁，也可以通过构造器来显示的指定使用公平锁。</p><p>下面我们来看一下公平锁与非公平锁的加锁方法的源码:</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/bc6fe583.png" alt="img"></p><p>通过上图中的源代码对比，我们可以明显的看出公平锁与非公平锁的lock()方法唯一的区别就在于公平锁在获取同步状态时多了一个限制条件：hasQueuedPredecessors()。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/bd0036bb.png" alt="img"></p><p>再进入hasQueuedPredecessors()，可以看到该方法主要做一件事情：主要是判断当前线程是否位于同步队列中的第一个。如果是则返回true，否则返回false。</p><p>综上，公平锁就是通过同步队列来实现多个线程按照申请锁的顺序来获取锁，从而实现公平的特性。非公平锁加锁时不考虑排队等待问题，直接尝试获取锁，所以存在后申请却先获得锁的情况。</p><h3 id="5-可重入锁-VS-非可重入锁"><a href="#5-可重入锁-VS-非可重入锁" class="headerlink" title="5. 可重入锁 VS 非可重入锁"></a>5. 可重入锁 VS 非可重入锁</h3><p>可重入锁又名递归锁，是指在同一个线程在外层方法获取锁的时候，再进入该线程的内层方法会自动获取锁（前提锁对象得是同一个对象或者class），不会因为之前已经获取过还没释放而阻塞。Java中ReentrantLock和synchronized都是可重入锁，可重入锁的一个优点是可一定程度避免死锁。下面用示例代码来进行分析：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Widget</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">synchronized</span> <span class="keyword">void</span> <span class="title">doSomething</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        System.out.println(<span class="string">"方法1执行..."</span>);</span><br><span class="line">        doOthers();</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">synchronized</span> <span class="keyword">void</span> <span class="title">doOthers</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        System.out.println(<span class="string">"方法2执行..."</span>);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>在上面的代码中，类中的两个方法都是被内置锁synchronized修饰的，doSomething()方法中调用doOthers()方法。因为内置锁是可重入的，所以同一个线程在调用doOthers()时可以直接获得当前对象的锁，进入doOthers()进行操作。</p><p>如果是一个不可重入锁，那么当前线程在调用doOthers()之前需要将执行doSomething()时获取当前对象的锁释放掉，实际上该对象锁已被当前线程所持有，且无法释放。所以此时会出现死锁。</p><p>而为什么可重入锁就可以在嵌套调用时可以自动获得锁呢？我们通过图示和源码来分别解析一下。</p><p>还是打水的例子，有多个人在排队打水，此时管理员允许锁和同一个人的多个水桶绑定。这个人用多个水桶打水时，第一个水桶和锁绑定并打完水之后，第二个水桶也可以直接和锁绑定并开始打水，所有的水桶都打完水之后打水人才会将锁还给管理员。这个人的所有打水流程都能够成功执行，后续等待的人也能够打到水。这就是可重入锁。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/58fc5bc9.png" alt="img"></p><p>但如果是非可重入锁的话，此时管理员只允许锁和同一个人的一个水桶绑定。第一个水桶和锁绑定打完水之后并不会释放锁，导致第二个水桶不能和锁绑定也无法打水。当前线程出现死锁，整个等待队列中的所有线程都无法被唤醒。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/ea597a0c.png" alt="img"></p><p>之前我们说过ReentrantLock和synchronized都是重入锁，那么我们通过重入锁ReentrantLock以及非可重入锁NonReentrantLock的源码来对比分析一下为什么非可重入锁在重复调用同步资源时会出现死锁。</p><p>首先ReentrantLock和NonReentrantLock都继承父类AQS，其父类AQS中维护了一个同步状态status来计数重入次数，status初始值为0。</p><p>当线程尝试获取锁时，可重入锁先尝试获取并更新status值，如果status == 0表示没有其他线程在执行同步代码，则把status置为1，当前线程开始执行。如果status != 0，则判断当前线程是否是获取到这个锁的线程，如果是的话执行status+1，且当前线程可以再次获取锁。而非可重入锁是直接去获取并尝试更新当前status的值，如果status != 0的话会导致其获取锁失败，当前线程阻塞。</p><p>释放锁时，可重入锁同样先获取当前status的值，在当前线程是持有锁的线程的前提下。如果status-1 == 0，则表示当前线程所有重复获取锁的操作都已经执行完毕，然后该线程才会真正释放锁。而非可重入锁则是在确定当前线程是持有锁的线程之后，直接将status置为0，将锁释放。</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/32536e7a.png" alt="img"></p><h3 id="6-独享锁-VS-共享锁"><a href="#6-独享锁-VS-共享锁" class="headerlink" title="6. 独享锁 VS 共享锁"></a>6. 独享锁 VS 共享锁</h3><p>独享锁和共享锁同样是一种概念。我们先介绍一下具体的概念，然后通过ReentrantLock和ReentrantReadWriteLock的源码来介绍独享锁和共享锁。</p><p>独享锁也叫排他锁，是指该锁一次只能被一个线程所持有。如果线程T对数据A加上排它锁后，则其他线程不能再对A加任何类型的锁。获得排它锁的线程即能读数据又能修改数据。JDK中的synchronized和JUC中Lock的实现类就是互斥锁。</p><p>共享锁是指该锁可被多个线程所持有。如果线程T对数据A加上共享锁后，则其他线程只能对A再加共享锁，不能加排它锁。获得共享锁的线程只能读数据，不能修改数据。</p><p>独享锁与共享锁也是通过AQS来实现的，通过实现不同的方法，来实现独享或者共享。</p><p>下图为ReentrantReadWriteLock的部分源码：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/762a042b.png" alt="img"></p><p>我们看到ReentrantReadWriteLock有两把锁：ReadLock和WriteLock，由词知意，一个读锁一个写锁，合称“读写锁”。再进一步观察可以发现ReadLock和WriteLock是靠内部类Sync实现的锁。Sync是AQS的一个子类，这种结构在CountDownLatch、ReentrantLock、Semaphore里面也都存在。</p><p>在ReentrantReadWriteLock里面，读锁和写锁的锁主体都是Sync，但读锁和写锁的加锁方式不一样。读锁是共享锁，写锁是独享锁。读锁的共享锁可保证并发读非常高效，而读写、写读、写写的过程互斥，因为读锁和写锁是分离的。所以ReentrantReadWriteLock的并发性相比一般的互斥锁有了很大提升。</p><p>那读锁和写锁的具体加锁方式有什么区别呢？在了解源码之前我们需要回顾一下其他知识。 在最开始提及AQS的时候我们也提到了state字段（int类型，32位），该字段用来描述有多少线程获持有锁。</p><p>在独享锁中这个值通常是0或者1（如果是重入锁的话state值就是重入的次数），在共享锁中state就是持有锁的数量。但是在ReentrantReadWriteLock中有读、写两把锁，所以需要在一个整型变量state上分别描述读锁和写锁的数量（或者也可以叫状态）。于是将state变量“按位切割”切分成了两个部分，高16位表示读锁状态（读锁个数），低16位表示写锁状态（写锁个数）。如下图所示：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/8793e00a.png" alt="img"></p><p>了解了概念之后我们再来看代码，先看写锁的加锁源码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">protected</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">tryAcquire</span><span class="params">(<span class="keyword">int</span> acquires)</span> </span>&#123;</span><br><span class="line">Thread current = Thread.currentThread();</span><br><span class="line"><span class="keyword">int</span> c = getState(); <span class="comment">// 取到当前锁的个数</span></span><br><span class="line"><span class="keyword">int</span> w = exclusiveCount(c); <span class="comment">// 取写锁的个数w</span></span><br><span class="line"><span class="keyword">if</span> (c != <span class="number">0</span>) &#123; <span class="comment">// 如果已经有线程持有了锁(c!=0)</span></span><br><span class="line">    <span class="comment">// (Note: if c != 0 and w == 0 then shared count != 0)</span></span><br><span class="line"><span class="keyword">if</span> (w == <span class="number">0</span> || current != getExclusiveOwnerThread()) <span class="comment">// 如果写线程数（w）为0（换言之存在读锁） 或者持有锁的线程不是当前线程就返回失败</span></span><br><span class="line"><span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line"><span class="keyword">if</span> (w + exclusiveCount(acquires) &gt; MAX_COUNT)    <span class="comment">// 如果写入锁的数量大于最大数（65535，2的16次方-1）就抛出一个Error。</span></span><br><span class="line">      <span class="keyword">throw</span> <span class="keyword">new</span> Error(<span class="string">"Maximum lock count exceeded"</span>);</span><br><span class="line"><span class="comment">// Reentrant acquire</span></span><br><span class="line">    setState(c + acquires);</span><br><span class="line">    <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">  &#125;</span><br><span class="line">  <span class="keyword">if</span> (writerShouldBlock() || !compareAndSetState(c, c + acquires)) <span class="comment">// 如果当且写线程数为0，并且当前线程需要阻塞那么就返回失败；或者如果通过CAS增加写线程数失败也返回失败。</span></span><br><span class="line"><span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">setExclusiveOwnerThread(current); <span class="comment">// 如果c=0，w=0或者c&gt;0，w&gt;0（重入），则设置当前线程或锁的拥有者</span></span><br><span class="line"><span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><ul><li>这段代码首先取到当前锁的个数c，然后再通过c来获取写锁的个数w。因为写锁是低16位，所以取低16位的最大值与当前的c做与运算（ int w = exclusiveCount©; ），高16位和0与运算后是0，剩下的就是低位运算的值，同时也是持有写锁的线程数目。</li><li>在取到写锁线程的数目后，首先判断是否已经有线程持有了锁。如果已经有线程持有了锁(c!=0)，则查看当前写锁线程的数目，如果写线程数为0（即此时存在读锁）或者持有锁的线程不是当前线程就返回失败（涉及到公平锁和非公平锁的实现）。</li><li>如果写入锁的数量大于最大数（65535，2的16次方-1）就抛出一个Error。</li><li>如果当且写线程数为0（那么读线程也应该为0，因为上面已经处理c!=0的情况），并且当前线程需要阻塞那么就返回失败；如果通过CAS增加写线程数失败也返回失败。</li><li>如果c=0,w=0或者c&gt;0,w&gt;0（重入），则设置当前线程或锁的拥有者，返回成功！</li></ul><p>tryAcquire()除了重入条件（当前线程为获取了写锁的线程）之外，增加了一个读锁是否存在的判断。如果存在读锁，则写锁不能被获取，原因在于：必须确保写锁的操作对读锁可见，如果允许读锁在已被获取的情况下对写锁的获取，那么正在运行的其他读线程就无法感知到当前写线程的操作。</p><p>因此，只有等待其他读线程都释放了读锁，写锁才能被当前线程获取，而写锁一旦被获取，则其他读写线程的后续访问均被阻塞。写锁的释放与ReentrantLock的释放过程基本类似，每次释放均减少写状态，当写状态为0时表示写锁已被释放，然后等待的读写线程才能够继续访问读写锁，同时前次写线程的修改对后续的读写线程可见。</p><p>接着是读锁的代码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">protected</span> <span class="keyword">final</span> <span class="keyword">int</span> <span class="title">tryAcquireShared</span><span class="params">(<span class="keyword">int</span> unused)</span> </span>&#123;</span><br><span class="line">    Thread current = Thread.currentThread();</span><br><span class="line">    <span class="keyword">int</span> c = getState();</span><br><span class="line">    <span class="keyword">if</span> (exclusiveCount(c) != <span class="number">0</span> &amp;&amp;</span><br><span class="line">        getExclusiveOwnerThread() != current)</span><br><span class="line">        <span class="keyword">return</span> -<span class="number">1</span>;                                   <span class="comment">// 如果其他线程已经获取了写锁，则当前线程获取读锁失败，进入等待状态</span></span><br><span class="line">    <span class="keyword">int</span> r = sharedCount(c);</span><br><span class="line">    <span class="keyword">if</span> (!readerShouldBlock() &amp;&amp;</span><br><span class="line">        r &lt; MAX_COUNT &amp;&amp;</span><br><span class="line">        compareAndSetState(c, c + SHARED_UNIT)) &#123;</span><br><span class="line">        <span class="keyword">if</span> (r == <span class="number">0</span>) &#123;</span><br><span class="line">            firstReader = current;</span><br><span class="line">            firstReaderHoldCount = <span class="number">1</span>;</span><br><span class="line">        &#125; <span class="keyword">else</span> <span class="keyword">if</span> (firstReader == current) &#123;</span><br><span class="line">            firstReaderHoldCount++;</span><br><span class="line">        &#125; <span class="keyword">else</span> &#123;</span><br><span class="line">            HoldCounter rh = cachedHoldCounter;</span><br><span class="line">            <span class="keyword">if</span> (rh == <span class="keyword">null</span> || rh.tid != getThreadId(current))</span><br><span class="line">                cachedHoldCounter = rh = readHolds.get();</span><br><span class="line">            <span class="keyword">else</span> <span class="keyword">if</span> (rh.count == <span class="number">0</span>)</span><br><span class="line">                readHolds.set(rh);</span><br><span class="line">            rh.count++;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> <span class="number">1</span>;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> fullTryAcquireShared(current);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>可以看到在tryAcquireShared(int unused)方法中，如果其他线程已经获取了写锁，则当前线程获取读锁失败，进入等待状态。如果当前线程获取了写锁或者写锁未被获取，则当前线程（线程安全，依靠CAS保证）增加读状态，成功获取读锁。读锁的每次释放（线程安全的，可能有多个读线程同时释放读锁）均减少读状态，减少的值是“1&lt;&lt;16”。所以读写锁才能实现读读的过程共享，而读写、写读、写写的过程互斥。</p><p>此时，我们再回头看一下互斥锁ReentrantLock中公平锁和非公平锁的加锁源码：</p><p><img src="https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/8b7878ec.png" alt="img"></p><p>我们发现在ReentrantLock虽然有公平锁和非公平锁两种，但是它们添加的都是独享锁。根据源码所示，当某一个线程调用lock方法获取锁时，如果同步资源没有被其他线程锁住，那么当前线程在使用CAS更新state成功后就会成功抢占该资源。而如果公共资源被占用且不是被当前线程占用，那么就会加锁失败。所以可以确定ReentrantLock无论读操作还是写操作，添加的锁都是都是独享锁。</p>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;前言&quot;&gt;&lt;a href=&quot;#前言&quot; class=&quot;headerlink&quot; title=&quot;前言&quot;&gt;&lt;/a&gt;前言&lt;/h2&gt;&lt;p&gt;Java提供了种类丰富的锁，每种锁因其特性的不同，在适当的场景下能够展现出非常高的效率。本文旨在对锁相关源码（本文中的源码来自JDK 8和Netty 3.10.6）、使用场景进行举例，为读者介绍主流锁的知识点，以及不同的锁的适用场景。&lt;/p&gt;
&lt;p&gt;Java中往往是按照是否含有某一特性来定义锁，我们通过特性将锁进行分组归类，再使用对比的方式进行介绍，帮助大家更快捷的理解相关知识。下面给出本文内容的总体分类目录：&lt;/p&gt;
&lt;p&gt;&lt;img src=&quot;https://awps-assets.meituan.net/mit-x/blog-images-bundle-2018b/7f749fc8.png&quot; alt=&quot;img&quot;&gt;&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>操作系统相关内容</title>
    <link href="https://zrbac.github.io/2020/09/09/%E6%93%8D%E4%BD%9C%E7%B3%BB%E7%BB%9F%E7%9B%B8%E5%85%B3%E5%86%85%E5%AE%B9/"/>
    <id>https://zrbac.github.io/2020/09/09/%E6%93%8D%E4%BD%9C%E7%B3%BB%E7%BB%9F%E7%9B%B8%E5%85%B3%E5%86%85%E5%AE%B9/</id>
    <published>2020-09-09T09:51:58.000Z</published>
    <updated>2020-09-13T06:50:09.184Z</updated>
    
    <content type="html"><![CDATA[<h2 id="操作系统"><a href="#操作系统" class="headerlink" title="操作系统"></a>操作系统</h2><h3 id="进程和线程有什么区别？"><a href="#进程和线程有什么区别？" class="headerlink" title="进程和线程有什么区别？"></a>进程和线程有什么区别？</h3><ul><li>进程是系统进行资源分配和调度的基本单位，线程是CPU调度和分派的基本单位</li><li>线程依赖于进程存在，一个进程至少有一个线程</li><li>进程有自己的独立地址空间，线程共享进程的地址空间</li><li>进程是拥有系统资源的一个独立单位，而线程自己基本上不拥有系统资源，只有一些在运行中必不可少的资源（如程序计数器、一组寄存器和栈），和其他线程共享本进程的相关资源，如内存、I/O、CPU等</li><li>在进程切换时，涉及到整个当前进程CPU环境的保存环境设置以及新被调度运行的CPU环境的设置，而线程切换只需要保存和设置少量寄存器的内容，并不涉及存储器管理方面的操作</li></ul><h3 id="同一进程中的线程可以共享哪些数据？"><a href="#同一进程中的线程可以共享哪些数据？" class="headerlink" title="同一进程中的线程可以共享哪些数据？"></a>同一进程中的线程可以共享哪些数据？</h3><ul><li>进程代码段</li><li>进程的共有数据（全局变量、静态变量）</li><li>进程打开的文件描述符</li><li>进程的当前目录</li><li>信号处理器/信号处理函数：对收到的信号的处理方式</li><li>进程ID和进程组ID</li></ul><a id="more"></a><h3 id="进程间通信方式有哪些？"><a href="#进程间通信方式有哪些？" class="headerlink" title="进程间通信方式有哪些？"></a>进程间通信方式有哪些？</h3><ul><li><p>管道</p><ul><li><p>管道是半双工的，数据只能向一个方向流动；需要双方通信时，需要建立两个管道</p></li><li><p>管道是内核里面的一串缓存</p></li><li><p>一个进程向管道中写的内容被管道另一端的进程读出，写入的内容每次都添加在管道缓冲区的末尾，并且每次都是从缓冲区的头部读出数据</p></li><li><p>只能由于父子进程或者兄弟进程之间（具有亲缘关系的进程）</p></li></ul></li><li><p>命名管道</p><ul><li><p>可用于没有亲缘关系的进程间，通过mknode()系统调用或者mkfifo()函数建立命名管道。命名管道实质上也是通过<strong>内核缓冲区</strong>来实现数据传输。有访问权限的进程，可以通过磁盘的索引节点来读写这块缓冲区。</p></li><li><p>当不再被任何进程使用时，命名管道在内存中释放，但磁盘节点仍然存在。</p></li></ul></li><li><p>消息队列</p><ul><li><p>消息队列是存放在内核中的消息链表，每个消息队列由消息队列标识符表示，异步通信</p></li><li><p>消息队列克服了信号传递信息少、管道只能承载无格式字节流及缓冲区大小受限等缺点，可传递有格式的数据，但大小仍有限制</p></li><li><p>消息队列只有在内核重启或显示地删除一个消息队列时，该消息队列才会真正被删除</p></li><li><p>与管道不同，消息队列在某一进程往一个队列写入消息前，不需要另一个进程在该队列上等待消息的到达</p></li><li><p>消息队列不适合比较大数据的传输，在通信过程中，存在用户态与内核态之间的数据拷贝开销</p></li></ul></li><li><p>信号(Signal)</p><ul><li><p>信号事件来源有硬件来源（Ctrl C）和软件来源（kill命令），异步通信</p></li><li><p>发送接收信号有信号队列，未执行则保存该信号直至恢复执行，阻塞则信号传递被延迟，直至阻塞取消再传给进程</p></li><li><p>处理信号的三种过程：1、处理信号，定义信号处理函数，当信号发生时，执行相应的处理函数</p></li><li><p>2、忽略信号，当不希望接收到的信号对进程的执行产生影响，而让进程继续执行时，可以忽略该信号，不对信号做任何处理</p></li><li><p>3、执行默认操作，Linux对每种信号都规定了默认操作，有的信号如SIGSTOP、SIGKILL等无法忽略。</p></li></ul></li><li><p>共享内存</p></li><li><ul><li>不同进程可以将同一段共享内存映射到自己的地址空间，像访问正常内存一样访问它</li><li>优点是简单高效，不需要系统调用，不涉及用户态到内核态的转换，也不需要对数据不必要的复制</li><li>缺点存在并发问题，可能多个进程修改同一块内存，，因此一般与信号量结合使用</li></ul></li><li><p>信号量：初始化操作、P操作、V操作；P操作：信号量-1，检测是否小于0，小于则进程进入阻塞状态；V操作：信号量+1，若小于等于0，则从队列中唤醒一个等待的进程进入就绪态</p></li><li><ul><li>进程互斥访问共享内存，初始化信号量为1，多进程同步，初始信号量为0。</li></ul></li><li><p>套接字(Socket)</p><ul><li><p>不同的计算机进程之间通过socket通信，也可用于同一计算机的不同进程</p></li><li><p>需要通信的进程之间首先各自创建一个socket，内容包括主机地址与端口号，声明自己接收来自某端口地址的数据</p></li><li><p>操作系统提供创建socket、发送、接收的系统调用，为每个socket设置发送缓冲区、接收缓冲区</p></li><li><p>根据创建socket类型的不同，通信方式也不同：针对TCP协议通信、针对UDP协议通信、针对本地进程通信</p></li></ul></li></ul><h3 id="进程调度策略"><a href="#进程调度策略" class="headerlink" title="进程调度策略"></a>进程调度策略</h3><h4 id="1-批处理系统"><a href="#1-批处理系统" class="headerlink" title="1.批处理系统"></a>1.批处理系统</h4><ul><li>先来先服务(first come first served) - FCFS</li></ul><p>按照请求顺序进行调度，非抢占式，开销小，无饥饿问题，响应时间不确定</p><ul><li>最短作业优先(shortest job first) - SJF</li></ul><p>按估计运行时间最短的顺序进行调度，非抢占式，吞吐量高，开销较大，可能造成长进程一直等不到调度而导致进程饥饿</p><ul><li>最高响应比优先(highest response ratio next) - HRRN</li></ul><p>响应比 =(等待时间+执行时间)/执行时间，同时考虑了等待时间的长短和估计需要执行时间的长短，很好的平衡了长短进程，非抢占式，吞吐量高，开销较大，能够提供好的响应时间，无饥饿问题</p><h4 id="2-交互式系统"><a href="#2-交互式系统" class="headerlink" title="2.交互式系统"></a>2.交互式系统</h4><ul><li>时间片轮转(round robin) - RR</li></ul><p>将所有就绪进程按照FCFS的原则排成一个队列，用完时间片的进程排到队列最后，抢占式，开销小，无饥饿问题，为短进程提供好的响应时间。若时间片小，进程切换频繁，吞吐量低；若时间片长，实时性得不到保证</p><ul><li>优先级调度算法</li></ul><p>为每个进程分配一个优先级，按优先级进行调度，为了防止低优先级的进程永远等不到调度，可以随着时间的推移增加等待进程的优先级</p><ul><li>多级反馈队列调度算法(multiple feedback queue) - MFQ</li></ul><p>设置多个就绪队列1、2、3…，优先级递减，时间片递增。只有等到优先级更高的队列为空时，才会调度当前队列中进程，如果进程用完了当前队列的时间片还未执行完，则会被移到下一队列。抢占式，开销较大，对IO型进程有利，可能出现饥饿问题</p><p><strong>什么叫优先级反转，如何解决</strong></p><p>高优先级的进程等待被一个低优先级进程占用资源时，就会出现优先级反转，即优先级较低的进程比优先级较高的进程先执行</p><p>解决方法：</p><ul><li>优先级天花板(priority ceiling)：当任务申请到资源时，把该任务的优先级提升到可访问这个资源的所有任务中的最高优先级</li><li>优先级继承(priority inheritance)：当任务A申请共享资源S时，如果S正被C使用，通过比较A与C任务的优先级，如果发现C的优先级小于自身，则将C的优先级提升到自身的优先级，任务C释放资源S后，再恢复任务C的原优先级</li></ul><h3 id="什么是僵尸进程？"><a href="#什么是僵尸进程？" class="headerlink" title="什么是僵尸进程？"></a>什么是僵尸进程？</h3><p>当一个子进程比父进程先结束，而父进程没有回收子进程，释放子进程占用的资源，此时子进程成为一个僵尸进程。僵尸进程是一个已经死亡的进程，但是并没有真正被销毁，它已经放弃了几乎所有内存空间，也没有任何可执行代码，也不能被调度，仅仅在进程表中保留一个位置，记载该进程的ID、终止状态即资源利用信息供父进程收集，除此之外，不占有任何内存空间。该僵尸进程可能会一直留在系统中直到系统重启</p><p>危害：占用进程号，占用内存</p><p>以下情况不会产生僵尸进程：</p><ul><li>该进程的父进程先结束了。每个进程结束时，系统都会扫描是否存在子进程，若有，则用Init进程接管，成为该进程的父进程，并会调用wait等待其结束</li><li>父进程调用wait或者waitpid等待子进程结束。 wait系统调用会使父进程暂停执行，直到它的一个子进程结束为止。waitpid则可以加入<code>WNOHANG</code>(wait-no-hang)选项，如果没有发现结束的子进程，就会立即返回，不会将调用waitpid的进程阻塞。同时，waitpid还可以选择是等待任一子进程（同wait），还是等待指定pid的子进程，还是等待同一进程组下的任一子进程，还是等待组ID等于pid的任一子进程 </li><li>子进程结束时，系统会产生<code>SIGCHLD</code>(signal-child)信号，可以注册一个信号处理函数，在该函数中调用waitpid，等待所有结束的子进程（注意：一般都需要循环调用waitpid，因为在信号处理函数开始执行之前，可能已经有多个子进程结束了，而信号处理函数只执行一次，所以要循环调用将所有结束的子进程回收）；</li><li>也可以用<code>signal(SIGCLD, SIG_IGN)</code>(signal-ignore)通知内核，表示忽略<code>SIGCHLD</code>信号，那么子进程结束后，内核会进行回收。</li></ul><p><strong>什么是孤儿进程</strong></p><p>一个父进程以及结束了，但是它的子进程还在运行，那么这些子进程会成为孤儿进程。孤儿进程会被Init（进程ID为1）接管，当这些孤儿进程结束时由Init完成状态收集工作</p><h3 id="线程同步有哪些方式？"><a href="#线程同步有哪些方式？" class="headerlink" title="线程同步有哪些方式？"></a>线程同步有哪些方式？</h3><p>线程同步： 线程有时候会和其他线程共享一些资源，比如内存、数据库等。当多个线程同时读写同一份共享资源的时候，可能会发生冲突。因此需要线程的同步，多个线程按顺序访问资源。 </p><ul><li><strong>互斥量</strong> Mutex：互斥量是内核对象，只有拥有互斥对象的线程才有访问互斥资源的权限。因为互斥对象只有一个，所以可以保证互斥资源不会被多个线程同时访问；当前拥有互斥对象的线程处理完任务后必须将互斥对象交出，以便其他线程访问该资源；</li><li><strong>信号量</strong> Semaphore：信号量是内核对象，它允许同一时刻多个线程访问同一资源，但是需要控制同一时刻访问此资源的最大线程数量。信号量对象保存了<strong>最大资源计数</strong>和<strong>当前可用资源计数</strong>，每增加一个线程对共享资源的访问，当前可用资源计数就减1，只要当前可用资源计数大于0，就可以发出信号量信号，如果为0，则将线程放入一个队列中等待。线程处理完共享资源后，应在离开的同时通过<code>ReleaseSemaphore</code>函数将当前可用资源数加1。如果信号量的取值只能为0或1，那么信号量就成为了互斥量；</li><li><strong>事件</strong> Event：允许一个线程在处理完一个任务后，主动唤醒另外一个线程执行任务。事件分为手动重置事件和自动重置事件。手动重置事件被设置为激发状态后，会唤醒所有等待的线程，而且一直保持为激发状态，直到程序重新把它设置为未激发状态。自动重置事件被设置为激发状态后，会唤醒<strong>一个</strong>等待中的线程，然后自动恢复为未激发状态。</li><li><strong>临界区</strong> Critical Section：任意时刻只允许一个线程对临界资源进行访问。拥有临界区对象的线程可以访问该临界资源，其它试图访问该资源的线程将被挂起，直到临界区对象被释放。</li></ul><h3 id="什么是死锁？"><a href="#什么是死锁？" class="headerlink" title="什么是死锁？"></a>什么是死锁？</h3><p>在两个或者多个并发进程中，每个进程持有某种资源而又等待其它进程释放它们现在保持着的资源，在未改变这种状态之前都不能向前推进，称这一组进程产生了死锁(deadlock)。</p><h3 id="死锁产生的必要条件？"><a href="#死锁产生的必要条件？" class="headerlink" title="死锁产生的必要条件？"></a>死锁产生的必要条件？</h3><ul><li><strong>互斥</strong>：一个资源一次只能被一个进程使用；</li><li><strong>占有并等待</strong>：一个进程至少占有一个资源，并在等待另一个被其它进程占用的资源；</li><li><strong>非抢占</strong>：已经分配给一个进程的资源不能被强制性抢占，只能由进程完成任务之后自愿释放；</li><li><strong>循环等待</strong>：若干进程之间形成一种头尾相接的环形等待资源关系，该环路中的每个进程都在等待下一个进程所占有的资源。</li></ul><h3 id="死锁有哪些处理方法？"><a href="#死锁有哪些处理方法？" class="headerlink" title="死锁有哪些处理方法？"></a>死锁有哪些处理方法？</h3><h4 id="鸵鸟策略"><a href="#鸵鸟策略" class="headerlink" title="鸵鸟策略"></a>鸵鸟策略</h4><p>直接忽略死锁。因为解决死锁问题的代价很高，因此鸵鸟策略这种不采取任务措施的方案会获得更高的性能。当发生死锁时不会对用户造成多大影响，或发生死锁的概率很低，可以采用鸵鸟策略。</p><h4 id="死锁预防"><a href="#死锁预防" class="headerlink" title="死锁预防"></a>死锁预防</h4><p>基本思想是破坏形成死锁的四个必要条件：</p><ul><li>破坏互斥条件：允许某些资源同时被多个进程访问。但是有些资源本身并不具有这种属性，因此这种方案实用性有限；</li><li>破坏占有并等待条件：<ul><li>实行资源预先分配策略（当一个进程开始运行之前，必须一次性向系统申请它所需要的全部资源，否则不运行）；</li><li>或者只允许进程在没有占用资源的时候才能申请资源（申请资源前先释放占有的资源）；</li><li>缺点：很多时候无法预知一个进程所需的全部资源；同时，会降低资源利用率，降低系统的并发性；</li></ul></li><li>破坏非抢占条件：允许进程强行抢占被其它进程占有的资源。会降低系统性能；</li><li>破坏循环等待条件：对所有资源统一编号，所有进程对资源的请求必须按照序号递增的顺序提出，即只有占有了编号较小的资源才能申请编号较大的资源。这样避免了占有大号资源的进程去申请小号资源。</li></ul><h3 id="Java线程状态"><a href="#Java线程状态" class="headerlink" title="Java线程状态"></a>Java线程状态</h3><ul><li><strong>新建状态（New）</strong>：当线程对象创建时，即进入新建状态，如 <code>Thread t = new MyThread();</code></li><li><strong>就绪/运行状态（Runnable）</strong>：<ul><li>当调用线程对象的start()方法，如<code>t.start()</code>时，线程进入就绪状态。处于就绪状态，只是说明此线程已经做好了准备，随时等待CPU调度执行，并不是执行了<code>t.start()</code>此线程就会运行；</li><li>当CPU开始调度处于就绪态的线程时，线程才真正执行，进入到运行态。（就绪态是进入到运行态的唯一入口，即线程若要进入运行态，首先必须要处于就绪态）；</li></ul></li><li><strong>阻塞状态（Blocked）</strong>：处于运行态的线程可因为某种原因，暂时放弃对CPU的使用权，停止执行，即进入阻塞状态，直到其进入到就绪态，才有机会再次被CPU调用进入运行态。线程在获取<code>synchronized</code>同步锁失败（锁被其他线程占用），会进入同步阻塞状态；<ul><li>其他阻塞：通过调用线程的<code>sleep()</code>或<code>join()</code>或发出来I/O请求时，线程会进入到阻塞状态。当<code>sleep()</code>状态超时、<code>join()</code>等待线程终止或者超时、或者I/O处理完毕时，线程重新转入就绪状态；</li></ul></li><li><strong>等待状态（Waiting）</strong>：进入该状态表示当前线程需要等待其他线程做出一些特定的动作（通知或中断）；<ul><li>当前线程运行时，其他线程调用<code>join()</code>方法时，当前线程进入等待状态；</li><li>当前线程对象调用<code>wait()</code>方法时，进入等待状态；</li><li>等待的线程被其他线程唤醒时，<code>notify()</code>和<code>notifyAll()</code>方法，进入就绪态；</li></ul></li><li><strong>超时等待（Timed_Waiting）</strong>：与Waiting不同，其可以在指定的时间自行返回就绪态；<ul><li>调用静态方法，<code>Thread.sleep(long)</code>进入超时等待；</li><li>线程调用<code>wait(long)</code>方法</li><li>其他线程调用指定时间的<code>join(long)</code>方法</li><li><strong><code>sleep</code>和<code>yield</code></strong>：<ul><li><code>sleep(long)</code>方法会<strong>使线程转入超时等待状态</strong>，时间到了之后才会转入就绪状态。而<code>yield()</code>方法不会将线程转入等待，而是强制线程进入就绪状态。</li><li>使用<code>sleep(long)</code>方法<strong>需要处理异常</strong>，而<code>yield()</code>不用。</li></ul></li></ul></li><li><strong>终止状态（Terminated）</strong>：线程执行完成或因异常退出了<code>run()</code>方法，该线程终止。</li></ul>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;操作系统&quot;&gt;&lt;a href=&quot;#操作系统&quot; class=&quot;headerlink&quot; title=&quot;操作系统&quot;&gt;&lt;/a&gt;操作系统&lt;/h2&gt;&lt;h3 id=&quot;进程和线程有什么区别？&quot;&gt;&lt;a href=&quot;#进程和线程有什么区别？&quot; class=&quot;headerlink&quot; title=&quot;进程和线程有什么区别？&quot;&gt;&lt;/a&gt;进程和线程有什么区别？&lt;/h3&gt;&lt;ul&gt;
&lt;li&gt;进程是系统进行资源分配和调度的基本单位，线程是CPU调度和分派的基本单位&lt;/li&gt;
&lt;li&gt;线程依赖于进程存在，一个进程至少有一个线程&lt;/li&gt;
&lt;li&gt;进程有自己的独立地址空间，线程共享进程的地址空间&lt;/li&gt;
&lt;li&gt;进程是拥有系统资源的一个独立单位，而线程自己基本上不拥有系统资源，只有一些在运行中必不可少的资源（如程序计数器、一组寄存器和栈），和其他线程共享本进程的相关资源，如内存、I/O、CPU等&lt;/li&gt;
&lt;li&gt;在进程切换时，涉及到整个当前进程CPU环境的保存环境设置以及新被调度运行的CPU环境的设置，而线程切换只需要保存和设置少量寄存器的内容，并不涉及存储器管理方面的操作&lt;/li&gt;
&lt;/ul&gt;
&lt;h3 id=&quot;同一进程中的线程可以共享哪些数据？&quot;&gt;&lt;a href=&quot;#同一进程中的线程可以共享哪些数据？&quot; class=&quot;headerlink&quot; title=&quot;同一进程中的线程可以共享哪些数据？&quot;&gt;&lt;/a&gt;同一进程中的线程可以共享哪些数据？&lt;/h3&gt;&lt;ul&gt;
&lt;li&gt;进程代码段&lt;/li&gt;
&lt;li&gt;进程的共有数据（全局变量、静态变量）&lt;/li&gt;
&lt;li&gt;进程打开的文件描述符&lt;/li&gt;
&lt;li&gt;进程的当前目录&lt;/li&gt;
&lt;li&gt;信号处理器/信号处理函数：对收到的信号的处理方式&lt;/li&gt;
&lt;li&gt;进程ID和进程组ID&lt;/li&gt;
&lt;/ul&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="操作系统" scheme="https://zrbac.github.io/tags/%E6%93%8D%E4%BD%9C%E7%B3%BB%E7%BB%9F/"/>
    
  </entry>
  
  <entry>
    <title>事务+隔离级别+阻塞+死锁</title>
    <link href="https://zrbac.github.io/2020/09/08/%E4%BA%8B%E5%8A%A1-%E9%9A%94%E7%A6%BB%E7%BA%A7%E5%88%AB-%E9%98%BB%E5%A1%9E-%E6%AD%BB%E9%94%81/"/>
    <id>https://zrbac.github.io/2020/09/08/%E4%BA%8B%E5%8A%A1-%E9%9A%94%E7%A6%BB%E7%BA%A7%E5%88%AB-%E9%98%BB%E5%A1%9E-%E6%AD%BB%E9%94%81/</id>
    <published>2020-09-08T00:24:35.000Z</published>
    <updated>2020-09-08T00:26:31.550Z</updated>
    
    <content type="html"><![CDATA[<h2 id="事务-隔离级别-阻塞-死锁"><a href="#事务-隔离级别-阻塞-死锁" class="headerlink" title="事务+隔离级别+阻塞+死锁"></a>事务+隔离级别+阻塞+死锁</h2><p>本篇主要内容如下：</p><p><img src="http://qiniu.zrbac.fun/46.png" alt="img"></p><h1 id="一、事务"><a href="#一、事务" class="headerlink" title="一、事务"></a>一、事务</h1><h2 id="1-1-什么是事务"><a href="#1-1-什么是事务" class="headerlink" title="1.1 什么是事务"></a>1.1 什么是事务</h2><p>为单个工作单元而执行的一系列操作。如查询、修改数据、修改数据定义。</p><h2 id="1-2-语法"><a href="#1-2-语法" class="headerlink" title="1.2 语法"></a>1.2 语法</h2><p><strong>「（1）显示定义事务的开始、提交」</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">BEGIN` `TRAN``INSERT` `INTO` `b(t1) ``VALUES``(1)``INSERT` `INTO` `b(t1) ``VALUES``(2)``COMMIT` `TRAN</span><br></pre></td></tr></table></figure><p><strong>「（2）隐式定义」</strong></p><p>如果不显示定义事务的边界，则SQL Server会默认把每个单独的语句作为一个事务，即在执行完每个语句之后就会自动提交事务。</p><a id="more"></a><h2 id="1-3-事务的四个属性ACID"><a href="#1-3-事务的四个属性ACID" class="headerlink" title="1.3 事务的四个属性ACID"></a>1.3 事务的四个属性ACID</h2><p><strong>「（1）原子性Atomicity」</strong></p><p><img src="http://qiniu.zrbac.fun/47.png" alt="img"></p><ul><li>1.事务必须是<code>原子</code>工作单元。事务中进行的修改，要么全部执行，要么全都不执行；</li><li>2.在事务完成之前（提交指令被记录到事务日志之前），系统出现故障或重新启动，SQL Server将会撤销在事务中进行的所有修改；</li><li>3.事务在处理中遇到错误，SQL Server通常会<code>自动</code>回滚事务；</li><li>4.少数不太严重的错误不会引发事务的自动回滚，如主键冲突、锁超时等；</li><li>5.可以使用错误处理来捕获第4点提到的错误，并采取某种操作，如把错误记录在日志中，再<code>回滚</code>事务；</li><li>6.SELECT @@TRANCOUNT可用在代码的任何位置来判断当前使用SELECT @@TRANCOUNT的地方是否位于一个打开的事务当中，如果不在任何打开的事务范围内，则该函数返回0；如果在某个打开的事务返回范围内，则返回一个大于0的值。打开一个事务，@@TRANCOUNT=@@TRANCOUNT+1；提交一个事务，@@TRANCOUNT-1。</li></ul><p><strong>「（2）一致性Consiitency」</strong></p><p><img src="http://qiniu.zrbac.fun/48.png" alt="img"></p><ul><li>1.同时发生的事务在修改和查询数据时不发生冲突；</li><li>2.一致性取决于应用程序的需要。后面会讲到一致性级别，以及如何对一致性进行控制。</li></ul><p><strong>「（3）隔离性Isolation」</strong></p><p><img src="http://qiniu.zrbac.fun/49.png" alt="img"></p><ul><li>1.用于控制数据访问，确保事务只访问处于期望的一致性级别下的数据；</li><li>2.使用锁对各个事务之间正在修改和查询的数据进行隔离。</li></ul><p><strong>「（4）持久性Durability」</strong></p><p><img src="http://qiniu.zrbac.fun/50.png" alt="img"></p><ul><li>1.<strong>「写事务日志：」</strong> 在将数据修改写入到磁盘上数据库的数据分区之前会把这些修改写入到磁盘上数据库的事务日志中，把提交指令记录到磁盘的事务日志中以后，即时数据修改还没有应用到磁盘的数据分区，也可以认为事务是持久化的。</li><li>2.<strong>「系统重新启动：」</strong> 正常启动或在发生系统故障之后启动，SQL Server会每个数据库的事务日志，进行回复处理。</li><li>3.<strong>「恢复处理包含两个阶段：」</strong> 重做阶段和撤销阶段。</li><li>4.<strong>「前滚：」</strong> 在重做阶段，对于提交指令已经写入到日志的事务，但数据修改还没有应用到数据分区的事务，数据库引擎会重做这些食物所做的所有修改。</li><li>5.<strong>「回滚：」</strong> 在撤销阶段，对于提交指令没有写入到日志中的事务，数据库引擎会撤销这些事务所做的修改。（这句话需要research,可能是不正确的。因为提交指令没有写入到数据分区，撤销修改是指撤销哪些修改呢？）</li></ul><h1 id="二、锁"><a href="#二、锁" class="headerlink" title="二、锁"></a>二、锁</h1><h2 id="2-1-事务中的锁"><a href="#2-1-事务中的锁" class="headerlink" title="2.1 事务中的锁"></a>2.1 事务中的锁</h2><p>（1）SQL Server使用锁来实现事务的隔离。</p><p>（2）事务获取锁这种控制资源，用于保护数据资源，防止其他事务对数据进行冲突的或不兼容的访问。</p><h2 id="2-2-锁模式"><a href="#2-2-锁模式" class="headerlink" title="2.2 锁模式"></a>2.2 锁模式</h2><p><img src="http://qiniu.zrbac.fun/51.png" alt="img"></p><ul><li>a.当试图修改数据时，事务只能为所依赖的数据资源请求排他锁。</li><li>b.持有排他锁时间：一旦某个事务得到了排他锁，则这个事务将一直持有排他锁直到事务完成。</li><li>c.排他锁和其他任何类型的锁在多事务中不能在同一阶段作用于同一个资源。</li></ul><p>如：当前事务获得了某个资源的排他锁，则其他事务不能获得该资源的任何其他类型的锁。其他事务获得了某个资源的任何其他类型的锁，则当前事务不能获得该资源的排他锁。</p><p><img src="http://qiniu.zrbac.fun/52.png" alt="img"></p><ul><li>a.当试图读取数据时，事务默认会为所依赖的数据资源请求共享锁。</li><li>b.持有共享锁时间：从事务得到共享锁到读操作完成。</li><li>c.多个事务可以在同一阶段用共享锁作用于同一数据资源。</li><li>d.在读取数据时，可以对如何处理锁定进行控制。后面隔离级别会讲到如何对锁定进行控制。</li></ul><h2 id="2-3-排他锁和共享锁的兼容性"><a href="#2-3-排他锁和共享锁的兼容性" class="headerlink" title="2.3 排他锁和共享锁的兼容性"></a>2.3 排他锁和共享锁的兼容性</h2><p>（1）如果数据正在由一个事务进行修改，则其他事务既不能修改该数据，也不能读取（至少默认不能）该数据，直到第一个事务完成。</p><p>（2）如果数据正在由一个事务读取，则其他事务不能修改该数据（至少默认不能）。</p><h2 id="2-4-可锁定的资源的类型"><a href="#2-4-可锁定的资源的类型" class="headerlink" title="2.4 可锁定的资源的类型"></a>2.4 可锁定的资源的类型</h2><p>RID、KEY（行）、PAGE（页）、对象（例如表）、数据库、EXTENT（区）、分配单元（ALLOCATION_UNIT）、堆（HEAP）、以及B树（B-tree）。</p><p><strong>「RID: 标识页上的特定行」</strong></p><ul><li>格式: fileid: pagenumber: rid （1:109:0 ）</li></ul><p>其中fileid标识包含页的文件， pagenumber标识包含行的页，rid标识页上的特定行。</p><p>fileid与sys.databases_files 目录视图中的file_id列相匹配</p><ul><li>例子：</li></ul><p>在查询视图sys.dm_tran_locks的时候有一行的resource_description列显示RID 是1:109:0 而status列显示wait,</p><p>表示第1个数据文件上的第109页上的第0行上的锁资源。</p><h2 id="2-5-锁升级"><a href="#2-5-锁升级" class="headerlink" title="2.5 锁升级"></a>2.5 锁升级</h2><p>SQL Server可以先获得<code>细粒度</code>的锁（例如行或页），在某些情况下将细粒度锁升级为<code>更粗粒度</code>的锁（例如，表）。<br>例如单个语句获得至少5000个锁，就会触发锁升级，如果由于锁冲突而导致无法升级锁，则SQL Server每当获取1250个新锁时出发锁升级。</p><h1 id="三、阻塞"><a href="#三、阻塞" class="headerlink" title="三、阻塞"></a>三、阻塞</h1><h2 id="3-1-阻塞"><a href="#3-1-阻塞" class="headerlink" title="3.1 阻塞"></a>3.1 阻塞</h2><p>当多个事务都需要对某一资源进行<code>锁定</code>时，默认情况下会发生阻塞。被阻塞的请求会一直等待，直到原来的事务释放相关的锁。锁定<code>超时期限</code>可以限制，这样就可以限制被阻塞的请求在超时之前要<code>等待的时间</code>。</p><p><img src="http://qiniu.zrbac.fun/53.png" alt="img"></p><ul><li>阶段1：事务A请求资源S1，事务不对资源S1进行操作</li><li>阶段2：事务A用锁A锁定资源S1，事务B请求对资源S1进行不兼容的锁定（锁B）,锁B的请求被阻塞，事务B将进入等待状态</li><li>阶段3：事务A正在释放锁A，事务B等待锁A释放，</li><li>阶段4：事务A的锁A已释放，事务B用锁B锁定资源S1</li></ul><h2 id="3-2-排除阻塞问题"><a href="#3-2-排除阻塞问题" class="headerlink" title="3.2 排除阻塞问题"></a>3.2 排除阻塞问题</h2><p>例子：</p><h4 id="3-2-1-准备工作："><a href="#3-2-1-准备工作：" class="headerlink" title="3.2.1 准备工作："></a>3.2.1 准备工作：</h4><ul><li>1.准备测试数据</li></ul><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">--先创建一张表Product作为测试。id为表的主键，price为product的价格</span><br><span class="line">CREATE TABLE [dbo].[myProduct](</span><br><span class="line">    [id] [int] NOT NULL,</span><br><span class="line">    [price] [money] NOT NULL</span><br><span class="line">) ON [PRIMARY]</span><br><span class="line">GO</span><br><span class="line">--插入一条数据，id=1,price=10</span><br><span class="line">INSERT INTO [TSQLFundamentals2008].[dbo].[myProduct]([id],[price])VALUES(1,10)</span><br></pre></td></tr></table></figure><ul><li>2.模拟阻塞发生的情况</li></ul><p>在SQL Server中打开三个查询窗口Connection1、Connection2、Connection3，分别按顺序执行表格中的执行语句。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">--Connection1</span><br><span class="line">BEGIN TRAN</span><br><span class="line">UPDATE dbo.myProduct SET price = price + 1 WHERE id=1</span><br></pre></td></tr></table></figure><p><img src="http://qiniu.zrbac.fun/54.png" alt="img"></p><p><strong>「结论1：」</strong></p><p>为了更新id=1这一行数据，会话必须先获得一个排他锁。事务处于一直打开状态，没有提交，所以事务一直持有排他锁，直到事务提交并完成。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">--Connection2</span><br><span class="line">SELECT * FROM dbo.myProduct WHERE id=1</span><br></pre></td></tr></table></figure><p><img src="http://qiniu.zrbac.fun/55.png" alt="img"></p><p><strong>「结论2：」</strong></p><p>事务为了读取数据，需要请求一个共享锁，但是这一行已经被其他会话持有的排他锁锁定，而且共享锁和排他锁不是兼容的，所以会话被阻塞，进入等待状态</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">--Connection3</span><br><span class="line">SELECT  request_session_id AS 会话id ,</span><br><span class="line">        resource_type AS 请求锁定的资源类型 ,</span><br><span class="line">        resource_description AS 描述 ,</span><br><span class="line">        request_mode AS 模式 ,</span><br><span class="line">        request_status AS 状态</span><br><span class="line">FROM    sys.dm_tran_locks</span><br></pre></td></tr></table></figure><p><img src="http://qiniu.zrbac.fun/56.png" alt="img"></p><p><strong><em>\</em>「结论3：」**</strong></p><p><strong>「会话56：」</strong>（1）状态WAIT-等待锁</p><p>（2）正在等待第1个数据文件上的第109页上的第0行资源的共享锁</p><p>（3）持有第1个数据文件上的第109页资源的意向共享锁</p><p>（3）持有OBJECT资源，意向共享锁</p><p>（4）持有DATABASE资源，意向共享锁</p><p><strong>「会话52：」</strong></p><p>（1）状态WAIT-授予锁</p><p>（2）正在等待第1个数据文件上的第109页上的第0行资源的排他锁（3）持有第1个数据文件上的第109页资源的排他锁</p><p>（3）持有OBJECT资源，排他锁</p><p>（4）持有DATABASE资源，排他锁</p><p>演示与总结如下所示：</p><p><img src="data:image/gif;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVQImWNgYGBgAAAABQABh6FO1AAAAABJRU5ErkJggg==" alt="img"><img src="http://qiniu.zrbac.fun/57.png" alt="img"></p><h3 id="3-2-2-分析阻塞原因"><a href="#3-2-2-分析阻塞原因" class="headerlink" title="3.2.2 分析阻塞原因"></a>3.2.2 分析阻塞原因</h3><h4 id="3-2-2-1-sys-dm-tran-locks-视图"><a href="#3-2-2-1-sys-dm-tran-locks-视图" class="headerlink" title="3.2.2.1 sys.dm_tran_locks 视图"></a>3.2.2.1 sys.dm_tran_locks 视图</h4><p>（1）该动态视图可以查询出哪些资源被哪个进程ID锁了</p><p>（2）查询出对资源授予或正在等待的锁模式</p><p>（3）查询出被锁定资源的类型</p><p>上面的查询语句3已经用到了这个视图，可以参考上图中的分析说明。</p><h4 id="3-2-2-2-sys-dm-exec-connections-视图"><a href="#3-2-2-2-sys-dm-exec-connections-视图" class="headerlink" title="3.2.2.2 sys.dm_exec_connections 视图"></a>3.2.2.2 sys.dm_exec_connections 视图</h4><p>（1）查询出该动态视图可以查询出进程相关的信息</p><p>（2）查询出最后一次发生读操作和写操作的时间last_read,last_write</p><p>（3）查询出进程执行的最后一个SQL批处理的二进制标记most_recent_sql_handle</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">SELECT  session_id ,</span><br><span class="line">        connect_time ,</span><br><span class="line">        last_read ,</span><br><span class="line">        last_write ,</span><br><span class="line">        most_recent_sql_handle</span><br><span class="line">FROM    sys.dm_exec_connections</span><br><span class="line"> </span><br><span class="line">WHERE   session_id IN ( 52, 56 )</span><br></pre></td></tr></table></figure><p><img src="http://qiniu.zrbac.fun/58.png" alt="img"></p><p><img src="data:image/gif;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVQImWNgYGBgAAAABQABh6FO1AAAAABJRU5ErkJggg==" alt="img"> <img src="http://qiniu.zrbac.fun/59.png" alt="img"></p><p><strong>「结论：」</strong></p><p><strong>「会话52：」</strong></p><p>（1）connect_time连接时间：2016-06-07 07:09:41.103</p><p>（2）last_read最后一次读操作时间：2016-06-07 07:10:56.233</p><p>（3）last_write最后一次写操作时间：2016-06-07 07:10:57.873</p><p>（4）most_recent_sql_handle这是一个二进制标记，最后一个SQL批处理</p><p><strong>「会话56：」</strong></p><p>（1）状态WAIT-授予锁</p><p>（2）正在等待第1个数据文件上的第109页上的第0行资源的排他锁（3）持有第1个数据文件上的第109页资源的排他锁</p><p>（3）持有OBJECT资源，排他锁</p><p>（4）持有DATABASE资源，排他锁</p><p>演示与总结如下所示：</p><p><img src="http://qiniu.zrbac.fun/60.png" alt="img"></p><h4 id="3-2-2-3-sys-dm-exec-sql-text-表函数"><a href="#3-2-2-3-sys-dm-exec-sql-text-表函数" class="headerlink" title="3.2.2.3 sys.dm_exec_sql_text 表函数"></a>3.2.2.3 sys.dm_exec_sql_text 表函数</h4><p>示例：</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">会话52：</span><br><span class="line">执行的SQL语句：</span><br><span class="line">BEGIN TRAN</span><br><span class="line">UPDATE dbo.myProduct</span><br><span class="line">SET price = price + 1</span><br><span class="line">WHERE id = 1</span><br><span class="line"></span><br><span class="line">会话56：</span><br><span class="line">执行的SQL语句：</span><br><span class="line">(@1 tinyint)</span><br><span class="line">SELECT * FROM [dbo].[myProduct]</span><br><span class="line">WHERE [id]=@1</span><br></pre></td></tr></table></figure><p>（1）该函数可以将二进制标记most_recent_sql_handle作为参数，然后返回SQL代码。</p><p>（2）阻塞进程在不断地运行，所以在代码中看到的最后一个操作不一定是导致问题的语句。在本例中最后一条执行语句是导致阻塞的语句。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">SELECT  session_id ,</span><br><span class="line">        text</span><br><span class="line">FROM    sys.dm_exec_connections</span><br><span class="line">        CROSS APPLY sys.dm_exec_sql_text</span><br><span class="line">        (most_recent_sql_handle) AS ST</span><br><span class="line">WHERE   session_id IN ( 52, 56 )</span><br></pre></td></tr></table></figure><p><img src="http://qiniu.zrbac.fun/61.png" alt="img"></p><p>演示与总结如下所示：</p><p><img src="http://qiniu.zrbac.fun/62.png" alt="img"></p><h4 id="3-2-2-4-sys-dm-exec-sessions-视图"><a href="#3-2-2-4-sys-dm-exec-sessions-视图" class="headerlink" title="3.2.2.4 sys.dm_exec_sessions 视图"></a>3.2.2.4 sys.dm_exec_sessions 视图</h4><p>（1）会话建立的时间login_time</p><p>（2）特定于会话的客户端工作站名称host_name</p><p>（3）初始化会话的客户端程序的名称program_name</p><p>（4）会话所使用的SQL Server登录名login_name</p><p>（5）最近一次会话请求的开始时间last_request_start_time</p><p>（6）最近一次会话请求的完成时间last_request_end_time</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">SELECT * FROM sys.dm_exec_sessions</span><br></pre></td></tr></table></figure><p><img src="http://qiniu.zrbac.fun/63.png" alt="img"></p><p>演示与总结如下所示：</p><p><img src="http://qiniu.zrbac.fun/64.png" alt="img"></p><h4 id="3-2-2-5-sys-dm-exec-requests-视图"><a href="#3-2-2-5-sys-dm-exec-requests-视图" class="headerlink" title="3.2.2.5 sys.dm_exec_requests 视图"></a>3.2.2.5 sys.dm_exec_requests 视图</h4><p>（1）识别出阻塞链涉及到的会话、争用的资源、被阻塞会话等待了多长时间</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">SELECT * FROM sys.dm_exec_sessions</span><br></pre></td></tr></table></figure><p><img src="http://qiniu.zrbac.fun/65.png" alt="img"></p><p><img src="http://qiniu.zrbac.fun/66.png" alt="img"></p><p><strong>「结论：」</strong></p><p><strong>「会话56：」</strong></p><p>（1）被会话52阻塞，blocking_session_id = 52</p><p>（2）会话52的开始时间start_time</p><p>（3）状态挂起status = suspended</p><p>（4）挂起的命令command</p><p>演示与总结如下所示：</p><p><img src="http://qiniu.zrbac.fun/67.png" alt="img"></p><h3 id="3-2-3-解决阻塞问题"><a href="#3-2-3-解决阻塞问题" class="headerlink" title="3.2.3 解决阻塞问题"></a>3.2.3 解决阻塞问题</h3><h4 id="3-2-3-1-Lock-TIMEOUT-选项"><a href="#3-2-3-1-Lock-TIMEOUT-选项" class="headerlink" title="3.2.3.1 Lock_TIMEOUT 选项"></a>3.2.3.1 Lock_TIMEOUT 选项</h4><p>（1）设置会话等待锁释放的超时期限</p><p>（2）默认情况下会话不会设置等待锁释放的超时期限</p><p>（3）设置会话超时期限为5秒， SET Lock_TIMEOUT 5000</p><p>（4）锁定如果超时，不会引发事务回滚</p><p>（5）取消会话超时锁定的设置，SET LOCK_TIMEOUT -1</p><p>如果超时，将显示以下错误：</p><p><img src="http://qiniu.zrbac.fun/68.png" alt="img"></p><h4 id="3-2-3-1-KILL命令"><a href="#3-2-3-1-KILL命令" class="headerlink" title="3.2.3.1 KILL命令"></a>3.2.3.1 KILL命令</h4><p>（1）杀掉会话52，KILL 52</p><p>（2）杀掉会话，会引起事务回滚，同时释放排他锁</p><h1 id="四、隔离级别"><a href="#四、隔离级别" class="headerlink" title="四、隔离级别"></a>四、隔离级别</h1><h2 id="4-1-基本概念"><a href="#4-1-基本概念" class="headerlink" title="4.1 基本概念"></a>4.1 基本概念</h2><p><strong>「（1）隔离级别用来做什么」</strong></p><ul><li>a.隔离级别用于决定如何控制并发用户读写数据的操作</li></ul><p><strong>「（2）写操作」</strong></p><ul><li>a.任何对表做出修改的语句</li><li>b.使用排他锁</li><li>c.不能修改读操作获得的锁和锁的持续时间</li></ul><p><strong>「（3）读操作：」</strong></p><ul><li>a.任何检索数据的语句</li><li>b.默认使用共享锁</li><li>c.使用隔离级别来控制读操作的处理方式</li></ul><h2 id="4-2-隔离级别的分类"><a href="#4-2-隔离级别的分类" class="headerlink" title="4.2 隔离级别的分类"></a>4.2 隔离级别的分类</h2><p>（1）未提交读 （READ UNCOMMITTED）</p><p>（2）已提交读（READ COMMITTED）（默认值）</p><p>（3）可重复读（REPEATABLE READ）</p><p>（4）可序列化（SERIALIZABLE）</p><p>（5）快照（SNAPSHOT）</p><p>（6）已经提交读快照（READ_COMMITTED_SNAPSHOT）</p><h2 id="4-3-隔离级别的设置"><a href="#4-3-隔离级别的设置" class="headerlink" title="4.3 隔离级别的设置"></a>4.3 隔离级别的设置</h2><p><strong>「（1）设置整个会话的隔离级别」</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">SET TRANSACTION ISOLATION LEVEL &lt;isolation name&gt;;</span><br><span class="line">SET TRANSACTION ISOLATION LEVEL READ COMMITTED;</span><br></pre></td></tr></table></figure><p><strong>「（2）用表提示设置查询的隔离级别」</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">SELECT ... FROM &lt;table&gt; WITH (&lt;isolation name&gt;);</span><br><span class="line">SELECT * FROM dbo.myProduct WITH (READCOMMITTED);</span><br></pre></td></tr></table></figure><p>注意：</p><ul><li>1.设置会话选项的隔离级别时，隔离级别中的每个单词之间需要用空格分隔</li><li>2.用表提示的隔离级别时，隔离级别中的每个单词之间不需要用空格分隔</li><li>3.表提示的隔离级别有同义词，如：NOLOCK-&gt;READUNCOMMITTED,HOLDLOCK-&gt;REPEATABLEREAD</li><li>4.隔离级别的严格性：<strong>1.未提交读&lt;2.已提交读&lt;3.可重复读&lt;4.可序列化</strong></li><li>5.隔离级别越高，一致性越高，并发性越低</li><li>6.基于快照的隔离级别，SQL Server将提交过的行保存到tempdb数据库中，当读操作发现行的当前版本和它们预期的不一致时，可以立即得到行的以前版本，从而不用请求共享锁也能取得预期的一致性。</li></ul><h2 id="4-4-隔离级别的行为方式"><a href="#4-4-隔离级别的行为方式" class="headerlink" title="4.4 隔离级别的行为方式"></a>4.4 隔离级别的行为方式</h2><h3 id="4-4-1-未提交读-（READ-UNCOMMITTED）"><a href="#4-4-1-未提交读-（READ-UNCOMMITTED）" class="headerlink" title="4.4.1 未提交读 （READ UNCOMMITTED）"></a>4.4.1 未提交读 （READ UNCOMMITTED）</h3><p>打开两个查询窗口，Connetion1,connection2</p><ul><li>Step1: 执行Connection1的阶段2的SQL 语句，然后执行connection2的SQL语句</li><li>Step2: 执行Connection1的阶段3的SQL 语句，执行connection2的SQL语句</li><li>Step3: 执行Connection1的阶段4的SQL 语句，执行connection2的SQL语句</li></ul><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br></pre></td><td class="code"><pre><span class="line">--阶段2</span><br><span class="line">UPDATE  myProduct</span><br><span class="line">SET     price = price + 1</span><br><span class="line">WHERE   id = 1;</span><br><span class="line">  </span><br><span class="line">SELECT  id ,</span><br><span class="line">        price</span><br><span class="line">FROM    dbo.myProduct</span><br><span class="line">WHERE   id = 1;</span><br><span class="line">  </span><br><span class="line">--阶段3</span><br><span class="line">UPDATE  myProduct</span><br><span class="line">SET     price = price + 5</span><br><span class="line">WHERE   id = 1;</span><br><span class="line">  </span><br><span class="line">SELECT  id ,</span><br><span class="line">        price</span><br><span class="line">FROM    dbo.myProduct</span><br><span class="line">WHERE   id = 1;</span><br><span class="line">  </span><br><span class="line">--阶段4</span><br><span class="line">COMMIT TRAN</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">--在阶段2执行之后</span><br><span class="line">SET TRAN ISOLATION LEVEL READ UNCOMMITTED</span><br><span class="line">BEGIN TRAN;</span><br><span class="line">SELECT  id ,</span><br><span class="line">        price</span><br><span class="line">FROM    dbo.myProduct</span><br><span class="line">WHERE   id = 1</span><br><span class="line"> </span><br><span class="line">COMMIT TRAN;</span><br></pre></td></tr></table></figure><p>两个事务的流程图：</p><p><img src="http://qiniu.zrbac.fun/69.png" alt="img"></p><ul><li>阶段1：Price=10,事务A对myProduct表请求排他锁</li><li>阶段2：事务A对myProduct表使用了排他锁，更新price = price + 1，然后事务A查询price的价格: price=11。事务B不请求任何锁，事务B在A更新Price之后进行查询，price=11</li><li>阶段3：事务A更新price = price + 5，然后事务A查询price的价格，price = 16。事务B查询price的价格: price=16</li><li>阶段4：事务A释放排他锁</li><li>阶段5：事务A中查询price的价格:price = 16。事务B查询price的价格: price=16</li></ul><p><strong>「大家可以看到事务B有两种结果，这就是“未提交读 （READ UNCOMMITTED）”隔离级别的含义：」</strong></p><p>（1）读操作可以读取未提交的修改（也称为脏读）。</p><p>（2）读操作不会妨碍写操作请求排他锁，其他事务正在进行读操作时，写操作可以同时对这些数据进行修改。</p><p>（3）事务A进行了多次修改，事务B在不同阶段进行查询时可能会有不同的结果。</p><h3 id="4-4-2-已提交读（READ-COMMITTED）（默认值）"><a href="#4-4-2-已提交读（READ-COMMITTED）（默认值）" class="headerlink" title="4.4.2 已提交读（READ COMMITTED）（默认值）"></a>4.4.2 已提交读（READ COMMITTED）（默认值）</h3><p>打开两个查询窗口，Connetion1,connection2</p><p>Step1: 执行Connection1的SQL 语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">UPDATE` `dbo.myProduct ``SET` `price = price + 1 ``WHERE` `id=1</span><br><span class="line">SELECT` `* ``FROM` `dbo.myProduct ``WHERE` `id =1</span><br></pre></td></tr></table></figure><p>Step2: 执行Connection2的SQL 语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">SET` `TRANSACTION` `ISOLATION` `LEVEL` `READ` `COMMITTED</span><br><span class="line">SELECT` `* ``FROM` `dbo.myProduct ``WHERE` `id = 1</span><br></pre></td></tr></table></figure><p>两个事务的流程图：</p><p><img src="http://qiniu.zrbac.fun/70.png" alt="img"></p><ul><li>阶段1：Price=10,事务A对myProduct表请求排他锁</li><li>阶段2：事务A对myProduct表使用了排他锁，更新price = price + 1，然后事务A查询price的价格: price=11。然后事务B请求共享锁进行读操作，查询price，</li></ul><p>由于在当前隔离级别下，事务A的排他锁和事务B的共享锁存在冲突，所以事务B需要等待事务A释放排他锁后才能读取数据。</p><ul><li><p>阶段3：事务A提交事务（COMMIT TRAN）</p></li><li><p>阶段4：事务A提交完事务后，释放排他锁</p></li><li><p>阶段5：事务B获得了共享锁，进行读操作，price=11</p><p><strong>「“已提交读 （READ UNCOMMITTED）”隔离级别的含义：」</strong></p></li></ul><p>（1）必须获得共享锁才能进行读操作，其他事务如果对该资源持有排他锁，则共享锁必须等待排他锁释放。</p><p>（2）读操作不能读取未提交的修改，读操作读取到的数据是提交过的修改。</p><p>（3）读操作不会在事务持续期间内保留共享锁，其他事务可以在两个读操作之间更改数据资源，读操作因而可能每次得到不同的取值。这种现象称为“不可重复读”</p><h3 id="4-4-3-可重复读（REPEATABLE-READ）"><a href="#4-4-3-可重复读（REPEATABLE-READ）" class="headerlink" title="4.4.3 可重复读（REPEATABLE READ）"></a>4.4.3 可重复读（REPEATABLE READ）</h3><p>打开两个查询窗口，Connetion1,connection2</p><p>Step1: 执行Connection1的SQL 语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">SET` `TRANSACTION` `ISOLATION` `LEVEL` `REPEATABLE` `READ</span><br><span class="line">SELECT` `* ``FROM` `dbo.myProduct ``WHERE` `id = 1</span><br></pre></td></tr></table></figure><p>Step2: 执行Connection2的SQL 语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">UPDATE` `dbo.myProduct ``SET` `price = price + 1 ``WHERE` `id=1</span><br></pre></td></tr></table></figure><p>演示与总结如下所示：</p><p><img src="http://qiniu.zrbac.fun/71.png" alt="img"></p><p>两个事务的流程图：</p><p><img src="http://qiniu.zrbac.fun/72.png" alt="img"></p><ul><li>阶段1：Price=10,事务A对myProduct表请求共享锁</li><li>阶段2：事务A对myProduct表使用了共享锁，事务A查询price的价格: price=10，事务A一直持有共享锁直到事务A完成为止。然后事务B请求排他锁进行写操作price=price+1，</li></ul><p>由于在当前隔离级别下，事务A的共享锁和事务B请求的排他锁存在冲突，所以事务B需要等待事务A释放共享锁后才能修改数据。</p><ul><li>阶段3：事务A查询price, price=10, 说明事务B的更新操作被阻塞了，更新操作没有被执行。然后事务A提交事务（COMMIT TRAN）</li><li>阶段4：事务A提交完事务后，释放共享锁</li><li>阶段5：事务B获得了排他锁，进行写操作，price=11</li></ul><p>*<em>“可重复读 （REPEATABLE READ）”隔离级别的含义： *</em></p><p>（1）必须获得共享锁才能进行读操作，获得的共享锁将一直保持直到事务完成之止。</p><p>（2）在获得共享锁的事务完成之前，没有其他事务能够获得排他锁修改这一数据资源，这样可以保证实现可重复的读取。</p><p>（3）两个事务在第一次读操作之后都将保留它们获得的共享锁，所以任何一个事务都不能获得为了更新数据而需要的排他锁，这种情况将会导致死锁（deadlock），不过却避免了更新冲突。</p><h3 id="4-4-4-可序列化（SERIALIZABLE）"><a href="#4-4-4-可序列化（SERIALIZABLE）" class="headerlink" title="4.4.4 可序列化（SERIALIZABLE）"></a>4.4.4 可序列化（SERIALIZABLE）</h3><p>打开两个查询窗口，Connetion1,connection2<br>Step1: 执行Connection1的SQL 语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">BEGIN TRANSACTION</span><br><span class="line">SET TRANSACTION ISOLATION LEVEL SERIALIZABLE   </span><br><span class="line">SELECT * FROM dbo.myProduct WHERE id = 1</span><br></pre></td></tr></table></figure><p>Step2: 执行Connection2的SQL 语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">INSERT` `INTO` `dbo.myProduct(id, price) ``VALUES` `(1, 20)</span><br></pre></td></tr></table></figure><p>演示与总结如下所示：</p><p><img src="http://qiniu.zrbac.fun/73.png" alt="img"></p><p>两个事务的流程图：</p><p><img src="http://qiniu.zrbac.fun/74.png" alt="img"></p><ul><li>阶段1：Price=10,事务A对myProduct表请求共享锁</li><li>阶段2：事务A对myProduct表使用了共享锁，事务A查询id=1的price的价格:1行记录，price=10，事务A一直持有共享锁直到事务A完成为止。然后事务B请求排他锁进行插入操作id=1,price=20，</li></ul><p>由于在当前隔离级别下，事务B试图增加能够满足事务A的读操作的查询搜索条件的新行，所以事务A的共享锁和事务B请求的排他锁存在冲突，事务B需要等待事务A释放共享锁后才能插入数据。</p><ul><li>阶段3：事务A查询出id=1的数据只有1行，说明事务B的插入操作被阻塞了，插入操作没有被执行。然后事务A提交事务（COMMIT TRAN）</li><li>阶段4：事务A提交完事务后，释放共享锁</li><li>阶段5：事务B获得了排他锁，进行插入操作，插入成功，查询出id=1的数据有两条-</li></ul><p><strong>「“可序列化（SERIALIZABLE）”隔离级别的含义：」</strong></p><p>（1）必须获得共享锁才能进行读操作，获得的共享锁将一直保持直到事务完成之止。</p><p>（2）在获得共享锁的事务完成之前，没有其他事务能够获得排他锁修改这一数据资源，且当其他事务增加能够满足当前事务的读操作的查询搜索条件的新行时，其他事务将会被阻塞，直到当前事务完成然后释放共享锁，其他事务才能获得排他锁进行插入操作。</p><p>（3）事务中的读操作在任何情况下读取到的数据是一致的，不会出现幻影行（幻读）。</p><p>（4）范围锁：读操作锁定满足查询搜索条件范围的锁。</p><h2 id="4-5-隔离级别总结"><a href="#4-5-隔离级别总结" class="headerlink" title="4.5 隔离级别总结"></a>4.5 隔离级别总结</h2><p><strong>「脏读：」</strong> 读取未提交的更改。</p><p><strong>「不可重复读：」</strong> 读操作不会在事务持续期间内保留共享锁，其他事务可以在两个读操作之间更改数据资源，读操作因而可能每次得到不同的取值。</p><p><strong>「丢失更新：」</strong> 两个事务进行读操作，获得资源上的共享锁，读取完数据后，不再持有资源上的任何锁，两个事务都能更新这个值，最后进行更新的事务将会覆盖其他事务做的更改，导致其他事务更改的数据丢失。</p><p><strong>「幻读：」</strong> 第一次和第二次读取到的数据行数不一致。</p><p><strong>「范围锁：」</strong> 读操作锁定满足查询搜索条件范围的锁</p><p><img src="data:image/gif;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVQImWNgYGBgAAAABQABh6FO1AAAAABJRU5ErkJggg==" alt="img"> <img src="http://qiniu.zrbac.fun/75.png" alt="img"></p><h1 id="五-死锁"><a href="#五-死锁" class="headerlink" title="五.死锁"></a>五.死锁</h1><p><img src="http://qiniu.zrbac.fun/76.png" alt="img"></p><p>死锁是指一种进程之间互相永久阻塞的状态，可能涉及两个或更多的进程。</p><p>打开两个查询窗口，Connetion1,connection2</p><p>Step1: 执行Connection1的SQL 语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">SET` `TRANSACTION` `ISOLATION` `LEVEL` `READ` `COMMITTED</span><br><span class="line">BEGIN` `TRAN</span><br><span class="line">UPDATE` `dbo.myProduct ``SET` `price = price + 1 ``WHERE` `id=1</span><br><span class="line">SELECT` `* ``FROM` `dbo.myOrder ``WHERE` `id =1</span><br></pre></td></tr></table></figure><p>Step2: 执行Connection2的SQL 语句</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">SET` `TRANSACTION` `ISOLATION` `LEVEL` `READ` `COMMITTED</span><br><span class="line">BEGIN` `TRAN</span><br><span class="line">UPDATE` `dbo.myOrder ``SET` `customer = ``&apos;ddd&apos;` `WHERE` `id = 1</span><br><span class="line">SELECT` `* ``FROM` `dbo.myProduct ``WHERE` `id = 1</span><br></pre></td></tr></table></figure><p>演示与总结如下所示：</p><p><img src="data:image/gif;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVQImWNgYGBgAAAABQABh6FO1AAAAABJRU5ErkJggg==" alt="img"> <img src="http://qiniu.zrbac.fun/77.png" alt="img"></p><p>两个事务的流程图：</p><p><img src="http://qiniu.zrbac.fun/78.png" alt="img"></p><ul><li>阶段1：Price=10,事务A对myProduct表请求排他锁。Customer = aaa,事务B对myOrder请求排他锁</li><li>阶段2：事务A对myProduct表使用了排他锁，更新price = price + 1。然后事务B对myOrder表使用了排他锁，更新customer=ddd。</li><li>阶段3：事务A查询myOrder表，对myOrder表请求共享锁，因为事务A的请求的共享锁与事务B的排他锁冲突，所以事务A被阻塞。然后事务B查询myProduct表，对myProduct表请求共享锁，因为事务B的请求的共享锁与事务A的排他锁冲突，所以事务B被阻塞。</li><li>阶段4：事务A等待事务B的排他锁释放，事务B等待事务A的排他锁释放，导致死锁。事务A和事务B都被阻塞了。</li><li>阶段5：SQL Server在几秒之内检测到死锁，会选择一个事务作为死锁的牺牲品，终止这个事务，并回滚这个事务所做的操作。在这个例子中，事务A被终止，提示信息：事务(进程 ID 53)与另一个进程被死锁在 锁 资源上，并且已被选作死锁牺牲品。请重新运行该事务。</li></ul><p>“<strong>「死锁 （Dead Lock）」</strong>” 的一些注意事项：</p><p>（1）如果两个事务没有设置死锁优先级，且两个事务进行的工作量也差不多一样时，任何一个事务都有可能被终止。</p><p>（2）解除死锁要付出一定的系统开销，因为这个过程会涉及撤销已经执行过的处理。</p><p>（3）事务处理的时间时间越长，持有锁的时间就越长，死锁的可能性也就越大，应该尽可能保持事务简短，把逻辑上可以不属于同一个工作单元的操作移到事务以外。</p><p>（4）上面的例子中，事务A和事务B以相反顺序访问资源，所以发生了死锁。如果两个事务按同样的顺序来访问资源，则不会发生这种类型的死锁。在不改变程序的逻辑情况下，可以通过交换顺序来解决死锁的问题。</p>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;事务-隔离级别-阻塞-死锁&quot;&gt;&lt;a href=&quot;#事务-隔离级别-阻塞-死锁&quot; class=&quot;headerlink&quot; title=&quot;事务+隔离级别+阻塞+死锁&quot;&gt;&lt;/a&gt;事务+隔离级别+阻塞+死锁&lt;/h2&gt;&lt;p&gt;本篇主要内容如下：&lt;/p&gt;
&lt;p&gt;&lt;img src=&quot;http://qiniu.zrbac.fun/46.png&quot; alt=&quot;img&quot;&gt;&lt;/p&gt;
&lt;h1 id=&quot;一、事务&quot;&gt;&lt;a href=&quot;#一、事务&quot; class=&quot;headerlink&quot; title=&quot;一、事务&quot;&gt;&lt;/a&gt;一、事务&lt;/h1&gt;&lt;h2 id=&quot;1-1-什么是事务&quot;&gt;&lt;a href=&quot;#1-1-什么是事务&quot; class=&quot;headerlink&quot; title=&quot;1.1 什么是事务&quot;&gt;&lt;/a&gt;1.1 什么是事务&lt;/h2&gt;&lt;p&gt;为单个工作单元而执行的一系列操作。如查询、修改数据、修改数据定义。&lt;/p&gt;
&lt;h2 id=&quot;1-2-语法&quot;&gt;&lt;a href=&quot;#1-2-语法&quot; class=&quot;headerlink&quot; title=&quot;1.2 语法&quot;&gt;&lt;/a&gt;1.2 语法&lt;/h2&gt;&lt;p&gt;&lt;strong&gt;「（1）显示定义事务的开始、提交」&lt;/strong&gt;&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;BEGIN` `TRAN``INSERT` `INTO` `b(t1) ``VALUES``(1)``INSERT` `INTO` `b(t1) ``VALUES``(2)``COMMIT` `TRAN&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;p&gt;&lt;strong&gt;「（2）隐式定义」&lt;/strong&gt;&lt;/p&gt;
&lt;p&gt;如果不显示定义事务的边界，则SQL Server会默认把每个单独的语句作为一个事务，即在执行完每个语句之后就会自动提交事务。&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="数据库" scheme="https://zrbac.github.io/tags/%E6%95%B0%E6%8D%AE%E5%BA%93/"/>
    
  </entry>
  
  <entry>
    <title>@Transactional事务问题分析</title>
    <link href="https://zrbac.github.io/2020/09/07/Transactional%E4%BA%8B%E5%8A%A1%E9%97%AE%E9%A2%98%E5%88%86%E6%9E%90/"/>
    <id>https://zrbac.github.io/2020/09/07/Transactional%E4%BA%8B%E5%8A%A1%E9%97%AE%E9%A2%98%E5%88%86%E6%9E%90/</id>
    <published>2020-09-07T09:46:18.000Z</published>
    <updated>2020-09-07T09:47:10.996Z</updated>
    
    <content type="html"><![CDATA[<h2 id="一个-Transactional哪里来这么多坑？"><a href="#一个-Transactional哪里来这么多坑？" class="headerlink" title="一个@Transactional哪里来这么多坑？"></a>一个@Transactional哪里来这么多坑？</h2><p><a href="https://mp.weixin.qq.com/s/infwcTVeEYK3RmI6I9NEog#" target="_blank" rel="noopener"> 以下文章来源于程序员DMZ ，作者程序员DMZ </a></p><p><strong>前言</strong></p><p>这篇文章我们来聊一聊平常工作时使用事务可能出现的一些问题（本文主要针对使用<code>@Transactional</code>进行事务管理的方式进行讨论）以及对应的解决方案</p><ol><li>事务失效</li><li>事务回滚相关问题</li><li>读写分离跟事务结合使用时的问题</li></ol><h1 id="事务失效"><a href="#事务失效" class="headerlink" title="事务失效"></a>事务失效</h1><p>事务失效我们一般要从两个方面排查问题</p><h2 id="数据库层面"><a href="#数据库层面" class="headerlink" title="数据库层面"></a>数据库层面</h2><p>数据库层面，数据库使用的存储引擎是否支持事务？默认情况下MySQL数据库使用的是Innodb存储引擎（5.5版本之后），它是支持事务的，但是如果你的表特地修改了存储引擎，例如，你通过下面的语句修改了表使用的存储引擎为<code>MyISAM</code>，而<code>MyISAM</code>又是不支持事务的</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">alter table table_name engine=myisam;</span><br></pre></td></tr></table></figure><p>这样就会出现“事务失效”的问题了</p><p><strong>「解决方案」</strong>：修改存储引擎为<code>Innodb</code>。</p><a id="more"></a><h2 id="业务代码层面"><a href="#业务代码层面" class="headerlink" title="业务代码层面"></a>业务代码层面</h2><p>业务层面的代码是否有问题，这就有很多种可能了</p><ol><li>我们要使用Spring的声明式事务，那么需要执行事务的Bean是否已经交由了Spring管理？在代码中的体现就是类上是否有<code>@Service</code>、<code>Component</code>等一系列注解</li></ol><p><strong>「解决方案」</strong>：将Bean交由Spring进行管理（添加<code>@Service</code>注解）</p><ol><li><code>@Transactional</code>注解是否被放在了合适的位置。在上篇文章中我们对Spring中事务失效的原理做了详细的分析，其中也分析了Spring内部是如何解析<code>@Transactional</code>注解的，我们稍微回顾下代码：</li></ol><p><img src="http://qiniu.zrbac.fun/36.png" alt="img">注解解析</p><blockquote><p>❝</p><p>代码位于：<code>AbstractFallbackTransactionAttributeSource#computeTransactionAttribute</code>中</p><p>❞</p></blockquote><p>也就是说，默认情况下你无法使用<code>@Transactional</code>对一个非public的方法进行事务管理</p><p><strong>「解决方案」</strong>：修改需要事务管理的方法为<code>public</code>。</p><ol><li>出现了自调用。什么是自调用呢？我们看个例子</li></ol><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta">@Service</span></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">DmzService</span> </span>&#123;</span><br><span class="line"> </span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveAB</span><span class="params">(A a, B b)</span> </span>&#123;</span><br><span class="line">  saveA(a);</span><br><span class="line">  saveB(b);</span><br><span class="line"> &#125;</span><br><span class="line"></span><br><span class="line"> <span class="meta">@Transactional</span></span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveA</span><span class="params">(A a)</span> </span>&#123;</span><br><span class="line">  dao.saveA(a);</span><br><span class="line"> &#125;</span><br><span class="line"> </span><br><span class="line"> <span class="meta">@Transactional</span></span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveB</span><span class="params">(B b)</span></span>&#123;</span><br><span class="line">  dao.saveB(a);</span><br><span class="line"> &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>上面三个方法都在同一个类<code>DmzService</code>中，其中<code>saveAB</code>方法中调用了本类中的<code>saveA</code>跟<code>saveB</code>方法，这就是自调用。在上面的例子中<code>saveA</code>跟<code>saveB</code>上的事务会失效</p><p>那么自调用为什么会导致事务失效呢？我们知道Spring中事务的实现是依赖于<code>AOP</code>的，当容器在创建<code>dmzService</code>这个Bean时，发现这个类中存在了被<code>@Transactional</code>标注的方法（修饰符为public）那么就需要为这个类创建一个代理对象并放入到容器中，创建的代理对象等价于下面这个类</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">DmzServiceProxy</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">private</span> DmzService dmzService;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">DmzServiceProxy</span><span class="params">(DmzService dmzService)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">this</span>.dmzService = dmzService;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveAB</span><span class="params">(A a, B b)</span> </span>&#123;</span><br><span class="line">        dmzService.saveAB(a, b);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveA</span><span class="params">(A a)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">try</span> &#123;</span><br><span class="line">            <span class="comment">// 开启事务</span></span><br><span class="line">            startTransaction();</span><br><span class="line">            dmzService.saveA(a);</span><br><span class="line">        &#125; <span class="keyword">catch</span> (Exception e) &#123;</span><br><span class="line">            <span class="comment">// 出现异常回滚事务</span></span><br><span class="line">            rollbackTransaction();</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">// 提交事务</span></span><br><span class="line">        commitTransaction();</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveB</span><span class="params">(B b)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">try</span> &#123;</span><br><span class="line">            <span class="comment">// 开启事务</span></span><br><span class="line">            startTransaction();</span><br><span class="line">            dmzService.saveB(b);</span><br><span class="line">        &#125; <span class="keyword">catch</span> (Exception e) &#123;</span><br><span class="line">            <span class="comment">// 出现异常回滚事务</span></span><br><span class="line">            rollbackTransaction();</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">// 提交事务</span></span><br><span class="line">        commitTransaction();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>上面是一段伪代码，通过<code>startTransaction</code>、<code>rollbackTransaction</code>、<code>commitTransaction</code>这三个方法模拟代理类实现的逻辑。因为目标类<code>DmzService</code>中的<code>saveA</code>跟<code>saveB</code>方法上存在<code>@Transactional</code>注解，所以会对这两个方法进行拦截并嵌入事务管理的逻辑，同时<code>saveAB</code>方法上没有<code>@Transactional</code>，相当于代理类直接调用了目标类中的方法。</p><p>我们会发现当通过代理类调用<code>saveAB</code>时整个方法的调用链如下：</p><p><img src="http://qiniu.zrbac.fun/37.png" alt="img"></p><p>实际上我们在调用<code>saveA</code>跟<code>saveB</code>时调用的是目标类中的方法，这种清空下，事务当然会失效。</p><p>常见的自调用导致的事务失效还有一个例子，如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta">@Service</span></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">DmzService</span> </span>&#123;</span><br><span class="line"> <span class="meta">@Transactional</span></span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">save</span><span class="params">(A a, B b)</span> </span>&#123;</span><br><span class="line">  saveB(b);</span><br><span class="line"> &#125;</span><br><span class="line"> </span><br><span class="line"> <span class="meta">@Transactional</span>(propagation = Propagation.REQUIRES_NEW)</span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveB</span><span class="params">(B b)</span></span>&#123;</span><br><span class="line">  dao.saveB(a);</span><br><span class="line"> &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>当我们调用<code>save</code>方法时，我们预期的执行流程是这样的</p><p><img src="http://qiniu.zrbac.fun/38.png" alt="img"></p><p>也就是说两个事务之间互不干扰，每个事务都有自己的开启、回滚、提交操作。</p><p>但根据之前的分析我们知道，实际上在调用saveB方法时，是直接调用的目标类中的saveB方法，在saveB方法前后并不会有事务的开启或者提交、回滚等操作，实际的流程是下面这样的</p><p><img src="http://qiniu.zrbac.fun/39.png" alt="img"></p><p>由于saveB方法实际上是由dmzService也就是目标类自己调用的，所以在saveB方法的前后并不会执行事务的相关操作。这也是自调用带来问题的根本原因：<strong>「自调用时，调用的是目标类中的方法而不是代理类中的方法」</strong></p><p><strong>「解决方案」</strong>：</p><ol><li><p>自己注入自己，然后显示的调用，例如：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta">@Service</span></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">DmzService</span> </span>&#123;</span><br><span class="line"> <span class="comment">// 自己注入自己</span></span><br><span class="line"> <span class="meta">@Autowired</span></span><br><span class="line"> DmzService dmzService;</span><br><span class="line"> </span><br><span class="line"> <span class="meta">@Transactional</span></span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">save</span><span class="params">(A a, B b)</span> </span>&#123;</span><br><span class="line">  dmzService.saveB(b);</span><br><span class="line"> &#125;</span><br><span class="line"></span><br><span class="line"> <span class="meta">@Transactional</span>(propagation = Propagation.REQUIRES_NEW)</span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveB</span><span class="params">(B b)</span></span>&#123;</span><br><span class="line">  dao.saveB(a);</span><br><span class="line"> &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这种方案看起来不是很优雅</p></li><li><p>利用<code>AopContext</code>，如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta">@Service</span></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">DmzService</span> </span>&#123;</span><br><span class="line"></span><br><span class="line"> <span class="meta">@Transactional</span></span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">save</span><span class="params">(A a, B b)</span> </span>&#123;</span><br><span class="line">  ((DmzService) AopContext.currentProxy()).saveB(b);</span><br><span class="line"> &#125;</span><br><span class="line"></span><br><span class="line"> <span class="meta">@Transactional</span>(propagation = Propagation.REQUIRES_NEW)</span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">saveB</span><span class="params">(B b)</span></span>&#123;</span><br><span class="line">  dao.saveB(a);</span><br><span class="line"> &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><blockquote><p>❝</p><p>使用上面这种解决方案需要注意的是，需要在配置类上新增一个配置</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">&gt; <span class="comment">// exposeProxy=true代表将代理类放入到线程上下文中，默认是false</span></span><br><span class="line">&gt; <span class="meta">@EnableAspectJAutoProxy</span>(exposeProxy = <span class="keyword">true</span>)</span><br><span class="line">&gt;</span><br></pre></td></tr></table></figure></blockquote><blockquote><p>❞</p></blockquote><p>个人比较喜欢的是第二种方式</p></li></ol><p>这里我们做个来做个小总结</p><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><p>一图胜千言</p><p><img src="http://qiniu.zrbac.fun/40.png" alt="img">事务失效的原因</p><h1 id="事务回滚相关问题"><a href="#事务回滚相关问题" class="headerlink" title="事务回滚相关问题"></a>事务回滚相关问题</h1><p>回滚相关的问题可以被总结为两句话</p><ol><li>想回滚的时候事务却提交了</li><li>想提交的时候被标记成只能回滚了（rollback only）</li></ol><p>先看第一种情况：<strong>「想回滚的时候事务却提交了」</strong>。这种情况往往是程序员对Spring中事务的<code>rollbackFor</code>属性不够了解导致的。</p><blockquote><p>❝</p><p>Spring默认抛出了未检查<code>unchecked</code>异常（继承自 <code>RuntimeException</code> 的异常）或者 <code>Error</code>才回滚事务；其他异常不会触发回滚事务，已经执行的SQL会提交掉。如果在事务中抛出其他类型的异常，但却期望 Spring 能够回滚事务，就需要指定<code>rollbackFor</code>属性。</p><p>❞</p></blockquote><p>对应代码其实我们上篇文章也分析过了，如下：</p><p><img src="http://qiniu.zrbac.fun/41.png" alt="img">回滚代码</p><blockquote><p>❝</p><p>以上代码位于：<code>TransactionAspectSupport#completeTransactionAfterThrowing</code>方法中</p><p>❞</p></blockquote><p>默认情况下，只有出现<code>RuntimeException</code>或者<code>Error</code>才会回滚</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">rollbackOn</span><span class="params">(Throwable ex)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">return</span> (ex <span class="keyword">instanceof</span> RuntimeException || ex <span class="keyword">instanceof</span> Error);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>所以，如果你想在出现了非<code>RuntimeException</code>或者<code>Error</code>时也回滚，请指定回滚时的异常，例如：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta">@Transactional</span>(rollbackFor = Exception.class)</span><br></pre></td></tr></table></figure><p>第二种情况：<strong>「想提交的时候被标记成只能回滚了（rollback only）」</strong>。</p><p>对应的异常信息如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Transaction rolled back because it has been marked as rollback-only</span><br></pre></td></tr></table></figure><p>我们先来看个例子吧</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta">@Service</span></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">DmzService</span> </span>&#123;</span><br><span class="line"></span><br><span class="line"> <span class="meta">@Autowired</span></span><br><span class="line"> IndexService indexService;</span><br><span class="line"></span><br><span class="line"> <span class="meta">@Transactional</span></span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">testRollbackOnly</span><span class="params">()</span> </span>&#123;</span><br><span class="line">  <span class="keyword">try</span> &#123;</span><br><span class="line">   indexService.a();</span><br><span class="line">  &#125; <span class="keyword">catch</span> (ClassNotFoundException e) &#123;</span><br><span class="line">   System.out.println(<span class="string">"catch"</span>);</span><br><span class="line">  &#125;</span><br><span class="line"> &#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="meta">@Service</span></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">IndexService</span> </span>&#123;</span><br><span class="line"> <span class="meta">@Transactional</span>(rollbackFor = Exception.class)</span><br><span class="line"> <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">a</span><span class="params">()</span> <span class="keyword">throws</span> ClassNotFoundException</span>&#123;</span><br><span class="line">  <span class="comment">// ......</span></span><br><span class="line">  <span class="keyword">throw</span> <span class="keyword">new</span> ClassNotFoundException();</span><br><span class="line"> &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>在上面这个例子中，<code>DmzService</code>的<code>testRollbackOnly</code>方法跟<code>IndexService</code>的<code>a</code>方法都开启了事务，并且事务的传播级别为<code>required</code>，所以当我们在<code>testRollbackOnly</code>中调用<code>IndexService</code>的<code>a</code>方法时这两个方法应当是共用的一个事务。按照这种思路，虽然<code>IndexService</code>的<code>a</code>方法抛出了异常，但是我们在<code>testRollbackOnly</code>将异常捕获了，那么这个事务应该是可以正常提交的，为什么会抛出异常呢？</p><p>如果你看过我之前的源码分析的文章应该知道，在处理回滚时有这么一段代码</p><p><img src="http://qiniu.zrbac.fun/42.png" alt="img">rollback Only设置</p><p>在提交时又做了下面这个判断（这个方法我删掉了一些不重要的代码）</p><p><img src="http://qiniu.zrbac.fun/43.png" alt="img"><code>commit_rollbackOnly</code></p><p>可以看到当提交时发现事务已经被标记为<code>rollbackOnly</code>后会进入回滚处理中，并且unexpected传入的为true。在处理回滚时又有下面这段代码</p><p><img src="http://qiniu.zrbac.fun/44.png" alt="img">抛出异常</p><p>最后在这里抛出了这个异常。</p><blockquote><p>❝</p><p>以上代码均位于<code>AbstractPlatformTransactionManager</code>中</p><p>❞</p></blockquote><p>总结起来，<strong>「主要的原因就是因为内部事务回滚时将整个大事务做了一个<code>rollbackOnly</code>的标记」</strong>，所以即使我们在外部事务中catch了抛出的异常，整个事务仍然无法正常提交，并且如果你希望正常提交，Spring还会抛出一个异常。</p><p><strong>「解决方案」</strong>:</p><p>这个解决方案要依赖业务而定，你要明确你想要的结果是什么</p><ol><li>内部事务发生异常，外部事务catch异常后，内部事务自行回滚，不影响外部事务</li></ol><blockquote><p>❝</p><p>将内部事务的传播级别设置为nested/requires_new均可。在我们的例子中就是做如下修改：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">&gt; <span class="comment">// @Transactional(rollbackFor = Exception.class,propagation = Propagation.REQUIRES_NEW)</span></span><br><span class="line">&gt; <span class="meta">@Transactional</span>(rollbackFor = Exception.class,propagation = Propagation.NESTED)</span><br><span class="line">&gt; <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">a</span><span class="params">()</span> <span class="keyword">throws</span> ClassNotFoundException</span>&#123;</span><br><span class="line">&gt; <span class="comment">// ......</span></span><br><span class="line">&gt; <span class="keyword">throw</span> <span class="keyword">new</span> ClassNotFoundException();</span><br><span class="line">&gt; &#125;</span><br><span class="line">&gt;</span><br></pre></td></tr></table></figure></blockquote><blockquote><p>❞</p></blockquote><p>虽然这两者都能得到上面的结果，但是它们之间还是有不同的。当传播级别为<code>requires_new</code>时，两个事务完全没有联系，各自都有自己的事务管理机制（开启事务、关闭事务、回滚事务）。但是传播级别为<code>nested</code>时，实际上只存在一个事务，只是在调用a方法时设置了一个保存点，当a方法回滚时，实际上是回滚到保存点上，并且当外部事务提交时，内部事务才会提交，外部事务如果回滚，内部事务会跟着回滚。</p><ol><li>内部事务发生异常时，外部事务catch异常后，内外两个事务都回滚，但是方法不抛出异常</li></ol><blockquote><p>❝</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line">&gt; <span class="meta">@Transactional</span></span><br><span class="line">&gt; <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">testRollbackOnly</span><span class="params">()</span> </span>&#123;</span><br><span class="line">&gt; <span class="keyword">try</span> &#123;</span><br><span class="line">&gt;    indexService.a();</span><br><span class="line">&gt; &#125; <span class="keyword">catch</span> (ClassNotFoundException e) &#123;</span><br><span class="line">&gt;    <span class="comment">// 加上这句代码</span></span><br><span class="line">&gt;    TransactionInterceptor.currentTransactionStatus().setRollbackOnly();</span><br><span class="line">&gt; &#125;</span><br><span class="line">&gt; &#125;</span><br><span class="line">&gt;</span><br></pre></td></tr></table></figure></blockquote><blockquote><p>❞</p></blockquote><p>通过显示的设置事务的状态为<code>RollbackOnly</code>。这样当提交事务时会进入下面这段代码</p><p><img src="http://qiniu.zrbac.fun/45.png" alt="img"></p><p><img src="data:image/gif;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVQImWNgYGBgAAAABQABh6FO1AAAAABJRU5ErkJggg==" alt="img">显示回滚</p><p>最大的区别在于处理回滚时第二个参数传入的是false,这意味着回滚是回滚是预期之中的，所以在处理完回滚后并不会抛出异常。</p><h1 id="读写分离跟事务结合使用时的问题"><a href="#读写分离跟事务结合使用时的问题" class="headerlink" title="读写分离跟事务结合使用时的问题"></a>读写分离跟事务结合使用时的问题</h1><p>读写分离一般有两种实现方式</p><ol><li>配置多数据源</li><li>依赖中间件，如<code>MyCat</code></li></ol><p>如果是配置了多数据源的方式实现了读写分离，那么需要注意的是：<strong>「如果开启了一个读写事务，那么必须使用写节点」</strong>，<strong>「如果是一个只读事务，那么可以使用读节点」</strong></p><p>如果是依赖于<code>MyCat</code>等中间件那么需要注意：<strong>「只要开启了事务，事务内的SQL都会使用写节点（依赖于具体中间件的实现，也有可能会允许使用读节点，具体策略需要自行跟DB团队确认）」</strong></p><p>基于上面的结论，我们在使用事务时应该更加谨慎，在没有必要开启事务时尽量不要开启。</p><blockquote><p>❝</p><p>一般我们会在配置文件配置某些约定的方法名字前缀开启不同的事务（或者不开启），但现在随着注解事务的流行，好多开发人员（或者架构师）搭建框架的时候在service类上加上了@Transactional注解，导致整个类都是开启事务的，这样严重影响数据库执行的效率，更重要的是开发人员不重视、或者不知道在查询类的方法上面自己加上@Transactional（propagation=Propagation.NOT_SUPPORTED）就会导致，所有的查询方法实际并没有走从库，导致主库压力过大。</p><p>❞</p></blockquote><p>其次，关于如果没有对只读事务做优化的话（优化意味着将只读事务路由到读节点），那么<code>@Transactional</code>注解中的<code>readOnly</code>属性就应该要慎用。我们使用<code>readOnly</code>的原本目的是为了将事务标记为只读，这样当MySQL服务端检测到是一个只读事务后就可以做优化，少分配一些资源（例如：只读事务不需要回滚，所以不需要分配undo log段）。但是当配置了读写分离后，可能会可能会导致只读事务内所有的SQL都被路由到了主库，读写分离也就失去了意义。</p>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;一个-Transactional哪里来这么多坑？&quot;&gt;&lt;a href=&quot;#一个-Transactional哪里来这么多坑？&quot; class=&quot;headerlink&quot; title=&quot;一个@Transactional哪里来这么多坑？&quot;&gt;&lt;/a&gt;一个@Transactional哪里来这么多坑？&lt;/h2&gt;&lt;p&gt;&lt;a href=&quot;https://mp.weixin.qq.com/s/infwcTVeEYK3RmI6I9NEog#&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt; 以下文章来源于程序员DMZ ，作者程序员DMZ &lt;/a&gt;&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;前言&lt;/strong&gt;&lt;/p&gt;
&lt;p&gt;这篇文章我们来聊一聊平常工作时使用事务可能出现的一些问题（本文主要针对使用&lt;code&gt;@Transactional&lt;/code&gt;进行事务管理的方式进行讨论）以及对应的解决方案&lt;/p&gt;
&lt;ol&gt;
&lt;li&gt;事务失效&lt;/li&gt;
&lt;li&gt;事务回滚相关问题&lt;/li&gt;
&lt;li&gt;读写分离跟事务结合使用时的问题&lt;/li&gt;
&lt;/ol&gt;
&lt;h1 id=&quot;事务失效&quot;&gt;&lt;a href=&quot;#事务失效&quot; class=&quot;headerlink&quot; title=&quot;事务失效&quot;&gt;&lt;/a&gt;事务失效&lt;/h1&gt;&lt;p&gt;事务失效我们一般要从两个方面排查问题&lt;/p&gt;
&lt;h2 id=&quot;数据库层面&quot;&gt;&lt;a href=&quot;#数据库层面&quot; class=&quot;headerlink&quot; title=&quot;数据库层面&quot;&gt;&lt;/a&gt;数据库层面&lt;/h2&gt;&lt;p&gt;数据库层面，数据库使用的存储引擎是否支持事务？默认情况下MySQL数据库使用的是Innodb存储引擎（5.5版本之后），它是支持事务的，但是如果你的表特地修改了存储引擎，例如，你通过下面的语句修改了表使用的存储引擎为&lt;code&gt;MyISAM&lt;/code&gt;，而&lt;code&gt;MyISAM&lt;/code&gt;又是不支持事务的&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;alter table table_name engine=myisam;&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;p&gt;这样就会出现“事务失效”的问题了&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;「解决方案」&lt;/strong&gt;：修改存储引擎为&lt;code&gt;Innodb&lt;/code&gt;。&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Spring" scheme="https://zrbac.github.io/tags/Spring/"/>
    
  </entry>
  
  <entry>
    <title>序列化和反序列化</title>
    <link href="https://zrbac.github.io/2020/08/28/%E5%BA%8F%E5%88%97%E5%8C%96%E5%92%8C%E5%8F%8D%E5%BA%8F%E5%88%97%E5%8C%96/"/>
    <id>https://zrbac.github.io/2020/08/28/%E5%BA%8F%E5%88%97%E5%8C%96%E5%92%8C%E5%8F%8D%E5%BA%8F%E5%88%97%E5%8C%96/</id>
    <published>2020-08-28T11:51:42.000Z</published>
    <updated>2020-08-28T12:00:07.784Z</updated>
    
    <content type="html"><![CDATA[<h1 id="序列化是干啥用的？"><a href="#序列化是干啥用的？" class="headerlink" title="序列化是干啥用的？"></a>序列化是干啥用的？</h1><p>序列化的原本意图是希望对一个Java对象作一下“变换”，变成字节序列，这样一来方便持久化存储到磁盘，避免程序运行结束后对象就从内存里消失，另外变换成字节序列也更便于网络运输和传播，所以概念上很好理解：</p><ul><li><strong>序列化</strong>：把Java对象转换为字节序列。</li><li><strong>反序列化</strong>：把字节序列恢复为原先的Java对象。</li></ul><p><img src="https://i0.hdslb.com/bfs/article/8469626c4d45bea2ebf49679b5d814457d4fef85.png@1320w_608h.webp" alt="img"></p><p>而且序列化机制从某种意义上来说也弥补了平台化的一些差异，毕竟转换后的字节流可以在其他平台上进行反序列化来恢复对象。</p><p>事情就是那么个事情，看起来很简单，不过后面的东西还不少，请往下看。</p><a id="more"></a><h1 id="对象如何序列化？"><a href="#对象如何序列化？" class="headerlink" title="对象如何序列化？"></a>对象如何序列化？</h1><p>然而Java目前并没有一个关键字可以直接去定义一个所谓的“可持久化”对象。</p><p>对象的持久化和反持久化需要靠程序员在代码里手动<strong>显式地</strong>进行序列化和反序列化还原的动作。</p><p>举个例子，假如我们要对<strong><code>Student</code></strong>类对象序列化到一个名为<strong><code>student.txt</code></strong>的文本文件中，然后再通过文本文件反序列化成<strong><code>Student</code></strong>类对象：</p><p><img src="https://i0.hdslb.com/bfs/article/d7bcfed9002453c6f39fab1a24962c7226403fe9.png@1320w_628h.webp" alt="img"></p><p><strong>1、Student类定义</strong></p><p><img src="https://i0.hdslb.com/bfs/article/ed81a71fd3f1b520e7b95b031cdc088e9616f28f.png@1320w_1172h.webp" alt="img"></p><p><strong>2、序列化</strong></p><p><img src="https://i0.hdslb.com/bfs/article/41ade4204eaa2f756963a575a834f4465b907b6f.png@1320w_748h.webp" alt="img"></p><p><strong>3、反序列化</strong></p><p><img src="https://i0.hdslb.com/bfs/article/1242c7c35935acc8b2ab2126791eb721837a9446.png@1320w_468h.webp" alt="img"></p><p><strong>4、运行结果</strong></p><p><img src="https://i0.hdslb.com/bfs/article/a99078edc4fc395db373ce8a0d992d4bb95267b2.png@1320w_560h.webp" alt="img"></p><h1 id="Serializable接口有何用？"><a href="#Serializable接口有何用？" class="headerlink" title="Serializable接口有何用？"></a>Serializable接口有何用？</h1><p>上面在定义<code>Student</code>类时，实现了一个<strong><code>Serializable</code></strong>接口，然而当我们点进<code>Serializable</code>接口内部查看，发现它<strong>竟然是一个空接口</strong>，并没有包含任何方法！</p><p><img src="https://i0.hdslb.com/bfs/article/c3ad48f484f306684c6f4c2f31cb138c1321b4db.png@1320w_1090h.webp" alt="img"></p><p>试想，如果上面在定义<code>Student</code>类时忘了加<strong><code>implements Serializable</code></strong>时会发生什么呢？</p><p>实验结果是：此时的程序运行<strong>会报错</strong>，并抛出<strong><code>NotSerializableException</code></strong>异常：</p><p><img src="https://i0.hdslb.com/bfs/article/73b3999a97a8605d254a0d56ec3f9b55b83e9685.png@1320w_324h.webp" alt="img"></p><p>我们按照错误提示，由源码一直跟到<strong><code>ObjectOutputStream</code></strong>的<strong><code>writeObject0()</code></strong>方法底层一看，才恍然大悟：</p><p><img src="https://i0.hdslb.com/bfs/article/9d90e23e037974adc27ed39950c7443d5493ba73.png@1320w_968h.webp" alt="img"></p><p>如果一个对象既不是<strong>字符串</strong>、<strong>数组</strong>、<strong>枚举</strong>，而且也没有实现<strong><code>Serializable</code></strong>接口的话，在序列化时就会抛出<strong><code>NotSerializableException</code></strong>异常！</p><p>哦，我明白了！</p><p>原来<code>Serializable</code>接口也<strong>仅仅只是做一个标记用！！！</strong></p><p>它告诉代码只要是实现了<code>Serializable</code>接口的类都是可以被序列化的！然而真正的序列化动作不需要靠它完成。</p><h1 id="serialVersionUID号有何用？"><a href="#serialVersionUID号有何用？" class="headerlink" title="serialVersionUID号有何用？"></a><code>serialVersionUID</code>号有何用？</h1><p>相信你一定经常看到有些类中定义了如下代码行，即定义了一个名为<strong><code>serialVersionUID</code></strong>的字段：</p><p><img src="https://i0.hdslb.com/bfs/article/40892b697d85b16ef659faf6a2487f911d9c34d3.png@1320w_168h.webp" alt="img"></p><p><strong>你知道这句声明的含义吗？为什么要搞一个名为<code>serialVersionUID</code>的序列号？</strong></p><p>继续来做一个简单实验，还拿上面的<code>Student</code>类为例，我们并没有人为在里面显式地声明一个<strong><code>serialVersionUID</code></strong>字段。</p><p>我们首先还是调用上面的<strong><code>serialize()</code></strong>方法，将一个<code>Student</code>对象序列化到本地磁盘上的<code>student.txt</code>文件：</p><p><img src="https://i0.hdslb.com/bfs/article/bd2f6d47c2aea42dfed58793e8a9f271ba1b27ce.png@1320w_614h.webp" alt="img"></p><p>接下来我们在<code>Student</code>类里面动点手脚，比如在里面再增加一个名为<strong><code>studentID</code></strong>的字段，表示学生学号：</p><p><img src="https://i0.hdslb.com/bfs/article/1e3760481c884871040a70ae1bd8dcd4a38090ea.png@1320w_534h.webp" alt="img"></p><p>这时候，我们拿刚才已经序列化到本地的<code>student.txt</code>文件，还用如下代码进行反序列化，试图还原出刚才那个<code>Student</code>对象：</p><p><img src="https://i0.hdslb.com/bfs/article/06d8b766b0dbb627837c934a974df0e255329ca7.png@1320w_470h.webp" alt="img"></p><p>运行发现<strong>报错了</strong>，并且抛出了<strong><code>InvalidClassException</code></strong>异常：</p><p><img src="https://i0.hdslb.com/bfs/article/8b9203293f9b6436a0262341bba90815949d1caf.png@1320w_622h.webp" alt="img"></p><p>这地方提示的信息非常明确了：序列化前后的<code>serialVersionUID</code>号码不兼容！</p><p>从这地方最起码可以得出<strong>两个</strong>重要信息：</p><ul><li><strong>1、serialVersionUID是序列化前后的唯一标识符</strong></li><li><strong>2、默认如果没有人为显式定义过**</strong><code>serialVersionUID</code>，那编译器会为它自动声明一个！**</li></ul><p><strong>第1个问题**</strong>：** <code>serialVersionUID</code>序列化ID，可以看成是序列化和反序列化过程中的“暗号”，在反序列化时，JVM会把字节流中的序列号ID和被序列化类中的序列号ID做比对，只有两者一致，才能重新反序列化，否则就会报异常来终止反序列化的过程。</p><p><strong>第2个问题**</strong>：** 如果在定义一个可序列化的类时，没有人为显式地给它定义一个<code>serialVersionUID</code>的话，则Java运行时环境会根据该类的各方面信息自动地为它生成一个默认的<code>serialVersionUID</code>，一旦像上面一样更改了类的结构或者信息，则类的<code>serialVersionUID</code>也会跟着变化！</p><p>所以，为了<code>serialVersionUID</code>的确定性，写代码时还是建议，凡是<code>implements Serializable</code>的类，都最好人为显式地为它声明一个<code>serialVersionUID</code>明确值！</p><p>当然，如果不想手动赋值，你也可以借助IDE的自动添加功能，比如我使用的<code>IntelliJ IDEA</code>，按<code>alt + enter</code>就可以为类自动生成和添加<code>serialVersionUID</code>字段，十分方便：</p><p><img src="https://i0.hdslb.com/bfs/article/545d565bf8750a2b4e9016d20eff2bd517d86d03.png@1320w_598h.webp" alt="img"></p><h1 id="两种特殊情况"><a href="#两种特殊情况" class="headerlink" title="两种特殊情况"></a>两种特殊情况</h1><ul><li>1、凡是被<code>static</code>修饰的字段是不会被序列化的</li><li>2、凡是被<code>transient</code>修饰符修饰的字段也是不会被序列化的</li></ul><p><strong>对于第一点</strong>，因为序列化保存的是<strong>对象的状态</strong>而非类的状态，所以会忽略<code>static</code>静态域也是理所应当的。</p><p><strong>对于第二点</strong>，就需要了解一下<code>transient</code>修饰符的作用了。</p><p>如果在序列化某个类的对象时，就是不希望某个字段被序列化（比如这个字段存放的是隐私值，如：<code>密码</code>等），那这时就可以用<code>transient</code>修饰符来修饰该字段。</p><p>比如在之前定义的<code>Student</code>类中，加入一个<strong>密码字段</strong>，但是不希望序列化到<code>txt</code>文本，则可以：</p><p><img src="https://i0.hdslb.com/bfs/article/b464d0e3351a67e1dcd1268fd74f3165c64c5c9d.png@1320w_506h.webp" alt="img"></p><p>这样在序列化<code>Student</code>类对象时，<code>password</code>字段会设置为默认值<code>null</code>，这一点可以从反序列化所得到的结果来看出：</p><p><img src="https://i0.hdslb.com/bfs/article/bd283be1015fb3950eb0e8531e3746a06d6ec46f.png@1320w_656h.webp" alt="img"></p><h1 id="序列化的受控和加强"><a href="#序列化的受控和加强" class="headerlink" title="序列化的受控和加强"></a>序列化的受控和加强</h1><h1 id="约束性加持"><a href="#约束性加持" class="headerlink" title="约束性加持"></a>约束性加持</h1><p>从上面的过程可以看出，序列化和反序列化的过程其实是<strong>有漏洞的</strong>，因为从序列化到反序列化是有中间过程的，如果被别人拿到了中间字节流，然后加以伪造或者篡改，那反序列化出来的对象就会有一定风险了。</p><p>毕竟反序列化也相当于一种 <strong>“隐式的”对象构造</strong> ，因此我们希望在反序列化时，进行<strong>受控的</strong>对象反序列化动作。</p><p>那怎么个受控法呢？</p><p><strong>答案就是：</strong> 自行编写<strong><code>readObject()</code></strong>函数，用于对象的反序列化构造，从而提供约束性。</p><p>既然自行编写<code>readObject()</code>函数，那就可以做很多可控的事情：比如各种判断工作。</p><p>还以上面的<code>Student</code>类为例，一般来说学生的成绩应该在<code>0 ~ 100</code>之间，我们为了防止学生的考试成绩在反序列化时被别人篡改成一个奇葩值，我们可以自行编写<code>readObject()</code>函数用于反序列化的控制：</p><p><img src="https://i0.hdslb.com/bfs/article/744163a802ca9fe8870326dad1ab5ad6afd29d3e.png@1320w_434h.webp" alt="img"></p><p>比如我故意将学生的分数改为<code>101</code>，此时反序列化立马终止并且报错：</p><p><img src="https://i0.hdslb.com/bfs/article/f007bea84a2982951796f2a3555db883619ccdb1.png@1320w_450h.webp" alt="img"></p><p>对于上面的代码，有些小伙伴可能会好奇，为什么自定义的<code>private</code>的<code>readObject()</code>方法可以被自动调用，这就需要你跟一下底层源码来一探究竟了，我帮你跟到了<code>ObjectStreamClass</code>类的最底层，看到这里我相信你一定恍然大悟：</p><p><img src="https://i0.hdslb.com/bfs/article/2efb8d5429692b79c6db1e27dd6d2c58b8f71991.png@1320w_808h.webp" alt="img"></p><p>又是反射机制在起作用！是的，在Java里，果然万物皆可“反射”（滑稽），即使是类中定义的<code>private</code>私有方法，也能被抠出来执行了，简直引起舒适了。</p><h1 id="单例模式增强"><a href="#单例模式增强" class="headerlink" title="单例模式增强"></a>单例模式增强</h1><p>一个容易被忽略的问题是：<strong>可序列化的单例类有可能并不单例</strong>！</p><p>举个代码小例子就清楚了。</p><p>比如这里我们先用<code>java</code>写一个常见的「静态内部类」方式的单例模式实现：</p><p><img src="https://i0.hdslb.com/bfs/article/eba81b8fc8ec4e5fe811efa6964aabf4b2d48c1e.png@1320w_836h.webp" alt="img"></p><p>然后写一个验证主函数：</p><p><img src="https://i0.hdslb.com/bfs/article/7a5dfa5e577ba091d25c7f5e9dc4c481ef0e9f33.png@1320w_1098h.webp" alt="img"></p><p>运行后我们发现：<strong>反序列化后的单例对象和原单例对象并不相等</strong>了，这无疑没有达到我们的目标。</p><p><strong>解决办法是</strong>：在单例类中手写<strong><code>readResolve()</code></strong>函数，直接返回单例对象，来规避之：</p><p><img src="https://i0.hdslb.com/bfs/article/e2328d25f92fa2d7bac4a2ef0b12c33a8e1f016d.png@1320w_360h.webp" alt="img"></p><p><img src="https://i0.hdslb.com/bfs/article/0e24263c094ddea1f3db44af4090011a8b6c8ea1.png@1320w_904h.webp" alt="img"></p><p>这样一来，当反序列化从流中读取对象时，<code>readResolve()</code>会被调用，用其中返回的对象替代反序列化新建的对象。</p>]]></content>
    
    <summary type="html">
    
      &lt;h1 id=&quot;序列化是干啥用的？&quot;&gt;&lt;a href=&quot;#序列化是干啥用的？&quot; class=&quot;headerlink&quot; title=&quot;序列化是干啥用的？&quot;&gt;&lt;/a&gt;序列化是干啥用的？&lt;/h1&gt;&lt;p&gt;序列化的原本意图是希望对一个Java对象作一下“变换”，变成字节序列，这样一来方便持久化存储到磁盘，避免程序运行结束后对象就从内存里消失，另外变换成字节序列也更便于网络运输和传播，所以概念上很好理解：&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;&lt;strong&gt;序列化&lt;/strong&gt;：把Java对象转换为字节序列。&lt;/li&gt;
&lt;li&gt;&lt;strong&gt;反序列化&lt;/strong&gt;：把字节序列恢复为原先的Java对象。&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;&lt;img src=&quot;https://i0.hdslb.com/bfs/article/8469626c4d45bea2ebf49679b5d814457d4fef85.png@1320w_608h.webp&quot; alt=&quot;img&quot;&gt;&lt;/p&gt;
&lt;p&gt;而且序列化机制从某种意义上来说也弥补了平台化的一些差异，毕竟转换后的字节流可以在其他平台上进行反序列化来恢复对象。&lt;/p&gt;
&lt;p&gt;事情就是那么个事情，看起来很简单，不过后面的东西还不少，请往下看。&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>剑指Offer题解（3-40）</title>
    <link href="https://zrbac.github.io/2020/08/27/%E5%89%91%E6%8C%87Offer%E9%A2%98%E8%A7%A3/"/>
    <id>https://zrbac.github.io/2020/08/27/%E5%89%91%E6%8C%87Offer%E9%A2%98%E8%A7%A3/</id>
    <published>2020-08-27T07:13:08.000Z</published>
    <updated>2020-08-29T07:37:32.179Z</updated>
    
    <content type="html"><![CDATA[<h2 id="剑指Offer题解（3-40）"><a href="#剑指Offer题解（3-40）" class="headerlink" title="剑指Offer题解（3-40）"></a>剑指Offer题解（3-40）</h2><h4 id="面试题03-数组中重复的数字"><a href="#面试题03-数组中重复的数字" class="headerlink" title="面试题03. 数组中重复的数字"></a><a href="https://leetcode-cn.com/problems/shu-zu-zhong-zhong-fu-de-shu-zi-lcof/" target="_blank" rel="noopener">面试题03. 数组中重复的数字</a></h4><p>找出数组中重复的数字。<br>在一个长度为 n 的数组 nums 里的所有数字都在 0～n-1 的范围内。数组中某些数字是重复的，但不知道有几个数字重复了，也不知道每个数字重复了几次。请找出数组中任意一个重复的数字。</p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入：</span><br><span class="line">[<span class="number">2</span>, <span class="number">3</span>, <span class="number">1</span>, <span class="number">0</span>, <span class="number">2</span>, <span class="number">5</span>, <span class="number">3</span>]</span><br><span class="line">输出：<span class="number">2</span> 或 <span class="number">3</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">findRepeateNumber</span><span class="params">(<span class="keyword">int</span>[] nums)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;nums.length; i++) &#123;<span class="comment">//如果当前值不是当前索引对应的值</span></span><br><span class="line">            <span class="keyword">while</span>(nums[i] != i) &#123;</span><br><span class="line">                <span class="keyword">int</span> cur = nums[i];</span><br><span class="line">                <span class="keyword">if</span>(nums[cur] = cur)<span class="comment">//当前值对应的索引是否已经存有了当前值，如果是说明重复</span></span><br><span class="line">                    <span class="keyword">return</span> cur;</span><br><span class="line">                <span class="keyword">else</span> &#123;<span class="comment">//如果不是，就将当前值放到自己对应的索引，将自己对应索引的值放过来</span></span><br><span class="line">                    nums[i] = nums[cur];</span><br><span class="line">                    nums[cur] = cur;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> <span class="number">0</span>;<span class="comment">//没找到，返回0（随便返回一个数即可）</span></span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><a id="more"></a><h4 id="面试题04-二维数组中的查找"><a href="#面试题04-二维数组中的查找" class="headerlink" title="面试题04. 二维数组中的查找"></a><a href="https://leetcode-cn.com/problems/er-wei-shu-zu-zhong-de-cha-zhao-lcof/" target="_blank" rel="noopener">面试题04. 二维数组中的查找</a></h4><p> 在一个 n * m 的二维数组中，每一行都按照从左到右递增的顺序排序，每一列都按照从上到下递增的顺序排序。请完成一个函数，输入这样的一个二维数组和一个整数，判断数组中是否含有该整数。 </p><p><strong>示例:</strong></p><p>现有矩阵 matrix 如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">[</span><br><span class="line">  [<span class="number">1</span>,   <span class="number">4</span>,  <span class="number">7</span>, <span class="number">11</span>, <span class="number">15</span>],</span><br><span class="line">  [<span class="number">2</span>,   <span class="number">5</span>,  <span class="number">8</span>, <span class="number">12</span>, <span class="number">19</span>],</span><br><span class="line">  [<span class="number">3</span>,   <span class="number">6</span>,  <span class="number">9</span>, <span class="number">16</span>, <span class="number">22</span>],</span><br><span class="line">  [<span class="number">10</span>, <span class="number">13</span>, <span class="number">14</span>, <span class="number">17</span>, <span class="number">24</span>],</span><br><span class="line">  [<span class="number">18</span>, <span class="number">21</span>, <span class="number">23</span>, <span class="number">26</span>, <span class="number">30</span>]</span><br><span class="line">]</span><br></pre></td></tr></table></figure><p> 给定 target = <code>5</code>，返回 <code>true</code>。 </p><p>给定 target = <code>20</code>，返回 <code>false</code>。</p><p><strong>思路和代码：</strong></p><p>我们分析该二维数组的特点，左到右递增，上到下递增，因此可以从右上角开始寻找。</p><p>如果比目标值大，就往左边找，如果比目标值小，就往下边找。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">findNumberIn2DArray</span><span class="params">(<span class="keyword">int</span>[] matrix, <span class="keyword">int</span> target)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(matrix.length==<span class="number">0</span>||matrix[<span class="number">0</span>].length==<span class="number">0</span>)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">int</span> row = <span class="number">0</span>;<span class="comment">//起始行为第一行</span></span><br><span class="line">        <span class="keyword">int</span> col = matrix[<span class="number">0</span>].length-<span class="number">1</span>; <span class="comment">//起始列为最后一列</span></span><br><span class="line">        <span class="keyword">while</span>(row &lt; matrix.length &amp;&amp; col &gt;= <span class="number">0</span>) &#123; <span class="comment">//边界条件</span></span><br><span class="line">            <span class="keyword">if</span>(matrix[row][col] &gt; target) </span><br><span class="line">                col--;</span><br><span class="line">            <span class="keyword">else</span> <span class="keyword">if</span>(matrix[row][col] &lt; target)</span><br><span class="line">                row++;</span><br><span class="line">            <span class="keyword">else</span></span><br><span class="line">                <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题05-替换空格"><a href="#面试题05-替换空格" class="headerlink" title="面试题05. 替换空格"></a><a href="https://leetcode-cn.com/problems/ti-huan-kong-ge-lcof/" target="_blank" rel="noopener">面试题05. 替换空格</a></h4><p> 请实现一个函数，把字符串 <code>s</code> 中的每个空格替换成”%20”。 </p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：s = <span class="string">"We are happy."</span></span><br><span class="line">输出：<span class="string">"We%20are%20happy."</span></span><br></pre></td></tr></table></figure><p><strong>思路和代码：</strong></p><p>这道题很简单没什么好说的，利用StringBuilder拼接字符串即可，如果遇到空格就替换。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> String <span class="title">replaceSpace</span><span class="params">(String s)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> n = s.length();</span><br><span class="line">        StringBuilder res = <span class="keyword">new</span> StringBuilder();</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;n; i++) &#123;</span><br><span class="line">            <span class="keyword">if</span>(s.charAt(i) == <span class="string">' '</span>)</span><br><span class="line">                res.append(<span class="string">"%20"</span>);</span><br><span class="line">            <span class="keyword">else</span></span><br><span class="line">                res.append(s.charAt(i));</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res.toString();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题06-从尾到头打印链表"><a href="#面试题06-从尾到头打印链表" class="headerlink" title="面试题06. 从尾到头打印链表"></a><a href="https://leetcode-cn.com/problems/cong-wei-dao-tou-da-yin-lian-biao-lcof/" target="_blank" rel="noopener">面试题06. 从尾到头打印链表</a></h4><p>输入一个链表的头节点，从尾到头反过来返回每个节点的值（用数组返回）。</p><p><strong>示例 1：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">`输入：head = [``<span class="number">1</span>``,``<span class="number">3</span>``,``<span class="number">2</span>``]``输出：[``<span class="number">2</span>``,``<span class="number">3</span>``,``<span class="number">1</span>``]`</span><br></pre></td></tr></table></figure><p><strong>思路和代码：</strong></p><p>方法一：利用LinkedList顺序保存链表，然后逆序保存到结果数组中返回即可。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] reversePrint(ListNode head) &#123;</span><br><span class="line">        LinkedList&lt;Integer&gt; stack = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">        <span class="keyword">while</span>(head != <span class="keyword">null</span>) &#123;</span><br><span class="line">            stack.addLast(head.val);</span><br><span class="line">            head = head.next;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[stack.size()];</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;res.length; i++) &#123;</span><br><span class="line">            res[i] = stack.removeLast();</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>方法二：递归至尾节点后逐步输出</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    ArrayList&lt;Integer&gt; tmp = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] reversePrint(ListNode head) &#123;</span><br><span class="line">        reverse(head);</span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[tmp.size()];</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;tmp.size(); i++) &#123;</span><br><span class="line">            res[i] = tmp.get(i);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="function"><span class="keyword">void</span> <span class="title">reverse</span><span class="params">(ListNode head)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(head == <span class="keyword">null</span>) <span class="keyword">return</span>;</span><br><span class="line">        reverse(head.next);</span><br><span class="line">        tmp.add(head.val);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题07-重建二叉树"><a href="#面试题07-重建二叉树" class="headerlink" title="面试题07. 重建二叉树"></a><a href="https://leetcode-cn.com/problems/zhong-jian-er-cha-shu-lcof/" target="_blank" rel="noopener">面试题07. 重建二叉树</a></h4><p>输入某二叉树的前序遍历和中序遍历的结果，请重建该二叉树。假设输入的前序遍历和中序遍历的结果中都不含重复的数字。</p><p>例如，给出</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">`前序遍历 preorder = [``<span class="number">3</span>``,``<span class="number">9</span>``,``<span class="number">20</span>``,``<span class="number">15</span>``,``<span class="number">7</span>``]``中序遍历 inorder = [``<span class="number">9</span>``,``<span class="number">3</span>``,``<span class="number">15</span>``,``<span class="number">20</span>``,``<span class="number">7</span>``]`</span><br></pre></td></tr></table></figure><p>返回如下的二叉树：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">  <span class="number">3</span></span><br><span class="line"> / \</span><br><span class="line"><span class="number">9</span>  <span class="number">20</span></span><br><span class="line">  /  \</span><br><span class="line"> <span class="number">15</span>   <span class="number">7</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="comment">//key是中序遍历的值，value是中序遍历的结果</span></span><br><span class="line">    HashMap&lt;Integer,Integer&gt; indexMap=<span class="keyword">new</span> HashMap&lt;&gt;();</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> TreeNode <span class="title">buildTree</span><span class="params">(<span class="keyword">int</span>[] preorder, <span class="keyword">int</span>[] inorder)</span> </span>&#123;</span><br><span class="line">        <span class="comment">//保存中序遍历的信息</span></span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>;i&lt;inorder.length;i++)&#123;</span><br><span class="line">            indexMap.put(inorder[i],i);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> createTree(preorder,<span class="number">0</span>,inorder,<span class="number">0</span>,inorder.length-<span class="number">1</span>);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">//preIndex是前序遍历的索引，inStart和inEnd是中序遍历的索引范围</span></span><br><span class="line">    <span class="function"><span class="keyword">private</span> TreeNode <span class="title">createTree</span><span class="params">(<span class="keyword">int</span>[] preorder,<span class="keyword">int</span> preIndex,<span class="keyword">int</span>[] inorder,<span class="keyword">int</span> inStart,<span class="keyword">int</span> inEnd)</span></span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(inStart&gt;inEnd)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">null</span>;</span><br><span class="line">        <span class="comment">//获取前序遍历的值</span></span><br><span class="line">        <span class="keyword">int</span> val=preorder[preIndex];</span><br><span class="line">        <span class="comment">//获取前序遍历值在中序遍历的位置</span></span><br><span class="line">        <span class="keyword">int</span> inIndex=indexMap.get(val);</span><br><span class="line">        <span class="comment">//以该值作为根节点的值创建根节点</span></span><br><span class="line">        TreeNode root=<span class="keyword">new</span> TreeNode(val);</span><br><span class="line">        <span class="comment">//根节点的左子树节点数目</span></span><br><span class="line">        <span class="keyword">int</span> leftNum=inIndex-inStart;</span><br><span class="line">        <span class="comment">//根节点以左创建左子树，根节点以右创建右子树</span></span><br><span class="line">        root.left=createTree(preorder,preIndex+<span class="number">1</span>,inorder,inStart,inIndex-<span class="number">1</span>);</span><br><span class="line">        root.right=createTree(preorder,preIndex+<span class="number">1</span>+leftNum,inorder,inIndex+<span class="number">1</span>,inEnd);</span><br><span class="line">        <span class="keyword">return</span> root;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题09-用两个栈实现队列"><a href="#面试题09-用两个栈实现队列" class="headerlink" title="面试题09. 用两个栈实现队列"></a><a href="https://leetcode-cn.com/problems/yong-liang-ge-zhan-shi-xian-dui-lie-lcof/" target="_blank" rel="noopener">面试题09. 用两个栈实现队列</a></h4><p>用两个栈实现一个队列。队列的声明如下，请实现它的两个函数 <code>appendTail</code> 和 <code>deleteHead</code> ，分别完成在队列尾部插入整数和在队列头部删除整数的功能。(若队列中没有元素，<code>deleteHead</code> 操作返回 -1 )</p><p><strong>示例 1：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">输入：</span><br><span class="line">[<span class="string">"CQueue"</span>,<span class="string">"appendTail"</span>,<span class="string">"deleteHead"</span>,<span class="string">"deleteHead"</span>]</span><br><span class="line">[[],[<span class="number">3</span>],[],[]]</span><br><span class="line">输出：[<span class="keyword">null</span>,<span class="keyword">null</span>,<span class="number">3</span>,-<span class="number">1</span>]</span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">输入：</span><br><span class="line">[<span class="string">"CQueue"</span>,<span class="string">"deleteHead"</span>,<span class="string">"appendTail"</span>,<span class="string">"appendTail"</span>,<span class="string">"deleteHead"</span>,<span class="string">"deleteHead"</span>]</span><br><span class="line">[[],[],[<span class="number">5</span>],[<span class="number">2</span>],[],[]]</span><br><span class="line">输出：[<span class="keyword">null</span>,-<span class="number">1</span>,<span class="keyword">null</span>,<span class="keyword">null</span>,<span class="number">5</span>,<span class="number">2</span>]</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">CQueue</span> </span>&#123;</span><br><span class="line">    <span class="comment">//不推荐使用Stack的方式来做这道题，会造成速度较慢； 原因的话是Stack继承了Vector接口，而Vector底层是一个Object[]数组（官方已不推荐使用Stack），那么就要考虑空间扩容和移位的问题了。 可以使用LinkedList来做Stack的容器，因为LinkedList实现了Deque接口，所以Stack能做的事LinkedList都能做，其本身结构是个双向链表，扩容消耗少。</span></span><br><span class="line">    LinkedList&lt;Integer&gt; A,B;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">CQueue</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        A = <span class="keyword">new</span> LinkedList&lt;Integer&gt;();</span><br><span class="line">        B = <span class="keyword">new</span> LinkedList&lt;Integer&gt;();</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">appendTail</span><span class="params">(<span class="keyword">int</span> value)</span> </span>&#123;</span><br><span class="line">        A.addLast(value);</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">deleteHead</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(!B.isEmpty()) <span class="keyword">return</span> B.removeFirst();</span><br><span class="line">        <span class="keyword">if</span>(A.isEmpty()) <span class="keyword">return</span> -<span class="number">1</span>;</span><br><span class="line">        <span class="keyword">while</span>(!A.isEmpty()) &#123;</span><br><span class="line">            B.addLast(A.removeFirst());</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> B.removeFirst();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题10-I-斐波那契数列"><a href="#面试题10-I-斐波那契数列" class="headerlink" title="面试题10- I. 斐波那契数列"></a><a href="https://leetcode-cn.com/problems/fei-bo-na-qi-shu-lie-lcof/" target="_blank" rel="noopener">面试题10- I. 斐波那契数列</a></h4><p>写一个函数，输入 <code>n</code> ，求斐波那契（Fibonacci）数列的第 <code>n</code> 项。斐波那契数列的定义如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">F(<span class="number">0</span>) = <span class="number">0</span>,   F(<span class="number">1</span>) = <span class="number">1</span></span><br><span class="line">F(N) = F(N - <span class="number">1</span>) + F(N - <span class="number">2</span>), 其中 N &gt; <span class="number">1</span>.</span><br></pre></td></tr></table></figure><p>斐波那契数列由 0 和 1 开始，之后的斐波那契数就是由之前的两数相加而得出。</p><p>答案需要取模 1e9+7（1000000007），如计算初始结果为：1000000008，请返回 1。</p><p><strong>示例 1：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">`输入：n = ``<span class="number">2</span>``输出：``<span class="number">1</span>`</span><br></pre></td></tr></table></figure><p><strong>示例 2：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：n = <span class="number">5</span></span><br><span class="line">输出：<span class="number">5</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>简单的动态规划</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">numWays</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> a = <span class="number">1</span>, b = <span class="number">1</span>, sum;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; n; i++)&#123;</span><br><span class="line">            sum = (a + b) % <span class="number">1000000007</span>;</span><br><span class="line">            a = b;</span><br><span class="line">            b = sum;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> a;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题10-II-青蛙跳台阶问题"><a href="#面试题10-II-青蛙跳台阶问题" class="headerlink" title="面试题10- II. 青蛙跳台阶问题"></a><a href="https://leetcode-cn.com/problems/qing-wa-tiao-tai-jie-wen-ti-lcof/" target="_blank" rel="noopener">面试题10- II. 青蛙跳台阶问题</a></h4><p>一只青蛙一次可以跳上1级台阶，也可以跳上2级台阶。求该青蛙跳上一个 <code>n</code> 级的台阶总共有多少种跳法。</p><p> 答案需要取模 1e9+7（1000000007），如计算初始结果为：1000000008，请返回 1。 </p><p><strong>示例 1：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">`输入：n = ``<span class="number">2</span>``输出：``<span class="number">2</span>`</span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：n = <span class="number">7</span></span><br><span class="line">输出：<span class="number">21</span></span><br></pre></td></tr></table></figure><p><strong>提示：</strong></p><ul><li><code>0 &lt;= n &lt;= 100</code></li></ul><p><strong>思路和代码：</strong></p><p>简单的动态规划，跳到0或1级有1种方法，之后跳到i的方法数量=跳到i-1的方法数量+跳到i-2的方法数量（因为每次可以跳1或2级）。</p><p>由于每次结果要取模所以要mod1000000007。</p><p>方法一、空间复杂度O(n)</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">numWays</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(n &lt; <span class="number">2</span>) <span class="keyword">return</span> <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">int</span>[] dp = <span class="keyword">new</span> <span class="keyword">int</span>[n+<span class="number">1</span>];</span><br><span class="line">        dp[<span class="number">0</span>] = <span class="number">1</span>; </span><br><span class="line">        dp[<span class="number">1</span>] = <span class="number">1</span>; </span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = <span class="number">2</span>; i &lt;= n; i++)&#123;</span><br><span class="line">            dp[i] = (dp[i-<span class="number">1</span>]+dp[i-<span class="number">2</span>]) % <span class="number">1000000007</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> dp[n];</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>方法二、优化为O(1)空间复杂度</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">numWays</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> a = <span class="number">1</span>, b = <span class="number">1</span>, sum;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; n; i++)&#123;</span><br><span class="line">            sum = (a + b) % <span class="number">1000000007</span>;</span><br><span class="line">            a = b;</span><br><span class="line">            b = sum;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> a;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题11-旋转数组的最小数字"><a href="#面试题11-旋转数组的最小数字" class="headerlink" title="面试题11. 旋转数组的最小数字"></a><a href="https://leetcode-cn.com/problems/xuan-zhuan-shu-zu-de-zui-xiao-shu-zi-lcof/" target="_blank" rel="noopener">面试题11. 旋转数组的最小数字</a></h4><p>把一个数组最开始的若干个元素搬到数组的末尾，我们称之为数组的旋转。输入一个递增排序的数组的一 个旋转，输出旋转数组的最小元素。例如，数组 <code>[3,4,5,1,2]</code> 为 <code>[1,2,3,4,5]</code> 的一个旋转，该数组的最小值为1。 </p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：[<span class="number">3</span>,<span class="number">4</span>,<span class="number">5</span>,<span class="number">1</span>,<span class="number">2</span>]</span><br><span class="line">输出：<span class="number">1</span></span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：[<span class="number">2</span>,<span class="number">2</span>,<span class="number">2</span>,<span class="number">0</span>,<span class="number">1</span>]</span><br><span class="line">输出：<span class="number">0</span></span><br></pre></td></tr></table></figure><p><strong>思路和代码：</strong></p><p>方法一、从头遍历，如果一个数字大于它的下一个，就返回它的下一个。</p><p>例如示例1，5&gt;1，返回1，示例2，2&gt;0，返回0。</p><p>如果没找到就返回第一个，例如12345返回1。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">minArray</span><span class="params">(<span class="keyword">int</span>[] numbers)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>;i&lt;numbers.length-<span class="number">1</span>;i++)&#123;</span><br><span class="line">            <span class="keyword">if</span>(numbers[i]&gt;numbers[i+<span class="number">1</span>])</span><br><span class="line">                <span class="keyword">return</span> numbers[i+<span class="number">1</span>];</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> numbers[<span class="number">0</span>];</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>方法二、优化为二分查找</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">minArray</span><span class="params">(<span class="keyword">int</span>[] numbers)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> start = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">int</span> end = numbers.length - <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">while</span>(start != end)&#123;</span><br><span class="line">            <span class="keyword">int</span> mid = start + (end - start) / <span class="number">2</span>;</span><br><span class="line">            <span class="keyword">if</span>(numbers[mid] &gt; numbers[end]) start = mid + <span class="number">1</span>;</span><br><span class="line">            <span class="keyword">else</span> <span class="keyword">if</span>(numbers[mid] &lt; numbers[end]) end = mid;</span><br><span class="line">            <span class="keyword">else</span> <span class="keyword">return</span> findMin(numbers,start,end);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> numbers[start];</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">findMin</span><span class="params">(<span class="keyword">int</span>[] numbers,<span class="keyword">int</span> start,<span class="keyword">int</span> end)</span></span>&#123;</span><br><span class="line">        <span class="keyword">int</span> result = numbers[start];</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = start;i &lt;= end;i++)&#123;</span><br><span class="line">            <span class="keyword">if</span> (numbers[i] &lt; result) result = numbers[i];</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> result;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题12-矩阵中的路径"><a href="#面试题12-矩阵中的路径" class="headerlink" title="面试题12. 矩阵中的路径"></a><a href="https://leetcode-cn.com/problems/ju-zhen-zhong-de-lu-jing-lcof/" target="_blank" rel="noopener">面试题12. 矩阵中的路径</a></h4><p>请设计一个函数，用来判断在一个矩阵中是否存在一条包含某字符串所有字符的路径。路径可以从矩阵中的任意一格开始，每一步可以在矩阵中向左、右、上、下移动一格。如果一条路径经过了矩阵的某一格，那么该路径不能再次进入该格子。例如，在下面的3×4的矩阵中包含一条字符串“bfce”的路径（路径中的字母用加粗标出）。 </p><p> [[“a”,”<strong>b</strong>“,”c”,”e”],<br>[“s”,”<strong>f</strong>“,”<strong>c</strong>“,”s”],<br>[“a”,”d”,”<strong>e</strong>“,”e”]] </p><p> 但矩阵中不包含字符串“abfb”的路径，因为字符串的第一个字符b占据了矩阵中的第一行第二个格子之后，路径不能再次进入这个格子。 </p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：board = [[<span class="string">"A"</span>,<span class="string">"B"</span>,<span class="string">"C"</span>,<span class="string">"E"</span>],[<span class="string">"S"</span>,<span class="string">"F"</span>,<span class="string">"C"</span>,<span class="string">"S"</span>],[<span class="string">"A"</span>,<span class="string">"D"</span>,<span class="string">"E"</span>,<span class="string">"E"</span>]], word = <span class="string">"ABCCED"</span></span><br><span class="line">输出：<span class="keyword">true</span></span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：board = [[<span class="string">"a"</span>,<span class="string">"b"</span>],[<span class="string">"c"</span>,<span class="string">"d"</span>]], word = <span class="string">"abcd"</span></span><br><span class="line">输出：<span class="keyword">false</span></span><br></pre></td></tr></table></figure><p><strong>思路和代码：</strong></p><p>使用深度优先搜索回溯，从全部字符以头开始遍历，如果寻找到了就直接返回true，否则继续以下一个字符为头重新开始。</p><p>k代表已经成功匹配的字符数量，初始为0，每匹配一个加1，当达到目标长度时返回true。</p><p>每次进行下一层搜索时将当前字符设为一个非字母值，这样可以防止重复遍历。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">exist</span><span class="params">(<span class="keyword">char</span>[][] board, String word)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">char</span>[] words=word.toCharArray();</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>;i&lt;board.length;i++)&#123;</span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> j=<span class="number">0</span>;j&lt;board[<span class="number">0</span>].length;j++)&#123;</span><br><span class="line">                <span class="keyword">if</span>(dfs(board,words,i,j,<span class="number">0</span>))</span><br><span class="line">                    <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">boolean</span> <span class="title">dfs</span><span class="params">(<span class="keyword">char</span>[][] board,<span class="keyword">char</span>[] words,<span class="keyword">int</span> i,<span class="keyword">int</span> j,<span class="keyword">int</span> k)</span></span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(i&lt;<span class="number">0</span>||j&lt;<span class="number">0</span>||i==board.length||j==board[<span class="number">0</span>].length)<span class="comment">//边界判断防止越界</span></span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">if</span>(board[i][j]!=words[k])<span class="comment">//如果遍历字符和目标字符不符，返回false</span></span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="comment">//如果全部匹配成功，k已达到目标数组长度，返回true</span></span><br><span class="line">        <span class="keyword">if</span>(k==words.length-<span class="number">1</span>)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        <span class="keyword">char</span> temp=board[i][j];<span class="comment">//保存当前字符</span></span><br><span class="line">        board[i][j]=<span class="string">'/'</span>;<span class="comment">//当前字符遍历后，防止在dfs中重复遍历，设为任意非字母字符</span></span><br><span class="line">        <span class="comment">//保存当前结果</span></span><br><span class="line">        <span class="keyword">boolean</span> res=dfs(board,words,i+<span class="number">1</span>,j,k+<span class="number">1</span>)</span><br><span class="line">            ||dfs(board,words,i-<span class="number">1</span>,j,k+<span class="number">1</span>)</span><br><span class="line">            ||dfs(board,words,i,j+<span class="number">1</span>,k+<span class="number">1</span>)</span><br><span class="line">            ||dfs(board,words,i,j-<span class="number">1</span>,k+<span class="number">1</span>);</span><br><span class="line">        board[i][j]=temp;<span class="comment">//还原字符，下次遍历正常</span></span><br><span class="line">        <span class="comment">//还原字符后返回结果</span></span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题13-机器人的运动范围"><a href="#面试题13-机器人的运动范围" class="headerlink" title="面试题13. 机器人的运动范围"></a><a href="https://leetcode-cn.com/problems/ji-qi-ren-de-yun-dong-fan-wei-lcof/" target="_blank" rel="noopener">面试题13. 机器人的运动范围</a></h4><p>地上有一个m行n列的方格，从坐标 <code>[0,0]</code> 到坐标 <code>[m-1,n-1]</code> 。一个机器人从坐标 <code>[0, 0]</code>的格子开始移动，它每次可以向左、右、上、下移动一格（不能移动到方格外），也不能进入行坐标和列坐标的数位之和大于k的格子。例如，当k为18时，机器人能够进入方格 [35, 37] ，因为3+5+3+7=18。但它不能进入方格 [35, 38]，因为3+5+3+8=19。请问该机器人能够到达多少个格子？ </p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：m = <span class="number">2</span>, n = <span class="number">3</span>, k = <span class="number">1</span></span><br><span class="line">输出：<span class="number">3</span></span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：m = <span class="number">3</span>, n = <span class="number">1</span>, k = <span class="number">0</span></span><br><span class="line">输出：<span class="number">1</span></span><br></pre></td></tr></table></figure><p><strong>提示：</strong></p><ul><li><code>1 &lt;= n,m &lt;= 100</code></li><li><code>0 &lt;= k &lt;= 20</code></li></ul><p><strong>思路和代码：</strong></p><p>由于最多100行，100列，因此索引从0~99。用/和%计算各位的数字之和，例如35和37，35/10+35%10+37/10+37%10=18。</p><p>一、DFS</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">boolean</span>[][] visited;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">movingCount</span><span class="params">(<span class="keyword">int</span> m, <span class="keyword">int</span> n, <span class="keyword">int</span> k)</span> </span>&#123;</span><br><span class="line">        visited = <span class="keyword">new</span> <span class="keyword">boolean</span>[m][n];</span><br><span class="line">        <span class="keyword">return</span> dfs(<span class="number">0</span>,<span class="number">0</span>,m,n,k);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">int</span> <span class="title">dfs</span><span class="params">(<span class="keyword">int</span> i, <span class="keyword">int</span> j, <span class="keyword">int</span> m, <span class="keyword">int</span> n, <span class="keyword">int</span> k)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(i&gt;=m || j&gt;=n || visited[i][j] || (i%<span class="number">10</span> + i/<span class="number">10</span> + j%<span class="number">10</span> + j/<span class="number">10</span>)&gt;k)</span><br><span class="line">            <span class="keyword">return</span> <span class="number">0</span>;</span><br><span class="line">        visited[i][j] = <span class="keyword">true</span>;</span><br><span class="line">        <span class="keyword">return</span> dfs(i+<span class="number">1</span>, j, m, n, k) + dfs(i, j+<span class="number">1</span>, m, n, k) + <span class="number">1</span>;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>二、BFS</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">movingCount</span><span class="params">(<span class="keyword">int</span> m, <span class="keyword">int</span> n, <span class="keyword">int</span> k)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">boolean</span>[][] visited = <span class="keyword">new</span> <span class="keyword">boolean</span>[m][n];</span><br><span class="line">    <span class="keyword">int</span> res = <span class="number">0</span>;</span><br><span class="line">    <span class="comment">//创建一个队列，保存的是访问到的格子坐标，是个二维数组</span></span><br><span class="line">    Queue&lt;<span class="keyword">int</span>[]&gt; queue = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">    <span class="comment">//从左上角坐标[0,0]点开始访问，add方法表示把坐标点加入到队列的队尾</span></span><br><span class="line">    queue.add(<span class="keyword">new</span> <span class="keyword">int</span>[]&#123;<span class="number">0</span>, <span class="number">0</span>&#125;);</span><br><span class="line">    <span class="keyword">while</span> (queue.size() &gt; <span class="number">0</span>) &#123;</span><br><span class="line">        <span class="keyword">int</span>[] x = queue.poll();</span><br><span class="line">        <span class="keyword">int</span> i = x[<span class="number">0</span>], j = x[<span class="number">1</span>];</span><br><span class="line">        <span class="keyword">if</span> (i &gt;= m || j &gt;= n || (i%<span class="number">10</span> + i/<span class="number">10</span> + j%<span class="number">10</span> + j/<span class="number">10</span>)&gt;k|| visited[i][j])</span><br><span class="line">            <span class="keyword">continue</span>;</span><br><span class="line">        visited[i][j] = <span class="keyword">true</span>;</span><br><span class="line">        res++;</span><br><span class="line">        <span class="comment">//把当前格子右边格子的坐标加入到队列中</span></span><br><span class="line">        queue.add(<span class="keyword">new</span> <span class="keyword">int</span>[]&#123;i + <span class="number">1</span>, j&#125;);</span><br><span class="line">        <span class="comment">//把当前格子下边格子的坐标加入到队列中</span></span><br><span class="line">        queue.add(<span class="keyword">new</span> <span class="keyword">int</span>[]&#123;i, j + <span class="number">1</span>&#125;);</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> res;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题14-I-剪绳子"><a href="#面试题14-I-剪绳子" class="headerlink" title="面试题14- I. 剪绳子"></a><a href="https://leetcode-cn.com/problems/jian-sheng-zi-lcof/" target="_blank" rel="noopener">面试题14- I. 剪绳子</a></h4><p> 给你一根长度为 <code>n</code> 的绳子 ，请把绳子剪成整数长度的 <code>m</code> 段（m、n都是整数，n&gt;1并且m&gt;1），每段绳子的长度记为 <code>k[0],k[1]...k[m]</code> 。请问 <code>k[0]*k[1]*...*k[m]</code> 可能的最大乘积是多少？例如，当绳子的长度是8时，我们把它剪成长度分别为2、3、3的三段，此时得到的最大乘积是18。 </p><p> <strong>示例 1：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入: <span class="number">2</span></span><br><span class="line">输出: <span class="number">1</span></span><br><span class="line">解释: <span class="number">2</span> = <span class="number">1</span> + <span class="number">1</span>, <span class="number">1</span> × <span class="number">1</span> = <span class="number">1</span></span><br></pre></td></tr></table></figure><p> <strong>示例 2:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入: <span class="number">10</span></span><br><span class="line">输出: <span class="number">36</span></span><br><span class="line">解释: <span class="number">10</span> = <span class="number">3</span> + <span class="number">3</span> + <span class="number">4</span>, <span class="number">3</span> × <span class="number">3</span> × <span class="number">4</span> = <span class="number">36</span></span><br></pre></td></tr></table></figure><p><strong>提示：</strong></p><ul><li><code>2 &lt;= n &lt;= 58</code></li></ul><p><strong>思路和代码：</strong></p><p> <strong>推论一：</strong> 将绳子 <strong>以相等的长度等分为多段</strong> ，得到的乘积最大。 </p><p> <strong>推论二：</strong> 尽可能将绳子以长度 3 等分为多段时，乘积最大。 </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">cuttingRope</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(n &lt; <span class="number">4</span>) <span class="keyword">return</span> n - <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">int</span> cnt = <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">while</span>(n &gt; <span class="number">4</span>) &#123;</span><br><span class="line">            cnt *= <span class="number">3</span>;</span><br><span class="line">            n -= <span class="number">3</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> n*cnt;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>或者分三种情况直接求积</p><p>切分规则：<br>最优： 3 。把绳子尽可能切为多个长度为 3 的片段，留下的最后一段绳子的长度可能为 0,1,2三种情况。<br>次优： 2 。若最后一段绳子长度为 2 ；则保留，不再拆为 1+1 。<br>最差： 1 。若最后一段绳子长度为 1 ；则应把一份 3+1 替换为 2+2，因为 2×2 &gt; 3×1。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">cuttingRope</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(n &lt;= <span class="number">3</span>) <span class="keyword">return</span> n - <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">int</span> a = n/<span class="number">3</span>, b = n%<span class="number">3</span>;</span><br><span class="line">        <span class="keyword">if</span>(b == <span class="number">0</span>) <span class="comment">//情况1，是3的倍数</span></span><br><span class="line">            <span class="keyword">return</span> (<span class="keyword">int</span>)Math.pow(<span class="number">3</span>, a);</span><br><span class="line">        <span class="keyword">if</span>(b == <span class="number">1</span>) <span class="comment">//情况2，余1，拆出一个4</span></span><br><span class="line">            <span class="keyword">return</span> (<span class="keyword">int</span>)Math.pow(<span class="number">3</span>, a - <span class="number">1</span>) * <span class="number">4</span>;</span><br><span class="line">        <span class="keyword">return</span> (<span class="keyword">int</span>)Math.pow(<span class="number">3</span>, a) * <span class="number">2</span>;<span class="comment">//情况3，余2，拆出一个2</span></span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题14-II-剪绳子-II"><a href="#面试题14-II-剪绳子-II" class="headerlink" title="面试题14- II. 剪绳子 II"></a><a href="https://leetcode-cn.com/problems/jian-sheng-zi-ii-lcof/" target="_blank" rel="noopener">面试题14- II. 剪绳子 II</a></h4><p> 给你一根长度为 <code>n</code> 的绳子 ，请把绳子剪成整数长度的 <code>m</code> 段（m、n都是整数，n&gt;1并且m&gt;1），每段绳子的长度记为 <code>k[0],k[1]...k[m]</code> 。请问 <code>k[0]*k[1]*...*k[m]</code> 可能的最大乘积是多少？例如，当绳子的长度是8时，我们把它剪成长度分别为2、3、3的三段，此时得到的最大乘积是18。 </p><p> 答案需要取模 1e9+7（1000000007），如计算初始结果为：1000000008，请返回 1。 </p><p> <strong>思路和代码：</strong> </p><p>同上一题，取个模就行</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">cuttingRope</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">long</span> res = <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">if</span>(n &lt; <span class="number">4</span>)</span><br><span class="line">            <span class="keyword">return</span> n-<span class="number">1</span>;</span><br><span class="line">        <span class="keyword">while</span>(n &gt; <span class="number">4</span>) &#123;</span><br><span class="line">            res *= <span class="number">3</span>;</span><br><span class="line">            res %= <span class="number">1000000007</span>;</span><br><span class="line">            n -= <span class="number">3</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> (<span class="keyword">int</span>) (n*res%<span class="number">1000000007</span>);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题15-二进制中1的个数"><a href="#面试题15-二进制中1的个数" class="headerlink" title="面试题15. 二进制中1的个数"></a><a href="https://leetcode-cn.com/problems/er-jin-zhi-zhong-1de-ge-shu-lcof/" target="_blank" rel="noopener">面试题15. 二进制中1的个数</a></h4><p> 请实现一个函数，输入一个整数，输出该数二进制表示中 1 的个数。例如，把 9 表示成二进制是 1001，有 2 位是 1。因此，如果输入 9，则该函数输出 2。 </p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入：<span class="number">00000000000000000000000000001011</span></span><br><span class="line">输出：<span class="number">3</span></span><br><span class="line">解释：输入的二进制串 <span class="number">00000000000000000000000000001011</span> 有三位为 <span class="string">'1'</span>。</span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入：<span class="number">00000000000000000000000010000000</span></span><br><span class="line">输出：<span class="number">1</span></span><br><span class="line">解释：输入的二进制串 <span class="number">00000000000000000000000010000000</span> 有一位为 <span class="string">'1'</span>。</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>方法一、根据与运算特点，使n与1逐位比较，判断n最右一位是否为1，根据结果计数</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="comment">// &gt;&gt;&gt;为无符号数右移</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">hammingWeight</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> res = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">while</span> (n != <span class="number">0</span>) &#123;</span><br><span class="line">            res += n &amp; <span class="number">1</span>;</span><br><span class="line">            n &gt;&gt;&gt;= <span class="number">1</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>方法二、利用n&amp;(n-1)</p><ul><li>(n−1) ： 二进制数字 n 最右边的 1 变成 0 ，此 1 右边的 0 都变成 1 。</li><li>n&amp;(n−1) ： 二进制数字 n 最右边的 1 变成 0 ，其余不变。</li></ul><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">hammingWeight</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> res = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">while</span>(n != <span class="number">0</span>) &#123;</span><br><span class="line">            res++;</span><br><span class="line">            n &amp;= n - <span class="number">1</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题16-数值的整数次方"><a href="#面试题16-数值的整数次方" class="headerlink" title="面试题16. 数值的整数次方"></a><a href="https://leetcode-cn.com/problems/shu-zhi-de-zheng-shu-ci-fang-lcof/" target="_blank" rel="noopener">面试题16. 数值的整数次方</a></h4><p> 实现函数double Power(double base, int exponent)，求base的exponent次方。不得使用库函数，同时不需要考虑大数问题。 </p><p> <strong>示例 1:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入: <span class="number">2.00000</span>, <span class="number">10</span></span><br><span class="line">输出: <span class="number">1024.00000</span></span><br></pre></td></tr></table></figure><p> <strong>示例 2:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入: <span class="number">2.10000</span>, <span class="number">3</span></span><br><span class="line">输出: <span class="number">9.26100</span></span><br></pre></td></tr></table></figure><p> <strong>示例 3:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入: <span class="number">2.00000</span>, -<span class="number">2</span></span><br><span class="line">输出: <span class="number">0.25000</span></span><br><span class="line">解释: <span class="number">2</span>-<span class="number">2</span> = <span class="number">1</span>/<span class="number">22</span> = <span class="number">1</span>/<span class="number">4</span> = <span class="number">0.25</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>快速幂法，注意区分奇偶即可</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">double</span> <span class="title">myPow</span><span class="params">(<span class="keyword">double</span> x, <span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">double</span> res = <span class="number">1.0</span>;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=n; i!=<span class="number">0</span>; i/=<span class="number">2</span>) &#123;</span><br><span class="line">            <span class="keyword">if</span>(i%<span class="number">2</span> != <span class="number">0</span>)</span><br><span class="line">                res *= x;</span><br><span class="line">            x *= x;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> n &gt; <span class="number">0</span> ? res : <span class="number">1</span>/res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题17-打印从1到最大的n位数"><a href="#面试题17-打印从1到最大的n位数" class="headerlink" title="面试题17. 打印从1到最大的n位数"></a><a href="https://leetcode-cn.com/problems/da-yin-cong-1dao-zui-da-de-nwei-shu-lcof/" target="_blank" rel="noopener">面试题17. 打印从1到最大的n位数</a></h4><p>输入数字 <code>n</code>，按顺序打印出从 1 到最大的 n 位十进制数。比如输入 3，则打印出 1、2、3 一直到最大的 3 位数 999。</p><p><strong>示例 1:</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入: n = <span class="number">1</span></span><br><span class="line">输出: [<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>,<span class="number">5</span>,<span class="number">6</span>,<span class="number">7</span>,<span class="number">8</span>,<span class="number">9</span>]</span><br></pre></td></tr></table></figure><p>说明：</p><ul><li><p>用返回一个整数列表来代替打印</p></li><li><p>n 为正整数</p><p><strong>思路和代码：</strong> </p></li></ul><p>本意是考察大数问题，不考虑大数解法：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] printNumbers(<span class="keyword">int</span> n) &#123;</span><br><span class="line">        <span class="keyword">int</span> end = (<span class="keyword">int</span>)Math.pow(<span class="number">10</span>, n) - <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[end];</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; end; i++)</span><br><span class="line">            res[i] = i + <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>大数问题解法：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">printNumbers</span><span class="params">(<span class="keyword">int</span> n)</span> </span>&#123;</span><br><span class="line">        StringBuilder str = <span class="keyword">new</span> StringBuilder();</span><br><span class="line">        <span class="comment">// 将str初始化为n个'0'字符组成的字符串</span></span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; n; i++) &#123;</span><br><span class="line">            str.append(<span class="string">'0'</span>);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">while</span>(!increment(str))&#123;</span><br><span class="line">            <span class="comment">// 去掉左侧的0</span></span><br><span class="line">            <span class="keyword">int</span> index = <span class="number">0</span>;</span><br><span class="line">            <span class="keyword">while</span> (index &lt; str.length() &amp;&amp; str.charAt(index) == <span class="string">'0'</span>)&#123;</span><br><span class="line">                index++;</span><br><span class="line">            &#125;</span><br><span class="line">            System.out.println(str.toString().substring(index));</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">increment</span><span class="params">(StringBuilder str)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">boolean</span> isOverflow = <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = str.length() - <span class="number">1</span>; i &gt;= <span class="number">0</span>; i--) &#123;</span><br><span class="line">            <span class="keyword">char</span> s = (<span class="keyword">char</span>)(str.charAt(i) + <span class="number">1</span>);</span><br><span class="line">            <span class="comment">// 如果s大于'9'则发生进位</span></span><br><span class="line">            <span class="keyword">if</span> (s &gt; <span class="string">'9'</span>) &#123;</span><br><span class="line">                str.replace(i, i + <span class="number">1</span>, <span class="string">"0"</span>);</span><br><span class="line">                <span class="keyword">if</span> (i == <span class="number">0</span>) &#123;</span><br><span class="line">                    isOverflow = <span class="keyword">true</span>;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="comment">// 没发生进位则跳出for循环</span></span><br><span class="line">            <span class="keyword">else</span> &#123;</span><br><span class="line">                str.replace(i, i + <span class="number">1</span>, String.valueOf(s));</span><br><span class="line">                <span class="keyword">break</span>;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> isOverflow;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题18-删除链表的节点"><a href="#面试题18-删除链表的节点" class="headerlink" title="面试题18. 删除链表的节点"></a><a href="https://leetcode-cn.com/problems/shan-chu-lian-biao-de-jie-dian-lcof/" target="_blank" rel="noopener">面试题18. 删除链表的节点</a></h4><p>给定单向链表的头指针和一个要删除的节点的值，定义一个函数删除该节点。</p><p>返回删除后的链表的头节点。</p><p> <strong>示例 1:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入: head = [<span class="number">4</span>,<span class="number">5</span>,<span class="number">1</span>,<span class="number">9</span>], val = <span class="number">5</span></span><br><span class="line">输出: [<span class="number">4</span>,<span class="number">1</span>,<span class="number">9</span>]</span><br><span class="line">解释: 给定你链表中值为 <span class="number">5</span> 的第二个节点，那么在调用了你的函数之后，该链表应变为 <span class="number">4</span> -&gt; <span class="number">1</span> -&gt; <span class="number">9</span>.</span><br></pre></td></tr></table></figure><p> <strong>示例 2:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入: head = [<span class="number">4</span>,<span class="number">5</span>,<span class="number">1</span>,<span class="number">9</span>], val = <span class="number">1</span></span><br><span class="line">输出: [<span class="number">4</span>,<span class="number">5</span>,<span class="number">9</span>]</span><br><span class="line">解释: 给定你链表中值为 <span class="number">1</span> 的第三个节点，那么在调用了你的函数之后，该链表应变为 <span class="number">4</span> -&gt; <span class="number">5</span> -&gt; <span class="number">9</span>.</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> ListNode <span class="title">deleteNode</span><span class="params">(ListNode head, <span class="keyword">int</span> val)</span> </span>&#123;</span><br><span class="line">        ListNode pre = head, cur = head.next;</span><br><span class="line">        <span class="keyword">if</span>(head.val == val) <span class="keyword">return</span> head.next;</span><br><span class="line">        <span class="keyword">while</span>(cur.val != val &amp;&amp; cur != <span class="keyword">null</span>) &#123;</span><br><span class="line">            pre = pre.next;</span><br><span class="line">            cur = cur.next;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">if</span>(cur != <span class="keyword">null</span>) &#123;</span><br><span class="line">            pre.next = cur.next;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> head;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题19-正则表达式匹配"><a href="#面试题19-正则表达式匹配" class="headerlink" title="面试题19. 正则表达式匹配"></a><a href="https://leetcode-cn.com/problems/zheng-ze-biao-da-shi-pi-pei-lcof/" target="_blank" rel="noopener">面试题19. 正则表达式匹配</a></h4><p>请实现一个函数用来匹配包含<code>&#39;. &#39;</code>和<code>&#39;*&#39;</code>的正则表达式。模式中的字符<code>&#39;.&#39;</code>表示任意一个字符，而<code>&#39;*&#39;</code>表示它前面的字符可以出现任意次（含0次）。 在本题中，匹配是指字符串的所有字符匹配整个模式。例如，字符串<code>&quot;aaa&quot;</code>与模式<code>&quot;a.a&quot;</code>和<code>&quot;ab*ac*a&quot;</code>匹配，但与<code>&quot;aa.a&quot;</code>和<code>&quot;ab*a&quot;</code>均不匹配。 </p><p> <strong>示例 1:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">输入:</span><br><span class="line">s = <span class="string">"aa"</span></span><br><span class="line">p = <span class="string">"a"</span></span><br><span class="line">输出: <span class="keyword">false</span></span><br><span class="line">解释: <span class="string">"a"</span> 无法匹配 <span class="string">"aa"</span> 整个字符串。</span><br></pre></td></tr></table></figure><p> <strong>示例 2:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">输入:</span><br><span class="line">s = <span class="string">"aa"</span></span><br><span class="line">p = <span class="string">"a*"</span></span><br><span class="line">输出: <span class="keyword">true</span></span><br><span class="line">解释: 因为 <span class="string">'*'</span> 代表可以匹配零个或多个前面的那一个元素, 在这里前面的元素就是 <span class="string">'a'</span>。因此，字符串 <span class="string">"aa"</span> 可被视为 <span class="string">'a'</span> 重复了一次。</span><br></pre></td></tr></table></figure><p> <strong>示例 3:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">输入:</span><br><span class="line">s = <span class="string">"ab"</span></span><br><span class="line">p = <span class="string">".*"</span></span><br><span class="line">输出: <span class="keyword">true</span></span><br><span class="line">解释: <span class="string">".*"</span> 表示可匹配零个或多个（<span class="string">'*'</span>）任意字符（<span class="string">'.'</span>）。</span><br></pre></td></tr></table></figure><p> <strong>示例 4:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">输入:</span><br><span class="line">s = <span class="string">"mississippi"</span></span><br><span class="line">p = <span class="string">"mis*is*p*."</span></span><br><span class="line">输出: <span class="keyword">false</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">isMatch</span><span class="params">(String s, String p)</span> </span>&#123;</span><br><span class="line">        <span class="comment">//任意一个为空，则匹配失败</span></span><br><span class="line">        <span class="keyword">if</span>(s==<span class="keyword">null</span>||p==<span class="keyword">null</span>)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">return</span> match(s.toCharArray(),<span class="number">0</span>,p.toCharArray(),<span class="number">0</span>);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">match</span><span class="params">(<span class="keyword">char</span>[] str, <span class="keyword">int</span> s,<span class="keyword">char</span>[] pattern,<span class="keyword">int</span> p)</span></span>&#123;</span><br><span class="line">        <span class="comment">//如果字符串和匹配字符串都到达了末尾，则说明匹配成功</span></span><br><span class="line">        <span class="keyword">if</span>(s==str.length&amp;&amp;p==pattern.length)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        <span class="comment">//如果字符串未遍历结束，但匹配字符串已结束，匹配失败</span></span><br><span class="line">        <span class="keyword">if</span>(s&lt;str.length&amp;&amp;p==pattern.length)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="comment">//如果匹配字符串的下一个字符是*</span></span><br><span class="line">        <span class="keyword">if</span>(p&lt;pattern.length-<span class="number">1</span>&amp;&amp;pattern[p+<span class="number">1</span>]==<span class="string">'*'</span>)&#123;</span><br><span class="line">            <span class="comment">//如果当前字符串字符和匹配字符串字符相同或者匹配字符为.</span></span><br><span class="line">            <span class="keyword">if</span>(s&lt;str.length&amp;&amp;(str[s]==pattern[p]||pattern[p]==<span class="string">'.'</span>))</span><br><span class="line">                <span class="keyword">return</span> match(str, s+<span class="number">1</span>, pattern, p)<span class="comment">//.*可以匹配多个字符 如aa匹配a*</span></span><br><span class="line">                     ||match(str, s, pattern, p+<span class="number">2</span>);<span class="comment">//字符串已匹配完，放弃匹配字符串的两个位置，例如a匹配ab*</span></span><br><span class="line">            <span class="keyword">else</span></span><br><span class="line">                <span class="keyword">return</span> match(str, s, pattern, p+<span class="number">2</span>);<span class="comment">//忽略当前匹配字符串的2个字符 如a不匹配b*，可跳过b*这两个位置</span></span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">//匹配字符串没有下一个位置或下一个位置不为*，那么当前位置必须相等或为.，否则匹配失败</span></span><br><span class="line">        <span class="keyword">if</span>(s&lt;str.length&amp;&amp;(str[s]==pattern[p]||pattern[p]==<span class="string">'.'</span>))&#123;</span><br><span class="line">            <span class="keyword">return</span> match(str,s+<span class="number">1</span>,pattern,p+<span class="number">1</span>);<span class="comment">//各自匹配一个位置</span></span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题20-表示数值的字符串"><a href="#面试题20-表示数值的字符串" class="headerlink" title="面试题20. 表示数值的字符串"></a><a href="https://leetcode-cn.com/problems/biao-shi-shu-zhi-de-zi-fu-chuan-lcof/" target="_blank" rel="noopener">面试题20. 表示数值的字符串</a></h4><p>请实现一个函数用来判断字符串是否表示数值（包括整数和小数）。例如，字符串”+100”、”5e2”、”-123”、”3.1416”、”0123”都表示数值，但”12e”、”1a3.14”、”1.2.3”、”+-5”、”-1E-16”及”12e+5.4”都不是。 </p><p> <strong>思路和代码：</strong> </p><p>[abc]表示匹配a、b、c任意一个即可。[0-9]表示匹配数字0-9</p><p><code>\\.</code>表示小数点，？表示0或1次，+表示1或多次，*表示任意次，|表示或。</p><p>首先判断开头，[+-]？表示可以以加号或减号开头，也可以不以加减号开头。</p><p>数字部分是<code>[0-9]+\\.?</code>表示0-9必须出现一次，小数点可以不出现，例如<code>111</code>，<code>11.</code></p><p> 或者是<code>[0-9]*\\.[0-9]+</code>，表示小数点前任意次，小数点必须有，小数点后必须有，例如<code>.5</code>，<code>1.5</code> </p><p> 最后指数<code>[e][+-]?[0-9]+</code>匹配时表示必须有e，正负号可有可无，有e时后面必须有数字，？表示也可以没指数。 </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">isNumber</span><span class="params">(String s)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> s.trim()</span><br><span class="line">                .matches(<span class="string">"^[+-]?(([0-9]+\\.?)|([0-9]*\\.[0-9]+))([e][+-]?[0-9]+)?$"</span>);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题21-调整数组顺序使奇数位于偶数前面"><a href="#面试题21-调整数组顺序使奇数位于偶数前面" class="headerlink" title="面试题21. 调整数组顺序使奇数位于偶数前面"></a><a href="https://leetcode-cn.com/problems/diao-zheng-shu-zu-shun-xu-shi-qi-shu-wei-yu-ou-shu-qian-mian-lcof/" target="_blank" rel="noopener">面试题21. 调整数组顺序使奇数位于偶数前面</a></h4><p> 输入一个整数数组，实现一个函数来调整该数组中数字的顺序，使得所有奇数位于数组的前半部分，所有偶数位于数组的后半部分。 </p><p> <strong>示例：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入：nums = [<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>]</span><br><span class="line">输出：[<span class="number">1</span>,<span class="number">3</span>,<span class="number">2</span>,<span class="number">4</span>] </span><br><span class="line">注：[<span class="number">3</span>,<span class="number">1</span>,<span class="number">2</span>,<span class="number">4</span>] 也是正确的答案之一。</span><br></pre></td></tr></table></figure><p><strong>思路与代码：</strong></p><p> 类似于快速排序的思想，使用双指针，从头找偶数，从尾找奇数，然后交换它们的位置。 </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] exchange(<span class="keyword">int</span>[] nums) &#123;</span><br><span class="line">        <span class="keyword">int</span> p = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">int</span> q = nums.length-<span class="number">1</span>;</span><br><span class="line">        <span class="keyword">while</span>(p &lt; q)&#123;</span><br><span class="line">            <span class="comment">//从前面找到第一个偶数</span></span><br><span class="line">            <span class="keyword">while</span>(p &lt;= q &amp;&amp; nums[p]%<span class="number">2</span> != <span class="number">0</span>)</span><br><span class="line">                p++;</span><br><span class="line">            <span class="comment">//从后面找到第一个奇数</span></span><br><span class="line">            <span class="keyword">while</span>(p &lt;= q &amp;&amp; nums[q]%<span class="number">2</span> == <span class="number">0</span>)</span><br><span class="line">                q--;</span><br><span class="line">            <span class="keyword">if</span>(p &lt; q)&#123;<span class="comment">//交换数字</span></span><br><span class="line">                <span class="keyword">int</span> temp=nums[p];</span><br><span class="line">                nums[p]=nums[q];</span><br><span class="line">                nums[q]=temp;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> nums;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题22-链表中倒数第k个节点"><a href="#面试题22-链表中倒数第k个节点" class="headerlink" title="面试题22. 链表中倒数第k个节点"></a><a href="https://leetcode-cn.com/problems/lian-biao-zhong-dao-shu-di-kge-jie-dian-lcof/" target="_blank" rel="noopener">面试题22. 链表中倒数第k个节点</a></h4><p>输入一个链表，输出该链表中倒数第k个节点。为了符合大多数人的习惯，本题从1开始计数，即链表的尾节点是倒数第1个节点。例如，一个链表有6个节点，从头节点开始，它们的值依次是1、2、3、4、5、6。这个链表的倒数第3个节点是值为4的节点。 </p><p><strong>示例：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">给定一个链表: <span class="number">1</span>-&gt;<span class="number">2</span>-&gt;<span class="number">3</span>-&gt;<span class="number">4</span>-&gt;<span class="number">5</span>, 和 k = <span class="number">2</span>.</span><br><span class="line">返回链表 <span class="number">4</span>-&gt;<span class="number">5</span>.</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p> 使用双指针，让前指针先走k个，这样当前指针为null时后指针就是答案。 </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> ListNode <span class="title">getKthFromEnd</span><span class="params">(ListNode head, <span class="keyword">int</span> k)</span> </span>&#123;</span><br><span class="line">        ListNode pre = head, cur = head;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;k; i++)</span><br><span class="line">            cur = cur.next;</span><br><span class="line">        <span class="keyword">while</span>(cur != <span class="keyword">null</span>) &#123;</span><br><span class="line">            pre = pre.next;</span><br><span class="line">            cur = cur.next;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> pre;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题24-反转链表"><a href="#面试题24-反转链表" class="headerlink" title="面试题24. 反转链表"></a><a href="https://leetcode-cn.com/problems/fan-zhuan-lian-biao-lcof/" target="_blank" rel="noopener">面试题24. 反转链表</a></h4><p>定义一个函数，输入一个链表的头节点，反转该链表并输出反转后链表的头节点。</p><p> <strong>示例:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入: <span class="number">1</span>-&gt;<span class="number">2</span>-&gt;<span class="number">3</span>-&gt;<span class="number">4</span>-&gt;<span class="number">5</span>-&gt;NULL</span><br><span class="line">输出: <span class="number">5</span>-&gt;<span class="number">4</span>-&gt;<span class="number">3</span>-&gt;<span class="number">2</span>-&gt;<span class="number">1</span>-&gt;NULL</span><br></pre></td></tr></table></figure><p><strong>思路和代码：</strong></p><p>方法一、利用两个指针，pre指针保存前一个节点，cur指针用于遍历链表， 每次迭代到 cur，都将 cur 的 next 指向 pre，然后 pre 和 cur 前进一位。 </p><p><img src="https://pic.leetcode-cn.com/fd2b1e4fe949ed0c09991c529e780708b2c68dc3d018342d51b846268369c3ef.gif" alt="img"></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> ListNode <span class="title">reverseList</span><span class="params">(ListNode head)</span> </span>&#123;</span><br><span class="line">        ListNode pre, cur;</span><br><span class="line">        pre = <span class="keyword">null</span>;</span><br><span class="line">        <span class="keyword">while</span>(head != <span class="keyword">null</span>) &#123;</span><br><span class="line">            cur = head.next;</span><br><span class="line">            head.next = pre;</span><br><span class="line">            pre = head;</span><br><span class="line">            head = cur;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> pre;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>方法二、递归</p><p><img src="https://pic.leetcode-cn.com/5ff86a743320333d3fe335c711182de37fb0fce958a005064254b4b48b2958a9.gif" alt="img"></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> ListNode <span class="title">reverseList</span><span class="params">(ListNode head)</span> </span>&#123;</span><br><span class="line">        <span class="comment">//递归终止条件是当前为空，或下一节点为空</span></span><br><span class="line">        <span class="keyword">if</span>(head == <span class="keyword">null</span> || head.next == <span class="keyword">null</span>)</span><br><span class="line">            <span class="keyword">return</span> head;</span><br><span class="line">        ListNode cur = reverseList(head.next);</span><br><span class="line">        <span class="comment">//反转节点</span></span><br><span class="line">        head.next.next = head;</span><br><span class="line">        <span class="comment">//防止列表循环，需将head.next置空</span></span><br><span class="line">        head.next = <span class="keyword">null</span>;</span><br><span class="line">        <span class="comment">//每层递归都返回cur，即最后一个节点</span></span><br><span class="line">        <span class="keyword">return</span> cur;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题25-合并两个排序的链表"><a href="#面试题25-合并两个排序的链表" class="headerlink" title="面试题25. 合并两个排序的链表"></a><a href="https://leetcode-cn.com/problems/he-bing-liang-ge-pai-xu-de-lian-biao-lcof/" target="_blank" rel="noopener">面试题25. 合并两个排序的链表</a></h4><p>输入两个递增排序的链表，合并这两个链表并使新链表中的节点仍然是递增排序的。</p><p> <strong>示例1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：<span class="number">1</span>-&gt;<span class="number">2</span>-&gt;<span class="number">4</span>, <span class="number">1</span>-&gt;<span class="number">3</span>-&gt;<span class="number">4</span></span><br><span class="line">输出：<span class="number">1</span>-&gt;<span class="number">1</span>-&gt;<span class="number">2</span>-&gt;<span class="number">3</span>-&gt;<span class="number">4</span>-&gt;<span class="number">4</span></span><br></pre></td></tr></table></figure><p><strong>思路和代码：</strong></p><p>比较简单，由于是有序链表，所以分别从头开始遍历，如果l1更小，将节点的下一个指向l1，否则就指向l2。如果有一个为空，就将另一个剩下的链表直接拼接。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> ListNode <span class="title">mergeTwoLists</span><span class="params">(ListNode l1, ListNode l2)</span> </span>&#123;</span><br><span class="line">        ListNode pre = <span class="keyword">new</span> ListNode(-<span class="number">1</span>);</span><br><span class="line">        ListNode cur = pre;</span><br><span class="line">        <span class="keyword">while</span>(l1!=<span class="keyword">null</span> &amp;&amp; l2!=<span class="keyword">null</span>) &#123;</span><br><span class="line">            <span class="keyword">if</span>(l1.val &lt; l2.val)&#123;</span><br><span class="line">                cur.next = l1;</span><br><span class="line">                l1 = l1.next;</span><br><span class="line">            &#125; <span class="keyword">else</span> &#123;</span><br><span class="line">                cur.next = l2;</span><br><span class="line">                l2 = l2.next;</span><br><span class="line">            &#125;</span><br><span class="line">            cur = cur.next;</span><br><span class="line">        &#125;</span><br><span class="line">        cur.next = l1==<span class="keyword">null</span> ? l2:l1;</span><br><span class="line">        <span class="keyword">return</span> pre.next;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题26-树的子结构"><a href="#面试题26-树的子结构" class="headerlink" title="面试题26. 树的子结构"></a><a href="https://leetcode-cn.com/problems/shu-de-zi-jie-gou-lcof/" target="_blank" rel="noopener">面试题26. 树的子结构</a></h4><p>输入两棵二叉树A和B，判断B是不是A的子结构。(约定空树不是任意一个树的子结构)</p><p>B是A的子结构， 即 A中有出现和B相同的结构和节点值。 </p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：A = [<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>], B = [<span class="number">3</span>,<span class="number">1</span>]</span><br><span class="line">输出：<span class="keyword">false</span></span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：A = [<span class="number">3</span>,<span class="number">4</span>,<span class="number">5</span>,<span class="number">1</span>,<span class="number">2</span>], B = [<span class="number">4</span>,<span class="number">1</span>]</span><br><span class="line">输出：<span class="keyword">true</span></span><br></pre></td></tr></table></figure><p><strong>思路和代码</strong></p><p>递归即可</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">isSubStructure</span><span class="params">(TreeNode A, TreeNode B)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(A == <span class="keyword">null</span> || B == <span class="keyword">null</span>)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">return</span> dfs(A,B) || isSubStructure(A.left,B) || isSubStructure(A.right,B);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">boolean</span> <span class="title">dfs</span><span class="params">(TreeNode A, TreeNode B)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(B == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        <span class="keyword">if</span>(A == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">return</span> A.val == B.val &amp;&amp; dfs(A.right,B.right) &amp;&amp; dfs(A.left ,B.left);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题27-二叉树的镜像"><a href="#面试题27-二叉树的镜像" class="headerlink" title="面试题27. 二叉树的镜像"></a><a href="https://leetcode-cn.com/problems/er-cha-shu-de-jing-xiang-lcof/" target="_blank" rel="noopener">面试题27. 二叉树的镜像</a></h4><p>请完成一个函数，输入一个二叉树，该函数输出它的镜像。</p><p> <strong>示例 ：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line">输入：  <span class="number">4</span></span><br><span class="line">    /    \</span><br><span class="line">   <span class="number">2</span>      <span class="number">7</span></span><br><span class="line">  /  \    / \</span><br><span class="line">  <span class="number">1</span>   <span class="number">3</span>  <span class="number">6</span>   <span class="number">9</span></span><br><span class="line">    </span><br><span class="line">输出：  <span class="number">4</span></span><br><span class="line">     /   \</span><br><span class="line">    <span class="number">7</span>      <span class="number">2</span></span><br><span class="line">   / \    / \</span><br><span class="line">  <span class="number">9</span>   <span class="number">6</span>  <span class="number">3</span>   <span class="number">1</span></span><br></pre></td></tr></table></figure><p><strong>思路和代码</strong></p><p>方法一、简单递归</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> TreeNode <span class="title">mirrorTree</span><span class="params">(TreeNode root)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(root!=<span class="keyword">null</span>) &#123;</span><br><span class="line">            <span class="comment">//将右子树翻转作为新的左子树</span></span><br><span class="line">            TreeNode newLeft = mirrorTree(root.right);</span><br><span class="line">            <span class="comment">//将左子树翻转作为新的右子树</span></span><br><span class="line">            TreeNode newRight = mirrorTree(root.left);</span><br><span class="line">            root.left = newLeft;</span><br><span class="line">            root.right = newRight;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> root;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>方法二、借助辅助栈或队列</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> TreeNode <span class="title">mirrorTree</span><span class="params">(TreeNode root)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(root == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="keyword">null</span>;</span><br><span class="line">        Stack&lt;TreeNode&gt; stack = <span class="keyword">new</span> Stack&lt;&gt;();</span><br><span class="line">        stack.push(root);</span><br><span class="line">        <span class="keyword">while</span>(!stack.isEmpty()) &#123;</span><br><span class="line">            TreeNode node = stack.pop();</span><br><span class="line">            <span class="keyword">if</span>(node.left != <span class="keyword">null</span>) stack.push(node.left);</span><br><span class="line">            <span class="keyword">if</span>(node.right != <span class="keyword">null</span>) stack.push(node.right);</span><br><span class="line">            TreeNode temp = node.left;</span><br><span class="line">            node.left = node.right;</span><br><span class="line">            node.right = temp;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> root;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题28-对称的二叉树"><a href="#面试题28-对称的二叉树" class="headerlink" title="面试题28. 对称的二叉树"></a><a href="https://leetcode-cn.com/problems/dui-cheng-de-er-cha-shu-lcof/" target="_blank" rel="noopener">面试题28. 对称的二叉树</a></h4><p>给定一个二叉树，检查它是否是镜像对称的。</p><p> 例如，二叉树 <code>[1,2,2,3,4,4,3]</code> 是对称的。 </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">    <span class="number">1</span></span><br><span class="line">   / \</span><br><span class="line">  <span class="number">2</span>   <span class="number">2</span></span><br><span class="line"> / \ / \</span><br><span class="line"><span class="number">3</span>  <span class="number">4</span> <span class="number">4</span>  <span class="number">3</span></span><br></pre></td></tr></table></figure><p> 但是下面这个 <code>[1,2,2,null,3,null,3]</code> 则不是镜像对称的: </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">  <span class="number">1</span></span><br><span class="line"> / \</span><br><span class="line"><span class="number">2</span>   <span class="number">2</span></span><br><span class="line"> \   \</span><br><span class="line"> <span class="number">3</span>    <span class="number">3</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong></p><p> 如果根节点为空，那么空节点是对称的，否则比较它的左右子树是否对称。</p><p>如果都为空那对称，如果只有一个为空肯定不对称。</p><p>如果都不为空那么比较值，值不同肯定不对称，如果值相同，再比较左节点的右子树和右节点的左子树是否对称（最里面那一层），比较左节点的左子树和右节点的右子树是否对称（最外面那一层）。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">isSymmetric</span><span class="params">(TreeNode root)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(root == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        <span class="keyword">return</span> helper(root.left,root.right);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">boolean</span> <span class="title">helper</span><span class="params">(TreeNode root1, TreeNode root2)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(root1 == <span class="keyword">null</span> &amp;&amp; root2 == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        <span class="keyword">if</span>(root1 == <span class="keyword">null</span> || root2 == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">return</span> root1.val == root2.val &amp;&amp; helper(root1.left,root2.right) &amp;&amp; helper(root1.right,root2.left);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题29-顺时针打印矩阵"><a href="#面试题29-顺时针打印矩阵" class="headerlink" title="面试题29. 顺时针打印矩阵"></a><a href="https://leetcode-cn.com/problems/shun-shi-zhen-da-yin-ju-zhen-lcof/" target="_blank" rel="noopener">面试题29. 顺时针打印矩阵</a></h4><p>输入一个矩阵，按照从外向里以顺时针的顺序依次打印出每一个数字。</p><p><strong>示例 1：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：matrix = [[<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>],[<span class="number">4</span>,<span class="number">5</span>,<span class="number">6</span>],[<span class="number">7</span>,<span class="number">8</span>,<span class="number">9</span>]]</span><br><span class="line">输出：[<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">6</span>,<span class="number">9</span>,<span class="number">8</span>,<span class="number">7</span>,<span class="number">4</span>,<span class="number">5</span>]</span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：matrix = [[<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>],[<span class="number">5</span>,<span class="number">6</span>,<span class="number">7</span>,<span class="number">8</span>],[<span class="number">9</span>,<span class="number">10</span>,<span class="number">11</span>,<span class="number">12</span>]]</span><br><span class="line">输出：[<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>,<span class="number">8</span>,<span class="number">12</span>,<span class="number">11</span>,<span class="number">10</span>,<span class="number">9</span>,<span class="number">5</span>,<span class="number">6</span>,<span class="number">7</span>]</span><br></pre></td></tr></table></figure><p><strong>限制：</strong></p><ul><li><code>0 &lt;= matrix.length &lt;= 100</code></li><li><code>0 &lt;= matrix[i].length &lt;= 100</code></li></ul><p><strong>思路和代码：</strong></p><p>在循环中按照右下左上的顺序循环，每次改变方向前先判断是否越界。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] spiralOrder(<span class="keyword">int</span>[][] matrix) &#123;</span><br><span class="line">        <span class="keyword">if</span>(matrix.length == <span class="number">0</span>) <span class="keyword">return</span> <span class="keyword">new</span> <span class="keyword">int</span>[<span class="number">0</span>];</span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[matrix.length*matrix[<span class="number">0</span>].length]; </span><br><span class="line">        <span class="keyword">int</span> left=<span class="number">0</span>, right=matrix[<span class="number">0</span>].length-<span class="number">1</span>, top=<span class="number">0</span>, bottom=matrix.length-<span class="number">1</span>, r=<span class="number">0</span>;</span><br><span class="line">        <span class="keyword">while</span>(<span class="keyword">true</span>) &#123;</span><br><span class="line">            <span class="comment">//从左向右移动</span></span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> i=left; i&lt;=right; i++) </span><br><span class="line">                res[r++] = matrix[top][i];</span><br><span class="line">            <span class="keyword">if</span>(++top &gt; bottom) <span class="keyword">break</span>;</span><br><span class="line">            <span class="comment">//从上向下移动</span></span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> i=top; i&lt;=bottom; i++) </span><br><span class="line">                res[r++] = matrix[i][right];</span><br><span class="line">            <span class="keyword">if</span>(--right &lt; left) <span class="keyword">break</span>;</span><br><span class="line">            <span class="comment">//从右向左移动</span></span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> i=right; i&gt;=left; i--) </span><br><span class="line">                res[r++] = matrix[bottom][i];</span><br><span class="line">            <span class="keyword">if</span>(--bottom &lt; top) <span class="keyword">break</span>;</span><br><span class="line">             <span class="comment">//从下向上移动</span></span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> i=bottom; i&gt;=top; i--) </span><br><span class="line">                res[r++] = matrix[i][left];</span><br><span class="line">            <span class="keyword">if</span>(++left &gt; right) <span class="keyword">break</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题30-包含min函数的栈"><a href="#面试题30-包含min函数的栈" class="headerlink" title="面试题30. 包含min函数的栈"></a><a href="https://leetcode-cn.com/problems/bao-han-minhan-shu-de-zhan-lcof/" target="_blank" rel="noopener">面试题30. 包含min函数的栈</a></h4><p>定义栈的数据结构，请在该类型中 实现一个能够得到栈的最小元素的 min 函数在该栈中，调用 min、push 及 pop 的时间复杂度都是 O(1)。 </p><p> <strong>示例:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">MinStack minStack = <span class="keyword">new</span> MinStack();</span><br><span class="line">minStack.push(-<span class="number">2</span>);</span><br><span class="line">minStack.push(<span class="number">0</span>);</span><br><span class="line">minStack.push(-<span class="number">3</span>);</span><br><span class="line">minStack.min();   --&gt; 返回 -<span class="number">3</span>.</span><br><span class="line">minStack.pop();</span><br><span class="line">minStack.top();      --&gt; 返回 <span class="number">0</span>.</span><br><span class="line">minStack.min();   --&gt; 返回 -<span class="number">2</span>.</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p> 使用一个辅助栈helper作为最小栈，进栈出栈helper都没有限制，对于最小栈helper只有helper为空或入栈节点值小于等于helper栈顶时才可入栈，出栈时，只有data和helper栈顶相同helper才出栈。 </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">MinStack</span> </span>&#123;</span><br><span class="line">    <span class="keyword">private</span> Stack&lt;Integer&gt; data;</span><br><span class="line">    <span class="keyword">private</span> Stack&lt;Integer&gt; helper;</span><br><span class="line">    <span class="comment">/** initialize your data structure here. */</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">MinStack</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        data = <span class="keyword">new</span> Stack&lt;&gt;();</span><br><span class="line">        helper = <span class="keyword">new</span> Stack&lt;&gt;();</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">push</span><span class="params">(<span class="keyword">int</span> x)</span> </span>&#123;</span><br><span class="line">        data.push(x);</span><br><span class="line">        <span class="keyword">if</span>(helper.isEmpty() || helper.peek() &gt;= x) </span><br><span class="line">            helper.push(x);</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">pop</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        <span class="comment">//data栈比较时即弹出</span></span><br><span class="line">        <span class="keyword">if</span>(helper.peek().equals(data.pop()))</span><br><span class="line">            helper.pop();</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">top</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> data.peek();</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">min</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> helper.peek();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题31-栈的压入、弹出序列"><a href="#面试题31-栈的压入、弹出序列" class="headerlink" title="面试题31. 栈的压入、弹出序列"></a><a href="https://leetcode-cn.com/problems/zhan-de-ya-ru-dan-chu-xu-lie-lcof/" target="_blank" rel="noopener">面试题31. 栈的压入、弹出序列</a></h4><p>输入两个整数序列，第一个序列表示栈的压入顺序，请判断第二个序列是否为该栈的弹出顺序。假设压入栈的所有数字均不相等。例如，序列 {1,2,3,4,5} 是某栈的压栈序列，序列 {4,5,3,2,1} 是该压栈序列对应的一个弹出序列，但 {4,3,5,1,2} 就不可能是该压栈序列的弹出序列。</p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">输入：pushed = [<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>,<span class="number">5</span>], popped = [<span class="number">4</span>,<span class="number">5</span>,<span class="number">3</span>,<span class="number">2</span>,<span class="number">1</span>]</span><br><span class="line">输出：<span class="keyword">true</span></span><br><span class="line">解释：我们可以按以下顺序执行：</span><br><span class="line">push(<span class="number">1</span>), push(<span class="number">2</span>), push(<span class="number">3</span>), push(<span class="number">4</span>), pop() -&gt; <span class="number">4</span>,</span><br><span class="line">push(<span class="number">5</span>), pop() -&gt; <span class="number">5</span>, pop() -&gt; <span class="number">3</span>, pop() -&gt; <span class="number">2</span>, pop() -&gt; <span class="number">1</span></span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入：pushed = [<span class="number">1</span>,<span class="number">2</span>,<span class="number">3</span>,<span class="number">4</span>,<span class="number">5</span>], popped = [<span class="number">4</span>,<span class="number">3</span>,<span class="number">5</span>,<span class="number">1</span>,<span class="number">2</span>]</span><br><span class="line">输出：<span class="keyword">false</span></span><br><span class="line">解释：<span class="number">1</span> 不能在 <span class="number">2</span> 之前弹出。</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>借助一个栈来模拟弹出操作，依次将pushed数组中的元素入栈，并与poped数组中元素值比较，若相等即立刻弹出，循环结束栈空则说明符合。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">validateStackSequences</span><span class="params">(<span class="keyword">int</span>[] pushed, <span class="keyword">int</span>[] popped)</span> </span>&#123;</span><br><span class="line">        Stack&lt;Integer&gt; stack = <span class="keyword">new</span> Stack&lt;&gt;();</span><br><span class="line">        <span class="keyword">int</span> j=<span class="number">0</span>;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt; popped.length; i++) &#123;</span><br><span class="line">            stack.push(pushed[i]);</span><br><span class="line">            <span class="keyword">while</span>(!stack.isEmpty() &amp;&amp; stack.peek()==popped[j]) &#123;</span><br><span class="line">                stack.pop();</span><br><span class="line">                j++;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> stack.isEmpty();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题32-I-从上到下打印二叉树"><a href="#面试题32-I-从上到下打印二叉树" class="headerlink" title="面试题32 - I. 从上到下打印二叉树"></a><a href="https://leetcode-cn.com/problems/cong-shang-dao-xia-da-yin-er-cha-shu-lcof/" target="_blank" rel="noopener">面试题32 - I. 从上到下打印二叉树</a></h4><p>从上到下打印出二叉树的每个节点，同一层的节点按照从左到右的顺序打印。</p><p> <strong>例如:</strong><br>给定二叉树: <code>[3,9,20,null,null,15,7]</code>, </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">  <span class="number">3</span></span><br><span class="line"> / \</span><br><span class="line"><span class="number">9</span>  <span class="number">20</span></span><br><span class="line">  /  \</span><br><span class="line"> <span class="number">15</span>   <span class="number">7</span></span><br></pre></td></tr></table></figure><p><strong>返回：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">[<span class="number">3</span>,<span class="number">9</span>,<span class="number">20</span>,<span class="number">15</span>,<span class="number">7</span>]</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>利用队列存储二叉树每一层的节点，当队列非空时将节点从头移除并加入结果集。然后按照先左后右将下一层节点加入队列。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] levelOrder(TreeNode root) &#123;</span><br><span class="line">        <span class="keyword">if</span>(root == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="keyword">new</span> <span class="keyword">int</span>[<span class="number">0</span>];</span><br><span class="line">        Queue&lt;TreeNode&gt; queue = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">        queue.add(root);</span><br><span class="line">        ArrayList&lt;Integer&gt; ans = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">        <span class="keyword">while</span>(!queue.isEmpty()) &#123;</span><br><span class="line">            TreeNode node = queue.poll();</span><br><span class="line">            ans.add(node.val);</span><br><span class="line">            <span class="keyword">if</span>(node.left != <span class="keyword">null</span>) queue.add(node.left);</span><br><span class="line">            <span class="keyword">if</span>(node.right != <span class="keyword">null</span>) queue.add(node.right);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[ans.size()];</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; ans.size(); i++)</span><br><span class="line">            res[i] = ans.get(i);</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题32-II-从上到下打印二叉树-II"><a href="#面试题32-II-从上到下打印二叉树-II" class="headerlink" title="面试题32 - II. 从上到下打印二叉树 II"></a><a href="https://leetcode-cn.com/problems/cong-shang-dao-xia-da-yin-er-cha-shu-ii-lcof/" target="_blank" rel="noopener">面试题32 - II. 从上到下打印二叉树 II</a></h4><p>从上到下按层打印二叉树，同一层的节点按从左到右的顺序打印，每一层打印到一行。</p><p><strong>例如:</strong><br>给定二叉树: <code>[3,9,20,null,null,15,7]</code>, </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">  <span class="number">3</span></span><br><span class="line"> / \</span><br><span class="line"><span class="number">9</span>  <span class="number">20</span></span><br><span class="line">  /  \</span><br><span class="line"> <span class="number">15</span>   <span class="number">7</span></span><br></pre></td></tr></table></figure><p><strong>返回：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">[</span><br><span class="line">  [<span class="number">3</span>],</span><br><span class="line">  [<span class="number">9</span>,<span class="number">20</span>],</span><br><span class="line">  [<span class="number">15</span>,<span class="number">7</span>]</span><br><span class="line">]</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p> 和上一题类似，只是要将每一行的数值保存到同一个list中。每次出队之前先计算当前队列的大小，这个大小就是这一层的节点数量，然后按这个数量依次从队头移除。 </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; levelOrder(TreeNode root) &#123;</span><br><span class="line">        LinkedList&lt;TreeNode&gt; queue = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">        List&lt;List&lt;Integer&gt;&gt; res = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">        <span class="keyword">if</span>(root != <span class="keyword">null</span>) queue.addLast(root);</span><br><span class="line">        <span class="keyword">while</span>(!queue.isEmpty()) &#123;</span><br><span class="line">            List&lt;Integer&gt; tmp = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">            <span class="comment">//注意queue的size一直在变，所以每层开始从队尾取一次size值；也可以单独写个变量赋值</span></span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> i=queue.size(); i&gt;<span class="number">0</span>; i--) &#123;</span><br><span class="line">                TreeNode node = queue.removeFirst();</span><br><span class="line">                tmp.add(node.val);</span><br><span class="line">                <span class="keyword">if</span>(node.left != <span class="keyword">null</span>) queue.addLast(node.left);</span><br><span class="line">                <span class="keyword">if</span>(node.right != <span class="keyword">null</span>) queue.addLast(node.right);</span><br><span class="line">            &#125;</span><br><span class="line">            res.add(tmp);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>DFS的递归解法参考</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; levelOrder(TreeNode root) &#123;</span><br><span class="line">    List&lt;List&lt;Integer&gt;&gt; res = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    levelHelper(res, root, <span class="number">0</span>);</span><br><span class="line">    <span class="keyword">return</span> res;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">levelHelper</span><span class="params">(List&lt;List&lt;Integer&gt;&gt; list, TreeNode root, <span class="keyword">int</span> level)</span> </span>&#123;</span><br><span class="line">    <span class="comment">//边界条件判断</span></span><br><span class="line">    <span class="keyword">if</span> (root == <span class="keyword">null</span>)</span><br><span class="line">        <span class="keyword">return</span>;</span><br><span class="line">    <span class="comment">//level表示的是层数，如果level &gt;= list.size()，说明到下一层了，所以</span></span><br><span class="line">    <span class="comment">//要先把下一层的list初始化，防止下面add的时候出现空指针异常</span></span><br><span class="line">    <span class="keyword">if</span> (level &gt;= list.size()) &#123;</span><br><span class="line">        list.add(<span class="keyword">new</span> ArrayList&lt;&gt;());</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="comment">//level表示的是第几层，这里访问到第几层，我们就把数据加入到第几层</span></span><br><span class="line">    list.get(level).add(root.val);</span><br><span class="line">    <span class="comment">//当前节点访问完之后，再使用递归的方式分别访问当前节点的左右子节点</span></span><br><span class="line">    levelHelper(list, root.left, level + <span class="number">1</span>);</span><br><span class="line">    levelHelper(list, root.right, level + <span class="number">1</span>);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题32-III-从上到下打印二叉树-III"><a href="#面试题32-III-从上到下打印二叉树-III" class="headerlink" title="面试题32 - III. 从上到下打印二叉树 III"></a><a href="https://leetcode-cn.com/problems/cong-shang-dao-xia-da-yin-er-cha-shu-iii-lcof/" target="_blank" rel="noopener">面试题32 - III. 从上到下打印二叉树 III</a></h4><p> 请实现一个函数按照之字形顺序打印二叉树，即第一行按照从左到右的顺序打印，第二层按照从右到左的顺序打印，第三行再按照从左到右的顺序打印，其他行以此类推。 </p><p><strong>例如:</strong><br>给定二叉树: <code>[3,9,20,null,null,15,7]</code>, </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">  <span class="number">3</span></span><br><span class="line"> / \</span><br><span class="line"><span class="number">9</span>  <span class="number">20</span></span><br><span class="line">  /  \</span><br><span class="line"> <span class="number">15</span>   <span class="number">7</span></span><br></pre></td></tr></table></figure><p><strong>返回：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">[</span><br><span class="line">  [<span class="number">3</span>],</span><br><span class="line">  [<span class="number">20</span>,<span class="number">9</span>],</span><br><span class="line">  [<span class="number">15</span>,<span class="number">7</span>]</span><br><span class="line">]</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>在上一题的基础上判断每一层的奇偶，利用双端队列对每层选择不同的输入方式（偶数从头进，奇数从尾进）。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; levelOrder(TreeNode root) &#123;</span><br><span class="line">        Queue&lt;TreeNode&gt; deque = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">        List&lt;List&lt;Integer&gt;&gt; res = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">        <span class="keyword">if</span>(root != <span class="keyword">null</span>)</span><br><span class="line">            deque.add(root);</span><br><span class="line">        <span class="keyword">while</span>(!deque.isEmpty()) &#123;</span><br><span class="line">            LinkedList&lt;Integer&gt; tmp = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> i= deque.size()-<span class="number">1</span>; i&gt;=<span class="number">0</span>; i--) &#123;</span><br><span class="line">                TreeNode node = deque.poll();</span><br><span class="line">                <span class="comment">//res的size为当前操作所在层数减去一</span></span><br><span class="line">                <span class="keyword">if</span>(res.size()%<span class="number">2</span> == <span class="number">1</span>) </span><br><span class="line">                    tmp.addFirst(node.val);</span><br><span class="line">                <span class="keyword">else</span> </span><br><span class="line">                    tmp.addLast(node.val);</span><br><span class="line">                <span class="keyword">if</span>(node.left != <span class="keyword">null</span>) deque.add(node.left);</span><br><span class="line">                <span class="keyword">if</span>(node.right != <span class="keyword">null</span>) deque.add(node.right);</span><br><span class="line">            &#125;</span><br><span class="line">            res.add(tmp);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>或者设置层数标识符来进行判断和逆序操作</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; levelOrder(TreeNode root) &#123;</span><br><span class="line">        List&lt;List&lt;Integer&gt;&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">        <span class="keyword">if</span>(root == <span class="keyword">null</span>)</span><br><span class="line">            <span class="keyword">return</span> list;</span><br><span class="line">        <span class="keyword">int</span> level=<span class="number">1</span>;</span><br><span class="line">        Queue&lt;TreeNode&gt; queue = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">        queue.offer(root);</span><br><span class="line">        <span class="keyword">while</span>(!queue.isEmpty())&#123;</span><br><span class="line">            <span class="keyword">int</span> n = queue.size();</span><br><span class="line">            List&lt;Integer&gt; tmp = <span class="keyword">new</span> ArrayList();</span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>;i&lt;n;i++)&#123;</span><br><span class="line">                TreeNode node = queue.poll();</span><br><span class="line">                tmp.add(node.val);</span><br><span class="line">                <span class="keyword">if</span>(node.left != <span class="keyword">null</span>)</span><br><span class="line">                    queue.offer(node.left);</span><br><span class="line">                <span class="keyword">if</span>(node.right != <span class="keyword">null</span>)</span><br><span class="line">                    queue.offer(node.right);</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="keyword">if</span>(level % <span class="number">2</span> == <span class="number">0</span>)</span><br><span class="line">                Collections.reverse(tmp);</span><br><span class="line">            level++;</span><br><span class="line">            list.add(tmp);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> list;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>DFS解法参考</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; levelOrder(TreeNode root) &#123;</span><br><span class="line">    List&lt;List&lt;Integer&gt;&gt; res = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    travel(root, res, <span class="number">0</span>);</span><br><span class="line">    <span class="keyword">return</span> res;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">travel</span><span class="params">(TreeNode cur, List&lt;List&lt;Integer&gt;&gt; res, <span class="keyword">int</span> level)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span> (cur == <span class="keyword">null</span>)</span><br><span class="line">        <span class="keyword">return</span>;</span><br><span class="line">    <span class="comment">//如果res.size() &lt;= level说明下一层的集合还没创建，所以要先创建下一层的集合</span></span><br><span class="line">    <span class="keyword">if</span> (res.size() &lt;= level) &#123;</span><br><span class="line">        List&lt;Integer&gt; newLevel = <span class="keyword">new</span> LinkedList&lt;&gt;();</span><br><span class="line">        res.add(newLevel);</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="comment">//遍历到第几层我们就操作第几层的数据</span></span><br><span class="line">    List&lt;Integer&gt; list = res.get(level);</span><br><span class="line">    <span class="comment">//这里默认根节点是第0层，偶数层相当于从左往右遍历，</span></span><br><span class="line">    <span class="comment">// 所以要添加到集合的末尾，如果是奇数层相当于从右往左遍历，</span></span><br><span class="line">    <span class="comment">// 要把数据添加到集合的开头</span></span><br><span class="line">    <span class="keyword">if</span> (level % <span class="number">2</span> == <span class="number">0</span>)</span><br><span class="line">        list.add(cur.val);</span><br><span class="line">    <span class="keyword">else</span></span><br><span class="line">        list.add(<span class="number">0</span>, cur.val);</span><br><span class="line">    <span class="comment">//分别遍历左右两个子节点，到下一层了，所以层数要加1</span></span><br><span class="line">    travel(cur.left, res, level + <span class="number">1</span>);</span><br><span class="line">    travel(cur.right, res, level + <span class="number">1</span>);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题33-二叉搜索树的后序遍历序列"><a href="#面试题33-二叉搜索树的后序遍历序列" class="headerlink" title="面试题33. 二叉搜索树的后序遍历序列"></a><a href="https://leetcode-cn.com/problems/er-cha-sou-suo-shu-de-hou-xu-bian-li-xu-lie-lcof/" target="_blank" rel="noopener">面试题33. 二叉搜索树的后序遍历序列</a></h4><p> 输入一个整数数组，判断该数组是不是某二叉搜索树的后序遍历结果。如果是则返回 <code>true</code>，否则返回 <code>false</code>。假设输入的数组的任意两个数字都互不相同。 </p><p><strong>参考以下这颗二叉搜索树：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">    <span class="number">5</span></span><br><span class="line">   / \</span><br><span class="line">  <span class="number">2</span>   <span class="number">6</span></span><br><span class="line"> / \</span><br><span class="line"><span class="number">1</span>   <span class="number">3</span></span><br></pre></td></tr></table></figure><p><strong>示例 1：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入: [<span class="number">1</span>,<span class="number">6</span>,<span class="number">3</span>,<span class="number">2</span>,<span class="number">5</span>]</span><br><span class="line">输出: <span class="keyword">false</span></span><br></pre></td></tr></table></figure><p><strong>示例 2：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入: [<span class="number">1</span>,<span class="number">3</span>,<span class="number">2</span>,<span class="number">6</span>,<span class="number">5</span>]</span><br><span class="line">输出: <span class="keyword">true</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>方法一、递归，根据后序遍历左-右-根的特点，从左边找到第一个大于根节点的值划分左右子树，左子树的值必须都比该值小（由于找到的是第一个大于根节点的值，这点肯定满足），接下来由于右子树都比根节点值大，再找到第一个不大于根节点的值，此时索引肯定等于根节点，如果不等于就是false。 </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">verifyPostorder</span><span class="params">(<span class="keyword">int</span>[] postorder)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> verify(postorder, <span class="number">0</span>, postorder.length-<span class="number">1</span>);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">verify</span><span class="params">(<span class="keyword">int</span>[] postorder, <span class="keyword">int</span> i, <span class="keyword">int</span> j)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(i &gt;= j)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">        <span class="keyword">int</span> mid = i;</span><br><span class="line">        <span class="keyword">while</span>(postorder[mid] &lt; postorder[j])</span><br><span class="line">            mid++;</span><br><span class="line">        <span class="keyword">int</span> root = mid;</span><br><span class="line">        <span class="keyword">while</span>(postorder[root] &gt; postorder[j])</span><br><span class="line">            root++;</span><br><span class="line">        <span class="keyword">if</span>(root != j)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">return</span> verify(postorder,i,mid-<span class="number">1</span>) &amp;&amp; verify(postorder,mid,j-<span class="number">1</span>);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>方法二、辅助栈，利用后续遍历的倒序，遍历数组。借助单调栈tmp存储递增节点，每当遇到递减节点时，通过出栈来更新当前节点的父节点，每轮判断当前节点和父节点的大小，大于父节点，返回false，小于则继续遍历。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">verifyPostorder</span><span class="params">(<span class="keyword">int</span>[] postorder)</span> </span>&#123;</span><br><span class="line">        Stack&lt;Integer&gt; tmp = <span class="keyword">new</span> Stack&lt;&gt;();</span><br><span class="line">        <span class="keyword">int</span> root = Integer.MAX_VALUE;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=postorder.length-<span class="number">1</span>; i&gt;=<span class="number">0</span>; i--) &#123;</span><br><span class="line">            <span class="keyword">if</span>(postorder[i] &gt; root) </span><br><span class="line">                <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">            <span class="keyword">while</span>(!tmp.isEmpty() &amp;&amp; tmp.peek() &gt; postorder[i])</span><br><span class="line">                root = tmp.pop();</span><br><span class="line">            tmp.push(postorder[i]);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题34-二叉树中和为某一值的路径"><a href="#面试题34-二叉树中和为某一值的路径" class="headerlink" title="面试题34. 二叉树中和为某一值的路径"></a><a href="https://leetcode-cn.com/problems/er-cha-shu-zhong-he-wei-mou-yi-zhi-de-lu-jing-lcof/" target="_blank" rel="noopener">面试题34. 二叉树中和为某一值的路径</a></h4><p> 输入一棵二叉树和一个整数，打印出二叉树中节点值的和为输入整数的所有路径。从树的根节点开始往下一直到叶节点所经过的节点形成一条路径。 </p><p> <strong>示例:</strong><br>给定如下二叉树，以及目标和 <code>sum = 22</code>， </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">      <span class="number">5</span></span><br><span class="line">     / \</span><br><span class="line">    <span class="number">4</span>   <span class="number">8</span></span><br><span class="line">   /   / \</span><br><span class="line">  <span class="number">11</span>  <span class="number">13</span>  <span class="number">4</span></span><br><span class="line"> /  \    / \</span><br><span class="line"><span class="number">7</span>    <span class="number">2</span>  <span class="number">5</span>   <span class="number">1</span></span><br></pre></td></tr></table></figure><p> <strong>返回:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">[</span><br><span class="line">   [<span class="number">5</span>,<span class="number">4</span>,<span class="number">11</span>,<span class="number">2</span>],</span><br><span class="line">   [<span class="number">5</span>,<span class="number">8</span>,<span class="number">4</span>,<span class="number">5</span>]</span><br><span class="line">]</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>回溯法，先序遍历： 按照 “根、左、右” 的顺序，遍历树的所有节点。<br>路径记录： 在先序遍历中，记录从根节点到当前节点的路径。当路径为 ① 根节点到叶节点形成的路径 且 ② 各节点值的和等于目标值 sum 时，将此路径加入结果列表。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    LinkedList&lt;Integer&gt; tmp = <span class="keyword">new</span> LinkedList&lt;&gt;();    </span><br><span class="line">    List&lt;List&lt;Integer&gt;&gt; res = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    <span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; pathSum(TreeNode root, <span class="keyword">int</span> sum) &#123;</span><br><span class="line">        recur(root, sum);</span><br><span class="line">        <span class="keyword">return</span> res; </span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">void</span> <span class="title">recur</span><span class="params">(TreeNode root, <span class="keyword">int</span> sum)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(root == <span class="keyword">null</span>) </span><br><span class="line">            <span class="keyword">return</span>;</span><br><span class="line">        sum -= root.val;</span><br><span class="line">        tmp.add(root.val);</span><br><span class="line">        <span class="keyword">if</span>(sum ==<span class="number">0</span> &amp;&amp; root.left == <span class="keyword">null</span> &amp;&amp; root.right == <span class="keyword">null</span>)</span><br><span class="line">            res.add(<span class="keyword">new</span> LinkedList(tmp));</span><br><span class="line">        recur(root.left,sum);</span><br><span class="line">        recur(root.right,sum);</span><br><span class="line">        tmp.removeLast();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题35-复杂链表的复制"><a href="#面试题35-复杂链表的复制" class="headerlink" title="面试题35. 复杂链表的复制"></a><a href="https://leetcode-cn.com/problems/fu-za-lian-biao-de-fu-zhi-lcof/" target="_blank" rel="noopener">面试题35. 复杂链表的复制</a></h4><p> 请实现 <code>copyRandomList</code> 函数，复制一个复杂链表。在复杂链表中，每个节点除了有一个 <code>next</code> 指针指向下一个节点，还有一个 <code>random</code> 指针指向链表中的任意节点或者 <code>null</code>。 </p><p> <strong>示例 1：</strong> </p><p><img src="https://assets.leetcode-cn.com/aliyun-lc-upload/uploads/2020/01/09/e1.png" alt="img"></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：head = [[<span class="number">7</span>,<span class="keyword">null</span>],[<span class="number">13</span>,<span class="number">0</span>],[<span class="number">11</span>,<span class="number">4</span>],[<span class="number">10</span>,<span class="number">2</span>],[<span class="number">1</span>,<span class="number">0</span>]]</span><br><span class="line">输出：[[<span class="number">7</span>,<span class="keyword">null</span>],[<span class="number">13</span>,<span class="number">0</span>],[<span class="number">11</span>,<span class="number">4</span>],[<span class="number">10</span>,<span class="number">2</span>],[<span class="number">1</span>,<span class="number">0</span>]]</span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><p><img src="https://assets.leetcode-cn.com/aliyun-lc-upload/uploads/2020/01/09/e2.png" alt="img"></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：head = [[<span class="number">1</span>,<span class="number">1</span>],[<span class="number">2</span>,<span class="number">1</span>]]</span><br><span class="line">输出：[[<span class="number">1</span>,<span class="number">1</span>],[<span class="number">2</span>,<span class="number">1</span>]]</span><br></pre></td></tr></table></figure><p> <strong>示例 3：</strong> </p><p> <img src="https://assets.leetcode-cn.com/aliyun-lc-upload/uploads/2020/01/09/e3.png" alt="img"></p> <figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：head = [[<span class="number">3</span>,<span class="keyword">null</span>],[<span class="number">3</span>,<span class="number">0</span>],[<span class="number">3</span>,<span class="keyword">null</span>]]</span><br><span class="line">输出：[[<span class="number">3</span>,<span class="keyword">null</span>],[<span class="number">3</span>,<span class="number">0</span>],[<span class="number">3</span>,<span class="keyword">null</span>]]</span><br></pre></td></tr></table></figure><p> <strong>示例 4：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">输入：head = []</span><br><span class="line">输出：[]</span><br><span class="line">解释：给定的链表为空（空指针），因此返回 <span class="keyword">null</span>。</span><br></pre></td></tr></table></figure><p><strong>提示：</strong></p><ul><li><p><code>-10000 &lt;= Node.val &lt;= 10000</code></p></li><li><p><code>Node.random</code> 为空（null）或指向链表中的节点。</p></li><li><p>节点数目不超过 1000 。</p><p><strong>思路和代码：</strong> </p></li></ul><p>方法一、链表原地复制节点和指针，然后断开形成新链表。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> Node <span class="title">copyRandomList</span><span class="params">(Node head)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span> (head == <span class="keyword">null</span>)</span><br><span class="line">            <span class="keyword">return</span> head;</span><br><span class="line">        <span class="comment">// 完成链表节点的复制</span></span><br><span class="line">        Node cur = head;</span><br><span class="line">        <span class="keyword">while</span> (cur != <span class="keyword">null</span>) &#123;</span><br><span class="line">            Node copyNode = <span class="keyword">new</span> Node(cur.val);</span><br><span class="line">            copyNode.next = cur.next;</span><br><span class="line">            cur.next = copyNode;</span><br><span class="line">            cur = cur.next.next;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">// 完成链表复制节点的随机指针复制</span></span><br><span class="line">        cur = head;</span><br><span class="line">        <span class="keyword">while</span> (cur != <span class="keyword">null</span>) &#123;</span><br><span class="line">            <span class="keyword">if</span> (cur.random != <span class="keyword">null</span>) <span class="comment">// 注意判断原来的节点有没有random指针</span></span><br><span class="line">                cur.next.random = cur.random.next;</span><br><span class="line">            cur = cur.next.next;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">// 将链表一分为二</span></span><br><span class="line">        Node copyHead = head.next;</span><br><span class="line">        cur = head;</span><br><span class="line">        Node curCopy = head.next;</span><br><span class="line">        <span class="keyword">while</span> (cur != <span class="keyword">null</span>) &#123;</span><br><span class="line">            cur.next = cur.next.next;</span><br><span class="line">            cur = cur.next;</span><br><span class="line">            <span class="keyword">if</span> (curCopy.next != <span class="keyword">null</span>) &#123;</span><br><span class="line">                curCopy.next = curCopy.next.next;</span><br><span class="line">                curCopy = curCopy.next;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> copyHead;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>方法二、哈希表复制</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> Node <span class="title">copyRandomList</span><span class="params">(Node head)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span> (head == <span class="keyword">null</span>) &#123;</span><br><span class="line">            <span class="keyword">return</span> head;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">//map中存的是(原节点，拷贝节点)的一个映射</span></span><br><span class="line">        Map&lt;Node, Node&gt; map = <span class="keyword">new</span> HashMap&lt;&gt;();</span><br><span class="line">        <span class="keyword">for</span> (Node cur = head; cur != <span class="keyword">null</span>; cur = cur.next) &#123;</span><br><span class="line">            map.put(cur, <span class="keyword">new</span> Node(cur.val));</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">//将拷贝的新的节点组织成一个链表</span></span><br><span class="line">        <span class="keyword">for</span> (Node cur = head; cur != <span class="keyword">null</span>; cur = cur.next) &#123;</span><br><span class="line">            map.get(cur).next = map.get(cur.next);</span><br><span class="line">            map.get(cur).random = map.get(cur.random);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> map.get(head);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题36-二叉搜索树与双向链表"><a href="#面试题36-二叉搜索树与双向链表" class="headerlink" title="面试题36. 二叉搜索树与双向链表"></a><a href="https://leetcode-cn.com/problems/er-cha-sou-suo-shu-yu-shuang-xiang-lian-biao-lcof/" target="_blank" rel="noopener">面试题36. 二叉搜索树与双向链表</a></h4><p> 输入一棵二叉搜索树，将该二叉搜索树转换成一个排序的循环双向链表。要求不能创建任何新的节点，只能调整树中节点指针的指向。 </p><p>为了让您更好地理解问题，以下面的二叉搜索树为例：</p><p><img src="https://assets.leetcode.com/uploads/2018/10/12/bstdlloriginalbst.png" alt="img"></p><p>我们希望将这个二叉搜索树转化为双向循环链表。链表中的每个节点都有一个前驱和后继指针。对于双向循环链表，第一个节点的前驱是最后一个节点，最后一个节点的后继是第一个节点。</p><p>下图展示了上面的二叉搜索树转化成的链表。“head” 表示指向链表中有最小元素的节点。</p><p><img src="https://assets.leetcode.com/uploads/2018/10/12/bstdllreturndll.png" alt="img"></p><p>特别地，我们希望可以就地完成转换操作。当转化完成以后，树中节点的左指针需要指向前驱，树中节点的右指针需要指向后继。还需要返回链表中的第一个节点的指针。</p><p> <strong>思路和代码：</strong> </p><p> 是二叉搜索树，使用中序遍历从小到大遍历即可，每次遍历的时候把当前节点的left指向前一个节点，把前一个节点的right指向当前节点。 </p><p>遍历到的第一个节点就是最小节点，此时head就是它，从第二个节点开始操作，每次更新pre。</p><p>遍历完之后pre就是最后一个节点，再把它和head连起来。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    Node pre, head;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> Node <span class="title">treeToDoublyList</span><span class="params">(Node root)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(root == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="keyword">null</span>;</span><br><span class="line">        dfs(root);</span><br><span class="line">        head.left = pre;</span><br><span class="line">        pre.right = head;</span><br><span class="line">        <span class="keyword">return</span> head;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">dfs</span><span class="params">(Node cur)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(cur == <span class="keyword">null</span>) </span><br><span class="line">            <span class="keyword">return</span>;</span><br><span class="line">        dfs(cur.left);</span><br><span class="line">        <span class="keyword">if</span>(pre == <span class="keyword">null</span>)</span><br><span class="line">            <span class="comment">//第一次操作的节点就是头节点</span></span><br><span class="line">            head = cur;</span><br><span class="line">        <span class="keyword">else</span></span><br><span class="line">            pre.right = cur;</span><br><span class="line">        cur.left = pre;</span><br><span class="line">        pre = cur;</span><br><span class="line">        dfs(cur.right);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题-37-序列化二叉树"><a href="#面试题-37-序列化二叉树" class="headerlink" title="面试题 37. 序列化二叉树"></a><a href="https://leetcode-cn.com/problems/xu-lie-hua-er-cha-shu-lcof/" target="_blank" rel="noopener">面试题 37. 序列化二叉树</a></h4><p>请实现两个函数，分别用来序列化和反序列化二叉树。</p><p><strong>示例:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">你可以将以下二叉树：</span><br><span class="line"></span><br><span class="line">    <span class="number">1</span></span><br><span class="line">   / \</span><br><span class="line">  <span class="number">2</span>   <span class="number">3</span></span><br><span class="line">     / \</span><br><span class="line">    <span class="number">4</span>   <span class="number">5</span></span><br><span class="line"></span><br><span class="line">序列化为 <span class="string">"[1,2,3,null,null,4,5]"</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>层序遍历BFS，只附代码参考</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Codec</span> </span>&#123;</span><br><span class="line">    </span><br><span class="line">    <span class="function"><span class="keyword">public</span> String <span class="title">serialize</span><span class="params">(TreeNode root)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(root == <span class="keyword">null</span>) <span class="keyword">return</span> <span class="string">"[]"</span>;</span><br><span class="line">        StringBuilder res = <span class="keyword">new</span> StringBuilder(<span class="string">"["</span>);</span><br><span class="line">        Queue&lt;TreeNode&gt; queue = <span class="keyword">new</span> LinkedList&lt;&gt;() &#123;&#123; add(root); &#125;&#125;;</span><br><span class="line">        <span class="keyword">while</span>(!queue.isEmpty()) &#123;</span><br><span class="line">            TreeNode node = queue.poll();</span><br><span class="line">            <span class="keyword">if</span>(node != <span class="keyword">null</span>) &#123;</span><br><span class="line">                res.append(node.val + <span class="string">","</span>);</span><br><span class="line">                queue.add(node.left);</span><br><span class="line">                queue.add(node.right);</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="keyword">else</span> res.append(<span class="string">"null,"</span>);</span><br><span class="line">        &#125;</span><br><span class="line">        res.deleteCharAt(res.length() - <span class="number">1</span>);</span><br><span class="line">        res.append(<span class="string">"]"</span>);</span><br><span class="line">        <span class="keyword">return</span> res.toString();</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> TreeNode <span class="title">deserialize</span><span class="params">(String data)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(data.equals(<span class="string">"[]"</span>)) <span class="keyword">return</span> <span class="keyword">null</span>;</span><br><span class="line">        String[] vals = data.substring(<span class="number">1</span>, data.length() - <span class="number">1</span>).split(<span class="string">","</span>);</span><br><span class="line">        TreeNode root = <span class="keyword">new</span> TreeNode(Integer.parseInt(vals[<span class="number">0</span>]));</span><br><span class="line">        Queue&lt;TreeNode&gt; queue = <span class="keyword">new</span> LinkedList&lt;&gt;() &#123;&#123; add(root); &#125;&#125;;</span><br><span class="line">        <span class="keyword">int</span> i = <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">while</span>(!queue.isEmpty()) &#123;</span><br><span class="line">            TreeNode node = queue.poll();</span><br><span class="line">            <span class="keyword">if</span>(!vals[i].equals(<span class="string">"null"</span>)) &#123;</span><br><span class="line">                node.left = <span class="keyword">new</span> TreeNode(Integer.parseInt(vals[i]));</span><br><span class="line">                queue.add(node.left);</span><br><span class="line">            &#125;</span><br><span class="line">            i++;</span><br><span class="line">            <span class="keyword">if</span>(!vals[i].equals(<span class="string">"null"</span>)) &#123;</span><br><span class="line">                node.right = <span class="keyword">new</span> TreeNode(Integer.parseInt(vals[i]));</span><br><span class="line">                queue.add(node.right);</span><br><span class="line">            &#125;</span><br><span class="line">            i++;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> root;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题38-字符串的排列"><a href="#面试题38-字符串的排列" class="headerlink" title="面试题38. 字符串的排列"></a><a href="https://leetcode-cn.com/problems/zi-fu-chuan-de-pai-lie-lcof/" target="_blank" rel="noopener">面试题38. 字符串的排列</a></h4><p>输入一个字符串，打印出该字符串中字符的所有排列。</p><p>你可以以任意顺序返回这个字符串数组，但里面不能有重复元素。</p><p> <strong>示例:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：s = <span class="string">"abc"</span></span><br><span class="line">输出：[<span class="string">"abc"</span>,<span class="string">"acb"</span>,<span class="string">"bac"</span>,<span class="string">"bca"</span>,<span class="string">"cab"</span>,<span class="string">"cba"</span>]</span><br></pre></td></tr></table></figure><p><strong>思路和代码：</strong></p><p>简单的回溯思想，重复方案与剪枝： 当字符串存在重复字符时，排列方案中也存在重复方案。为排除重复方案，需在固定某位字符时，保证 “每种字符只在此位固定一次” ，即遇到重复字符时不交换，直接跳过。从 DFS 角度看，此操作称为 “剪枝” 。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    List&lt;String&gt; res = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    <span class="keyword">char</span>[] c;</span><br><span class="line">    <span class="keyword">public</span> String[] permutation(String s) &#123;</span><br><span class="line">        c =s.toCharArray();</span><br><span class="line">        backtrack(<span class="number">0</span>);</span><br><span class="line">        <span class="keyword">return</span> res.toArray(<span class="keyword">new</span> String[res.size()]);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">backtrack</span><span class="params">(<span class="keyword">int</span> start)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(start == c.length-<span class="number">1</span>)&#123;</span><br><span class="line">            res.add(String.valueOf(c));</span><br><span class="line">            <span class="keyword">return</span>;    </span><br><span class="line">        &#125;</span><br><span class="line">        HashSet&lt;Character&gt; set = <span class="keyword">new</span> HashSet&lt;&gt;();</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=start; i&lt;c.length; i++) &#123;</span><br><span class="line">            <span class="keyword">if</span>(set.contains(c[i]))</span><br><span class="line">                <span class="keyword">continue</span>;</span><br><span class="line">            set.add(c[i]);</span><br><span class="line">            swap(i,start);</span><br><span class="line">            backtrack(start+<span class="number">1</span>);</span><br><span class="line">            swap(start,i);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">swap</span><span class="params">(<span class="keyword">int</span> i, <span class="keyword">int</span> j)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">char</span> tmp = c[i];</span><br><span class="line">        c[i] = c[j];</span><br><span class="line">        c[j] = tmp;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题39-数组中出现次数超过一半的数字"><a href="#面试题39-数组中出现次数超过一半的数字" class="headerlink" title="面试题39. 数组中出现次数超过一半的数字"></a><a href="https://leetcode-cn.com/problems/shu-zu-zhong-chu-xian-ci-shu-chao-guo-yi-ban-de-shu-zi-lcof/" target="_blank" rel="noopener">面试题39. 数组中出现次数超过一半的数字</a></h4><p>数组中有一个数字出现的次数超过数组长度的一半，请找出这个数字。</p><p>你可以假设数组是非空的，并且给定的数组总是存在多数元素。</p><p> <strong>示例 1:</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入: [<span class="number">1</span>, <span class="number">2</span>, <span class="number">3</span>, <span class="number">2</span>, <span class="number">2</span>, <span class="number">2</span>, <span class="number">5</span>, <span class="number">4</span>, <span class="number">2</span>]</span><br><span class="line">输出: <span class="number">2</span></span><br></pre></td></tr></table></figure><p><strong>限制：</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line"><span class="number">1</span> &lt;= 数组长度 &lt;= <span class="number">50000</span></span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p>摩尔投票法：</p><ul><li>票数和： 由于众数出现的次数超过数组长度的一半；若记 众数 的票数为 <code>+1</code> ，非众数 的票数为 <code>-1</code> ，则一定有所有数字的 票数和 <code>&gt; 0</code> 。</li><li>票数正负抵消： 设数组 <code>nums</code> 中的众数为 <code>x</code> ，数组长度为 <code>n</code> 。若 nums 的前 <code>a</code> 个数字的 票数和 <code>= 0</code> ，则 数组后 <code>(n-a)</code> 个数字的 票数和一定仍 <code>&gt; 0</code> （即后 <code>(n−a)</code> 个数字的 众数仍为 <code>x</code>)。</li></ul><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">majorityElement</span><span class="params">(<span class="keyword">int</span>[] nums)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> cnt = <span class="number">0</span>, res = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> num : nums) &#123;</span><br><span class="line">            <span class="keyword">if</span>(cnt == <span class="number">0</span>) </span><br><span class="line">                res = num;</span><br><span class="line">            <span class="keyword">if</span>(res == num) </span><br><span class="line">                cnt++;</span><br><span class="line">            <span class="keyword">else</span> </span><br><span class="line">                cnt--;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="面试题40-最小的k个数"><a href="#面试题40-最小的k个数" class="headerlink" title="面试题40. 最小的k个数"></a><a href="https://leetcode-cn.com/problems/zui-xiao-de-kge-shu-lcof/" target="_blank" rel="noopener">面试题40. 最小的k个数</a></h4><p> 输入整数数组 <code>arr</code> ，找出其中最小的 <code>k</code> 个数。例如，输入4、5、1、6、2、7、3、8这8个数字，则最小的4个数字是1、2、3、4。 </p><p> <strong>示例 1：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：arr = [<span class="number">3</span>,<span class="number">2</span>,<span class="number">1</span>], k = <span class="number">2</span></span><br><span class="line">输出：[<span class="number">1</span>,<span class="number">2</span>] 或者 [<span class="number">2</span>,<span class="number">1</span>]</span><br></pre></td></tr></table></figure><p> <strong>示例 2：</strong> </p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">输入：arr = [<span class="number">0</span>,<span class="number">1</span>,<span class="number">2</span>,<span class="number">1</span>], k = <span class="number">1</span></span><br><span class="line">输出：[<span class="number">0</span>]</span><br></pre></td></tr></table></figure><p> <strong>思路和代码：</strong> </p><p><a href="https://leetcode-cn.com/problems/zui-xiao-de-kge-shu-lcof/solution/3chong-jie-fa-miao-sha-topkkuai-pai-dui-er-cha-sou/" target="_blank" rel="noopener">TopK问题解决方案</a></p><p>总结的很好</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">//计数排序的方法</span></span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] getLeastNumbers(<span class="keyword">int</span>[] arr, <span class="keyword">int</span> k) &#123;</span><br><span class="line">        <span class="keyword">if</span>(arr.length == <span class="number">0</span> || k == <span class="number">0</span>) <span class="keyword">return</span> <span class="keyword">new</span> <span class="keyword">int</span>[<span class="number">0</span>];</span><br><span class="line">        <span class="keyword">int</span>[] cnt = <span class="keyword">new</span> <span class="keyword">int</span>[<span class="number">10001</span>];</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> num : arr) &#123;</span><br><span class="line">            cnt[num]++;</span><br><span class="line">        &#125; </span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[k];</span><br><span class="line">        <span class="keyword">int</span> index = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;cnt.length; i++) &#123;</span><br><span class="line">            <span class="keyword">while</span>(cnt[i]-- &gt; <span class="number">0</span> &amp;&amp; index &lt; k) &#123;</span><br><span class="line">                res[index++] = i;</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="keyword">if</span>(index == k)</span><br><span class="line">                <span class="keyword">break</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;剑指Offer题解（3-40）&quot;&gt;&lt;a href=&quot;#剑指Offer题解（3-40）&quot; class=&quot;headerlink&quot; title=&quot;剑指Offer题解（3-40）&quot;&gt;&lt;/a&gt;剑指Offer题解（3-40）&lt;/h2&gt;&lt;h4 id=&quot;面试题03-数组中重复的数字&quot;&gt;&lt;a href=&quot;#面试题03-数组中重复的数字&quot; class=&quot;headerlink&quot; title=&quot;面试题03. 数组中重复的数字&quot;&gt;&lt;/a&gt;&lt;a href=&quot;https://leetcode-cn.com/problems/shu-zu-zhong-zhong-fu-de-shu-zi-lcof/&quot; target=&quot;_blank&quot; rel=&quot;noopener&quot;&gt;面试题03. 数组中重复的数字&lt;/a&gt;&lt;/h4&gt;&lt;p&gt;找出数组中重复的数字。&lt;br&gt;在一个长度为 n 的数组 nums 里的所有数字都在 0～n-1 的范围内。数组中某些数字是重复的，但不知道有几个数字重复了，也不知道每个数字重复了几次。请找出数组中任意一个重复的数字。&lt;/p&gt;
&lt;p&gt; &lt;strong&gt;示例 1：&lt;/strong&gt; &lt;/p&gt;
&lt;figure class=&quot;highlight java&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;3&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;输入：&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;[&lt;span class=&quot;number&quot;&gt;2&lt;/span&gt;, &lt;span class=&quot;number&quot;&gt;3&lt;/span&gt;, &lt;span class=&quot;number&quot;&gt;1&lt;/span&gt;, &lt;span class=&quot;number&quot;&gt;0&lt;/span&gt;, &lt;span class=&quot;number&quot;&gt;2&lt;/span&gt;, &lt;span class=&quot;number&quot;&gt;5&lt;/span&gt;, &lt;span class=&quot;number&quot;&gt;3&lt;/span&gt;]&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;输出：&lt;span class=&quot;number&quot;&gt;2&lt;/span&gt; 或 &lt;span class=&quot;number&quot;&gt;3&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;p&gt; &lt;strong&gt;思路和代码：&lt;/strong&gt; &lt;/p&gt;
&lt;figure class=&quot;highlight java&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;3&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;4&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;5&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;6&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;7&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;8&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;9&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;10&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;11&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;12&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;13&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;14&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;15&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;16&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;class&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;class&lt;/span&gt; &lt;span class=&quot;title&quot;&gt;Solution&lt;/span&gt; &lt;/span&gt;&amp;#123;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;    &lt;span class=&quot;function&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;public&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;int&lt;/span&gt; &lt;span class=&quot;title&quot;&gt;findRepeateNumber&lt;/span&gt;&lt;span class=&quot;params&quot;&gt;(&lt;span class=&quot;keyword&quot;&gt;int&lt;/span&gt;[] nums)&lt;/span&gt; &lt;/span&gt;&amp;#123;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;        &lt;span class=&quot;keyword&quot;&gt;for&lt;/span&gt;(&lt;span class=&quot;keyword&quot;&gt;int&lt;/span&gt; i=&lt;span class=&quot;number&quot;&gt;0&lt;/span&gt;; i&amp;lt;nums.length; i++) &amp;#123;	&lt;span class=&quot;comment&quot;&gt;//如果当前值不是当前索引对应的值&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;            &lt;span class=&quot;keyword&quot;&gt;while&lt;/span&gt;(nums[i] != i) &amp;#123;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;                &lt;span class=&quot;keyword&quot;&gt;int&lt;/span&gt; cur = nums[i];&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;                &lt;span class=&quot;keyword&quot;&gt;if&lt;/span&gt;(nums[cur] = cur)	&lt;span class=&quot;comment&quot;&gt;//当前值对应的索引是否已经存有了当前值，如果是说明重复&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;                    &lt;span class=&quot;keyword&quot;&gt;return&lt;/span&gt; cur;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;                &lt;span class=&quot;keyword&quot;&gt;else&lt;/span&gt; &amp;#123;			&lt;span class=&quot;comment&quot;&gt;//如果不是，就将当前值放到自己对应的索引，将自己对应索引的值放过来&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;                    nums[i] = nums[cur];&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;                    nums[cur] = cur;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;                &amp;#125;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;            &amp;#125;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;        &amp;#125;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;        &lt;span class=&quot;keyword&quot;&gt;return&lt;/span&gt; &lt;span class=&quot;number&quot;&gt;0&lt;/span&gt;;		&lt;span class=&quot;comment&quot;&gt;//没找到，返回0（随便返回一个数即可）&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;    &amp;#125;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&amp;#125;&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;
    
    </summary>
    
    
      <category term="leetcode" scheme="https://zrbac.github.io/categories/leetcode/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>浅拷贝与深拷贝</title>
    <link href="https://zrbac.github.io/2020/08/27/%E6%B5%85%E6%8B%B7%E8%B4%9D%E4%B8%8E%E6%B7%B1%E6%8B%B7%E8%B4%9D/"/>
    <id>https://zrbac.github.io/2020/08/27/%E6%B5%85%E6%8B%B7%E8%B4%9D%E4%B8%8E%E6%B7%B1%E6%8B%B7%E8%B4%9D/</id>
    <published>2020-08-27T03:17:14.000Z</published>
    <updated>2020-08-27T03:18:25.420Z</updated>
    
    <content type="html"><![CDATA[<h1 id="值类型-vs-引用类型"><a href="#值类型-vs-引用类型" class="headerlink" title="值类型 vs 引用类型"></a>值类型 vs 引用类型</h1><p>这两个概念的准确区分，对于深、浅拷贝问题的理解非常重要。</p><p>正如<code>Java</code>圣经《<code>Java</code>编程思想》第二章的标题所言，在<code>Java</code>中一切都可以视为对象！</p><p>所以来到<code>Java</code>的世界，我们要习惯用引用去操作对象。在<code>Java</code>中，像数组、类<code>Class</code>、枚举<code>Enum</code>、<code>Integer</code>包装类等等，就是典型的引用类型，所以操作时采用的也是<strong>引用传递</strong>的方式；</p><p>但是<code>Java</code>的语言级基础数据类型，诸如<code>int</code>这些基本类型，操作时一般采取的则是<strong>值传递</strong>的方式，所以有时候也称它为值类型。</p><a id="more"></a><p>为了便于下文的讲述和举例，我们这里先定义两个类：<code>Student</code>和<code>Major</code>，分别表示「学生」以及「所学的专业」，二者是包含关系：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// 学生的所学专业</span></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Major</span> </span>&#123;</span><br><span class="line">    <span class="keyword">private</span> String majorName; <span class="comment">// 专业名称</span></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">long</span> majorId;     <span class="comment">// 专业代号</span></span><br><span class="line">    </span><br><span class="line">    <span class="comment">// ... 其他省略 ...</span></span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="comment">// 学生</span></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Student</span> </span>&#123;</span><br><span class="line">    <span class="keyword">private</span> String name;  <span class="comment">// 姓名</span></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">int</span> age;      <span class="comment">// 年龄</span></span><br><span class="line">    <span class="keyword">private</span> Major major;  <span class="comment">// 所学专业</span></span><br><span class="line">    </span><br><span class="line">    <span class="comment">// ... 其他省略 ...</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><img src="http://qiniu.zrbac.fun/30.png" alt="img"></p><hr><h1 id="赋值-vs-浅拷贝-vs-深拷贝"><a href="#赋值-vs-浅拷贝-vs-深拷贝" class="headerlink" title="赋值 vs 浅拷贝 vs 深拷贝"></a>赋值 vs 浅拷贝 vs 深拷贝</h1><h2 id="对象赋值"><a href="#对象赋值" class="headerlink" title="对象赋值"></a><strong>对象赋值</strong></h2><p>赋值是日常编程过程中最常见的操作，最简单的比如：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">Student codeSheep = <span class="keyword">new</span> Student();</span><br><span class="line">Student codePig = codeSheep;</span><br></pre></td></tr></table></figure><p>严格来说，这种不能算是对象拷贝，因为拷贝的仅仅只是引用关系，并没有生成新的实际对象：</p><p><img src="http://qiniu.zrbac.fun/31.png" alt="img"></p><h2 id="浅拷贝"><a href="#浅拷贝" class="headerlink" title="浅拷贝"></a><strong>浅拷贝</strong></h2><p>浅拷贝属于对象克隆方式的一种，重要的特性体现在这个 <strong>「浅」</strong> 字上。</p><p>比如我们试图通过<code>studen1</code>实例，拷贝得到<code>student2</code>，如果是浅拷贝这种方式，大致模型可以示意成如下所示的样子：</p><p><img src="http://qiniu.zrbac.fun/32.png" alt="img"></p><p>很明显，<strong>值类型</strong>的字段会复制一份，而<strong>引用类型</strong>的字段拷贝的仅仅是引用地址，而该引用地址指向的实际对象空间其实只有一份。</p><p>一图胜前言，我想上面这个图已经表现得很清楚了。</p><h2 id="深拷贝"><a href="#深拷贝" class="headerlink" title="深拷贝"></a><strong>深拷贝</strong></h2><p>深拷贝相较于上面所示的浅拷贝，除了值类型字段会复制一份，引用类型字段所指向的对象，会在内存中也<strong>创建一个副本</strong>，就像这个样子：</p><p>!<img src="http://qiniu.zrbac.fun/33.png" alt="img"></p><p>原理很清楚明了，下面来看看具体的代码实现吧。</p><hr><h1 id="浅拷贝代码实现"><a href="#浅拷贝代码实现" class="headerlink" title="浅拷贝代码实现"></a>浅拷贝代码实现</h1><p>还以上文的例子来讲，我想通过<code>student1</code>拷贝得到<code>student2</code>，浅拷贝的典型实现方式是：让被复制对象的类实现<code>Cloneable</code>接口，并重写<code>clone()</code>方法即可。</p><p>以上面的<code>Student</code>类拷贝为例：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Student</span> <span class="keyword">implements</span> <span class="title">Cloneable</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">private</span> String name;  <span class="comment">// 姓名</span></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">int</span> age;      <span class="comment">// 年龄</span></span><br><span class="line">    <span class="keyword">private</span> Major major;  <span class="comment">// 所学专业</span></span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> Object <span class="title">clone</span><span class="params">()</span> <span class="keyword">throws</span> CloneNotSupportedException </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">super</span>.clone();</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="comment">// ... 其他省略 ...</span></span><br><span class="line"></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>然后我们写个测试代码，一试便知：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Test</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> <span class="keyword">throws</span> CloneNotSupportedException </span>&#123;</span><br><span class="line"></span><br><span class="line">        Major m = <span class="keyword">new</span> Major(<span class="string">"计算机科学与技术"</span>,<span class="number">666666</span>);</span><br><span class="line">        Student student1 = <span class="keyword">new</span> Student( <span class="string">"CodeSheep"</span>, <span class="number">18</span>, m );</span><br><span class="line">        </span><br><span class="line">        <span class="comment">// 由 student1 拷贝得到 student2</span></span><br><span class="line">        Student student2 = (Student) student1.clone();</span><br><span class="line"></span><br><span class="line">        System.out.println( student1 == student2 );</span><br><span class="line">        System.out.println( student1 );</span><br><span class="line">        System.out.println( student2 );</span><br><span class="line">        System.out.println( <span class="string">"\n"</span> );</span><br><span class="line"></span><br><span class="line">        <span class="comment">// 修改student1的值类型字段</span></span><br><span class="line">        student1.setAge( <span class="number">35</span> );</span><br><span class="line">        </span><br><span class="line">        <span class="comment">// 修改student1的引用类型字段</span></span><br><span class="line">        m.setMajorName( <span class="string">"电子信息工程"</span> );</span><br><span class="line">        m.setMajorId( <span class="number">888888</span> );</span><br><span class="line"></span><br><span class="line">        System.out.println( student1 );</span><br><span class="line">        System.out.println( student2 );</span><br><span class="line"></span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>运行得到如下结果：</p><p><img src="http://qiniu.zrbac.fun/34.png" alt="img"></p><p>从结果可以看出：</p><ul><li><code>student1==student2</code>打印false，说明<code>clone()</code>方法的确克隆出了一个新对象；</li><li>修改值类型字段并不影响克隆出来的新对象，符合预期；</li><li>而修改了<code>student1</code>内部的引用对象，克隆对象<code>student2</code>也受到了波及，说明内部还是关联在一起的</li></ul><hr><h1 id="深拷贝代码实现"><a href="#深拷贝代码实现" class="headerlink" title="深拷贝代码实现"></a>深拷贝代码实现</h1><h2 id="深度遍历式拷贝"><a href="#深度遍历式拷贝" class="headerlink" title="深度遍历式拷贝"></a><strong>深度遍历式拷贝</strong></h2><p>虽然<code>clone()</code>方法可以完成对象的拷贝工作，但是注意：<code>clone()</code>方法默认是浅拷贝行为，就像上面的例子一样。若想实现深拷贝需覆写 <code>clone()</code>方法实现引用对象的深度遍历式拷贝，进行地毯式搜索。</p><p>所以对于上面的例子，如果想实现深拷贝，首先需要对更深一层次的引用类<code>Major</code>做改造，让其也实现<code>Cloneable</code>接口并重写<code>clone()</code>方法：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Major</span> <span class="keyword">implements</span> <span class="title">Cloneable</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="function"><span class="keyword">protected</span> Object <span class="title">clone</span><span class="params">()</span> <span class="keyword">throws</span> CloneNotSupportedException </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">super</span>.clone();</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="comment">// ... 其他省略 ...</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>其次我们还需要在<strong>顶层的</strong>调用类中重写<code>clone</code>方法，来调用引用类型字段的<code>clone()</code>方法实现深度拷贝，对应到本文那就是<code>Student</code>类：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Student</span> <span class="keyword">implements</span> <span class="title">Cloneable</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> Object <span class="title">clone</span><span class="params">()</span> <span class="keyword">throws</span> CloneNotSupportedException </span>&#123;</span><br><span class="line">        Student student = (Student) <span class="keyword">super</span>.clone();</span><br><span class="line">        student.major = (Major) major.clone(); <span class="comment">// 重要！！！</span></span><br><span class="line">        <span class="keyword">return</span> student;</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="comment">// ... 其他省略 ...</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这时候上面的测试用例不变，运行可得结果：</p><p><img src="http://qiniu.zrbac.fun/35.png" alt="img"></p><p>很明显，这时候<code>student1</code>和<code>student2</code>两个对象就完全独立了，不受互相的干扰。</p><h2 id="利用反序列化实现深拷贝"><a href="#利用反序列化实现深拷贝" class="headerlink" title="利用反序列化实现深拷贝"></a><strong>利用反序列化实现深拷贝</strong></h2><p>利用反序列化技术，我们也可以从一个对象深拷贝出另一个复制对象，而且这货在解决多层套娃式的深拷贝问题时效果出奇的好。</p><p>所以我们这里改造一下<code>Student</code>类，让其<code>clone()</code>方法通过序列化和反序列化的方式来生成一个原对象的深拷贝副本：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Student</span> <span class="keyword">implements</span> <span class="title">Serializable</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">private</span> String name;  <span class="comment">// 姓名</span></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">int</span> age;      <span class="comment">// 年龄</span></span><br><span class="line">    <span class="keyword">private</span> Major major;  <span class="comment">// 所学专业</span></span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> Student <span class="title">clone</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        <span class="keyword">try</span> &#123;</span><br><span class="line">            <span class="comment">// 将对象本身序列化到字节流</span></span><br><span class="line">            ByteArrayOutputStream byteArrayOutputStream = <span class="keyword">new</span> ByteArrayOutputStream();</span><br><span class="line">            ObjectOutputStream objectOutputStream =</span><br><span class="line">                    <span class="keyword">new</span> ObjectOutputStream( byteArrayOutputStream );</span><br><span class="line">            objectOutputStream.writeObject( <span class="keyword">this</span> );</span><br><span class="line"></span><br><span class="line">            <span class="comment">// 再将字节流通过反序列化方式得到对象副本</span></span><br><span class="line">            ObjectInputStream objectInputStream =</span><br><span class="line">                    <span class="keyword">new</span> ObjectInputStream( <span class="keyword">new</span> ByteArrayInputStream( byteArrayOutputStream.toByteArray() ) );</span><br><span class="line">            <span class="keyword">return</span> (Student) objectInputStream.readObject();</span><br><span class="line"></span><br><span class="line">        &#125; <span class="keyword">catch</span> (IOException e) &#123;</span><br><span class="line">            e.printStackTrace();</span><br><span class="line">        &#125; <span class="keyword">catch</span> (ClassNotFoundException e) &#123;</span><br><span class="line">            e.printStackTrace();</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">null</span>;</span><br><span class="line">    &#125;</span><br><span class="line">    </span><br><span class="line">    <span class="comment">// ... 其他省略 ...</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>当然这种情况下要求被引用的子类（比如这里的<code>Major</code>类）也必须是可以序列化的，即实现了<code>Serializable</code>接口：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Major</span> <span class="keyword">implements</span> <span class="title">Serializable</span> </span>&#123;    </span><br><span class="line">    <span class="comment">// ... 其他省略 ...    </span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这时候测试用例完全不变，直接运行，也可以得到如下结果：</p><p><img src="http://qiniu.zrbac.fun/35.png" alt="img"></p><p>很明显，这时候<code>student1</code>和<code>student2</code>两个对象也是完全独立的，不受互相的干扰，深拷贝完成。</p>]]></content>
    
    <summary type="html">
    
      &lt;h1 id=&quot;值类型-vs-引用类型&quot;&gt;&lt;a href=&quot;#值类型-vs-引用类型&quot; class=&quot;headerlink&quot; title=&quot;值类型 vs 引用类型&quot;&gt;&lt;/a&gt;值类型 vs 引用类型&lt;/h1&gt;&lt;p&gt;这两个概念的准确区分，对于深、浅拷贝问题的理解非常重要。&lt;/p&gt;
&lt;p&gt;正如&lt;code&gt;Java&lt;/code&gt;圣经《&lt;code&gt;Java&lt;/code&gt;编程思想》第二章的标题所言，在&lt;code&gt;Java&lt;/code&gt;中一切都可以视为对象！&lt;/p&gt;
&lt;p&gt;所以来到&lt;code&gt;Java&lt;/code&gt;的世界，我们要习惯用引用去操作对象。在&lt;code&gt;Java&lt;/code&gt;中，像数组、类&lt;code&gt;Class&lt;/code&gt;、枚举&lt;code&gt;Enum&lt;/code&gt;、&lt;code&gt;Integer&lt;/code&gt;包装类等等，就是典型的引用类型，所以操作时采用的也是&lt;strong&gt;引用传递&lt;/strong&gt;的方式；&lt;/p&gt;
&lt;p&gt;但是&lt;code&gt;Java&lt;/code&gt;的语言级基础数据类型，诸如&lt;code&gt;int&lt;/code&gt;这些基本类型，操作时一般采取的则是&lt;strong&gt;值传递&lt;/strong&gt;的方式，所以有时候也称它为值类型。&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>ArrayList源码分析</title>
    <link href="https://zrbac.github.io/2020/08/25/ArrayList%E6%BA%90%E7%A0%81%E5%88%86%E6%9E%90/"/>
    <id>https://zrbac.github.io/2020/08/25/ArrayList%E6%BA%90%E7%A0%81%E5%88%86%E6%9E%90/</id>
    <published>2020-08-25T03:29:49.000Z</published>
    <updated>2020-08-25T03:30:54.268Z</updated>
    
    <content type="html"><![CDATA[<h1 id="ArrayList源码分析"><a href="#ArrayList源码分析" class="headerlink" title="ArrayList源码分析"></a>ArrayList源码分析</h1><h2 id="类图"><a href="#类图" class="headerlink" title="类图"></a>类图</h2><p><img src="http://qiniu.zrbac.fun/26.png" alt="img"></p><ul><li>实现了<code>RandomAccess</code>接口，可以随机访问</li><li>实现了<code>Cloneable</code>接口，可以克隆</li><li>实现了<code>Serializable</code>接口，可以序列化、反序列化</li><li>实现了<code>List</code>接口，是<code>List</code>的实现类之一</li><li>实现了<code>Collection</code>接口，是<code>Java Collections Framework</code>成员之一</li><li>实现了<code>Iterable</code>接口，可以使用<code>for-each</code>迭代</li></ul><h2 id="属性"><a href="#属性" class="headerlink" title="属性"></a>属性</h2><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// 序列化版本UID</span></span><br><span class="line"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">final</span> <span class="keyword">long</span></span><br><span class="line">        serialVersionUID = <span class="number">8683452581122892189L</span>;</span><br><span class="line"></span><br><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 默认的初始容量</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">final</span> <span class="keyword">int</span></span><br><span class="line">        DEFAULT_CAPACITY = <span class="number">10</span>;</span><br><span class="line"></span><br><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 用于空实例的共享空数组实例</span></span><br><span class="line"><span class="comment"> * new ArrayList(0);</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">final</span> Object[]</span><br><span class="line">        EMPTY_ELEMENTDATA = &#123;&#125;;</span><br><span class="line"></span><br><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 用于提供默认大小的实例的共享空数组实例</span></span><br><span class="line"><span class="comment"> * new ArrayList();</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">final</span> Object[]</span><br><span class="line">        DEFAULTCAPACITY_EMPTY_ELEMENTDATA = &#123;&#125;;</span><br><span class="line"></span><br><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 存储ArrayList元素的数组缓冲区</span></span><br><span class="line"><span class="comment"> * ArrayList的容量，是数组的长度</span></span><br><span class="line"><span class="comment"> * </span></span><br><span class="line"><span class="comment"> * non-private to simplify nested class access</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="keyword">transient</span> Object[] elementData;</span><br><span class="line"></span><br><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * ArrayList中元素的数量</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="keyword">private</span> <span class="keyword">int</span> size;</span><br></pre></td></tr></table></figure><a id="more"></a><ol><li>为什么空实例默认数组有的时候是<code>EMPTY_ELEMENTDATA</code>，而又有的时候是<code>DEFAULTCAPACITY_EMPTY_ELEMENTDATA</code></li><li>为什么<code>elementData</code>要被<code>transient</code>修饰</li><li>为什么<code>elementData</code>没有被<code>private</code>修饰？难道正如注释所写的<strong>non-private to simplify nested class access</strong></li></ol><h2 id="构造方法"><a href="#构造方法" class="headerlink" title="构造方法"></a>构造方法</h2><h3 id="带初始容量的构造方法"><a href="#带初始容量的构造方法" class="headerlink" title="带初始容量的构造方法"></a>带初始容量的构造方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 带一个初始容量参数的构造方法</span></span><br><span class="line"><span class="comment"> *</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span>  initialCapacity  初始容量</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@throws</span>  如果初始容量非法就抛出</span></span><br><span class="line"><span class="comment"> *          IllegalArgumentException</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="title">ArrayList</span><span class="params">(<span class="keyword">int</span> initialCapacity)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span> (initialCapacity &gt; <span class="number">0</span>) &#123;</span><br><span class="line">        <span class="keyword">this</span>.elementData =</span><br><span class="line">                <span class="keyword">new</span> Object[initialCapacity];</span><br><span class="line">    &#125; <span class="keyword">else</span> <span class="keyword">if</span> (initialCapacity == <span class="number">0</span>) &#123;</span><br><span class="line">        <span class="keyword">this</span>.elementData = EMPTY_ELEMENTDATA;</span><br><span class="line">    &#125; <span class="keyword">else</span> &#123;</span><br><span class="line">        <span class="keyword">throw</span> <span class="keyword">new</span> IllegalArgumentException(</span><br><span class="line">                <span class="string">"Illegal Capacity: "</span>+ initialCapacity);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><ul><li>如果<code>initialCapacity &lt; 0</code>，就创建一个新的长度是<code>initialCapacity</code>的数组</li><li>如果<code>initialCapacity == 0</code>，就使用EMPTY_ELEMENTDATA</li><li>其他情况，<code>initialCapacity</code>不合法，抛出异常</li></ul><h3 id="无参构造方法"><a href="#无参构造方法" class="headerlink" title="无参构造方法"></a>无参构造方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 无参构造方法 将elementData 赋值为</span></span><br><span class="line"><span class="comment"> *   DEFAULTCAPACITY_EMPTY_ELEMENTDATA</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="title">ArrayList</span><span class="params">()</span> </span>&#123;</span><br><span class="line">    <span class="keyword">this</span>.elementData =</span><br><span class="line">            DEFAULTCAPACITY_EMPTY_ELEMENTDATA;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="带一个集合参数的构造方法"><a href="#带一个集合参数的构造方法" class="headerlink" title="带一个集合参数的构造方法"></a>带一个集合参数的构造方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 带一个集合参数的构造方法</span></span><br><span class="line"><span class="comment"> *</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span> c 集合，代表集合中的元素会被放到list中</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@throws</span> 如果集合为空，抛出NullPointerException</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="title">ArrayList</span><span class="params">(Collection&lt;? extends E&gt; c)</span> </span>&#123;</span><br><span class="line">    elementData = c.toArray();</span><br><span class="line">    <span class="comment">// 如果 size != 0</span></span><br><span class="line">    <span class="keyword">if</span> ((size = elementData.length) != <span class="number">0</span>) &#123;</span><br><span class="line">        <span class="comment">// c.toArray 可能不正确的，不返回 Object[]</span></span><br><span class="line">        <span class="comment">// https://bugs.openjdk.java.net/browse/JDK-6260652</span></span><br><span class="line">        <span class="keyword">if</span> (elementData.getClass() != Object[].class)</span><br><span class="line">            elementData = Arrays.copyOf(</span><br><span class="line">                    elementData, size, Object[].class);</span><br><span class="line">    &#125; <span class="keyword">else</span> &#123;</span><br><span class="line">        <span class="comment">// size == 0</span></span><br><span class="line">        <span class="comment">// 将EMPTY_ELEMENTDATA 赋值给 elementData</span></span><br><span class="line">        <span class="keyword">this</span>.elementData = EMPTY_ELEMENTDATA;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><ul><li>使用将集合转换为数组的方法</li><li>为了防止<code>c.toArray()</code>方法不正确的执行，导致没有返回<code>Object[]</code>，特殊做了处理</li><li>如果数组大小等于<code>0</code>，则使用 <code>EMPTY_ELEMENTDATA</code></li></ul><blockquote><p>那么问题来了，什么情况下<code>c.toArray()</code>会不返回<code>Object[]</code>呢？</p></blockquote><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">    List&lt;String&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;(Arrays.asList(<span class="string">"list"</span>));</span><br><span class="line">    <span class="comment">// class java.util.ArrayList</span></span><br><span class="line">    System.out.println(list.getClass());</span><br><span class="line"></span><br><span class="line">    Object[] listArray = list.toArray();</span><br><span class="line">    <span class="comment">// class [Ljava.lang.Object;</span></span><br><span class="line">    System.out.println(listArray.getClass());</span><br><span class="line">    listArray[<span class="number">0</span>] = <span class="keyword">new</span> Object();</span><br><span class="line"></span><br><span class="line">    System.out.println();</span><br><span class="line"></span><br><span class="line">    List&lt;String&gt; asList = Arrays.asList(<span class="string">"asList"</span>);</span><br><span class="line">    <span class="comment">// class java.util.Arrays$ArrayList</span></span><br><span class="line">    System.out.println(asList.getClass());</span><br><span class="line"></span><br><span class="line">    Object[] asListArray = asList.toArray();</span><br><span class="line">    <span class="comment">// class [Ljava.lang.String;</span></span><br><span class="line">    System.out.println(asListArray.getClass());</span><br><span class="line">    <span class="comment">// java.lang.ArrayStoreException</span></span><br><span class="line">    asListArray[<span class="number">0</span>] = <span class="keyword">new</span> Object();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>我们通过这个例子可以看出来，<code>java.util.ArrayList.toArray()</code>方法会返回<code>Object[]</code>没有问题。而<code>java.util.Arrays</code>的私有内部类ArrayList的<code>toArray()</code>方法可能不返回<code>Object[]</code>。</p><blockquote><p>为什么会这样？</p></blockquote><p>我们看ArrayList的<code>toArray()</code>方法源码：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> Object[] toArray() &#123;</span><br><span class="line">    <span class="comment">// ArrayLisy中 elementData是这样定义的</span></span><br><span class="line">    <span class="comment">// transient Object[] elementData;</span></span><br><span class="line">    <span class="keyword">return</span> Arrays.copyOf(elementData, size);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>使用了<code>Arrays.copyOf()</code>方法：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="keyword">static</span> &lt;T&gt; T[] copyOf(T[] original, <span class="keyword">int</span> newLength) &#123;</span><br><span class="line">    <span class="comment">// original.getClass() 是 class [Ljava.lang.Object</span></span><br><span class="line">    <span class="keyword">return</span> (T[]) copyOf(original, newLength, original.getClass());</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><code>copyOf()</code>的具体实现：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="keyword">static</span> &lt;T,U&gt; T[] copyOf(U[] original, </span><br><span class="line">          <span class="keyword">int</span> newLength, Class&lt;? extends T[]&gt; newType) &#123;</span><br><span class="line">    <span class="meta">@SuppressWarnings</span>(<span class="string">"unchecked"</span>)</span><br><span class="line">    <span class="comment">/**</span></span><br><span class="line"><span class="comment">     * 如果newType是Object[] copy 数组 类型就是 Object </span></span><br><span class="line"><span class="comment">     * 否则就是 newType 类型</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    T[] copy = ((Object)newType == (Object)Object[].class)</span><br><span class="line">        ? (T[]) <span class="keyword">new</span> Object[newLength]</span><br><span class="line">        : (T[]) Array.newInstance(newType.getComponentType(), newLength);</span><br><span class="line">    System.arraycopy(original, <span class="number">0</span>, copy, <span class="number">0</span>,</span><br><span class="line">                     Math.min(original.length, newLength));</span><br><span class="line">    <span class="keyword">return</span> copy;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>我们知道ArrayList中<code>elementData</code>就是<code>Object[]</code>类型，所以ArrayList的<code>toArray()</code>方法必然会返回<code>Object[]</code>。</p><p>我们再看一下<code>java.util.Arrays</code>的内部ArrayList源码（截取的部分源码）：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">private</span> <span class="keyword">static</span> <span class="class"><span class="keyword">class</span> <span class="title">ArrayList</span>&lt;<span class="title">E</span>&gt; <span class="keyword">extends</span> <span class="title">AbstractList</span>&lt;<span class="title">E</span>&gt;</span></span><br><span class="line"><span class="class">        <span class="keyword">implements</span> <span class="title">RandomAccess</span>, <span class="title">java</span>.<span class="title">io</span>.<span class="title">Serializable</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="comment">// 存储元素的数组</span></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">final</span> E[] a;</span><br><span class="line"></span><br><span class="line">    ArrayList(E[] array) &#123;</span><br><span class="line">        <span class="comment">// 直接把接收的数组 赋值 给 a</span></span><br><span class="line">        a = Objects.requireNonNull(array);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">/**</span></span><br><span class="line"><span class="comment">     * obj 为空抛出异常</span></span><br><span class="line"><span class="comment">     * 不为空 返回 obj</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">static</span> &lt;T&gt; <span class="function">T <span class="title">requireNonNull</span><span class="params">(T obj)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span> (obj == <span class="keyword">null</span>)</span><br><span class="line">            <span class="keyword">throw</span> <span class="keyword">new</span> NullPointerException();</span><br><span class="line">        <span class="keyword">return</span> obj;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="keyword">public</span> Object[] toArray() &#123;</span><br><span class="line">        <span class="comment">// 返回 a 的克隆对象</span></span><br><span class="line">        <span class="keyword">return</span> a.clone();</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>这是<code>Arrays.asList()</code>方法源码</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="keyword">static</span> &lt;T&gt; <span class="function">List&lt;T&gt; <span class="title">asList</span><span class="params">(T... a)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">return</span> <span class="keyword">new</span> ArrayList&lt;&gt;(a);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>不难看出来<code>java.util.Arrays</code>的内部ArrayList的<code>toArray()</code>方法，是构造方法接收什么类型的数组，就返回什么类型的数组。</p><p>所以，在我们上面的例子中，实际上返回的是String类型的数组，再将其中的元素赋值成<code>Object</code>类型的，自然报错。</p><p>我们还是继续看ArrayList吧…</p><h2 id="插入方法"><a href="#插入方法" class="headerlink" title="插入方法"></a>插入方法</h2><h3 id="在列表最后添加指定元素"><a href="#在列表最后添加指定元素" class="headerlink" title="在列表最后添加指定元素"></a>在列表最后添加指定元素</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 在列表最后添加指定元素</span></span><br><span class="line"><span class="comment"> *</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span> e 要添加的指定元素</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@return</span> true</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">add</span><span class="params">(E e)</span> </span>&#123;</span><br><span class="line">    <span class="comment">// 增加 modCount ！！</span></span><br><span class="line">    ensureCapacityInternal(size + <span class="number">1</span>); </span><br><span class="line">    elementData[size++] = e;</span><br><span class="line">    <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><ul><li>在父类<code>AbstractList</code>上，定义了<code>modCount</code> 属性，用于记录数组修改的次数。</li></ul><h3 id="在指定位置添加指定元素"><a href="#在指定位置添加指定元素" class="headerlink" title="在指定位置添加指定元素"></a>在指定位置添加指定元素</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 在指定位置添加指定元素</span></span><br><span class="line"><span class="comment"> * 如果指定位置已经有元素，就将该元素和随后的元素移动到右面一位</span></span><br><span class="line"><span class="comment"> *</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span> index 待插入元素的下标</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span> element 待插入的元素</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@throws</span> 可能抛出 IndexOutOfBoundsException</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">add</span><span class="params">(<span class="keyword">int</span> index, E element)</span> </span>&#123;</span><br><span class="line">    rangeCheckForAdd(index);</span><br><span class="line"></span><br><span class="line"></span><br><span class="line">    <span class="comment">// 增加 modCount ！！</span></span><br><span class="line">    ensureCapacityInternal(size + <span class="number">1</span>);</span><br><span class="line">    System.arraycopy(elementData, index, elementData, index + <span class="number">1</span>,</span><br><span class="line">                     size - index);</span><br><span class="line">    elementData[index] = element;</span><br><span class="line">    size++;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="插入方法调用的其他私有方法"><a href="#插入方法调用的其他私有方法" class="headerlink" title="插入方法调用的其他私有方法"></a>插入方法调用的其他私有方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 计算容量</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">int</span> <span class="title">calculateCapacity</span><span class="params">(</span></span></span><br><span class="line"><span class="function"><span class="params">        Object[] elementData, <span class="keyword">int</span> minCapacity)</span> </span>&#123;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> (elementData ==</span><br><span class="line">            DEFAULTCAPACITY_EMPTY_ELEMENTDATA) &#123;</span><br><span class="line">        <span class="keyword">return</span> Math.max(DEFAULT_CAPACITY, minCapacity);</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> minCapacity;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">ensureCapacityInternal</span><span class="params">(<span class="keyword">int</span> minCapacity)</span> </span>&#123;</span><br><span class="line">    ensureExplicitCapacity(</span><br><span class="line">            calculateCapacity(elementData, minCapacity)</span><br><span class="line">    );</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">ensureExplicitCapacity</span><span class="params">(<span class="keyword">int</span> minCapacity)</span> </span>&#123;</span><br><span class="line">    modCount++;</span><br><span class="line"></span><br><span class="line">    <span class="comment">// overflow-conscious code</span></span><br><span class="line">    <span class="keyword">if</span> (minCapacity - elementData.length &gt; <span class="number">0</span>)</span><br><span class="line">        grow(minCapacity);</span><br><span class="line">&#125;<span class="comment">/** * 计算容量 */</span><span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">int</span> <span class="title">calculateCapacity</span><span class="params">(        Object[] elementData, <span class="keyword">int</span> minCapacity)</span> </span>&#123;    <span class="keyword">if</span> (elementData ==            DEFAULTCAPACITY_EMPTY_ELEMENTDATA) &#123;        <span class="keyword">return</span> Math.max(DEFAULT_CAPACITY, minCapacity);    &#125;    <span class="keyword">return</span> minCapacity;&#125;<span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">ensureCapacityInternal</span><span class="params">(<span class="keyword">int</span> minCapacity)</span> </span>&#123;    ensureExplicitCapacity(            calculateCapacity(elementData, minCapacity)    );&#125;<span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">ensureExplicitCapacity</span><span class="params">(<span class="keyword">int</span> minCapacity)</span> </span>&#123;    modCount++;    <span class="comment">// overflow-conscious code    if (minCapacity - elementData.length &gt; 0)        grow(minCapacity);&#125;</span></span><br></pre></td></tr></table></figure><h2 id="扩容方法"><a href="#扩容方法" class="headerlink" title="扩容方法"></a>扩容方法</h2><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 数组可以分配的最大size</span></span><br><span class="line"><span class="comment"> * 一些虚拟机在数组中预留一些header words</span></span><br><span class="line"><span class="comment"> * 如果尝试分配更大的size，可能导致OutOfMemoryError</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">final</span> <span class="keyword">int</span> MAX_ARRAY_SIZE = Integer.MAX_VALUE - <span class="number">8</span>;</span><br><span class="line"></span><br><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 增加容量，至少保证比minCapacity大</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span> minCapacity 期望的最小容量</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">grow</span><span class="params">(<span class="keyword">int</span> minCapacity)</span> </span>&#123;</span><br><span class="line">    <span class="comment">// 有可能溢出的代码</span></span><br><span class="line">    <span class="keyword">int</span> oldCapacity = elementData.length;</span><br><span class="line">    <span class="keyword">int</span> newCapacity = oldCapacity + (oldCapacity &gt;&gt; <span class="number">1</span>);</span><br><span class="line">    <span class="keyword">if</span> (newCapacity - minCapacity &lt; <span class="number">0</span>)</span><br><span class="line">        newCapacity = minCapacity;</span><br><span class="line">    <span class="keyword">if</span> (newCapacity - MAX_ARRAY_SIZE &gt; <span class="number">0</span>)</span><br><span class="line">        newCapacity = hugeCapacity(minCapacity);</span><br><span class="line">    <span class="comment">// minCapacity is usually close to size, so this is a win:</span></span><br><span class="line">    elementData = Arrays.copyOf(elementData, newCapacity);</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 最大容量返回 Integer.MAX_VALUE</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">int</span> <span class="title">hugeCapacity</span><span class="params">(<span class="keyword">int</span> minCapacity)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span> (minCapacity &lt; <span class="number">0</span>) <span class="comment">// overflow</span></span><br><span class="line">        <span class="keyword">throw</span> <span class="keyword">new</span> OutOfMemoryError();</span><br><span class="line">    <span class="keyword">return</span> (minCapacity &gt; MAX_ARRAY_SIZE) ?</span><br><span class="line">        Integer.MAX_VALUE :</span><br><span class="line">        MAX_ARRAY_SIZE;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><ul><li>通常情况新容量是原来容量的1.5倍</li><li>如果原容量的1.5倍比<code>minCapacity</code>小，那么就扩容到<code>minCapacity</code></li><li>特殊情况扩容到<code>Integer.MAX_VALUE</code></li></ul><blockquote><p>看完构造方法、添加方法、扩容方法之后，上文第1个问题终于有了答案。原来，<code>new ArrayList()</code>会将<code>elementData</code> 赋值为 DEFAULTCAPACITY_EMPTY_ELEMENTDATA，<code>new ArrayList(0)</code>会将<code>elementData</code> 赋值为 EMPTY_ELEMENTDATA，EMPTY_ELEMENTDATA添加元素会扩容到容量为<code>1</code>，而DEFAULTCAPACITY_EMPTY_ELEMENTDATA扩容之后容量为<code>10</code>。</p></blockquote><p>通过反射我们可以验证这一想法。如下：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">    printDefaultCapacityList();</span><br><span class="line">    printEmptyCapacityList();</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">printDefaultCapacityList</span><span class="params">()</span> </span>&#123;</span><br><span class="line">    ArrayList defaultCapacity = <span class="keyword">new</span> ArrayList();</span><br><span class="line">    System.out.println(</span><br><span class="line">            <span class="string">"default 初始化长度："</span> + getCapacity(defaultCapacity));</span><br><span class="line"></span><br><span class="line">    defaultCapacity.add(<span class="number">1</span>);</span><br><span class="line">    System.out.println(</span><br><span class="line">            <span class="string">"default add 之后 长度："</span> + getCapacity(defaultCapacity));</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">printEmptyCapacityList</span><span class="params">()</span> </span>&#123;</span><br><span class="line">    ArrayList emptyCapacity = <span class="keyword">new</span> ArrayList(<span class="number">0</span>);</span><br><span class="line">    System.out.println(</span><br><span class="line">            <span class="string">"empty 初始化长度："</span> + getCapacity(emptyCapacity));</span><br><span class="line"></span><br><span class="line">    emptyCapacity.add(<span class="number">1</span>);</span><br><span class="line">    System.out.println(</span><br><span class="line">            <span class="string">"empty add 之后 长度："</span> + getCapacity(emptyCapacity));</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">int</span> <span class="title">getCapacity</span><span class="params">(ArrayList&lt;?&gt; arrayList)</span> </span>&#123;</span><br><span class="line">    Class&lt;ArrayList&gt; arrayListClass = ArrayList.class;</span><br><span class="line">    <span class="keyword">try</span> &#123;</span><br><span class="line">        <span class="comment">// 获取 elementData 字段</span></span><br><span class="line">        Field field = arrayListClass.getDeclaredField(<span class="string">"elementData"</span>);</span><br><span class="line">        <span class="comment">// 开启访问权限</span></span><br><span class="line">        field.setAccessible(<span class="keyword">true</span>);</span><br><span class="line">        <span class="comment">// 把示例传入get，获取实例字段elementData的值</span></span><br><span class="line">        Object[] objects = (Object[]) field.get(arrayList);</span><br><span class="line">        <span class="comment">//返回当前ArrayList实例的容量值</span></span><br><span class="line">        <span class="keyword">return</span> objects.length;</span><br><span class="line">    &#125; <span class="keyword">catch</span> (Exception e) &#123;</span><br><span class="line">        e.printStackTrace();</span><br><span class="line">        <span class="keyword">return</span> -<span class="number">1</span>;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h2 id="移除方法"><a href="#移除方法" class="headerlink" title="移除方法"></a>移除方法</h2><h3 id="移除指定下标元素方法"><a href="#移除指定下标元素方法" class="headerlink" title="移除指定下标元素方法"></a>移除指定下标元素方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 移除列表中指定下标位置的元素</span></span><br><span class="line"><span class="comment"> * 将所有的后续元素，向左移动</span></span><br><span class="line"><span class="comment"> *</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span> 要移除的指定下标</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@return</span> 返回被移除的元素</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@throws</span> 下标越界会抛出IndexOutOfBoundsException</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> E <span class="title">remove</span><span class="params">(<span class="keyword">int</span> index)</span> </span>&#123;</span><br><span class="line">    rangeCheck(index);</span><br><span class="line"></span><br><span class="line">    modCount++;</span><br><span class="line">    E oldValue = elementData(index);</span><br><span class="line"></span><br><span class="line">    <span class="keyword">int</span> numMoved = size - index - <span class="number">1</span>;</span><br><span class="line">    <span class="keyword">if</span> (numMoved &gt; <span class="number">0</span>)</span><br><span class="line">            System.arraycopy(elementData, </span><br><span class="line">                    index+<span class="number">1</span>, elementData, index,  numMoved);</span><br><span class="line">    <span class="comment">// 将引用置空，让GC回收</span></span><br><span class="line">    elementData[--size] = <span class="keyword">null</span>;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> oldValue;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="移除指定元素方法"><a href="#移除指定元素方法" class="headerlink" title="移除指定元素方法"></a>移除指定元素方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 移除第一个在列表中出现的指定元素</span></span><br><span class="line"><span class="comment"> * 如果存在，移除返回true</span></span><br><span class="line"><span class="comment"> * 否则，返回false</span></span><br><span class="line"><span class="comment"> *</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span> o 指定元素</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">remove</span><span class="params">(Object o)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span> (o == <span class="keyword">null</span>) &#123;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> index = <span class="number">0</span>; index &lt; size; index++)</span><br><span class="line">            <span class="keyword">if</span> (elementData[index] == <span class="keyword">null</span>) &#123;</span><br><span class="line">                fastRemove(index);</span><br><span class="line">                <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">            &#125;</span><br><span class="line">    &#125; <span class="keyword">else</span> &#123;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> index = <span class="number">0</span>; index &lt; size; index++)</span><br><span class="line">            <span class="keyword">if</span> (o.equals(elementData[index])) &#123;</span><br><span class="line">                fastRemove(index);</span><br><span class="line">                <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">            &#125;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><blockquote><p>移除方法名字、参数的个数都一样，使用的时候要注意。</p></blockquote><h3 id="私有移除方法"><a href="#私有移除方法" class="headerlink" title="私有移除方法"></a>私有移除方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/*</span></span><br><span class="line"><span class="comment"> * 私有的 移除 方法 跳过边界检查且不返回移除的元素</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">fastRemove</span><span class="params">(<span class="keyword">int</span> index)</span> </span>&#123;</span><br><span class="line">    modCount++;</span><br><span class="line">    <span class="keyword">int</span> numMoved = size - index - <span class="number">1</span>;</span><br><span class="line">    <span class="keyword">if</span> (numMoved &gt; <span class="number">0</span>)</span><br><span class="line">        System.arraycopy(elementData, index+<span class="number">1</span>, elementData, index,</span><br><span class="line">                         numMoved);</span><br><span class="line">    <span class="comment">// 将引用置空，让GC回收</span></span><br><span class="line">    elementData[--size] = <span class="keyword">null</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h2 id="查找方法"><a href="#查找方法" class="headerlink" title="查找方法"></a>查找方法</h2><h3 id="查找指定元素的所在位置"><a href="#查找指定元素的所在位置" class="headerlink" title="查找指定元素的所在位置"></a>查找指定元素的所在位置</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 返回指定元素第一次出现的下标</span></span><br><span class="line"><span class="comment"> * 如果不存在该元素，返回 -1</span></span><br><span class="line"><span class="comment"> * 如果 o ==null 会特殊处理</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">indexOf</span><span class="params">(Object o)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span> (o == <span class="keyword">null</span>) &#123;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; size; i++)</span><br><span class="line">            <span class="keyword">if</span> (elementData[i]==<span class="keyword">null</span>)</span><br><span class="line">                <span class="keyword">return</span> i;</span><br><span class="line">    &#125; <span class="keyword">else</span> &#123;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; size; i++)</span><br><span class="line">            <span class="keyword">if</span> (o.equals(elementData[i]))</span><br><span class="line">                <span class="keyword">return</span> i;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> -<span class="number">1</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="查找指定位置的元素"><a href="#查找指定位置的元素" class="headerlink" title="查找指定位置的元素"></a>查找指定位置的元素</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 返回指定位置的元素</span></span><br><span class="line"><span class="comment"> *</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span>  index 指定元素的位置 </span></span><br><span class="line"><span class="comment"> * <span class="doctag">@throws</span> index越界会抛出IndexOutOfBoundsException</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> E <span class="title">get</span><span class="params">(<span class="keyword">int</span> index)</span> </span>&#123;</span><br><span class="line">    rangeCheck(index);</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> elementData(index);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><blockquote><p>该方法直接返回<code>elementData</code>数组指定下标的元素，效率还是很高的。所以ArrayList，<code>for</code>循环遍历效率也是很高的。</p></blockquote><h2 id="序列化方法"><a href="#序列化方法" class="headerlink" title="序列化方法"></a>序列化方法</h2><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 将ArrayLisy实例的状态保存到一个流里面</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">writeObject</span><span class="params">(java.io.ObjectOutputStream s)</span></span></span><br><span class="line"><span class="function">    <span class="keyword">throws</span> java.io.IOException</span>&#123;</span><br><span class="line">    <span class="comment">// Write out element count, and any hidden stuff</span></span><br><span class="line">    <span class="keyword">int</span> expectedModCount = modCount;</span><br><span class="line">    s.defaultWriteObject();</span><br><span class="line"></span><br><span class="line">    <span class="comment">// Write out size as capacity for behavioural compatibility with clone()</span></span><br><span class="line">    s.writeInt(size);</span><br><span class="line"></span><br><span class="line">    <span class="comment">// 按照顺序写入所有的元素</span></span><br><span class="line">    <span class="keyword">for</span> (<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;size; i++) &#123;</span><br><span class="line">        s.writeObject(elementData[i]);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> (modCount != expectedModCount) &#123;</span><br><span class="line">        <span class="keyword">throw</span> <span class="keyword">new</span> ConcurrentModificationException();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h2 id="反序列化方法"><a href="#反序列化方法" class="headerlink" title="反序列化方法"></a>反序列化方法</h2><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 根据一个流(参数)重新生成一个ArrayList</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">readObject</span><span class="params">(java.io.ObjectInputStream s)</span></span></span><br><span class="line"><span class="function">    <span class="keyword">throws</span> java.io.IOException, ClassNotFoundException </span>&#123;</span><br><span class="line">    elementData = EMPTY_ELEMENTDATA;</span><br><span class="line"></span><br><span class="line">    <span class="comment">// Read in size, and any hidden stuff</span></span><br><span class="line">    s.defaultReadObject();</span><br><span class="line"></span><br><span class="line">    <span class="comment">// Read in capacity</span></span><br><span class="line">    s.readInt();</span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> (size &gt; <span class="number">0</span>) &#123;</span><br><span class="line">        <span class="comment">// be like clone(), allocate array based upon size not capacity</span></span><br><span class="line">        ensureCapacityInternal(size);</span><br><span class="line"></span><br><span class="line">        Object[] a = elementData;</span><br><span class="line">        <span class="comment">// Read in all elements in the proper order.</span></span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;size; i++) &#123;</span><br><span class="line">            a[i] = s.readObject();</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><blockquote><p>看完序列化，反序列化方法，我们终于又能回答开篇的第二个问题了。<code>elementData</code>之所以用<code>transient</code>修饰，是因为JDK不想将整个<code>elementData</code>都序列化或者反序列化，而只是将<code>size</code>和实际存储的元素序列化或反序列化，从而节省空间和时间。</p></blockquote><h2 id="创建子数组"><a href="#创建子数组" class="headerlink" title="创建子数组"></a>创建子数组</h2><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> List&lt;E&gt; <span class="title">subList</span><span class="params">(<span class="keyword">int</span> fromIndex, <span class="keyword">int</span> toIndex)</span> </span>&#123;</span><br><span class="line">    subListRangeCheck(fromIndex, toIndex, size);</span><br><span class="line">    <span class="keyword">return</span> <span class="keyword">new</span> SubList(<span class="keyword">this</span>, <span class="number">0</span>, fromIndex, toIndex);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>我们看一下简短版的<code>SubList</code>：</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">private</span> <span class="class"><span class="keyword">class</span> <span class="title">SubList</span> <span class="keyword">extends</span> <span class="title">AbstractList</span>&lt;<span class="title">E</span>&gt; <span class="keyword">implements</span> <span class="title">RandomAccess</span> </span>&#123;</span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">final</span> AbstractList&lt;E&gt; parent;</span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">final</span> <span class="keyword">int</span> parentOffset;</span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">final</span> <span class="keyword">int</span> offset;</span><br><span class="line">    <span class="keyword">int</span> size;</span><br><span class="line"></span><br><span class="line">    SubList(AbstractList&lt;E&gt; parent,</span><br><span class="line">            <span class="keyword">int</span> offset, <span class="keyword">int</span> fromIndex, <span class="keyword">int</span> toIndex) &#123;</span><br><span class="line">        <span class="keyword">this</span>.parent = parent;</span><br><span class="line">        <span class="keyword">this</span>.parentOffset = fromIndex;</span><br><span class="line">        <span class="keyword">this</span>.offset = offset + fromIndex;</span><br><span class="line">        <span class="keyword">this</span>.size = toIndex - fromIndex;</span><br><span class="line">        <span class="keyword">this</span>.modCount = ArrayList.<span class="keyword">this</span>.modCount;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> E <span class="title">set</span><span class="params">(<span class="keyword">int</span> index, E e)</span> </span>&#123;</span><br><span class="line">        rangeCheck(index);</span><br><span class="line">        checkForComodification();</span><br><span class="line">        E oldValue = ArrayList.<span class="keyword">this</span>.elementData(offset + index);</span><br><span class="line">        ArrayList.<span class="keyword">this</span>.elementData[offset + index] = e;</span><br><span class="line">        <span class="keyword">return</span> oldValue;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">// 省略代码...</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><ul><li>SubList的set()方法，<strong>是直接修改ArrayList</strong>中<code>elementData</code>数组的，使用中应该注意</li><li>SubList是没有实现<code>Serializable</code>接口的，<strong>是不能序列化的</strong></li></ul><h2 id="迭代器"><a href="#迭代器" class="headerlink" title="迭代器"></a>迭代器</h2><h3 id="创建迭代器方法"><a href="#创建迭代器方法" class="headerlink" title="创建迭代器方法"></a>创建迭代器方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> Iterator&lt;E&gt; <span class="title">iterator</span><span class="params">()</span> </span>&#123;    </span><br><span class="line"><span class="keyword">return</span> <span class="keyword">new</span> Itr();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="Itr属性"><a href="#Itr属性" class="headerlink" title="Itr属性"></a>Itr属性</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// 下一个要返回的元素的下标</span></span><br><span class="line"><span class="keyword">int</span> cursor;</span><br><span class="line"><span class="comment">// 最后一个要返回元素的下标 没有元素返回 -1</span></span><br><span class="line"><span class="keyword">int</span> lastRet = -<span class="number">1</span>;</span><br><span class="line"><span class="comment">// 期望的 </span></span><br><span class="line">modCountint expectedModCount = modCount;</span><br></pre></td></tr></table></figure><h3 id="Itr的hasNext-方法"><a href="#Itr的hasNext-方法" class="headerlink" title="Itr的hasNext() 方法"></a>Itr的hasNext() 方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">hasNext</span><span class="params">()</span> </span>&#123;    </span><br><span class="line">    <span class="keyword">return</span> cursor != size;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="Itr的next-方法"><a href="#Itr的next-方法" class="headerlink" title="Itr的next()方法"></a>Itr的next()方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> E <span class="title">next</span><span class="params">()</span> </span>&#123;</span><br><span class="line">    checkForComodification();</span><br><span class="line">    <span class="keyword">int</span> i = cursor;</span><br><span class="line">    <span class="keyword">if</span> (i &gt;= size)</span><br><span class="line">        <span class="keyword">throw</span> <span class="keyword">new</span> NoSuchElementException();</span><br><span class="line">    Object[] elementData = ArrayList.<span class="keyword">this</span>.elementData;</span><br><span class="line">    <span class="keyword">if</span> (i &gt;= elementData.length)</span><br><span class="line">        <span class="keyword">throw</span> <span class="keyword">new</span> ConcurrentModificationException();</span><br><span class="line">    cursor = i + <span class="number">1</span>;</span><br><span class="line">    <span class="keyword">return</span> (E) elementData[lastRet = i];</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">void</span> <span class="title">checkForComodification</span><span class="params">()</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span> (modCount != expectedModCount)</span><br><span class="line">        <span class="keyword">throw</span> <span class="keyword">new</span> ConcurrentModificationException();</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><blockquote><p>在迭代的时候，会校验<code>modCount</code>是否等于<code>expectedModCount</code>，不等于就会抛出著名的<code>ConcurrentModificationException</code>异常。什么时候会抛出<code>ConcurrentModificationException</code>？</p></blockquote><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">    ArrayList arrayList = <span class="keyword">new</span> ArrayList();</span><br><span class="line">    <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; <span class="number">10</span>; i++) &#123;</span><br><span class="line">        arrayList.add(i);</span><br><span class="line">    &#125;</span><br><span class="line">    remove(arrayList);</span><br><span class="line">    System.out.println(arrayList);</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">remove</span><span class="params">(ArrayList&lt;Integer&gt; list)</span> </span>&#123;</span><br><span class="line">    Iterator&lt;Integer&gt; iterator = list.iterator();</span><br><span class="line">    <span class="keyword">while</span> (iterator.hasNext()) &#123;</span><br><span class="line">        Integer number = iterator.next();</span><br><span class="line">        <span class="keyword">if</span> (number % <span class="number">2</span> == <span class="number">0</span>) &#123;</span><br><span class="line">            <span class="comment">// 抛出ConcurrentModificationException异常</span></span><br><span class="line">            list.remove(number);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><blockquote><p>那怎么写才能不抛出<code>ConcurrentModificationException</code>？很简单，将<code>list.remove(number);</code>换成<code>iterator.remove();</code>即可。why？请看Itr的<code>remove()</code>源码…</p></blockquote><h3 id="Itr的remove-方法"><a href="#Itr的remove-方法" class="headerlink" title="Itr的remove()方法"></a>Itr的remove()方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">remove</span><span class="params">()</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span> (lastRet &lt; <span class="number">0</span>)</span><br><span class="line">        <span class="keyword">throw</span> <span class="keyword">new</span> IllegalStateException();</span><br><span class="line">    checkForComodification();</span><br><span class="line"></span><br><span class="line">    <span class="keyword">try</span> &#123;</span><br><span class="line">        ArrayList.<span class="keyword">this</span>.remove(lastRet);</span><br><span class="line">        cursor = lastRet;</span><br><span class="line">        lastRet = -<span class="number">1</span>;</span><br><span class="line">        <span class="comment">// 移除之后将modCount 重新赋值给 expectedModCount</span></span><br><span class="line">        expectedModCount = modCount;</span><br><span class="line">    &#125; <span class="keyword">catch</span> (IndexOutOfBoundsException ex) &#123;</span><br><span class="line">        <span class="keyword">throw</span> <span class="keyword">new</span> ConcurrentModificationException();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>原因就是因为Itr的<code>remove()</code>方法，移除之后将<code>modCount</code>重新赋值给 <code>expectedModCount</code>。这就是源码，不管单线程还是多线程，只要违反了规则，就会抛异常。</p><blockquote><p>源码看的差不多了，开篇的问题却还剩一个！到底为什么<code>elementData</code>没有用<code>private</code>修饰呢？</p></blockquote><p>我们知道的，<code>private</code>修饰的变量，内部类也是可以访问到的。难道注释中<code>non-private to simplify nested class access</code>的这句话有毛病？</p><p>当我们看表面看不到什么东西的时候，不妨看一下底层。</p><p>测试类代码：</p><p><img src="http://qiniu.zrbac.fun/27.png" alt="img"></p><p>一顿<code>javac</code>、<code>javap</code>之后（使用JDK8）：</p><p><img src="http://qiniu.zrbac.fun/28.png" alt="img"></p><p>再一顿<code>javac</code>、<code>javap</code>之后（使用JDK11）：</p><p><img src="http://qiniu.zrbac.fun/29.png" alt="img"></p><p>虽然字节码指令我还看不太懂，但是我能品出来，注释是没毛病的，<code>private</code>修饰的确会影响内部类的访问。</p><h2 id="ArrayList类注释翻译"><a href="#ArrayList类注释翻译" class="headerlink" title="ArrayList类注释翻译"></a>ArrayList类注释翻译</h2><p>类注释还是要看的，能给我们一个整体的了解这个类。我将ArrayList的类注释大概翻译整理了一下：</p><ul><li>ArrayList是实现<code>List</code>接口的可自动扩容的数组。实现了所有的<code>List</code>操作，允许所有的元素，包括<code>null</code>值。</li><li>ArrayList大致和Vector相同，除了ArrayList是非同步的。</li><li><code>size</code> <code>isEmpty</code> <code>get</code> <code>set</code> <code>iterator</code> 和 <code>listIterator</code> 方法时间复杂度是<code>O(1)</code>，常量时间。其他方法是<code>O(n)</code>，线性时间。</li><li>每一个ArrayList实例都有一个<code>capacity</code>（容量）。<code>capacity</code>是用于存储列表中元素的数组的大小。<code>capacity</code>至少和列表的大小一样大。</li><li>如果多个线程同时访问ArrayList的实例，并且至少一个线程会修改，必须在外部保证ArrayList的同步。修改包括添加删除扩容等操作，仅仅设置值不包括。这种场景可以用其他的一些封装好的同步的<code>list</code>。如果不存在这样的<code>Object</code>，ArrayList应该用<code>Collections.synchronizedList</code>包装起来最好在创建的时候就包装起来，来保证同步访问。</li><li><code>iterator()</code>和<code>listIterator(int)</code>方法是<code>fail-fast</code>的，如果在迭代器创建之后，列表进行结构化修改，迭代器会抛出<code>ConcurrentModificationException</code>。</li><li>面对并发修改，迭代器快速失败、清理，而不是在未知的时间不确定的情况下冒险。请注意，快速失败行为不能被保证。通常来讲，不能同步进行的并发修改几乎不可能做任何保证。因此，写依赖这个异常的程序的代码是错误的，快速失败行为应该仅仅用于防止<code>bug</code>。</li></ul><h2 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h2><ul><li>ArrayList底层的数据结构是数组</li><li>ArrayList可以自动扩容，不传初始容量或者初始容量是<code>0</code>，都会初始化一个空数组，但是如果添加元素，会自动进行扩容，所以，创建ArrayList的时候，给初始容量是必要的</li><li><code>Arrays.asList()</code>方法返回的是的<code>Arrays</code>内部的ArrayList，用的时候需要注意</li><li><code>subList()</code>返回内部类，不能序列化，和ArrayList共用同一个数组</li><li>迭代删除要用，迭代器的<code>remove</code>方法，或者可以用倒序的<code>for</code>循环</li><li>ArrayList重写了序列化、反序列化方法，避免序列化、反序列化全部数组，浪费时间和空间</li><li><code>elementData</code>不使用<code>private</code>修饰，可以简化内部类的访问</li></ul>]]></content>
    
    <summary type="html">
    
      &lt;h1 id=&quot;ArrayList源码分析&quot;&gt;&lt;a href=&quot;#ArrayList源码分析&quot; class=&quot;headerlink&quot; title=&quot;ArrayList源码分析&quot;&gt;&lt;/a&gt;ArrayList源码分析&lt;/h1&gt;&lt;h2 id=&quot;类图&quot;&gt;&lt;a href=&quot;#类图&quot; class=&quot;headerlink&quot; title=&quot;类图&quot;&gt;&lt;/a&gt;类图&lt;/h2&gt;&lt;p&gt;&lt;img src=&quot;http://qiniu.zrbac.fun/26.png&quot; alt=&quot;img&quot;&gt;&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;实现了&lt;code&gt;RandomAccess&lt;/code&gt;接口，可以随机访问&lt;/li&gt;
&lt;li&gt;实现了&lt;code&gt;Cloneable&lt;/code&gt;接口，可以克隆&lt;/li&gt;
&lt;li&gt;实现了&lt;code&gt;Serializable&lt;/code&gt;接口，可以序列化、反序列化&lt;/li&gt;
&lt;li&gt;实现了&lt;code&gt;List&lt;/code&gt;接口，是&lt;code&gt;List&lt;/code&gt;的实现类之一&lt;/li&gt;
&lt;li&gt;实现了&lt;code&gt;Collection&lt;/code&gt;接口，是&lt;code&gt;Java Collections Framework&lt;/code&gt;成员之一&lt;/li&gt;
&lt;li&gt;实现了&lt;code&gt;Iterable&lt;/code&gt;接口，可以使用&lt;code&gt;for-each&lt;/code&gt;迭代&lt;/li&gt;
&lt;/ul&gt;
&lt;h2 id=&quot;属性&quot;&gt;&lt;a href=&quot;#属性&quot; class=&quot;headerlink&quot; title=&quot;属性&quot;&gt;&lt;/a&gt;属性&lt;/h2&gt;&lt;figure class=&quot;highlight java&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;3&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;4&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;5&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;6&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;7&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;8&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;9&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;10&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;11&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;12&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;13&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;14&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;15&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;16&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;17&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;18&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;19&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;20&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;21&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;22&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;23&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;24&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;25&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;26&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;27&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;28&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;29&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;30&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;31&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;32&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;33&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;34&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;35&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;36&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt;// 序列化版本UID&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;private&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;static&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;final&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;long&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;        serialVersionUID = &lt;span class=&quot;number&quot;&gt;8683452581122892189L&lt;/span&gt;;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt;/**&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * 默认的初始容量&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; */&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;private&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;static&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;final&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;int&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;        DEFAULT_CAPACITY = &lt;span class=&quot;number&quot;&gt;10&lt;/span&gt;;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt;/**&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * 用于空实例的共享空数组实例&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * new ArrayList(0);&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; */&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;private&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;static&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;final&lt;/span&gt; Object[]&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;        EMPTY_ELEMENTDATA = &amp;#123;&amp;#125;;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt;/**&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * 用于提供默认大小的实例的共享空数组实例&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * new ArrayList();&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; */&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;private&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;static&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;final&lt;/span&gt; Object[]&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;        DEFAULTCAPACITY_EMPTY_ELEMENTDATA = &amp;#123;&amp;#125;;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt;/**&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * 存储ArrayList元素的数组缓冲区&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * ArrayList的容量，是数组的长度&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * &lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * non-private to simplify nested class access&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; */&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;transient&lt;/span&gt; Object[] elementData;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt;/**&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; * ArrayList中元素的数量&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;comment&quot;&gt; */&lt;/span&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;private&lt;/span&gt; &lt;span class=&quot;keyword&quot;&gt;int&lt;/span&gt; size;&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;
    
    </summary>
    
    
      <category term="数据结构" scheme="https://zrbac.github.io/categories/%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>Java面试常见问题汇总</title>
    <link href="https://zrbac.github.io/2020/08/24/Java%E9%9D%A2%E8%AF%95%E5%B8%B8%E8%A7%81%E9%97%AE%E9%A2%98%E6%B1%87%E6%80%BB/"/>
    <id>https://zrbac.github.io/2020/08/24/Java%E9%9D%A2%E8%AF%95%E5%B8%B8%E8%A7%81%E9%97%AE%E9%A2%98%E6%B1%87%E6%80%BB/</id>
    <published>2020-08-24T08:01:46.000Z</published>
    <updated>2020-08-24T08:21:03.089Z</updated>
    
    <content type="html"><![CDATA[<h2 id="Java面试常见问题汇总"><a href="#Java面试常见问题汇总" class="headerlink" title="Java面试常见问题汇总"></a>Java面试常见问题汇总</h2><h3 id="语言特性-12"><a href="#语言特性-12" class="headerlink" title="语言特性 12"></a>语言特性 12</h3><h4 id="Q1：Java-语言的优点？"><a href="#Q1：Java-语言的优点？" class="headerlink" title="Q1：Java 语言的优点？"></a>Q1：Java 语言的优点？</h4><p>① 平台无关性，摆脱硬件束缚，”一次编写，到处运行”。</p><p>② 相对安全的内存管理和访问机制，避免大部分内存泄漏和指针越界。</p><p>③ 热点代码检测和运行时编译及优化，使程序随运行时间增长获得更高性能。</p><p>④ 完善的应用程序接口，支持第三方类库。</p><hr><h4 id="Q2：Java-如何实现平台无关？"><a href="#Q2：Java-如何实现平台无关？" class="headerlink" title="Q2：Java 如何实现平台无关？"></a>Q2：Java 如何实现平台无关？</h4><p><strong>JVM：</strong> Java 编译器可生成与计算机体系结构无关的字节码指令，字节码文件不仅可以轻易地在任何机器上解释执行，还可以动态地转换成本地机器代码，转换是由 JVM 实现的，JVM 是平台相关的，屏蔽了不同操作系统的差异。</p><p><strong>语言规范：</strong> 基本数据类型大小有明确规定，例如 int 永远为 32 位，而 C/C++ 中可能是 16 位、32 位，也可能是编译器开发商指定的其他大小。Java 中数值类型有固定字节数，二进制数据以固定格式存储和传输，字符串采用标准的 Unicode 格式存储。</p><hr><a id="more"></a><h4 id="Q3：JDK-和-JRE-的区别？"><a href="#Q3：JDK-和-JRE-的区别？" class="headerlink" title="Q3：JDK 和 JRE 的区别？"></a>Q3：JDK 和 JRE 的区别？</h4><p><strong>JDK：</strong> Java Development Kit，开发工具包。提供了编译运行 Java 程序的各种工具，包括编译器、JRE 及常用类库，是 JAVA 核心。</p><p><strong>JRE：</strong> Java Runtime Environment，运行时环境，运行 Java 程序的必要环境，包括 JVM、核心类库、核心配置工具。</p><hr><h4 id="Q4：Java-按值调用还是引用调用？"><a href="#Q4：Java-按值调用还是引用调用？" class="headerlink" title="Q4：Java 按值调用还是引用调用？"></a>Q4：Java 按值调用还是引用调用？</h4><p><strong>按值调用</strong>指方法接收调用者提供的值，<strong>按引用调用</strong>指方法接收调用者提供的变量地址。</p><p>Java 总是按值调用，方法得到的是所有参数值的副本，传递对象时实际上方法接收的是对象引用的副本。方法不能修改基本数据类型的参数，如果传递了一个 int 值 ，改变值不会影响实参，因为改变的是值的一个副本。</p><p>可以改变对象参数的状态，但不能让对象参数引用一个新的对象。如果传递了一个 int 数组，改变数组的内容会影响实参，而改变这个参数的引用并不会让实参引用新的数组对象。</p><hr><h4 id="Q5：浅拷贝和深拷贝的区别？"><a href="#Q5：浅拷贝和深拷贝的区别？" class="headerlink" title="Q5：浅拷贝和深拷贝的区别？"></a>Q5：浅拷贝和深拷贝的区别？</h4><p><strong>浅拷贝：</strong> 只复制当前对象的基本数据类型及引用变量，没有复制引用变量指向的实际对象。修改克隆对象可能影响原对象，不安全。</p><p><strong>深拷贝：</strong> 完全拷贝基本数据类型和引用数据类型，安全。</p><hr><h4 id="Q6：什么是反射？"><a href="#Q6：什么是反射？" class="headerlink" title="Q6：什么是反射？"></a>Q6：什么是反射？</h4><p>在运行状态中，对于任意一个类都能知道它的所有属性和方法，对于任意一个对象都能调用它的任意方法和属性，这种动态获取信息及调用对象方法的功能称为反射。缺点是破坏了封装性以及泛型约束。反射是框架的核心，Spring 大量使用反射。</p><hr><h4 id="Q7：Class-类的作用？如何获取一个-Class-对象？"><a href="#Q7：Class-类的作用？如何获取一个-Class-对象？" class="headerlink" title="Q7：Class 类的作用？如何获取一个 Class 对象？"></a>Q7：Class 类的作用？如何获取一个 Class 对象？</h4><p>在程序运行期间，Java 运行时系统为所有对象维护一个运行时类型标识，这个信息会跟踪每个对象所属的类，虚拟机利用运行时类型信息选择要执行的正确方法，保存这些信息的类就是 Class，这是一个泛型类。</p><p>获取 Class 对象：①  <code>类名.class</code> 。②对象的 <code>getClass</code>方法。③ <code>Class.forName(类的全限定名)</code>。</p><hr><h4 id="Q8：什么是注解？什么是元注解？"><a href="#Q8：什么是注解？什么是元注解？" class="headerlink" title="Q8：什么是注解？什么是元注解？"></a>Q8：什么是注解？什么是元注解？</h4><p><strong>注解</strong>是一种标记，使类或接口附加额外信息，帮助编译器和 JVM 完成一些特定功能，例如 <code>@Override</code> 标识一个方法是重写方法。</p><p><strong>元注解</strong>是自定义注解的注解，例如：</p><p><code>@Target</code>：约束作用位置，值是 ElementType 枚举常量，包括 METHOD 方法、VARIABLE 变量、TYPE 类/接口、PARAMETER 方法参数、CONSTRUCTORS 构造方法和 LOACL_VARIABLE 局部变量等。</p><p><code>@Rentention</code>：约束生命周期，值是 RetentionPolicy 枚举常量，包括 SOURCE 源码、CLASS 字节码和 RUNTIME 运行时。</p><p><code>@Documented</code>：表明这个注解应该被 javadoc 记录。</p><hr><h4 id="Q9：什么是泛型，有什么作用？"><a href="#Q9：什么是泛型，有什么作用？" class="headerlink" title="Q9：什么是泛型，有什么作用？"></a>Q9：什么是泛型，有什么作用？</h4><p><strong>泛型</strong>本质是参数化类型，解决不确定对象具体类型的问题。泛型在定义处只具备执行 Object 方法的能力。</p><p>泛型的好处：① 类型安全，放置什么出来就是什么，不存在 ClassCastException。② 提升可读性，编码阶段就显式知道泛型集合、泛型方法等处理的对象类型。③ 代码重用，合并了同类型的处理代码。</p><h4 id="Q10：泛型擦除是什么？"><a href="#Q10：泛型擦除是什么？" class="headerlink" title="Q10：泛型擦除是什么？"></a>Q10：泛型擦除是什么？</h4><p>泛型用于编译阶段，编译后的字节码文件不包含泛型类型信息，因为虚拟机没有泛型类型对象，所有对象都属于普通类。例如定义 <code>List</code> 或 <code>List</code>，在编译后都会变成 <code>List</code> 。</p><p>定义一个泛型类型，会自动提供一个对应原始类型，类型变量会被擦除。如果没有限定类型就会替换为 Object，如果有限定类型就会替换为第一个限定类型，例如 `` 会使用 A 类型替换 T。</p><hr><h4 id="Q11：JDK8-新特性有哪些？"><a href="#Q11：JDK8-新特性有哪些？" class="headerlink" title="Q11：JDK8 新特性有哪些？"></a>Q11：JDK8 新特性有哪些？</h4><p><strong>lambda 表达式：</strong>允许把函数作为参数传递到方法，简化匿名内部类代码。</p><p><strong>函数式接口：</strong>使用 <code>@FunctionalInterface</code> 标识，有且仅有一个抽象方法，可被隐式转换为 lambda 表达式。</p><p><strong>方法引用：</strong>可以引用已有类或对象的方法和构造方法，进一步简化 lambda 表达式。</p><p><strong>接口：</strong>接口可以定义 <code>default</code> 修饰的默认方法，降低了接口升级的复杂性，还可以定义静态方法。</p><p><strong>注解：</strong>引入重复注解机制，相同注解在同地方可以声明多次。注解作用范围也进行了扩展，可作用于局部变量、泛型、方法异常等。</p><p><strong>类型推测：</strong>加强了类型推测机制，使代码更加简洁。</p><p><strong>Optional 类：</strong>处理空指针异常，提高代码可读性。</p><p><strong>Stream 类：</strong>引入函数式编程风格，提供了很多功能，使代码更加简洁。方法包括 <code>forEach</code> 遍历、<code>count</code> 统计个数、<code>filter</code> 按条件过滤、<code>limit</code> 取前 n 个元素、<code>skip</code> 跳过前 n 个元素、<code>map</code> 映射加工、<code>concat</code> 合并 stream 流等。</p><p><strong>日期：</strong>增强了日期和时间 API，新的 java.time 包主要包含了处理日期、时间、日期/时间、时区、时刻和时钟等操作。</p><p><strong>JavaScript：</strong>提供了一个新的 JavaScript 引擎，允许在 JVM上运行特定 JavaScript 应用。</p><hr><h4 id="Q12：异常有哪些分类？"><a href="#Q12：异常有哪些分类？" class="headerlink" title="Q12：异常有哪些分类？"></a>Q12：异常有哪些分类？</h4><p>所有异常都是 Throwable 的子类，分为 Error 和 Exception。<strong>Error</strong> 是 Java 运行时系统的内部错误和资源耗尽错误，例如 StackOverFlowError 和 OutOfMemoryError，这种异常程序无法处理。</p><p><strong>Exception</strong> 分为受检异常和非受检异常，受检异常需要在代码中显式处理，否则会编译出错，非受检异常是运行时异常，继承自 RuntimeException。</p><p><strong>受检异常</strong>：① 无能为力型，如字段超长导致的 SQLException。② 力所能及型，如未授权异常 UnAuthorizedException，程序可跳转权限申请页面。常见受检异常还有 FileNotFoundException、ClassNotFoundException、IOException等。</p><p><strong>非受检异常</strong>：① 可预测异常，例如 IndexOutOfBoundsException、NullPointerException、ClassCastException 等，这类异常应该提前处理。② 需捕捉异常，例如进行 RPC 调用时的远程服务超时，这类异常客户端必须显式处理。③ 可透出异常，指框架或系统产生的且会自行处理的异常，例如 Spring 的 NoSuchRequestHandingMethodException，Spring 会自动完成异常处理，将异常自动映射到合适的状态码。</p><hr><h3 id="数据类型-5"><a href="#数据类型-5" class="headerlink" title="数据类型 5"></a>数据类型 5</h3><h4 id="Q1：Java-有哪些基本数据类型？"><a href="#Q1：Java-有哪些基本数据类型？" class="headerlink" title="Q1：Java 有哪些基本数据类型？"></a>Q1：Java 有哪些基本数据类型？</h4><table><thead><tr><th>数据类型</th><th>内存大小</th><th>默认值</th><th>取值范围</th></tr></thead><tbody><tr><td>byte</td><td>1 B</td><td>(byte)0</td><td>-128 ~ 127</td></tr><tr><td>short</td><td>2 B</td><td>(short)0</td><td>-2^15^ ~ 2^15^-1</td></tr><tr><td>int</td><td>4 B</td><td>0</td><td>-2^31^ ~ 2^31^-1</td></tr><tr><td>long</td><td>8 B</td><td>0L</td><td>-2^63^ ~ 2^63^-1</td></tr><tr><td>float</td><td>4 B</td><td>0.0F</td><td>±3.4E+38（有效位数 6~7 位）</td></tr><tr><td>double</td><td>8 B</td><td>0.0D</td><td>±1.7E+308（有效位数 15 位）</td></tr><tr><td>char</td><td>英文 1B，中文 UTF-8 占 3B，GBK 占 2B。</td><td>‘\u0000’</td><td>‘\u0000’ ~ ‘\uFFFF’</td></tr><tr><td>boolean</td><td>单个变量 4B / 数组 1B</td><td>false</td><td>true、false</td></tr></tbody></table><p>JVM 没有 boolean 赋值的专用字节码指令，<code>boolean f = false</code> 就是使用 ICONST_0 即常数 0 赋值。单个 boolean 变量用 int 代替，boolean 数组会编码成 byte 数组。</p><hr><h4 id="Q2：自动装箱-拆箱是什么？"><a href="#Q2：自动装箱-拆箱是什么？" class="headerlink" title="Q2：自动装箱/拆箱是什么？"></a>Q2：自动装箱/拆箱是什么？</h4><p>每个基本数据类型都对应一个包装类，除了 int 和 char 对应 Integer 和 Character 外，其余基本数据类型的包装类都是首字母大写即可。</p><p><strong>自动装箱：</strong> 将基本数据类型包装为一个包装类对象，例如向一个泛型为 Integer 的集合添加 int 元素。</p><p><strong>自动拆箱：</strong> 将一个包装类对象转换为一个基本数据类型，例如将一个包装类对象赋值给一个基本数据类型的变量。</p><p>比较两个包装类数值要用 <code>equals</code> ，而不能用 <code>==</code> 。</p><hr><h4 id="Q3：String-是不可变类为什么值可以修改？"><a href="#Q3：String-是不可变类为什么值可以修改？" class="headerlink" title="Q3：String 是不可变类为什么值可以修改？"></a>Q3：String 是不可变类为什么值可以修改？</h4><p>String 类和其存储数据的成员变量 value 字节数组都是 final 修饰的。对一个 String 对象的任何修改实际上都是创建一个新 String 对象，再引用该对象。只是修改 String 变量引用的对象，没有修改原 String 对象的内容。</p><hr><h4 id="Q4：字符串拼接的方式有哪些？"><a href="#Q4：字符串拼接的方式有哪些？" class="headerlink" title="Q4：字符串拼接的方式有哪些？"></a>Q4：字符串拼接的方式有哪些？</h4><p>① 直接用 <code>+</code> ，底层用 StringBuilder 实现。只适用小数量，如果在循环中使用 <code>+</code> 拼接，相当于不断创建新的 StringBuilder 对象再转换成 String 对象，效率极差。</p><p>② 使用 String 的 concat 方法，该方法中使用 <code>Arrays.copyOf</code> 创建一个新的字符数组 buf 并将当前字符串 value 数组的值拷贝到 buf 中，buf 长度 = 当前字符串长度 + 拼接字符串长度。之后调用 <code>getChars</code> 方法使用 <code>System.arraycopy</code> 将拼接字符串的值也拷贝到 buf 数组，最后用 buf 作为构造参数 new 一个新的 String 对象返回。效率稍高于直接使用 <code>+</code>。</p><p>③ 使用 StringBuilder 或 StringBuffer，两者的 <code>append</code> 方法都继承自 AbstractStringBuilder，该方法首先使用 <code>Arrays.copyOf</code>  确定新的字符数组容量，再调用 <code>getChars</code> 方法使用 <code>System.arraycopy</code> 将新的值追加到数组中。StringBuilder 是 JDK5 引入的，效率高但线程不安全。StringBuffer 使用 synchronized 保证线程安全。</p><hr><h4 id="Q5：String-a-“a”-new-String-“b”-创建了几个对象？"><a href="#Q5：String-a-“a”-new-String-“b”-创建了几个对象？" class="headerlink" title="Q5：String a = “a” + new String(“b”)  创建了几个对象？"></a>Q5：String a = “a” + new String(“b”)  创建了几个对象？</h4><p>常量和常量拼接仍是常量，结果在常量池，只要有变量参与拼接结果就是变量，存在堆。</p><p>使用字面量时只创建一个常量池中的常量，使用 new 时如果常量池中没有该值就会在常量池中新创建，再在堆中创建一个对象引用常量池中常量。因此 <code>String a = &quot;a&quot; + new String(&quot;b&quot;)</code> 会创建四个对象，常量池中的 a 和 b，堆中的 b 和堆中的 ab。</p><hr><h3 id="面向对象-10"><a href="#面向对象-10" class="headerlink" title="面向对象 10"></a>面向对象 10</h3><h4 id="Q1：谈一谈你对面向对象的理解"><a href="#Q1：谈一谈你对面向对象的理解" class="headerlink" title="Q1：谈一谈你对面向对象的理解"></a>Q1：谈一谈你对面向对象的理解</h4><p>面向过程让计算机有步骤地顺序做一件事，是过程化思维，使用面向过程语言开发大型项目，软件复用和维护存在很大问题，模块之间耦合严重。面向对象相对面向过程更适合解决规模较大的问题，可以拆解问题复杂度，对现实事物进行抽象并映射为开发对象，更接近人的思维。</p><p>例如开门这个动作，面向过程是 <code>open(Door door)</code>，动宾结构，door 作为操作对象的参数传入方法，方法内定义开门的具体步骤。面向对象的方式首先会定义一个类 Door，抽象出门的属性（如尺寸、颜色）和行为（如 open 和 close），主谓结构。</p><p>面向过程代码松散，强调流程化解决问题。面向对象代码强调高内聚、低耦合，先抽象模型定义共性行为，再解决实际问题。</p><hr><h4 id="Q2：面向对象的三大特性？"><a href="#Q2：面向对象的三大特性？" class="headerlink" title="Q2：面向对象的三大特性？"></a>Q2：面向对象的三大特性？</h4><p><strong>封装</strong>是对象功能内聚的表现形式，在抽象基础上决定信息是否公开及公开等级，核心问题是以什么方式暴漏哪些信息。主要任务是对属性、数据、敏感行为实现隐藏，对属性的访问和修改必须通过公共接口实现。封装使对象关系变得简单，降低了代码耦合度，方便维护。</p><p>迪米特原则就是对封装的要求，即 A 模块使用 B 模块的某接口行为，对 B 模块中除此行为外的其他信息知道得应尽可能少。不直接对 public 属性进行读取和修改而使用 getter/setter 方法是因为假设想在修改属性时进行权限控制、日志记录等操作，在直接访问属性的情况下无法实现。如果将 public 的属性和行为修改为 private 一般依赖模块都会报错，因此不知道使用哪种权限时应优先使用 private。</p><p><strong>继承</strong>用来扩展一个类，子类可继承父类的部分属性和行为使模块具有复用性。继承是”is-a”关系，可使用里氏替换原则判断是否满足”is-a”关系，即任何父类出现的地方子类都可以出现。如果父类引用直接使用子类引用来代替且可以正确编译并执行，输出结果符合子类场景预期，那么说明两个类符合里氏替换原则。</p><p><strong>多态</strong>以封装和继承为基础，根据运行时对象实际类型使同一行为具有不同表现形式。多态指在编译层面无法确定最终调用的方法体，在运行期由 JVM 动态绑定，调用合适的重写方法。由于重载属于静态绑定，本质上重载结果是完全不同的方法，因此多态一般专指重写。</p><hr><h4 id="Q3：重载和重写的区别？"><a href="#Q3：重载和重写的区别？" class="headerlink" title="Q3：重载和重写的区别？"></a>Q3：重载和重写的区别？</h4><p><strong>重载</strong>指方法名称相同，但参数类型个数不同，是行为水平方向不同实现。对编译器来说，方法名称和参数列表组成了一个唯一键，称为方法签名，JVM 通过方法签名决定调用哪种重载方法。不管继承关系如何复杂，重载在编译时可以根据规则知道调用哪种目标方法，因此属于静态绑定。</p><p>JVM 在重载方法中选择合适方法的顺序：① 精确匹配。② 基本数据类型自动转换成更大表示范围。③ 自动拆箱与装箱。④ 子类向上转型。⑤ 可变参数。</p><p><strong>重写</strong>指子类实现接口或继承父类时，保持方法签名完全相同，实现不同方法体，是行为垂直方向不同实现。</p><p>元空间有一个方法表保存方法信息，如果子类重写了父类的方法，则方法表中的方法引用会指向子类实现。父类引用执行子类方法时无法调用子类存在而父类不存在的方法。</p><p>重写方法访问权限不能变小，返回类型和抛出的异常类型不能变大，必须加 <code>@Override</code> 。</p><hr><h4 id="Q4：类之间有哪些关系？"><a href="#Q4：类之间有哪些关系？" class="headerlink" title="Q4：类之间有哪些关系？"></a>Q4：类之间有哪些关系？</h4><table><thead><tr><th>类关系</th><th>描述</th><th>权力强侧</th><th>举例</th></tr></thead><tbody><tr><td>继承</td><td>父子类之间的关系：is-a</td><td>父类</td><td>小狗继承于动物</td></tr><tr><td>实现</td><td>接口和实现类之间的关系：can-do</td><td>接口</td><td>小狗实现了狗叫接口</td></tr><tr><td>组合</td><td>比聚合更强的关系：contains-a</td><td>整体</td><td>头是身体的一部分</td></tr><tr><td>聚合</td><td>暂时组装的关系：has-a</td><td>组装方</td><td>小狗和绳子是暂时的聚合关系</td></tr><tr><td>依赖</td><td>一个类用到另一个：depends-a</td><td>被依赖方</td><td>人养小狗，人依赖于小狗</td></tr><tr><td>关联</td><td>平等的使用关系：links-a</td><td>平等</td><td>人使用卡消费，卡可以提取人的信息</td></tr></tbody></table><hr><h4 id="Q5：Object-类有哪些方法？"><a href="#Q5：Object-类有哪些方法？" class="headerlink" title="Q5：Object 类有哪些方法？"></a>Q5：Object 类有哪些方法？</h4><p><strong>equals：</strong>检测对象是否相等，默认使用 <code>==</code> 比较对象引用，可以重写 equals 方法自定义比较规则。equals 方法规范：自反性、对称性、传递性、一致性、对于任何非空引用 x，<code>x.equals(null)</code>  返回 false。</p><p><strong>hashCode：</strong>散列码是由对象导出的一个整型值，没有规律，每个对象都有默认散列码，值由对象存储地址得出。字符串散列码由内容导出，值可能相同。为了在集合中正确使用，一般需要同时重写 equals 和 hashCode，要求 equals 相同 hashCode 必须相同，hashCode 相同 equals 未必相同，因此 hashCode 是对象相等的必要不充分条件。</p><p><strong>toString</strong>：打印对象时默认的方法，如果没有重写打印的是表示对象值的一个字符串。</p><p><strong>clone：</strong>clone 方法声明为 protected，类只能通过该方法克隆它自己的对象，如果希望其他类也能调用该方法必须定义该方法为 public。如果一个对象的类没有实现 Cloneable 接口，该对象调用 clone 方***抛出一个 CloneNotSupport 异常。默认的 clone 方法是浅拷贝，一般重写 clone 方法需要实现 Cloneable 接口并指定访问修饰符为 public。</p><p><strong>finalize：</strong>确定一个对象死亡至少要经过两次标记，如果对象在可达性分析后发现没有与 GC Roots 连接的引用链会被第一次标记，随后进行一次筛选，条件是对象是否有必要执行 finalize 方法。假如对象没有重写该方法或方法已被虚拟机调用，都视为没有必要执行。如果有必要执行，对象会被放置在 F-Queue 队列，由一条低调度优先级的 Finalizer 线程去执行。虚拟机会触发该方法但不保证会结束，这是为了防止某个对象的 finalize 方法执行缓慢或发生死循环。只要对象在 finalize 方法中重新与引用链上的对象建立关联就会在第二次标记时被移出回收集合。由于运行代价高昂且无法保证调用顺序，在 JDK 9 被标记为过时方法，并不适合释放资源。</p><p><strong>getClass：</strong>返回包含对象信息的类对象。</p><p><strong>wait / notify / notifyAll：</strong>阻塞或唤醒持有该对象锁的线程。</p><hr><h4 id="Q6：内部类的作用是什么，有哪些分类？"><a href="#Q6：内部类的作用是什么，有哪些分类？" class="headerlink" title="Q6：内部类的作用是什么，有哪些分类？"></a>Q6：内部类的作用是什么，有哪些分类？</h4><p>内部类可对同一包中其他类隐藏，内部类方法可以访问定义这个内部类的作用域中的数据，包括 private 数据。</p><p>内部类是一个编译器现象，与虚拟机无关。编译器会把内部类转换成常规的类文件，用 $ 分隔外部类名与内部类名，其中匿名内部类使用数字编号，虚拟机对此一无所知。</p><p><strong>静态内部类：</strong> 属于外部类，只加载一次。作用域仅在包内，可通过 <code>外部类名.内部类名</code> 直接访问，类内只能访问外部类所有静态属性和方法。HashMap 的 Node 节点，ReentrantLock 中的 Sync 类，ArrayList 的 SubList 都是静态内部类。内部类中还可以定义内部类，如 ThreadLoacl 静态内部类 ThreadLoaclMap 中定义了内部类 Entry。</p><p><strong>成员内部类：</strong> 属于外部类的每个对象，随对象一起加载。不可以定义静态成员和方法，可访问外部类的所有内容。</p><p><strong>局部内部类：</strong> 定义在方法内，不能声明访问修饰符，只能定义实例成员变量和实例方法，作用范围仅在声明类的代码块中。</p><p><strong>匿名内部类：</strong> 只用一次的没有名字的类，可以简化代码，创建的对象类型相当于 new 的类的子类类型。用于实现事件监听和其他回调。</p><hr><h4 id="Q7：访问权限控制符有哪些？"><a href="#Q7：访问权限控制符有哪些？" class="headerlink" title="Q7：访问权限控制符有哪些？"></a>Q7：访问权限控制符有哪些？</h4><table><thead><tr><th>访问权限控制符</th><th>本类</th><th>包内</th><th>包外子类</th><th>任何地方</th></tr></thead><tbody><tr><td>public</td><td>√</td><td>√</td><td>√</td><td>√</td></tr><tr><td>protected</td><td>√</td><td>√</td><td>√</td><td>×</td></tr><tr><td>无</td><td>√</td><td>√</td><td>×</td><td>×</td></tr><tr><td>private</td><td>√</td><td>×</td><td>×</td><td>×</td></tr></tbody></table><hr><h4 id="Q8：接口和抽象类的异同？"><a href="#Q8：接口和抽象类的异同？" class="headerlink" title="Q8：接口和抽象类的异同？"></a>Q8：接口和抽象类的异同？</h4><p>接口和抽象类对实体类进行更高层次的抽象，仅定义公共行为和特征。</p><table><thead><tr><th>语法维度</th><th>抽象类</th><th>接口</th></tr></thead><tbody><tr><td>成员变量</td><td>无特殊要求</td><td>默认 public static final 常量</td></tr><tr><td>构造方法</td><td>有构造方法，不能实例化</td><td>没有构造方法，不能实例化</td></tr><tr><td>方法</td><td>抽象类可以没有抽象方法，但有抽象方法一定是抽象类。</td><td>默认 public abstract，JDK8 支持默认/静态方法，JDK9 支持私有方法。</td></tr><tr><td>继承</td><td>单继承</td><td>多继承</td></tr></tbody></table><hr><h4 id="Q9：接口和抽象类应该怎么选择？"><a href="#Q9：接口和抽象类应该怎么选择？" class="headerlink" title="Q9：接口和抽象类应该怎么选择？"></a>Q9：接口和抽象类应该怎么选择？</h4><p>抽象类体现 is-a 关系，接口体现 can-do 关系。与接口相比，抽象类通常是对同类事物相对具体的抽象。</p><p>抽象类是模板式设计，包含一组具体特征，例如某汽车，底盘、控制电路等是抽象出来的共同特征，但内饰、显示屏、座椅材质可以根据不同级别配置存在不同实现。</p><p>接口是契约式设计，是开放的，定义了方法名、参数、返回值、抛出的异常类型，谁都可以实现它，但必须遵守接口的约定。例如所有车辆都必须实现刹车这种强制规范。</p><p>接口是顶级类，抽象类在接口下面的第二层，对接口进行了组合，然后实现部分接口。当纠结定义接口和抽象类时，推荐定义为接口，遵循接口隔离原则，按维度划分成多个接口，再利用抽象类去实现这些，方便后续的扩展和重构。</p><p>例如 Plane 和 Bird 都有 fly 方法，应把 fly 定义为接口，而不是抽象类的抽象方法再继承，因为除了 fly 行为外 Plane 和 Bird 间很难再找到其他共同特征。</p><hr><h4 id="Q10：子类初始化的顺序"><a href="#Q10：子类初始化的顺序" class="headerlink" title="Q10：子类初始化的顺序"></a>Q10：子类初始化的顺序</h4><p>① 父类静态代码块和静态变量。② 子类静态代码块和静态变量。③ 父类普通代码块和普通变量。④ 父类构造方法。⑤ 子类普通代码块和普通变量。⑥ 子类构造方法。</p><hr><h3 id="集合-7"><a href="#集合-7" class="headerlink" title="集合 7"></a>集合 7</h3><h4 id="Q1：说一说-ArrayList"><a href="#Q1：说一说-ArrayList" class="headerlink" title="Q1：说一说 ArrayList"></a>Q1：说一说 ArrayList</h4><p><strong>ArrayList</strong> 是容量可变的非线程安全列表，使用数组实现，集合扩容时会创建更大的数组，把原有数组复制到新数组。支持对元素的快速随机访问，但插入与删除速度很慢。ArrayList 实现了 RandomAcess 标记接口，如果一个类实现了该接口，那么表示使用索引遍历比迭代器更快。</p><p><strong>elementData</strong>是 ArrayList 的数据域，被 transient 修饰，序列化时会调用 writeObject 写入流，反序列化时调用 readObject 重新赋值到新对象的 elementData。原因是 elementData 容量通常大于实际存储元素的数量，所以只需发送真正有实际值的数组元素。</p><p><strong>size</strong> 是当前实际大小，elementData 大小大于等于 size。</p><p>*<em>modCount *</em>记录了 ArrayList 结构性变化的次数，继承自 AbstractList。所有涉及结构变化的方法都会增加该值。expectedModCount 是迭代器初始化时记录的 modCount 值，每次访问新元素时都会检查 modCount 和 expectedModCount 是否相等，不相等就会抛出异常。这种机制叫做 fail-fast，所有集合类都有这种机制。</p><hr><h4 id="Q2：说一说-LinkedList"><a href="#Q2：说一说-LinkedList" class="headerlink" title="Q2：说一说 LinkedList"></a>Q2：说一说 LinkedList</h4><p><strong>LinkedList</strong> 本质是双向链表，与 ArrayList 相比插入和删除速度更快，但随机访问元素很慢。除继承 AbstractList 外还实现了 Deque 接口，这个接口具有队列和栈的性质。成员变量被 transient 修饰，原理和 ArrayList 类似。</p><p>LinkedList 包含三个重要的成员：size、first 和 last。size 是双向链表中节点的个数，first 和 last 分别指向首尾节点的引用。</p><p>LinkedList 的优点在于可以将零散的内存单元通过附加引用的方式关联起来，形成按链路顺序查找的线性结构，内存利用率较高。</p><hr><h4 id="Q3：Set-有什么特点，有哪些实现？"><a href="#Q3：Set-有什么特点，有哪些实现？" class="headerlink" title="Q3：Set 有什么特点，有哪些实现？"></a>Q3：Set 有什么特点，有哪些实现？</h4><p><strong>Set</strong> 不允许元素重复且无序，常用实现有 HashSet、LinkedHashSet 和 TreeSet。</p><p><strong>HashSet</strong> 通过 HashMap 实现，HashMap 的 Key 即 HashSet 存储的元素，所有 Key 都使用相同的 Value ，一个名为 PRESENT 的 Object 类型常量。使用 Key 保证元素唯一性，但不保证有序性。由于 HashSet 是 HashMap 实现的，因此线程不安全。</p><p>HashSet 判断元素是否相同时，对于包装类型直接按值比较。对于引用类型先比较 hashCode 是否相同，不同则代表不是同一个对象，相同则继续比较 equals，都相同才是同一个对象。</p><p><strong>LinkedHashSet</strong> 继承自 HashSet，通过 LinkedHashMap 实现，使用双向链表维护元素插入顺序。</p><p><strong>TreeSet</strong> 通过 TreeMap 实现的，添加元素到集合时按照比较规则将其插入合适的位置，保证插入后的集合仍然有序。</p><hr><h4 id="Q4：TreeMap-有什么特点？"><a href="#Q4：TreeMap-有什么特点？" class="headerlink" title="Q4：TreeMap 有什么特点？"></a>Q4：TreeMap 有什么特点？</h4><p>TreeMap 基于红黑树实现，增删改查的平均和最差时间复杂度均为 O(log<del>n</del>) ，最大特点是 Key 有序。Key 必须实现 Comparable 接口或提供的 Comparator 比较器，所以 Key 不允许为 null。</p><p>HashMap 依靠 <code>hashCode</code> 和 <code>equals</code> 去重，而 TreeMap 依靠 Comparable 或 Comparator。 TreeMap 排序时，如果比较器不为空就会优先使用比较器的 <code>compare</code> 方法，否则使用 Key 实现的 Comparable 的 <code>compareTo</code> 方法，两者都不满足会抛出异常。</p><p>TreeMap 通过 <code>put</code> 和 <code>deleteEntry</code> 实现增加和删除树节点。插入新节点的规则有三个：① 需要调整的新节点总是红色的。② 如果插入新节点的父节点是黑色的，不需要调整。③ 如果插入新节点的父节点是红色的，由于红黑树不能出现相邻红色，进入循环判断，通过重新着色或左右旋转来调整。TreeMap 的插入操作就是按照 Key 的对比往下遍历，大于节点值向右查找，小于向左查找，先按照二叉查找树的特性操作，后续会重新着色和旋转，保持红黑树的特性。</p><hr><h4 id="Q5：HashMap-有什么特点？"><a href="#Q5：HashMap-有什么特点？" class="headerlink" title="Q5：HashMap 有什么特点？"></a>Q5：HashMap 有什么特点？</h4><p>JDK8 之前底层实现是数组 + 链表，JDK8 改为数组 + 链表/红黑树，节点类型从Entry 变更为 Node。主要成员变量包括存储数据的 table 数组、元素数量 size、加载因子 loadFactor。</p><p>table 数组记录 HashMap 的数据，每个下标对应一条链表，所有哈希冲突的数据都会被存放到同一条链表，Node/Entry 节点包含四个成员变量：key、value、next 指针和 hash 值。</p><p>HashMap 中数据以键值对的形式存在，键对应的 hash 值用来计算数组下标，如果两个元素 key 的 hash 值一样，就会发生哈希冲突，被放到同一个链表上，为使查询效率尽可能高，键的 hash 值要尽可能分散。</p><p>HashMap 默认初始化容量为 16，扩容容量必须是 2 的幂次方、最大容量为 1&lt;&lt; 30 、默认加载因子为 0.75。</p><hr><h4 id="Q6：HashMap-相关方法的源码？"><a href="#Q6：HashMap-相关方法的源码？" class="headerlink" title="Q6：HashMap 相关方法的源码？"></a>Q6：HashMap 相关方法的源码？</h4><p><strong>JDK8 之前</strong></p><p><strong>hash：计算元素 key 的散列值</strong></p><p>① 处理 String 类型时，调用 <code>stringHash32</code> 方法获取 hash 值。</p><p>② 处理其他类型数据时，提供一个相对于 HashMap 实例唯一不变的随机值 hashSeed 作为计算初始量。</p><p>③ 执行异或和无符号右移使 hash 值更加离散，减小哈希冲突概率。</p><p><strong>indexFor：计算元素下标</strong></p><p>将 hash 值和数组长度-1 进行与操作，保证结果不会超过 table 数组范围。</p><p><strong>get：获取元素的 value 值</strong></p><p>① 如果 key 为 null，调用 <code>getForNullKey</code> 方法，如果 size 为 0 表示链表为空，返回 null。如果 size 不为 0 说明存在链表，遍历 table[0] 链表，如果找到了 key 为 null 的节点则返回其 value，否则返回 null。</p><p>② 如果 key 为 不为 null，调用 <code>getEntry</code> 方法，如果 size 为 0 表示链表为空，返回 null 值。如果 size 不为 0，首先计算 key 的 hash 值，然后遍历该链表的所有节点，如果节点的 key 和 hash 值都和要查找的元素相同则返回其 Entry 节点。</p><p>③ 如果找到了对应的 Entry 节点，调用 <code>getValue</code> 方法获取其 value 并返回，否则返回 null。</p><p><strong>put：添加元素</strong></p><p>① 如果 key 为 null，直接存入 table[0]。</p><p>② 如果 key 不为 null，计算 key 的 hash 值。</p><p>③ 调用 <code>indexFor</code> 计算元素存放的下标 i。</p><p>④ 遍历 table[i] 对应的链表，如果 key 已存在，就更新 value 然后返回旧 value。</p><p>⑤ 如果 key 不存在，将 modCount 值加 1，使用 <code>addEntry</code> 方法增加一个节点并返回 null。</p><p><strong>resize：扩容数组</strong></p><p>① 如果当前容量达到了最大容量，将阈值设置为 Integer 最大值，之后扩容不再触发。</p><p>② 否则计算新的容量，将阈值设为 <code>newCapacity x loadFactor</code> 和 <code>最大容量 + 1</code> 的较小值。</p><p>③ 创建一个容量为 newCapacity 的 Entry 数组，调用 <code>transfer</code> 方法将旧数组的元素转移到新数组。</p><p><strong>transfer：转移元素</strong></p><p>① 遍历旧数组的所有元素，调用 <code>rehash</code> 方法判断是否需要哈希重构，如果需要就重新计算元素 key 的 hash 值。</p><p>② 调用 <code>indexFor</code> 方法计算元素存放的下标 i，利用头插法将旧数组的元素转移到新数组。</p><p><strong>JDK8</strong></p><p><strong>hash：计算元素 key 的散列值</strong></p><p>如果 key 为 null 返回 0，否则就将 key 的 <code>hashCode</code> 方法返回值高低16位异或，让尽可能多的位参与运算，让结果的 0 和 1 分布更加均匀，降低哈希冲突概率。</p><p><strong>put：添加元素</strong></p><p>① 调用 <code>putVal</code> 方法添加元素。</p><p>② 如果 table 为空或长度为 0 就进行扩容，否则计算元素下标位置，不存在就调用 <code>newNode</code> 创建一个节点。</p><p>③ 如果存在且是链表，如果首节点和待插入元素的 hash 和 key 都一样，更新节点的 value。</p><p>④ 如果首节点是 TreeNode 类型，调用 <code>putTreeVal</code> 方法增加一个树节点，每一次都比较插入节点和当前节点的大小，待插入节点小就往左子树查找，否则往右子树查找，找到空位后执行两个方法：<code>balanceInsert</code> 方法，插入节点并调整平衡、<code>moveRootToFront</code> 方法，由于调整平衡后根节点可能变化，需要重置根节点。</p><p>⑤ 如果都不满足，遍历链表，根据 hash 和 key 判断是否重复，决定更新 value 还是新增节点。如果遍历到了链表末尾则添加节点，如果达到建树阈值 7，还需要调用 <code>treeifyBin</code> 把链表重构为红黑树。</p><p>⑥ 存放元素后将 modCount 加 1，如果 <code>++size &gt; threshold</code> ，调用 <code>resize</code> 扩容。</p><p><strong>get ：获取元素的 value 值</strong></p><p>① 调用 <code>getNode</code> 方法获取 Node 节点，如果不是 null 就返回其 value 值，否则返回 null。</p><p>② <code>getNode</code> 方法中如果数组不为空且存在元素，先比较第一个节点和要查找元素的 hash 和 key ，如果都相同则直接返回。</p><p>③ 如果第二个节点是 TreeNode 类型则调用 <code>getTreeNode</code> 方法进行查找，否则遍历链表根据 hash 和 key 查找，如果没有找到就返回 null。</p><p><strong>resize：扩容数组</strong></p><p>重新规划长度和阈值，如果长度发生了变化，部分数据节点也要重新排列。</p><p><strong>重新规划长度</strong></p><p>① 如果当前容量 <code>oldCap &gt; 0</code> 且达到最大容量，将阈值设为 Integer 最大值，return 终止扩容。</p><p>② 如果未达到最大容量，当 <code>oldCap &lt;&lt; 1</code> 不超过最大容量就扩大为 2 倍。</p><p>③ 如果都不满足且当前扩容阈值 <code>oldThr &gt; 0</code>，使用当前扩容阈值作为新容量。</p><p>④ 否则将新容量置为默认初始容量 16，新扩容阈值置为 12。</p><p><strong>重新排列数据节点</strong></p><p>① 如果节点为 null 不进行处理。</p><p>② 如果节点不为 null 且没有next节点，那么通过节点的 hash 值和 <code>新容量-1</code> 进行与运算计算下标存入新的 table 数组。</p><p>③ 如果节点为 TreeNode 类型，调用 <code>split</code> 方法处理，如果节点数 hc 达到6 会调用 <code>untreeify</code> 方法转回链表。</p><p>④ 如果是链表节点，需要将链表拆分为 hash 值超出旧容量的链表和未超出容量的链表。对于<code>hash &amp; oldCap == 0</code> 的部分不需要做处理，否则需要放到新的下标位置上，新下标 = 旧下标 + 旧容量。</p><hr><h4 id="Q7：HashMap-为什么线程不安全？"><a href="#Q7：HashMap-为什么线程不安全？" class="headerlink" title="Q7：HashMap 为什么线程不安全？"></a>Q7：HashMap 为什么线程不安全？</h4><p>JDK7 存在死循环和数据丢失问题。</p><p><strong>数据丢失：</strong></p><ul><li><strong>并发赋值被覆盖：</strong> 在 <code>createEntry</code> 方法中，新添加的元素直接放在头部，使元素之后可以被更快访问，但如果两个线程同时执行到此处，会导致其中一个线程的赋值被覆盖。</li><li><strong>已遍历区间新增元素丢失：</strong> 当某个线程在 <code>transfer</code> 方法迁移时，其他线程新增的元素可能落在已遍历过的哈希槽上。遍历完成后，table 数组引用指向了 newTable，新增元素丢失。</li><li><strong>新表被覆盖：</strong> 如果 <code>resize</code> 完成，执行了 <code>table = newTable</code>，则后续元素就可以在新表上进行插入。但如果多线程同时 <code>resize</code> ，每个线程都会 new 一个数组，这是线程内的局部对象，线程之间不可见。迁移完成后<code>resize</code> 的线程会赋值给 table 线程共享变量，可能会覆盖其他线程的操作，在新表中插入的对象都会被丢弃。</li></ul><p><strong>死循环：</strong> 扩容时 <code>resize</code> 调用 <code>transfer</code> 使用头插法迁移元素，虽然 newTable 是局部变量，但原先 table 中的 Entry 链表是共享的，问题根源是 Entry 的 next 指针并发修改，某线程还没有将 table 设为 newTable 时用完了 CPU 时间片，导致数据丢失或死循环。</p><p>JDK8 在 <code>resize</code> 方法中完成扩容，并改用尾插法，不会产生死循环，但并发下仍可能丢失数据。可用 ConcurrentHashMap 或 <code>Collections.synchronizedMap</code> 包装成同步集合。</p><hr><h3 id="IO-流-6"><a href="#IO-流-6" class="headerlink" title="IO 流 6"></a>IO 流 6</h3><h4 id="Q1：同步-异步-阻塞-非阻塞-IO-的区别？"><a href="#Q1：同步-异步-阻塞-非阻塞-IO-的区别？" class="headerlink" title="Q1：同步/异步/阻塞/非阻塞 IO 的区别？"></a>Q1：同步/异步/阻塞/非阻塞 IO 的区别？</h4><p>同步和异步是通信机制，阻塞和非阻塞是调用状态。</p><p>同步 IO 是用户线程发起 IO 请求后需要等待或轮询内核 IO 操作完成后才能继续执行。异步 IO 是用户线程发起 IO 请求后可以继续执行，当内核 IO 操作完成后会通知用户线程，或调用用户线程注册的回调函数。</p><p>阻塞 IO 是 IO 操作需要彻底完成后才能返回用户空间 。非阻塞 IO 是 IO 操作调用后立即返回一个状态值，无需等 IO 操作彻底完成。</p><hr><h4 id="Q2：什么是-BIO？"><a href="#Q2：什么是-BIO？" class="headerlink" title="Q2：什么是 BIO？"></a>Q2：什么是 BIO？</h4><p><strong>BIO</strong> 是同步阻塞式 IO，JDK1.4 之前的 IO 模型。服务器实现模式为一个连接请求对应一个线程，服务器需要为每一个客户端请求创建一个线程，如果这个连接不做任何事会造成不必要的线程开销。可以通过线程池改善，这种 IO 称为伪异步 IO。适用连接数目少且服务器资源多的场景。</p><hr><h4 id="Q3：什么是-NIO？"><a href="#Q3：什么是-NIO？" class="headerlink" title="Q3：什么是 NIO？"></a>Q3：什么是 NIO？</h4><p><strong>NIO</strong> 是 JDK1.4 引入的同步非阻塞 IO。服务器实现模式为多个连接请求对应一个线程，客户端连接请求会注册到一个多路复用器 Selector ，Selector 轮询到连接有 IO 请求时才启动一个线程处理。适用连接数目多且连接时间短的场景。</p><p>同步是指线程还是要不断接收客户端连接并处理数据，非阻塞是指如果一个管道没有数据，不需要等待，可以轮询下一个管道。</p><p>核心组件：</p><ul><li><p><strong>Selector：</strong> 多路复用器，轮询检查多个 Channel 的状态，判断注册事件是否发生，即判断 Channel 是否处于可读或可写状态。使用前需要将 Channel 注册到 Selector，注册后会得到一个 SelectionKey，通过 SelectionKey 获取 Channel 和 Selector 相关信息。</p></li><li><p><strong>Channel：</strong> 双向通道，替换了 BIO 中的 Stream 流，不能直接访问数据，要通过 Buffer 来读写数据，也可以和其他 Channel 交互。</p></li><li><p><strong>Buffer：</strong> 缓冲区，本质是一块可读写数据的内存，用来简化数据读写。Buffer 三个重要属性：position 下次读写数据的位置，limit 本次读写的极限位置，capacity 最大容量。</p><ul><li><code>flip</code> 将写转为读，底层实现原理把 position 置 0，并把 limit 设为当前的 position 值。 </li><li><code>clear</code> 将读转为写模式（用于读完全部数据的情况，把 position 置 0，limit 设为 capacity）。 </li><li><code>compact</code> 将读转为写模式（用于存在未读数据的情况，让 position 指向未读数据的下一个）。 </li><li>通道方向和 Buffer 方向相反，读数据相当于向 Buffer 写，写数据相当于从 Buffer 读。 </li></ul><p>使用步骤：向 Buffer 写数据，调用 flip 方法转为读模式，从 Buffer 中读数据，调用 clear 或 compact 方法清空缓冲区。</p></li></ul><hr><h4 id="Q4：什么是-AIO？"><a href="#Q4：什么是-AIO？" class="headerlink" title="Q4：什么是 AIO？"></a>Q4：什么是 AIO？</h4><p>AIO 是 JDK7 引入的异步非阻塞 IO。服务器实现模式为一个有效请求对应一个线程，客户端的 IO 请求都是由操作系统先完成 IO 操作后再通知服务器应用来直接使用准备好的数据。适用连接数目多且连接时间长的场景。</p><p>异步是指服务端线程接收到客户端管道后就交给底层处理IO通信，自己可以做其他事情，非阻塞是指客户端有数据才会处理，处理好再通知服务器。</p><p>实现方式包括通过 Future 的 <code>get</code> 方法进行阻塞式调用以及实现 CompletionHandler 接口，重写请求成功的回调方法 <code>completed</code> 和请求失败回调方法 <code>failed</code>。</p><hr><h4 id="Q5：java-io-包下有哪些流？"><a href="#Q5：java-io-包下有哪些流？" class="headerlink" title="Q5：java.io 包下有哪些流？"></a>Q5：java.io 包下有哪些流？</h4><p>主要分为字符流和字节流，字符流一般用于文本文件，字节流一般用于图像或其他文件。</p><p>字符流包括了字符输入流 Reader 和字符输出流 Writer，字节流包括了字节输入流 InputStream 和字节输出流 OutputStream。字符流和字节流都有对应的缓冲流，字节流也可以包装为字符流，缓冲流带有一个 8KB 的缓冲数组，可以提高流的读写效率。除了缓冲流外还有过滤流 FilterReader、字符数组流 CharArrayReader、字节数组流 ByteArrayInputStream、文件流 FileInputStream 等。</p><hr><h4 id="Q6：序列化和反序列化是什么？"><a href="#Q6：序列化和反序列化是什么？" class="headerlink" title="Q6：序列化和反序列化是什么？"></a>Q6：序列化和反序列化是什么？</h4><p>Java 对象 JVM 退出时会全部销毁，如果需要将对象及状态持久化，就要通过序列化实现，将内存中的对象保存在二进制流中，需要时再将二进制流反序列化为对象。对象序列化保存的是对象的状态，因此属于类属性的静态变量不会被序列化。</p><p>常见的序列化有三种：</p><ul><li><p><strong>Java 原生序列化</strong></p><p>实现 <code>Serializabale</code> 标记接口，Java 序列化保留了对象类的元数据（如类、成员变量、继承类信息）以及对象数据，兼容性最好，但不支持跨语言，性能一般。序列化和反序列化必须保持序列化 ID 的一致，一般使用 <code>private static final long serialVersionUID</code> 定义序列化 ID，如果不设置编译器会根据类的内部实现自动生成该值。如果是兼容升级不应该修改序列化 ID，防止出错，如果是不兼容升级则需要修改。</p></li><li><p><strong>Hessian 序列化</strong></p><p>Hessian 序列化是一种支持动态类型、跨语言、基于对象传输的网络协议。Java 对象序列化的二进制流可以被其它语言反序列化。Hessian 协议的特性：① 自描述序列化类型，不依赖外部描述文件，用一个字节表示常用基础类型，极大缩短二进制流。② 语言无关，支持脚本语言。③ 协议简单，比 Java 原生序列化高效。Hessian 会把复杂对象所有属性存储在一个 Map 中序列化，当父类和子类存在同名成员变量时会先序列化子类再序列化父类，因此子类值会被父类覆盖。</p></li><li><p><strong>JSON 序列化</strong></p><p>JSON 序列化就是将数据对象转换为 JSON 字符串，在序列化过程中抛弃了类型信息，所以反序列化时只有提供类型信息才能准确进行。相比前两种方式可读性更好，方便调试。</p></li></ul><p>序列化通常会使用网络传输对象，而对象中往往有敏感数据，容易遭受攻击，Jackson 和 fastjson 等都出现过反序列化漏洞，因此不需要进行序列化的敏感属性传输时应加上 transient 关键字。transient 的作用就是把变量生命周期仅限于内存而不会写到磁盘里持久化，变量会被设为对应数据类型的零值。</p><hr><h2 id="JVM-32"><a href="#JVM-32" class="headerlink" title="JVM 32"></a>JVM 32</h2><h3 id="内存区域划分-8"><a href="#内存区域划分-8" class="headerlink" title="内存区域划分 8"></a>内存区域划分 8</h3><h4 id="Q1：运行时数据区是什么？"><a href="#Q1：运行时数据区是什么？" class="headerlink" title="Q1：运行时数据区是什么？"></a>Q1：运行时数据区是什么？</h4><p>虚拟机在执行 Java 程序的过程中会把它所管理的内存划分为若干不同的数据区，这些区域有各自的用途、创建和销毁时间。</p><p>线程私有：程序计数器、Java 虚拟机栈、本地方法栈。</p><p>线程共享：Java 堆、方法区。</p><hr><h4 id="Q2：程序计数器是什么？"><a href="#Q2：程序计数器是什么？" class="headerlink" title="Q2：程序计数器是什么？"></a>Q2：程序计数器是什么？</h4><p><strong>程序计数器</strong>是一块较小的内存空间，可以看作当前线程所执行字节码的行号指示器。字节码解释器工作时通过改变计数器的值选取下一条执行指令。分支、循环、跳转、线程恢复等功能都需要依赖计数器完成。是唯一在虚拟机规范中没有规定内存溢出情况的区域。</p><p>如果线程正在执行 Java 方法，计数器记录正在执行的虚拟机字节码指令地址。如果是本地方法，计数器值为 Undefined。</p><hr><h4 id="Q3：Java-虚拟机栈的作用？"><a href="#Q3：Java-虚拟机栈的作用？" class="headerlink" title="Q3：Java 虚拟机栈的作用？"></a>Q3：Java 虚拟机栈的作用？</h4><p><strong>Java 虚拟机栈</strong>来描述 Java 方法的内存模型。每当有新线程创建时就会分配一个栈空间，线程结束后栈空间被回收，栈与线程拥有相同的生命周期。栈中元素用于支持虚拟机进行方法调用，每个方法在执行时都会创建一个栈帧存储方法的局部变量表、操作栈、动态链接和方法出口等信息。每个方法从调用到执行完成，就是栈帧从入栈到出栈的过程。</p><p>有两类异常：① 线程请求的栈深度大于虚拟机允许的深度抛出 StackOverflowError。② 如果 JVM 栈容量可以动态扩展，栈扩展无法申请足够内存抛出 OutOfMemoryError（HotSpot 不可动态扩展，不存在此问题）。</p><hr><h4 id="Q4：本地方法栈的作用？"><a href="#Q4：本地方法栈的作用？" class="headerlink" title="Q4：本地方法栈的作用？"></a>Q4：本地方法栈的作用？</h4><p><strong>本地方法栈</strong>与虚拟机栈作用相似，不同的是虚拟机栈为虚拟机执行 Java 方法服务，本地方法栈为虚本地方法服务。调用本地方法时虚拟机栈保持不变，动态链接并直接调用指定本地方法。</p><p>虚拟机规范对本地方法栈中方法的语言与数据结构无强制规定，虚拟机可自由实现，例如 HotSpot 将虚拟机栈和本地方法栈合二为一。</p><p>本地方法栈在栈深度异常和栈扩展失败时分别抛出 StackOverflowError 和 OutOfMemoryError。</p><hr><h4 id="Q5：堆的作用是什么？"><a href="#Q5：堆的作用是什么？" class="headerlink" title="Q5：堆的作用是什么？"></a>Q5：堆的作用是什么？</h4><p><strong>堆</strong>是虚拟机所管理的内存中最大的一块，被所有线程共享的，在虚拟机启动时创建。堆用来存放对象实例，Java 里几乎所有对象实例都在堆分配内存。堆可以处于物理上不连续的内存空间，逻辑上应该连续，但对于例如数组这样的大对象，多数虚拟机实现出于简单、存储高效的考虑会要求连续的内存空间。</p><p>堆既可以被实现成固定大小，也可以是可扩展的，可通过 <code>-Xms</code> 和 <code>-Xmx</code> 设置堆的最小和最大容量，当前主流 JVM 都按照可扩展实现。如果堆没有内存完成实例分配也无法扩展，抛出 OutOfMemoryError。</p><hr><h4 id="Q6：方法区的作用是什么？"><a href="#Q6：方法区的作用是什么？" class="headerlink" title="Q6：方法区的作用是什么？"></a>Q6：方法区的作用是什么？</h4><p><strong>方法区</strong>用于存储被虚拟机加载的类型信息、常量、静态变量、即时编译器编译后的代码缓存等数据。</p><p>JDK8 之前使用永久代实现方法区，容易内存溢出，因为永久代有 <code>-XX:MaxPermSize</code> 上限，即使不设置也有默认大小。JDK7 把放在永久代的字符串常量池、静态变量等移出，JDK8 中永久代完全废弃，改用在本地内存中实现的元空间代替，把 JDK 7 中永久代剩余内容（主要是类型信息）全部移到元空间。</p><p>虚拟机规范对方法区的约束宽松，除和堆一样不需要连续内存和可选择固定大小/可扩展外，还可以不实现垃圾回收。垃圾回收在方法区出现较少，主要目标针对常量池和类型卸载。如果方法区无法满足新的内存分配需求，将抛出 OutOfMemoryError。</p><hr><h4 id="Q7：运行时常量池的作用是什么"><a href="#Q7：运行时常量池的作用是什么" class="headerlink" title="Q7：运行时常量池的作用是什么?"></a>Q7：运行时常量池的作用是什么?</h4><p>运行时常量池是方法区的一部分，Class 文件中除了有类的版本、字段、方法、接口等描述信息外，还有一项信息是常量池表，用于存放编译器生成的各种字面量与符号引用，这部分内容在类加载后存放到运行时常量池。一般除了保存 Class 文件中描述的符号引用外，还会把符号引用翻译的直接引用也存储在运行时常量池。</p><p>运行时常量池相对于 Class 文件常量池的一个重要特征是动态性，Java 不要求常量只有编译期才能产生，运行期间也可以将新的常量放入池中，这种特性利用较多的是 String 的 <code>intern</code> 方法。</p><p>运行时常量池是方法区的一部分，受到方法区内存的限制，当常量池无法再申请到内存时会抛出 OutOfMemoryError。</p><hr><h4 id="Q8：直接内存是什么？"><a href="#Q8：直接内存是什么？" class="headerlink" title="Q8：直接内存是什么？"></a>Q8：直接内存是什么？</h4><p>直接内存不属于运行时数据区，也不是虚拟机规范定义的内存区域，但这部分内存被频繁使用，而且可能导致内存溢出。</p><p>JDK1.4 中新加入了 NIO 这种基于通道与缓冲区的 IO，它可以使用 Native 函数库直接分配堆外内存，通过一个堆里的 DirectByteBuffer 对象作为内存的引用进行操作，避免了在 Java 堆和 Native堆来回复制数据。</p><p>直接内存的分配不受 Java 堆大小的限制，但还是会受到本机总内存及处理器寻址空间限制，一般配置虚拟机参数时会根据实际内存设置 <code>-Xmx</code> 等参数信息，但经常忽略直接内存，使内存区域总和大于物理内存限制，导致动态扩展时出现 OOM。</p><p>由直接内存导致的内存溢出，一个明显的特征是在 Heap Dump 文件中不会看见明显的异常，如果发现内存溢出后产生的 Dump 文件很小，而程序中又直接或间接使用了直接内存（典型的间接使用就是 NIO），那么就可以考虑检查直接内存方面的原因。</p><hr><h3 id="内存溢出-5"><a href="#内存溢出-5" class="headerlink" title="内存溢出 5"></a>内存溢出 5</h3><h4 id="Q1：内存溢出和内存泄漏的区别？"><a href="#Q1：内存溢出和内存泄漏的区别？" class="headerlink" title="Q1：内存溢出和内存泄漏的区别？"></a>Q1：内存溢出和内存泄漏的区别？</h4><p>内存溢出 OutOfMemory，指程序在申请内存时，没有足够的内存空间供其使用。</p><p>内存泄露 Memory Leak，指程序在申请内存后，无法释放已申请的内存空间，内存泄漏最终将导致内存溢出。</p><hr><h4 id="Q2：堆溢出的原因？"><a href="#Q2：堆溢出的原因？" class="headerlink" title="Q2：堆溢出的原因？"></a>Q2：堆溢出的原因？</h4><p>堆用于存储对象实例，只要不断创建对象并保证 GC Roots 到对象有可达路径避免垃圾回收，随着对象数量的增加，总容量触及最大堆容量后就会 OOM，例如在 while 死循环中一直 new 创建实例。</p><p>堆 OOM 是实际应用中最常见的 OOM，处理方法是通过内存映像分析工具对 Dump 出的堆转储快照分析，确认内存中导致 OOM 的对象是否必要，分清到底是内存泄漏还是内存溢出。</p><p>如果是内存泄漏，通过工具查看泄漏对象到 GC Roots 的引用链，找到泄露对象是通过怎样的引用路径、与哪些 GC Roots 关联才导致无法回收，一般可以准确定位到产生内存泄漏代码的具***置。</p><p>如果不是内存泄漏，即内存中对象都必须存活，应当检查 JVM 堆参数，与机器内存相比是否还有向上调整的空间。再从代码检查是否存在某些对象生命周期过长、持有状态时间过长、存储结构设计不合理等情况，尽量减少程序运行期的内存消耗。</p><hr><h4 id="Q3：栈溢出的原因？"><a href="#Q3：栈溢出的原因？" class="headerlink" title="Q3：栈溢出的原因？"></a>Q3：栈溢出的原因？</h4><p>由于 HotSpot 不区分虚拟机和本地方法栈，设置本地方法栈大小的参数没有意义，栈容量只能由 <code>-Xss</code> 参数来设定，存在两种异常：</p><p><strong>StackOverflowError：</strong> 如果线程请求的栈深度大于虚拟机所允许的深度，将抛出 StackOverflowError，例如一个递归方法不断调用自己。该异常有明确错误堆栈可供分析，容易定位到问题所在。</p><p><strong>OutOfMemoryError：</strong> 如果 JVM 栈可以动态扩展，当扩展无法申请到足够内存时会抛出 OutOfMemoryError。HotSpot 不支持虚拟机栈扩展，所以除非在创建线程申请内存时就因无法获得足够内存而出现 OOM，否则在线程运行时是不会因为扩展而导致溢出的。</p><hr><h4 id="Q4：运行时常量池溢出的原因？"><a href="#Q4：运行时常量池溢出的原因？" class="headerlink" title="Q4：运行时常量池溢出的原因？"></a>Q4：运行时常量池溢出的原因？</h4><p>String 的 <code>intern</code> 方法是一个本地方法，作用是如果字符串常量池中已包含一个等于此 String 对象的字符串，则返回池中这个字符串的 String 对象的引用，否则将此 String 对象包含的字符串添加到常量池并返回此 String 对象的引用。</p><p>在 JDK6 及之前常量池分配在永久代，因此可以通过 <code>-XX:PermSize</code> 和 <code>-XX:MaxPermSize</code> 限制永久代大小，间接限制常量池。在 while 死循环中调用 <code>intern</code> 方法导致运行时常量池溢出。在 JDK7 后不会出现该问题，因为存放在永久代的字符串常量池已经被移至堆中。</p><hr><h4 id="Q5：方法区溢出的原因？"><a href="#Q5：方法区溢出的原因？" class="headerlink" title="Q5：方法区溢出的原因？"></a>Q5：方法区溢出的原因？</h4><p>方法区主要存放类型信息，如类名、访问修饰符、常量池、字段描述、方法描述等。只要不断在运行时产生大量类，方法区就会溢出。例如使用 JDK 反射或 CGLib 直接操作字节码在运行时生成大量的类。很多框架如 Spring、Hibernate 等对类增强时都会使用 CGLib 这类字节码技术，增强的类越多就需要越大的方法区保证动态生成的新类型可以载入内存，也就更容易导致方法区溢出。</p><p>JDK8 使用元空间取代永久代，HotSpot 提供了一些参数作为元空间防御措施，例如 <code>-XX:MetaspaceSize</code> 指定元空间初始大小，达到该值会触发 GC 进行类型卸载，同时收集器会对该值进行调整，如果释放大量空间就适当降低该值，如果释放很少空间就适当提高。</p><hr><h3 id="创建对象-5"><a href="#创建对象-5" class="headerlink" title="创建对象 5"></a>创建对象 5</h3><h4 id="Q1：创建对象的过程是什么？"><a href="#Q1：创建对象的过程是什么？" class="headerlink" title="Q1：创建对象的过程是什么？"></a>Q1：创建对象的过程是什么？</h4><p><strong>字节码角度</strong></p><ul><li><strong>NEW：</strong> 如果找不到 Class 对象则进行类加载。加载成功后在堆中分配内存，从 Object 到本类路径上的所有属性都要分配。分配完毕后进行零值设置。最后将指向实例对象的引用变量压入虚拟机栈顶。 </li><li>*<em>DUP： *</em> 在栈顶复制引用变量，这时栈顶有两个指向堆内实例的引用变量。两个引用变量的目的不同，栈底的引用用于赋值或保存局部变量表，栈顶的引用作为句柄调用相关方法。 </li><li><strong>INVOKESPECIAL：</strong> 通过栈顶的引用变量调用 init 方法。 </li></ul><p><strong>执行角度</strong></p><p>① 当 JVM 遇到字节码 new 指令时，首先将检查该指令的参数能否在常量池中定位到一个类的符号引用，并检查引用代表的类是否已被加载、解析和初始化，如果没有就先执行类加载。</p><p>② 在类加载检查通过后虚拟机将为新生对象分配内存。</p><p>③ 内存分配完成后虚拟机将成员变量设为零值，保证对象的实例字段可以不赋初值就使用。</p><p>④ 设置对象头，包括哈希码、GC 信息、锁信息、对象所属类的类元信息等。</p><p>⑤ 执行 init 方法，初始化成员变量，执行实例化代码块，调用类的构造方法，并把堆内对象的首地址赋值给引用变量。</p><hr><h4 id="Q2：对象分配内存的方式有哪些？"><a href="#Q2：对象分配内存的方式有哪些？" class="headerlink" title="Q2：对象分配内存的方式有哪些？"></a>Q2：对象分配内存的方式有哪些？</h4><p>对象所需内存大小在类加载完成后便可完全确定，分配空间的任务实际上等于把一块确定大小的内存块从 Java 堆中划分出来。</p><p><strong>指针碰撞：</strong> 假设 Java 堆内存规整，被使用过的内存放在一边，空闲的放在另一边，中间放着一个指针作为分界指示器，分配内存就是把指针向空闲方向挪动一段与对象大小相等的距离。</p><p><strong>空闲列表：</strong> 如果 Java 堆内存不规整，虚拟机必须维护一个列表记录哪些内存可用，在分配时从列表中找到一块足够大的空间划分给对象并更新列表记录。</p><p>选择哪种分配方式由堆是否规整决定，堆是否规整由垃圾收集器是否有空间压缩能力决定。使用 Serial、ParNew 等收集器时，系统采用指针碰撞；使用 CMS 这种基于清除算法的垃圾收集器时，采用空间列表。</p><hr><h4 id="Q3：对象分配内存是否线程安全？"><a href="#Q3：对象分配内存是否线程安全？" class="headerlink" title="Q3：对象分配内存是否线程安全？"></a>Q3：对象分配内存是否线程安全？</h4><p>对象创建十分频繁，即使修改一个指针的位置在并发下也不是线程安全的，可能正给对象 A 分配内存，指针还没来得及修改，对象 B 又使用了指针来分配内存。</p><p>解决方法：① CAS 加失败重试保证更新原子性。② 把内存分配按线程划分在不同空间，即每个线程在 Java 堆中预先分配一小块内存，叫做本地线程分配缓冲 TLAB，哪个线程要分配内存就在对应的 TLAB 分配，TLAB 用完了再进行同步。</p><hr><h4 id="Q4：对象的内存布局了解吗？"><a href="#Q4：对象的内存布局了解吗？" class="headerlink" title="Q4：对象的内存布局了解吗？"></a>Q4：对象的内存布局了解吗？</h4><p>对象在堆内存的存储布局可分为对象头、实例数据和对齐填充。</p><p><strong>对象头</strong>占 12B，包括对象标记和类型指针。对象标记存储对象自身的运行时数据，如哈希码、GC 分代年龄、锁标志、偏向线程 ID 等，这部分占 8B，称为 Mark Word。Mark Word 被设计为动态数据结构，以便在极小的空间存储更多数据，根据对象状态复用存储空间。</p><p>类型指针是对象指向它的类型元数据的指针，占 4B。JVM 通过该指针来确定对象是哪个类的实例。</p><p><strong>实例数据</strong>是对象真正存储的有效信息，即本类对象的实例成员变量和所有可见的父类成员变量。存储顺序会受到虚拟机分配策略参数和字段在源码中定义顺序的影响。相同宽度的字段总是被分配到一起存放，在满足该前提条件的情况下父类中定义的变量会出现在子类之前。</p><p><strong>对齐填充</strong>不是必然存在的，仅起占位符作用。虚拟机的自动内存管理系统要求任何对象的大小必须是 8B 的倍数，对象头已被设为 8B 的 1 或 2 倍，如果对象实例数据部分没有对齐，需要对齐填充补全。</p><hr><h4 id="Q5：对象的访问方式有哪些？"><a href="#Q5：对象的访问方式有哪些？" class="headerlink" title="Q5：对象的访问方式有哪些？"></a>Q5：对象的访问方式有哪些？</h4><p>Java 程序会通过栈上的 reference 引用操作堆对象，访问方式由虚拟机决定，主流访问方式主要有句柄和直接指针。</p><p><strong>句柄：</strong> 堆会划分出一块内存作为句柄池，reference 中存储对象的句柄地址，句柄包含对象实例数据与类型数据的地址信息。优点是 reference 中存储的是稳定句柄地址，在 GC 过程中对象被移动时只会改变句柄的实例数据指针，而 reference 本身不需要修改。</p><p><strong>直接指针：</strong> 堆中对象的内存布局就必须考虑如何放置访问类型数据的相关信息，reference 存储对象地址，如果只是访问对象本身就不需要多一次间接访问的开销。优点是速度更快，节省了一次指针定位的时间开销，HotSpot 主要使用直接指针进行对象访问。</p><hr><h3 id="垃圾回收-7"><a href="#垃圾回收-7" class="headerlink" title="垃圾回收 7"></a>垃圾回收 7</h3><h4 id="Q1：如何判断对象是否是垃圾？"><a href="#Q1：如何判断对象是否是垃圾？" class="headerlink" title="Q1：如何判断对象是否是垃圾？"></a>Q1：如何判断对象是否是垃圾？</h4><p><strong>引用计数：</strong>在对象中添加一个引用计数器，如果被引用计数器加 1，引用失效时计数器减 1，如果计数器为 0 则被标记为垃圾。原理简单，效率高，但是在 Java 中很少使用，因为存在对象间循环引用的问题，导致计数器无法清零。</p><p><strong>可达性分析：</strong>主流语言的内存管理都使用可达性分析判断对象是否存活。基本思路是通过一系列称为 GC Roots 的根对象作为起始节点集，从这些节点开始，根据引用关系向下搜索，搜索过程走过的路径称为引用链，如果某个对象到 GC Roots 没有任何引用链相连，则会被标记为垃圾。可作为 GC Roots 的对象包括虚拟机栈和本地方法栈中引用的对象、类静态属性引用的对象、常量引用的对象。</p><hr><h4 id="Q2：Java-的引用有哪些类型？"><a href="#Q2：Java-的引用有哪些类型？" class="headerlink" title="Q2：Java 的引用有哪些类型？"></a>Q2：Java 的引用有哪些类型？</h4><p>JDK1.2 后对引用进行了扩充，按强度分为四种：</p><p><strong>强引用：</strong> 最常见的引用，例如 <code>Object obj = new Object()</code> 就属于强引用。只要对象有强引用指向且 GC Roots 可达，在内存回收时即使濒临内存耗尽也不会被回收。</p><p><strong>软引用：</strong> 弱于强引用，描述非必需对象。在系统将发生内存溢出前，会把软引用关联的对象加入回收范围以获得更多内存空间。用来缓存服务器中间计算结果及不需要实时保存的用户行为等。</p><p><strong>弱引用：</strong> 弱于软引用，描述非必需对象。弱引用关联的对象只能生存到下次 YGC 前，当垃圾收集器开始工作时无论当前内存是否足够都会回收只被弱引用关联的对象。由于 YGC 具有不确定性，因此弱引用何时被回收也不确定。</p><p><strong>虚引用：</strong> 最弱的引用，定义完成后无法通过该引用获取对象。唯一目的就是为了能在对象被回收时收到一个系统通知。虚引用必须与引用队列联合使用，垃圾回收时如果出现虚引用，就会在回收对象前把这个虚引用加入引用队列。</p><hr><h4 id="Q3：有哪些-GC-算法？"><a href="#Q3：有哪些-GC-算法？" class="headerlink" title="Q3：有哪些 GC 算法？"></a>Q3：有哪些 GC 算法？</h4><p><strong>标记-清除算法</strong></p><p>分为标记和清除阶段，首先从每个 GC Roots 出发依次标记有引用关系的对象，最后清除没有标记的对象。</p><p>执行效率不稳定，如果堆包含大量对象且大部分需要回收，必须进行大量标记清除，导致效率随对象数量增长而降低。</p><p>存在内存空间碎片化问题，会产生大量不连续的内存碎片，导致以后需要分配大对象时容易触发 Full GC。</p><p><strong>标记-复制算法</strong></p><p>为了解决内存碎片问题，将可用内存按容量划分为大小相等的两块，每次只使用其中一块。当使用的这块空间用完了，就将存活对象复制到另一块，再把已使用过的内存空间一次清理掉。主要用于进行新生代。</p><p>实现简单、运行高效，解决了内存碎片问题。 代价是可用内存缩小为原来的一半，浪费空间。</p><p>HotSpot 把新生代划分为一块较大的 Eden 和两块较小的 Survivor，每次分配内存只使用 Eden 和其中一块 Survivor。垃圾收集时将 Eden 和 Survivor 中仍然存活的对象一次性复制到另一块 Survivor 上，然后直接清理掉 Eden 和已用过的那块 Survivor。HotSpot 默认Eden 和 Survivor 的大小比例是 8:1，即每次新生代中可用空间为整个新生代的 90%。</p><p><strong>标记-整理算法</strong></p><p>标记-复制算法在对象存活率高时要进行较多复制操作，效率低。如果不想浪费空间，就需要有额外空间分配担保，应对被使用内存中所有对象都存活的极端情况，所以老年代一般不使用此算法。</p><p>老年代使用标记-整理算法，标记过程与标记-清除算法一样，但不直接清理可回收对象，而是让所有存活对象都向内存空间一端移动，然后清理掉边界以外的内存。</p><p>标记-清除与标记-整理的差异在于前者是一种非移动式算法而后者是移动式的。如果移动存活对象，尤其是在老年代这种每次回收都有大量对象存活的区域，是一种极为负重的操作，而且移动必须全程暂停用户线程。如果不移动对象就会导致空间碎片问题，只能依赖更复杂的内存分配器和访问器解决。</p><hr><h4 id="Q4：你知道哪些垃圾收集器？"><a href="#Q4：你知道哪些垃圾收集器？" class="headerlink" title="Q4：你知道哪些垃圾收集器？"></a>Q4：你知道哪些垃圾收集器？</h4><p><strong>Serial</strong></p><p>最基础的收集器，使用复制算法、单线程工作，只用一个处理器或一条线程完成垃圾收集，进行垃圾收集时必须暂停其他所有工作线程。</p><p>Serial 是虚拟机在客户端模式的默认新生代收集器，简单高效，对于内存受限的环境它是所有收集器中额外内存消耗最小的，对于处理器核心较少的环境，Serial 由于没有线程交互开销，可获得最高的单线程收集效率。</p><p><strong>ParNew</strong></p><p>Serial 的多线程版本，除了使用多线程进行垃圾收集外其余行为完全一致。</p><p>ParNew 是虚拟机在服务端模式的默认新生代收集器，一个重要原因是除了 Serial 外只有它能与 CMS 配合。自从 JDK 9 开始，ParNew 加 CMS 不再是官方推荐的解决方案，官方希望它被 G1 取代。</p><p><strong>Parallel Scavenge</strong></p><p>新生代收集器，基于复制算法，是可并行的多线程收集器，与 ParNew 类似。</p><p>特点是它的关注点与其他收集器不同，Parallel Scavenge 的目标是达到一个可控制的吞吐量，吞吐量就是处理器用于运行用户代码的时间与处理器消耗总时间的比值。</p><p><strong>Serial Old</strong></p><p>Serial 的老年代版本，单线程工作，使用标记-整理算法。</p><p>Serial Old 是虚拟机在客户端模式的默认老年代收集器，用于服务端有两种用途：① JDK5 及之前与 Parallel Scavenge 搭配。② 作为CMS 失败预案。</p><p><strong>Parellel Old</strong></p><p>Parallel Scavenge 的老年代版本，支持多线程，基于标记-整理算法。JDK6 提供，注重吞吐量可考虑 Parallel Scavenge 加 Parallel Old。</p><p><strong>CMS</strong></p><p>以获取最短回收停顿时间为目标，基于标记-清除算法，过程相对复杂，分为四个步骤：初始标记、并发标记、重新标记、并发清除。</p><p>初始标记和重新标记需要 STW（Stop The World，系统停顿），初始标记仅是标记 GC Roots 能直接关联的对象，速度很快。并发标记从 GC Roots 的直接关联对象开始遍历整个对象图，耗时较长但不需要停顿用户线程。重新标记则是为了修正并发标记期间因用户程序运作而导致标记产生变动的那部分记录。并发清除清理标记阶段判断的已死亡对象，不需要移动存活对象，该阶段也可与用户线程并发。</p><p>缺点：① 对处理器资源敏感，并发阶段虽然不会导致用户线程暂停，但会降低吞吐量。② 无法处理浮动垃圾，有可能出现并发失败而导致 Full GC。③ 基于标记-清除算法，产生空间碎片。</p><p><strong>G1</strong></p><p>开创了收集器面向局部收集的设计思路和基于 Region 的内存布局，主要面向服务端，最初设计目标是替换 CMS。</p><p>G1 之前的收集器，垃圾收集目标要么是整个新生代，要么是整个老年代或整个堆。而 G1 可面向堆任何部分来组成回收集进行回收，衡量标准不再是分代，而是哪块内存中存放的垃圾数量最多，回收受益最大。</p><p>跟踪各 Region 里垃圾的价值，价值即回收所获空间大小以及回收所需时间的经验值，在后台维护一个优先级列表，每次根据用户设定允许的收集停顿时间优先处理回收价值最大的 Region。这种方式保证了 G1 在有限时间内获取尽可能高的收集效率。</p><p>G1 运作过程：</p><ul><li><strong>初始标记：</strong>标记 GC Roots 能直接关联到的对象，让下一阶段用户线程并发运行时能正确地在可用 Region 中分配新对象。需要 STW 但耗时很短，在 Minor GC 时同步完成。 </li><li><strong>并发标记：</strong>从 GC Roots 开始对堆中对象进行可达性分析，递归扫描整个堆的对象图。耗时长但可与用户线程并发，扫描完成后要重新处理 SATB 记录的在并发时有变动的对象。 </li><li><strong>最终标记：</strong>对用户线程做短暂暂停，处理并发阶段结束后仍遗留下来的少量 SATB 记录。 </li><li><strong>筛选回收：</strong>对各 Region 的回收价值排序，根据用户期望停顿时间制定回收计划。必须暂停用户线程，由多条收集线程并行完成。 </li></ul><p>可由用户指定期望停顿时间是 G1 的一个强大功能，但该值不能设得太低，一般设置为100~300 ms。</p><hr><h4 id="Q5：ZGC-了解吗？"><a href="#Q5：ZGC-了解吗？" class="headerlink" title="Q5：ZGC 了解吗？"></a>Q5：ZGC 了解吗？</h4><p>JDK11 中加入的具有实验性质的低延迟垃圾收集器，目标是尽可能在不影响吞吐量的前提下，实现在任意堆内存大小都可以把停顿时间限制在 10ms 以内的低延迟。</p><p>基于 Region 内存布局，不设分代，使用了读屏障、染色指针和内存多重映射等技术实现可并发的标记-整理，以低延迟为首要目标。</p><p>ZGC 的 Region 具有动态性，是动态创建和销毁的，并且容量大小也是动态变化的。</p><hr><h4 id="Q6：你知道哪些内存分配与回收策略？"><a href="#Q6：你知道哪些内存分配与回收策略？" class="headerlink" title="Q6：你知道哪些内存分配与回收策略？"></a>Q6：你知道哪些内存分配与回收策略？</h4><p><strong>对象优先在 Eden 区分配</strong></p><p>大多数情况下对象在新生代 Eden 区分配，当 Eden 没有足够空间时将发起一次 Minor GC。</p><p><strong>大对象直接进入老年代</strong></p><p>大对象指需要大量连续内存空间的对象，典型是很长的字符串或数量庞大的数组。大对象容易导致内存还有不少空间就提前触发垃圾收集以获得足够的连续空间。</p><p>HotSpot 提供了 <code>-XX:PretenureSizeThreshold</code> 参数，大于该值的对象直接在老年代分配，避免在 Eden 和 Survivor 间来回复制。</p><p><strong>长期存活对象进入老年代</strong></p><p>虚拟机给每个对象定义了一个对象年龄计数器，存储在对象头。如果经历过第一次 Minor GC 仍然存活且能被 Survivor 容纳，该对象就会被移动到 Survivor 中并将年龄设置为 1。对象在 Survivor 中每熬过一次 Minor GC 年龄就加 1 ，当增加到一定程度（默认15）就会被晋升到老年代。对象晋升老年代的阈值可通过 <code>-XX:MaxTenuringThreshold</code> 设置。</p><p><strong>动态对象年龄判定</strong></p><p>为了适应不同内存状况，虚拟机不要求对象年龄达到阈值才能晋升老年代，如果在 Survivor 中相同年龄所有对象大小的总和大于 Survivor 的一半，年龄不小于该年龄的对象就可以直接进入老年代。</p><p><strong>空间分配担保</strong></p><p>MinorGC 前虚拟机必须检查老年代最大可用连续空间是否大于新生代对象总空间，如果满足则说明这次 Minor GC 确定安全。</p><p>如果不满足，虚拟机会查看 <code>-XX:HandlePromotionFailure</code> 参数是否允许担保失败，如果允许会继续检查老年代最大可用连续空间是否大于历次晋升老年代对象的平均大小，如果满足将冒险尝试一次 Minor GC，否则改成一次 FullGC。</p><p>冒险是因为新生代使用复制算法，为了内存利用率只使用一个 Survivor，大量对象在 Minor GC 后仍然存活时，需要老年代进行分配担保，接收 Survivor 无法容纳的对象。</p><hr><h4 id="Q7：你知道哪些故障处理工具？"><a href="#Q7：你知道哪些故障处理工具？" class="headerlink" title="Q7：你知道哪些故障处理工具？"></a>Q7：你知道哪些故障处理工具？</h4><p><strong>jps：虚拟机进程状况工具</strong></p><p>功能和 ps 命令类似：可以列出正在运行的虚拟机进程，显示虚拟机执行主类名称以及这些进程的本地虚拟机唯一 ID（LVMID)。LVMID 与操作系统的进程 ID（PID）一致，使用 Windows 的任务管理器或 UNIX 的 ps 命令也可以查询到虚拟机进程的 LVMID，但如果同时启动了多个虚拟机进程，必须依赖 jps 命令。</p><p><strong>jstat：虚拟机统计信息监视工具</strong></p><p>用于监视虚拟机各种运行状态信息。可以显示本地或远程虚拟机进程中的类加载、内存、垃圾收集、即时编译器等运行时数据，在没有 GUI 界面的服务器上是运行期定位虚拟机性能问题的常用工具。</p><p>参数含义：S0 和 S1 表示两个 Survivor，E 表示新生代，O 表示老年代，YGC 表示 Young GC 次数，YGCT 表示 Young GC 耗时，FGC 表示 Full GC 次数，FGCT 表示 Full GC 耗时，GCT 表示 GC 总耗时。</p><p><strong>jinfo：Java 配置信息工具</strong></p><p>实时查看和调整虚拟机各项参数，使用 jps 的 -v 参数可以查看虚拟机启动时显式指定的参数，但如果想知道未显式指定的参数值只能使用 jinfo 的 -flag 查询。</p><p><strong>jmap：Java 内存映像工具</strong></p><p>用于生成堆转储快照，还可以查询 finalize 执行队列、Java 堆和方法区的详细信息，如空间使用率，当前使用的是哪种收集器等。和 jinfo 一样，部分功能在 Windows 受限，除了生成堆转储快照的 -dump 和查看每个类实例的 -histo 外，其余选项只能在 Linux 使用。</p><p><strong>jhat：虚拟机堆转储快照分析工具</strong></p><p>JDK 提供 jhat 与 jmap 搭配使用分析 jmap 生成的堆转储快照。jhat 内置了一个微型的 HTTP/Web 服务器，生成堆转储快照的分析结果后可以在浏览器查看。</p><p><strong>jstack：Java 堆栈跟踪工具</strong></p><p>用于生成虚拟机当前时刻的线程快照。线程快照就是当前虚拟机内每一条线程正在执行的方法堆栈的集合，生成线程快照的目的通常是定位线程出现长时间停顿的原因，如线程间死锁、死循环、请求外部资源导致的长时间挂起等。线程出现停顿时通过 jstack 查看各个线程的调用堆栈，可以获知没有响应的线程在后台做什么或等什么资源。</p><hr><h3 id="类加载机制-7"><a href="#类加载机制-7" class="headerlink" title="类加载机制 7"></a>类加载机制 7</h3><h4 id="Q1：Java-程序是怎样运行的？"><a href="#Q1：Java-程序是怎样运行的？" class="headerlink" title="Q1：Java 程序是怎样运行的？"></a>Q1：Java 程序是怎样运行的？</h4><ul><li><p>首先通过 Javac 编译器将 <code>.java</code> 转为 JVM 可加载的 <code>.class</code> 字节码文件。</p><p>Javac 是由 Java 编写的程序，编译过程可以分为： ① 词法解析，通过空格分割出单词、操作符、控制符等信息，形成 token 信息流，传递给语法解析器。② 语法解析，把 token 信息流按照 Java 语法规则组装成语法树。③ 语义分析，检查关键字使用是否合理、类型是否匹配、作用域是否正确等。④ 字节码生成，将前面各个步骤的信息转换为字节码。</p><p>字节码必须通过类加载过程加载到 JVM 后才可以执行，执行有三种模式，解释执行、JIT 编译执行、JIT 编译与解释器混合执行（主流 JVM 默认执行的方式）。混合模式的优势在于解释器在启动时先解释执行，省去编译时间。</p></li><li><p>之后通过即时编译器 JIT 把字节码文件编译成本地机器码。</p><p>Java 程序最初都是通过解释器进行解释执行的，当虚拟机发现某个方法或代码块的运行特别频繁，就会认定其为”热点代码”，热点代码的检测主要有基于采样和基于计数器两种方式，为了提高热点代码的执行效率，虚拟机会把它们编译成本地机器码，尽可能对代码优化，在运行时完成这个任务的后端编译器被称为即时编译器。</p></li><li><p>还可以通过静态的提前编译器 AOT 直接把程序编译成与目标机器指令集相关的二进制代码。</p></li></ul><hr><h4 id="Q2：类加载是什么？"><a href="#Q2：类加载是什么？" class="headerlink" title="Q2：类加载是什么？"></a>Q2：类加载是什么？</h4><p>Class 文件中描述的各类信息都需要加载到虚拟机后才能使用。JVM 把描述类的数据从 Class 文件加载到内存，并对数据进行校验、解析和初始化，最终形成可以被虚拟机直接使用的 Java 类型，这个过程称为虚拟机的类加载机制。</p><p>与编译时需要连接的语言不同，Java 中类型的加载、连接和初始化都是在运行期间完成的，这增加了性能开销，但却提供了极高的扩展性，Java 动态扩展的语言特性就是依赖运行期动态加载和连接实现的。</p><p>一个类型从被加载到虚拟机内存开始，到卸载出内存为止，整个生命周期经历加载、验证、准备、解析、初始化、使用和卸载七个阶段，其中验证、解析和初始化三个部分称为连接。加载、验证、准备、初始化阶段的顺序是确定的，解析则不一定：可能在初始化之后再开始，这是为了支持 Java 的动态绑定。</p><hr><h4 id="Q3：类初始化的情况有哪些？"><a href="#Q3：类初始化的情况有哪些？" class="headerlink" title="Q3：类初始化的情况有哪些？"></a>Q3：类初始化的情况有哪些？</h4><p>① 遇到 <code>new</code>、<code>getstatic</code>、<code>putstatic</code> 或 <code>invokestatic</code> 字节码指令时，还未初始化。典型场景包括 new 实例化对象、读取或设置静态字段、调用静态方法。</p><p>② 对类反射调用时，还未初始化。</p><p>③ 初始化类时，父类还未初始化。</p><p>④ 虚拟机启动时，会先初始化包含 main 方法的主类。</p><p>⑤ 使用 JDK7 的动态语言支持时，如果 MethodHandle 实例的解析结果为指定类型的方法句柄且句柄对应的类还未初始化。</p><p>⑥ 接口定义了默认方法，如果接口的实现类初始化，接口要在其之前初始化。</p><p>其余所有引用类型的方式都不会触发初始化，称为被动引用。被动引用实例：① 子类使用父类的静态字段时，只有父类被初始化。② 通过数组定义使用类。③ 常量在编译期会存入调用类的常量池，不会初始化定义常量的类。</p><p>接口和类加载过程的区别：初始化类时如果父类没有初始化需要初始化父类，但接口初始化时不要求父接口初始化，只有在真正使用父接口时（如引用接口中定义的常量）才会初始化。</p><hr><h4 id="Q4：类加载的过程是什么？"><a href="#Q4：类加载的过程是什么？" class="headerlink" title="Q4：类加载的过程是什么？"></a>Q4：类加载的过程是什么？</h4><p><strong>加载</strong></p><p>该阶段虚拟机需要完成三件事：① 通过一个类的全限定类名获取定义类的二进制字节流。② 将字节流所代表的静态存储结构转化为方法区的运行时数据区。③ 在内存中生成对应该类的 Class 实例，作为方法区这个类的数据访问入口。</p><p><strong>验证</strong></p><p>确保 Class 文件的字节流符合约束。如果虚拟机不检查输入的字节流，可能因为载入有错误或恶意企图的字节流而导致系统受攻击。验证主要包含四个阶段：文件格式验证、元数据验证、字节码验证、符号引用验证。</p><p>验证重要但非必需，因为只有通过与否的区别，通过后对程序运行期没有任何影响。如果代码已被反复使用和验证过，在生产环境就可以考虑关闭大部分验证缩短类加载时间。</p><p><strong>准备</strong></p><p>为类静态变量分配内存并设置零值，该阶段进行的内存分配仅包括类变量，不包括实例变量。如果变量被 final 修饰，编译时 Javac 会为变量生成 ConstantValue 属性，准备阶段虚拟机会将变量值设为代码值。</p><p><strong>解析</strong></p><p>将常量池内的符号引用替换为直接引用。</p><p><strong>符号引用</strong>以一组符号描述引用目标，可以是任何形式的字面量，只要使用时能无歧义地定位目标即可。与虚拟机内存布局无关，引用目标不一定已经加载到虚拟机内存。</p><p><strong>直接引用</strong>是可以直接指向目标的指针、相对偏移量或能间接定位到目标的句柄。和虚拟机的内存布局相关，引用目标必须已在虚拟机的内存中存在。</p><p><strong>初始化</strong></p><p>直到该阶段 JVM 才开始执行类中编写的代码。准备阶段时变量赋过零值，初始化阶段会根据程序员的编码去初始化类变量和其他资源。初始化阶段就是执行类构造方法中的 `` 方法，该方法是 Javac 自动生成的。</p><hr><h4 id="Q5：有哪些类加载器？"><a href="#Q5：有哪些类加载器？" class="headerlink" title="Q5：有哪些类加载器？"></a>Q5：有哪些类加载器？</h4><p>自 JDK1.2 起 Java 一直保持三层类加载器：</p><ul><li><p><strong>启动类加载器</strong></p><p>在 JVM 启动时创建，负责加载最核心的类，例如 Object、System 等。无法被程序直接引用，如果需要把加载委派给启动类加载器，直接使用 null 代替即可，因为启动类加载器通常由操作系统实现，并不存在于 JVM 体系。</p></li><li><p><strong>平台类加载器</strong></p><p>从 JDK9 开始从扩展类加载器更换为平台类加载器，负载加载一些扩展的系统类，比如 XML、加密、压缩相关的功能类等。</p></li><li><p><strong>应用类加载器</strong></p><p>也称系统类加载器，负责加载用户类路径上的类库，可以直接在代码中使用。如果没有自定义类加载器，一般情况下应用类加载器就是默认的类加载器。自定义类加载器通过继承 ClassLoader 并重写 <code>findClass</code> 方法实现。</p></li></ul><hr><h4 id="Q6：双亲委派模型是什么？"><a href="#Q6：双亲委派模型是什么？" class="headerlink" title="Q6：双亲委派模型是什么？"></a>Q6：双亲委派模型是什么？</h4><p>类加载器具有等级制度但非继承关系，以组合的方式复用父加载器的功能。双亲委派模型要求除了顶层的启动类加载器外，其余类加载器都应该有自己的父加载器。</p><p>一个类加载器收到了类加载请求，它不会自己去尝试加载，而将该请求委派给父加载器，每层的类加载器都是如此，因此所有加载请求最终都应该传送到启动类加载器，只有当父加载器反馈无法完成请求时，子加载器才会尝试。</p><p>类跟随它的加载器一起具备了有优先级的层次关系，确保某个类在各个类加载器环境中都是同一个，保证程序的稳定性。</p><hr><h4 id="Q7：如何判断两个类是否相等？"><a href="#Q7：如何判断两个类是否相等？" class="headerlink" title="Q7：如何判断两个类是否相等？"></a>Q7：如何判断两个类是否相等？</h4><p>任意一个类都必须由类加载器和这个类本身共同确立其在虚拟机中的唯一性。</p><p>两个类只有由同一类加载器加载才有比较意义，否则即使两个类来源于同一个 Class 文件，被同一个 JVM 加载，只要类加载器不同，这两个类就必定不相等。</p><hr><h2 id="并发-39"><a href="#并发-39" class="headerlink" title="并发 39"></a>并发 39</h2><h3 id="JMM-8"><a href="#JMM-8" class="headerlink" title="JMM 8"></a>JMM 8</h3><h4 id="Q1：JMM-的作用是什么？"><a href="#Q1：JMM-的作用是什么？" class="headerlink" title="Q1：JMM 的作用是什么？"></a>Q1：JMM 的作用是什么？</h4><p>Java 线程的通信由 JMM 控制，JMM 的主要目的是定义程序中各种变量的访问规则。变量包括实例字段、静态字段，但不包括局部变量与方法参数，因为它们是线程私有的，不存在多线程竞争。JMM 遵循一个基本原则：只要不改变程序执行结果，编译器和处理器怎么优化都行。例如编译器分析某个锁只会单线程访问就消除锁，某个 volatile 变量只会单线程访问就把它当作普通变量。</p><p>JMM 规定所有变量都存储在主内存，每条线程有自己的工作内存，工作内存中保存被该线程使用的变量的主内存副本，线程对变量的所有操作都必须在工作空间进行，不能直接读写主内存数据。不同线程间无法直接访问对方工作内存中的变量，线程通信必须经过主内存。</p><p>关于主内存与工作内存的交互，即变量如何从主内存拷贝到工作内存、从工作内存同步回主内存，JMM 定义了 8 种原子操作：</p><table><thead><tr><th>操作</th><th>作用变量范围</th><th>作用</th></tr></thead><tbody><tr><td>lock</td><td>主内存</td><td>把变量标识为线程独占状态</td></tr><tr><td>unlock</td><td>主内存</td><td>释放处于锁定状态的变量</td></tr><tr><td>read</td><td>主内存</td><td>把变量值从主内存传到工作内存</td></tr><tr><td>load</td><td>工作内存</td><td>把 read 得到的值放入工作内存的变量副本</td></tr><tr><td>user</td><td>工作内存</td><td>把工作内存中的变量值传给执行引擎</td></tr><tr><td>assign</td><td>工作内存</td><td>把从执行引擎接收的值赋给工作内存变量</td></tr><tr><td>store</td><td>工作内存</td><td>把工作内存的变量值传到主内存</td></tr><tr><td>write</td><td>主内存</td><td>把 store 取到的变量值放入主内存变量中</td></tr></tbody></table><hr><h4 id="Q2：as-if-serial-是什么？"><a href="#Q2：as-if-serial-是什么？" class="headerlink" title="Q2：as-if-serial 是什么？"></a>Q2：as-if-serial 是什么？</h4><p>不管怎么重排序，单线程程序的执行结果不能改变，编译器和处理器必须遵循 as-if-serial 语义。</p><p>为了遵循 as-if-serial，编译器和处理器不会对存在数据依赖关系的操作重排序，因为这种重排序会改变执行结果。但是如果操作之间不存在数据依赖关系，这些操作就可能被编译器和处理器重排序。</p><p>as-if-serial 把单线程程序保护起来，给程序员一种幻觉：单线程程序是按程序的顺序执行的。</p><hr><h4 id="Q3：happens-before-是什么？"><a href="#Q3：happens-before-是什么？" class="headerlink" title="Q3：happens-before 是什么？"></a>Q3：happens-before 是什么？</h4><p>先行发生原则，JMM 定义的两项操作间的偏序关系，是判断数据是否存在竞争的重要手段。</p><p>JMM 将 happens-before 要求禁止的重排序按是否会改变程序执行结果分为两类。对于会改变结果的重排序 JMM 要求编译器和处理器必须禁止，对于不会改变结果的重排序，JMM 不做要求。 </p><p>JMM 存在一些天然的 happens-before 关系，无需任何同步器协助就已经存在。如果两个操作的关系不在此列，并且无法从这些规则推导出来，它们就没有顺序性保障，虚拟机可以对它们随意进行重排序。</p><ul><li><strong>程序次序规则：</strong>一个线程内写在前面的操作先行发生于后面的。 </li><li><strong>管程锁定规则：</strong> unlock 操作先行发生于后面对同一个锁的 lock 操作。 </li><li><strong>volatile 规则：</strong>对 volatile 变量的写操作先行发生于后面的读操作。 </li><li><strong>线程启动规则：</strong>线程的 <code>start</code> 方法先行发生于线程的每个动作。 </li><li><strong>线程终止规则：</strong>线程中所有操作先行发生于对线程的终止检测。 </li><li><strong>对象终结规则：</strong>对象的初始化先行发生于 <code>finalize</code> 方法。 </li><li><strong>传递性：</strong>如果操作 A 先行发生于操作 B，操作 B 先行发生于操作 C，那么操作 A 先行发生于操作 C 。 </li></ul><hr><h4 id="Q4：as-if-serial-和-happens-before-有什么区别？"><a href="#Q4：as-if-serial-和-happens-before-有什么区别？" class="headerlink" title="Q4：as-if-serial 和 happens-before 有什么区别？"></a>Q4：as-if-serial 和 happens-before 有什么区别？</h4><p>as-if-serial 保证单线程程序的执行结果不变，happens-before 保证正确同步的多线程程序的执行结果不变。</p><p>这两种语义的目的都是为了在不改变程序执行结果的前提下尽可能提高程序执行并行度。</p><hr><h4 id="Q5：什么是指令重排序？"><a href="#Q5：什么是指令重排序？" class="headerlink" title="Q5：什么是指令重排序？"></a>Q5：什么是指令重排序？</h4><p>为了提高性能，编译器和处理器通常会对指令进行重排序，重排序指从源代码到指令序列的重排序，分为三种：① 编译器优化的重排序，编译器在不改变单线程程序语义的前提下可以重排语句的执行顺序。② 指令级并行的重排序，如果不存在数据依赖性，处理器可以改变语句对应机器指令的执行顺序。③ 内存系统的重排序。</p><hr><h4 id="Q6：原子性、可见性、有序性分别是什么？"><a href="#Q6：原子性、可见性、有序性分别是什么？" class="headerlink" title="Q6：原子性、可见性、有序性分别是什么？"></a>Q6：原子性、可见性、有序性分别是什么？</h4><p><strong>原子性</strong></p><p>基本数据类型的访问都具备原子性，例外就是 long 和 double，虚拟机将没有被 volatile 修饰的 64 位数据操作划分为两次 32 位操作。</p><p>如果应用场景需要更大范围的原子性保证，JMM 还提供了 lock 和 unlock 操作满足需求，尽管 JVM 没有把这两种操作直接开放给用户使用，但是提供了更高层次的字节码指令 monitorenter 和 monitorexit，这两个字节码指令反映到 Java 代码中就是 synchronized。</p><p><strong>可见性</strong></p><p>可见性指当一个线程修改了共享变量时，其他线程能够立即得知修改。JMM 通过在变量修改后将值同步回主内存，在变量读取前从主内存刷新的方式实现可见性，无论普通变量还是 volatile 变量都是如此，区别是 volatile 保证新值能立即同步到主内存以及每次使用前立即从主内存刷新。</p><p>除了 volatile 外，synchronized 和 final 也可以保证可见性。同步块可见性由”对一个变量执行 unlock 前必须先把此变量同步回主内存，即先执行 store 和 write”这条规则获得。final 的可见性指：被 final 修饰的字段在构造方法中一旦初始化完成，并且构造方法没有把 this 引用传递出去，那么其他线程就能看到 final 字段的值。</p><p><strong>有序性</strong></p><p>有序性可以总结为：在本线程内观察所有操作是有序的，在一个线程内观察另一个线程，所有操作都是无序的。前半句指 as-if-serial 语义，后半句指指令重排序和工作内存与主内存延迟现象。</p><p>Java 提供 volatile 和 synchronized 保证有序性，volatile 本身就包含禁止指令重排序的语义，而 synchronized 保证一个变量在同一时刻只允许一条线程对其进行 lock 操作，确保持有同一个锁的两个同步块只能串行进入。</p><hr><h4 id="Q7：谈一谈-volatile"><a href="#Q7：谈一谈-volatile" class="headerlink" title="Q7：谈一谈 volatile"></a>Q7：谈一谈 volatile</h4><p>JMM 为 volatile 定义了一些特殊访问规则，当变量被定义为 volatile 后具备两种特性：</p><ul><li><p><strong>保证变量对所有线程可见</strong></p><p>当一条线程修改了变量值，新值对于其他线程来说是立即可以得知的。volatile 变量在各个线程的工作内存中不存在一致性问题，但 Java 的运算操作符并非原子操作，导致 volatile 变量运算在并发下仍不安全。</p></li><li><p><strong>禁止指令重排序优化</strong></p><p>使用 volatile 变量进行写操作，汇编指令带有 lock 前缀，相当于一个内存屏障，后面的指令不能重排到内存屏障之前。</p><p>使用 lock 前缀引发两件事：① 将当前处理器缓存行的数据写回系统内存。②使其他处理器的缓存无效。相当于对缓存变量做了一次 store 和 write 操作，让 volatile 变量的修改对其他处理器立即可见。</p></li></ul><p><strong>静态变量 i 执行多线程 i++ 的不安全问题</strong></p><p>自增语句由 4 条字节码指令构成的，依次为 <code>getstatic</code>、<code>iconst_1</code>、<code>iadd</code>、<code>putstatic</code>，当 <code>getstatic</code> 把 i 的值取到操作栈顶时，volatile 保证了 i 值在此刻正确，但在执行 <code>iconst_1</code>、<code>iadd</code> 时，其他线程可能已经改变了 i 值，操作栈顶的值就变成了过期数据，所以 <code>putstatic</code> 执行后就可能把较小的 i 值同步回了主内存。 </p><p><strong>适用场景</strong></p><p>① 运算结果并不依赖变量的当前值。② 一写多读，只有单一的线程修改变量值。</p><p><strong>内存语义</strong></p><p>写一个 volatile 变量时，把该线程工作内存中的值刷新到主内存。</p><p>读一个 volatile 变量时，把该线程工作内存值置为无效，从主内存读取。</p><p><strong>指令重排序特点</strong></p><p>第二个操作是 volatile 写，不管第一个操作是什么都不能重排序，确保写之前的操作不会被重排序到写之后。</p><p>第一个操作是 volatile 读，不管第二个操作是什么都不能重排序，确保读之后的操作不会被重排序到读之前。</p><p>第一个操作是 volatile 写，第二个操作是 volatile 读不能重排序。</p><p><strong>JSR-133 增强 volatile 语义的原因</strong></p><p>在旧的内存模型中，虽然不允许 volatile 变量间重排序，但允许 volatile 变量与普通变量重排序，可能导致内存不可见问题。JSR-133 严格限制编译器和处理器对 volatile 变量与普通变量的重排序，确保 volatile 的写-读和锁的释放-获取具有相同的内存语义。</p><hr><h4 id="Q8：final-可以保证可见性吗？"><a href="#Q8：final-可以保证可见性吗？" class="headerlink" title="Q8：final 可以保证可见性吗？"></a>Q8：final 可以保证可见性吗？</h4><p>final 可以保证可见性，被 final 修饰的字段在构造方法中一旦被初始化完成，并且构造方法没有把 this 引用传递出去，在其他线程中就能看见 final 字段值。</p><p>在旧的 JMM 中，一个严重缺陷是线程可能看到 final 值改变。比如一个线程看到一个 int 类型 final 值为 0，此时该值是未初始化前的零值，一段时间后该值被某线程初始化，再去读这个 final 值会发现值变为 1。</p><p>为修复该漏洞，JSR-133 为 final 域增加重排序规则：只要对象是正确构造的（被构造对象的引用在构造方法中没有逸出），那么不需要使用同步就可以保证任意线程都能看到这个 final 域初始化后的值。</p><p><strong>写 final 域重排序规则</strong></p><p>禁止把 final 域的写重排序到构造方法之外，编译器会在 final 域的写后，构造方法的 return 前，插入一个 Store Store 屏障。确保在对象引用为任意线程可见之前，对象的 final 域已经初始化过。</p><p><strong>读 final 域重排序规则</strong></p><p>在一个线程中，初次读对象引用和初次读该对象包含的 final 域，JMM 禁止处理器重排序这两个操作。编译器在读 final 域操作的前面插入一个 Load Load 屏障，确保在读一个对象的 final 域前一定会先读包含这个 final 域的对象引用。</p><hr><h3 id="锁-17"><a href="#锁-17" class="headerlink" title="锁 17"></a>锁 17</h3><h4 id="Q1：谈一谈-synchronized"><a href="#Q1：谈一谈-synchronized" class="headerlink" title="Q1：谈一谈 synchronized"></a>Q1：谈一谈 synchronized</h4><p>每个 Java 对象都有一个关联的 monitor，使用 synchronized 时 JVM 会根据使用环境找到对象的 monitor，根据 monitor 的状态进行加解锁的判断。如果成功加锁就成为该 monitor 的唯一持有者，monitor 在被释放前不能再被其他线程获取。</p><p>同步代码块使用 monitorenter 和 monitorexit 这两个字节码指令获取和释放 monitor。这两个字节码指令都需要一个引用类型的参数指明要锁定和解锁的对象，对于同步普通方法，锁是当前实例对象；对于静态同步方法，锁是当前类的 Class 对象；对于同步方法块，锁是 synchronized 括号里的对象。</p><p>执行 monitorenter 指令时，首先尝试获取对象锁。如果这个对象没有被锁定，或当前线程已经持有锁，就把锁的计数器加 1，执行 monitorexit 指令时会将锁计数器减 1。一旦计数器为 0 锁随即就被释放。</p><p>例如有两个线程 A、B 竞争 monitor，当 A 竞争到锁时会将 monitor 中的 owner 设置为 A，把 B 阻塞并放到等待资源的 ContentionList 队列。ContentionList 中的部分线程会进入 EntryList，EntryList 中的线程会被指定为 OnDeck 竞争候选者，如果获得了锁资源将进入 Owner 状态，释放锁后进入 !Owner 状态。被阻塞的线程会进入 WaitSet。</p><p>被 synchronized 修饰的同步块对一条线程来说是可重入的，并且同步块在持有锁的线程释放锁前会阻塞其他线程进入。从执行成本的角度看，持有锁是一个重量级的操作。Java 线程是映射到操作系统的内核线程上的，如果要阻塞或唤醒一条线程，需要操作系统帮忙完成，不可避免用户态到核心态的转换。</p><p><strong>不公平的原因</strong></p><p>所有收到锁请求的线程首先自旋，如果通过自旋也没有获取锁将被放入 ContentionList，该做法对于已经进入队列的线程不公平。</p><p>为了防止 ContentionList 尾部的元素被大量线程进行 CAS 访问影响性能，Owner 线程会在释放锁时将 ContentionList 的部分线程移动到 EntryList 并指定某个线程为 OnDeck 线程，该行为叫做竞争切换，牺牲了公平性但提高了性能。</p><hr><h4 id="Q2：锁优化有哪些策略？"><a href="#Q2：锁优化有哪些策略？" class="headerlink" title="Q2：锁优化有哪些策略？"></a>Q2：锁优化有哪些策略？</h4><p>JDK 6 对 synchronized 做了很多优化，引入了自适应自旋、锁消除、锁粗化、偏向锁和轻量级锁等提高锁的效率，锁一共有 4 个状态，级别从低到高依次是：无锁、偏向锁、轻量级锁和重量级锁，状态会随竞争情况升级。锁可以升级但不能降级，这种只能升级不能降级的锁策略是为了提高锁获得和释放的效率。</p><hr><h4 id="Q3：自旋锁是什么？"><a href="#Q3：自旋锁是什么？" class="headerlink" title="Q3：自旋锁是什么？"></a>Q3：自旋锁是什么？</h4><p>同步对性能最大的影响是阻塞，挂起和恢复线程的操作都需要转入内核态完成。许多应用上共享数据的锁定只会持续很短的时间，为了这段时间去挂起和恢复线程并不值得。如果机器有多个处理器核心，我们可以让后面请求锁的线程稍等一会，但不放弃处理器的执行时间，看看持有锁的线程是否很快会释放锁。为了让线程等待只需让线程执行一个忙循环，这项技术就是自旋锁。</p><p>自旋锁在 JDK1.4 就已引入，默认关闭，在 JDK6 中改为默认开启。自旋不能代替阻塞，虽然避免了线程切换开销，但要占用处理器时间，如果锁被占用的时间很短，自旋的效果就会非常好，反之只会白白消耗处理器资源。如果自旋超过了限定的次数仍然没有成功获得锁，就应挂起线程，自旋默认限定次数是 10。</p><hr><h4 id="Q4：什么是自适应自旋？"><a href="#Q4：什么是自适应自旋？" class="headerlink" title="Q4：什么是自适应自旋？"></a>Q4：什么是自适应自旋？</h4><p>JDK6 对自旋锁进行了优化，自旋时间不再固定，而是由前一次的自旋时间及锁拥有者的状态决定。</p><p>如果在同一个锁上，自旋刚刚成功获得过锁且持有锁的线程正在运行，虚拟机会认为这次自旋也很可能成功，进而允许自旋持续更久。如果自旋很少成功，以后获取锁时将可能直接省略掉自旋，避免浪费处理器资源。</p><p>有了自适应自旋，随着程序运行时间的增长，虚拟机对程序锁的状况预测就会越来越精准。</p><hr><h4 id="Q5：锁消除是什么？"><a href="#Q5：锁消除是什么？" class="headerlink" title="Q5：锁消除是什么？"></a>Q5：锁消除是什么？</h4><p>锁消除指即时编译器对检测到不可能存在共享数据竞争的锁进行消除。</p><p>主要判定依据来源于逃逸分析，如果判断一段代码中堆上的所有数据都只被一个线程访问，就可以当作栈上的数据对待，认为它们是线程私有的而无须同步。</p><hr><h4 id="Q6：锁粗化是什么？"><a href="#Q6：锁粗化是什么？" class="headerlink" title="Q6：锁粗化是什么？"></a>Q6：锁粗化是什么？</h4><p>原则需要将同步块的作用范围限制得尽量小，只在共享数据的实际作用域中进行同步，这是为了使等待锁的线程尽快拿到锁。</p><p>但如果一系列的连续操作都对同一个对象反复加锁和解锁，甚至加锁操作是出现在循环体之外的，即使没有线程竞争也会导致不必要的性能消耗。因此如果虚拟机探测到有一串零碎的操作都对同一个对象加锁，将会把同步的范围扩展到整个操作序列的外部。</p><hr><h4 id="Q7：偏向锁是什么？"><a href="#Q7：偏向锁是什么？" class="headerlink" title="Q7：偏向锁是什么？"></a>Q7：偏向锁是什么？</h4><p>偏向锁是为了在没有竞争的情况下减少锁开销，锁会偏向于第一个获得它的线程，如果在执行过程中锁一直没有被其他线程获取，则持有偏向锁的线程将不需要进行同步。</p><p>当锁对象第一次被线程获取时，虚拟机会将对象头中的偏向模式设为 1，同时使用 CAS 把获取到锁的线程 ID 记录在对象的 Mark Word 中。如果 CAS 成功，持有偏向锁的线程以后每次进入锁相关的同步块都不再进行任何同步操作。</p><p>一旦有其他线程尝试获取锁，偏向模式立即结束，根据锁对象是否处于锁定状态决定是否撤销偏向，后续同步按照轻量级锁那样执行。</p><hr><h4 id="Q8：轻量级锁是什么？"><a href="#Q8：轻量级锁是什么？" class="headerlink" title="Q8：轻量级锁是什么？"></a>Q8：轻量级锁是什么？</h4><p>轻量级锁是为了在没有竞争的前提下减少重量级锁使用操作系统互斥量产生的性能消耗。</p><p>在代码即将进入同步块时，如果同步对象没有被锁定，虚拟机将在当前线程的栈帧中建立一个锁记录空间，存储锁对象目前 Mark Word 的拷贝。然后虚拟机使用 CAS 尝试把对象的 Mark Word 更新为指向锁记录的指针，如果更新成功即代表该线程拥有了锁，锁标志位将转变为 00，表示处于轻量级锁定状态。</p><p>如果更新失败就意味着至少存在一条线程与当前线程竞争。虚拟机检查对象的 Mark Word 是否指向当前线程的栈帧，如果是则说明当前线程已经拥有了锁，直接进入同步块继续执行，否则说明锁对象已经被其他线程抢占。如果出现两条以上线程争用同一个锁，轻量级锁就不再有效，将膨胀为重量级锁，锁标志状态变为 10，此时Mark Word 存储的就是指向重量级锁的指针，后面等待锁的线程也必须阻塞。</p><p>解锁同样通过 CAS 进行，如果对象 Mark Word 仍然指向线程的锁记录，就用 CAS 把对象当前的 Mark Word 和线程复制的 Mark Word 替换回来。假如替换成功同步过程就顺利完成了，如果失败则说明有其他线程尝试过获取该锁，就要在释放锁的同时唤醒被挂起的线程。</p><hr><h4 id="Q9：偏向锁、轻量级锁和重量级锁的区别？"><a href="#Q9：偏向锁、轻量级锁和重量级锁的区别？" class="headerlink" title="Q9：偏向锁、轻量级锁和重量级锁的区别？"></a>Q9：偏向锁、轻量级锁和重量级锁的区别？</h4><p>偏向锁的优点是加解锁不需要额外消耗，和执行非同步方法比仅存在纳秒级差距，缺点是如果存在锁竞争会带来额外锁撤销的消耗，适用只有一个线程访问同步代码块的场景。</p><p>轻量级锁的优点是竞争线程不阻塞，程序响应速度快，缺点是如果线程始终得不到锁会自旋消耗 CPU，适用追求响应时间、同步代码块执行快的场景。</p><p>重量级锁的优点是线程竞争不使用自旋不消耗CPU，缺点是线程会阻塞，响应时间慢，适应追求吞吐量、同步代码块执行慢的场景。</p><hr><h4 id="Q10：Lock-和-synchronized-有什么区别？"><a href="#Q10：Lock-和-synchronized-有什么区别？" class="headerlink" title="Q10：Lock 和 synchronized 有什么区别？"></a>Q10：Lock 和 synchronized 有什么区别？</h4><p>Lock 接是 juc 包的顶层接口，基于Lock 接口，用户能够以非块结构来实现互斥同步，摆脱了语言特性束缚，在类库层面实现同步。Lock 并未用到 synchronized，而是利用了 volatile 的可见性。</p><p>重入锁 ReentrantLock 是 Lock 最常见的实现，与 synchronized 一样可重入，不过它增加了一些高级功能：</p><ul><li>*<em>等待可中断： *</em>持有锁的线程长期不释放锁时，正在等待的线程可以选择放弃等待而处理其他事情。 </li><li><strong>公平锁：</strong> 公平锁指多个线程在等待同一个锁时，必须按照申请锁的顺序来依次获得锁，而非公平锁不保证这一点，在锁被释放时，任何线程都有机会获得锁。synchronized 是非公平的，ReentrantLock 在默认情况下是非公平的，可以通过构造方法指定公平锁。一旦使用了公平锁，性能会急剧下降，影响吞吐量。 </li><li><strong>锁绑定多个条件：</strong> 一个 ReentrantLock 可以同时绑定多个 Condition。synchronized 中锁对象的 <code>wait</code> 跟 <code>notify</code> 可以实现一个隐含条件，如果要和多个条件关联就不得不额外添加锁，而 ReentrantLock 可以多次调用 <code>newCondition</code> 创建多个条件。 </li></ul><p>一般优先考虑使用 synchronized：① synchronized 是语法层面的同步，足够简单。② Lock 必须确保在 finally 中释放锁，否则一旦抛出异常有可能永远不会释放锁。使用 synchronized 可以由 JVM 来确保即使出现异常锁也能正常释放。③ 尽管 JDK5 时 ReentrantLock 的性能优于 synchronized，但在 JDK6 进行锁优化后二者的性能基本持平。从长远来看 JVM 更容易针对synchronized 优化，因为 JVM 可以在线程和对象的元数据中记录 synchronized 中锁的相关信息，而使用 Lock 的话 JVM 很难得知具体哪些锁对象是由特定线程持有的。</p><hr><h4 id="Q11：ReentrantLock-的可重入是怎么实现的？"><a href="#Q11：ReentrantLock-的可重入是怎么实现的？" class="headerlink" title="Q11：ReentrantLock 的可重入是怎么实现的？"></a>Q11：ReentrantLock 的可重入是怎么实现的？</h4><p>以非公平锁为例，通过 <code>nonfairTryAcquire</code> 方法获取锁，该方法增加了再次获取同步状态的处理逻辑：判断当前线程是否为获取锁的线程来决定获取是否成功，如果是获取锁的线程再次请求则将同步状态值增加并返回 true，表示获取同步状态成功。</p><p>成功获取锁的线程再次获取锁将增加同步状态值，释放同步状态时将减少同步状态值。如果锁被获取了 n 次，那么前 n-1 次 <code>tryRelease</code> 方法必须都返回 fasle，只有同步状态完全释放才能返回 true，该方法将同步状态是否为 0 作为最终释放条件，释放时将占有线程设置为null 并返回 true。</p><p>对于非公平锁只要 CAS 设置同步状态成功则表示当前线程获取了锁，而公平锁则不同。公平锁使用 <code>tryAcquire</code> 方法，该方法与<code>nonfairTryAcquire</code> 的唯一区别就是判断条件中多了对同步队列中当前节点是否有前驱节点的判断，如果该方法返回 true 表示有线程比当前线程更早请求锁，因此需要等待前驱线程获取并释放锁后才能获取锁。</p><hr><h4 id="Q12：什么是读写锁？"><a href="#Q12：什么是读写锁？" class="headerlink" title="Q12：什么是读写锁？"></a>Q12：什么是读写锁？</h4><p>ReentrantLock 是排他锁，同一时刻只允许一个线程访问，读写锁在同一时刻允许多个读线程访问，在写线程访问时，所有的读写线程均阻塞。读写锁维护了一个读锁和一个写锁，通过分离读写锁使并发性相比排他锁有了很大提升。</p><p>读写锁依赖 AQS 来实现同步功能，读写状态就是其同步器的同步状态。读写锁的自定义同步器需要在同步状态，即一个 int 变量上维护多个读线程和一个写线程的状态。读写锁将变量切分成了两个部分，高 16 位表示读，低 16 位表示写。</p><p>写锁是可重入排他锁，如果当前线程已经获得了写锁则增加写状态，如果当前线程在获取写锁时，读锁已经被获取或者该线程不是已经获得写锁的线程则进入等待。写锁的释放与 ReentrantLock 的释放类似，每次释放减少写状态，当写状态为 0 时表示写锁已被释放。</p><p>读锁是可重入共享锁，能够被多个线程同时获取，在没有其他写线程访问时，读锁总会被成功获取。如果当前线程已经获取了读锁，则增加读状态。如果当前线程在获取读锁时，写锁已被其他线程获取则进入等待。读锁每次释放会减少读状态，减少的值是（1&lt;&lt;16），读锁的释放是线程安全的。</p><p><strong>锁降级</strong>指把持住当前拥有的写锁，再获取读锁，随后释放先前拥有的写锁。</p><p>锁降级中读锁的获取是必要的，这是为了保证数据可见性，如果当前线程不获取读锁而直接释放写锁，假设此刻另一个线程 A 获取写锁修改了数据，当前线程无法感知线程 A 的数据更新。如果当前线程获取读锁，遵循锁降级的步骤，A 将被阻塞，直到当前线程使用数据并释放读锁之后，线程 A 才能获取写锁进行数据更新。</p><hr><h4 id="Q13：AQS-了解吗？"><a href="#Q13：AQS-了解吗？" class="headerlink" title="Q13：AQS 了解吗？"></a>Q13：AQS 了解吗？</h4><p>AQS 队列同步器是用来构建锁或其他同步组件的基础框架，它使用一个 volatile int state 变量作为共享资源，如果线程获取资源失败，则进入同步队列等待；如果获取成功就执行临界区代码，释放资源时会通知同步队列中的等待线程。</p><p>同步器的主要使用方式是继承，子类通过继承同步器并实现它的抽象方法来管理同步状态，对同步状态进行更改需要使用同步器提供的 3个方法 <code>getState</code>、<code>setState</code> 和 <code>compareAndSetState</code> ，它们保证状态改变是安全的。子类推荐被定义为自定义同步组件的静态内部类，同步器自身没有实现任何同步接口，它仅仅定义若干同步状态获取和释放的方法，同步器既支持独占式也支持共享式。</p><p>同步器是实现锁的关键，在锁的实现中聚合同步器，利用同步器实现锁的语义。锁面向使用者，定义了使用者与锁交互的接口，隐藏实现细节；同步器面向锁的实现者，简化了锁的实现方式，屏蔽了同步状态管理、线程排队、等待与唤醒等底层操作。</p><p>每当有新线程请求资源时都会进入一个等待队列，只有当持有锁的线程释放锁资源后该线程才能持有资源。等待队列通过双向链表实现，线程被封装在链表的 Node 节点中，Node 的等待状态包括：CANCELLED（线程已取消）、SIGNAL（线程需要唤醒）、CONDITION （线程正在等待）、PROPAGATE（后继节点会传播唤醒操作，只在共享模式下起作用）。</p><hr><h4 id="Q14：AQS-有哪两种模式？"><a href="#Q14：AQS-有哪两种模式？" class="headerlink" title="Q14：AQS 有哪两种模式？"></a>Q14：AQS 有哪两种模式？</h4><p><strong>独占模式</strong>表示锁只会被一个线程占用，其他线程必须等到持有锁的线程释放锁后才能获取锁，同一时间只能有一个线程获取到锁。</p><p><strong>共享模式</strong>表示多个线程获取同一个锁有可能成功，ReadLock 就采用共享模式。</p><p>独占模式通过 acquire 和 release 方法获取和释放锁，共享模式通过 acquireShared 和 releaseShared 方法获取和释放锁。</p><hr><h4 id="Q15：AQS-独占式获取-释放锁的原理？"><a href="#Q15：AQS-独占式获取-释放锁的原理？" class="headerlink" title="Q15：AQS 独占式获取/释放锁的原理？"></a>Q15：AQS 独占式获取/释放锁的原理？</h4><p>获取同步状态时，调用 <code>acquire</code> 方法，维护一个同步队列，使用 <code>tryAcquire</code> 方法安全地获取线程同步状态，获取失败的线程会被构造同步节点并通过 <code>addWaiter</code> 方法加入到同步队列的尾部，在队列中自旋。之后调用 <code>acquireQueued</code> 方法使得该节点以死循环的方式获取同步状态，如果获取不到则阻塞，被阻塞线程的唤醒主要依靠前驱节点的出队或被中断实现，移出队列或停止自旋的条件是前驱节点是头结点且成功获取了同步状态。</p><p>释放同步状态时，同步器调用 <code>tryRelease</code> 方法释放同步状态，然后调用 <code>unparkSuccessor</code> 方法唤醒头节点的后继节点，使后继节点重新尝试获取同步状态。</p><hr><h4 id="Q16：为什么只有前驱节点是头节点时才能尝试获取同步状态？"><a href="#Q16：为什么只有前驱节点是头节点时才能尝试获取同步状态？" class="headerlink" title="Q16：为什么只有前驱节点是头节点时才能尝试获取同步状态？"></a>Q16：为什么只有前驱节点是头节点时才能尝试获取同步状态？</h4><p>头节点是成功获取到同步状态的节点，后继节点的线程被唤醒后需要检查自己的前驱节点是否是头节点。</p><p>目的是维护同步队列的 FIFO 原则，节点和节点在循环检查的过程中基本不通信，而是简单判断自己的前驱是否为头节点，这样就使节点的释放规则符合 FIFO，并且也便于对过早通知的处理，过早通知指前驱节点不是头节点的线程由于中断被唤醒。</p><hr><h4 id="Q17：AQS-共享式式获取-释放锁的原理？"><a href="#Q17：AQS-共享式式获取-释放锁的原理？" class="headerlink" title="Q17：AQS 共享式式获取/释放锁的原理？"></a>Q17：AQS 共享式式获取/释放锁的原理？</h4><p>获取同步状态时，调用 <code>acquireShared</code> 方法，该方法调用 <code>tryAcquireShared</code> 方法尝试获取同步状态，返回值为 int 类型，返回值不小于于 0 表示能获取同步状态。因此在共享式获取锁的自旋过程中，成功获取同步状态并退出自旋的条件就是该方法的返回值不小于0。</p><p>释放同步状态时，调用 <code>releaseShared</code> 方法，释放后会唤醒后续处于等待状态的节点。它和独占式的区别在于 <code>tryReleaseShared</code> 方法必须确保同步状态安全释放，通过循环 CAS 保证，因为释放同步状态的操作会同时来自多个线程。</p><hr><h3 id="线程-13"><a href="#线程-13" class="headerlink" title="线程 13"></a>线程 13</h3><h4 id="Q1：线程的生命周期有哪些状态？"><a href="#Q1：线程的生命周期有哪些状态？" class="headerlink" title="Q1：线程的生命周期有哪些状态？"></a>Q1：线程的生命周期有哪些状态？</h4><p>NEW：新建状态，线程被创建且未启动，此时还未调用 <code>start</code>  方法。</p><p>RUNNABLE：Java 将操作系统中的就绪和运行两种状态统称为 RUNNABLE，此时线程有可能在等待时间片，也有可能在执行。</p><p>BLOCKED：阻塞状态，可能由于锁被其他线程占用、调用了 <code>sleep</code> 或 <code>join</code> 方法、执行了 <code>wait</code>方法等。</p><p>WAITING：等待状态，该状态线程不会被分配 CPU 时间片，需要其他线程通知或中断。可能由于调用了无参的 <code>wait</code> 和 <code>join</code> 方法。</p><p>TIME_WAITING：限期等待状态，可以在指定时间内自行返回。导可能由于调用了带参的 <code>wait</code> 和 <code>join</code> 方法。</p><p>TERMINATED：终止状态，表示当前线程已执行完毕或异常退出。</p><hr><h4 id="Q2：线程的创建方式有哪些？"><a href="#Q2：线程的创建方式有哪些？" class="headerlink" title="Q2：线程的创建方式有哪些？"></a>Q2：线程的创建方式有哪些？</h4><p>① 继承 Thread 类并重写 run 方法。实现简单，但不符合里氏替换原则，不可以继承其他类。</p><p>② 实现 Runnable 接口并重写 run 方法。避免了单继承局限性，编程更加灵活，实现解耦。</p><p>③实现 Callable 接口并重写 call 方法。可以获取线程执行结果的返回值，并且可以抛出异常。</p><hr><h4 id="Q3：线程有哪些方法？"><a href="#Q3：线程有哪些方法？" class="headerlink" title="Q3：线程有哪些方法？"></a>Q3：线程有哪些方法？</h4><p>① <code>sleep</code> 方***导致当前线程进入休眠状态，与 <code>wait</code> 不同的是该方法不会释放锁资源，进入的是 TIMED-WAITING 状态。</p><p>② <code>yiled</code> 方法使当前线程让出 CPU 时间片给优先级相同或更高的线程，回到 RUNNABLE 状态，与其他线程一起重新竞争CPU时间片。</p><p>③ <code>join</code> 方法用于等待其他线程运行终止，如果当前线程调用了另一个线程的 join 方法，则当前线程进入阻塞状态，当另一个线程结束时当前线程才能从阻塞状态转为就绪态，等待获取CPU时间片。底层使用的是wait，也会释放锁。</p><hr><h4 id="Q4：什么是守护线程？"><a href="#Q4：什么是守护线程？" class="headerlink" title="Q4：什么是守护线程？"></a>Q4：什么是守护线程？</h4><p>守护线程是一种支持型线程，可以通过 <code>setDaemon(true)</code> 将线程设置为守护线程，但必须在线程启动前设置。</p><p>守护线程被用于完成支持性工作，但在 JVM 退出时守护线程中的 finally 块不一定执行，因为 JVM 中没有非守护线程时需要立即退出，所有守护线程都将立即终止，不能靠在守护线程使用 finally 确保关闭资源。</p><hr><h4 id="Q5：线程通信的方式有哪些？"><a href="#Q5：线程通信的方式有哪些？" class="headerlink" title="Q5：线程通信的方式有哪些？"></a>Q5：线程通信的方式有哪些？</h4><p>命令式编程中线程的通信机制有两种，共享内存和消息传递。在共享内存的并发模型里线程间共享程序的公共状态，通过写-读内存中的公共状态进行隐式通信。在消息传递的并发模型里线程间没有公共状态，必须通过发送消息来显式通信。Java 并发采用共享内存模型，线程之间的通信总是隐式进行，整个通信过程对程序员完全透明。</p><p><strong>volatile</strong> 告知程序任何对变量的读需要从主内存中获取，写必须同步刷新回主内存，保证所有线程对变量访问的可见性。</p><p><strong>synchronized</strong> 确保多个线程在同一时刻只能有一个处于方法或同步块中，保证线程对变量访问的原子性、可见性和有序性。</p><p><strong>等待通知机制</strong>指一个线程 A 调用了对象的 <code>wait</code> 方法进入等待状态，另一线程 B 调用了对象的 <code>notify/notifyAll</code> 方法，线程 A 收到通知后结束阻塞并执行后序操作。对象上的 <code>wait</code> 和 <code>notify/notifyAll</code> 如同开关信号，完成等待方和通知方的交互。</p><p>如果一个线程执行了某个线程的 <code>join</code> 方法，这个线程就会阻塞等待执行了 <code>join</code> 方法的线程终止，这里涉及等待/通知机制。<code>join</code> 底层通过 <code>wait</code> 实现，线程终止时会调用自身的 <code>notifyAll</code> 方法，通知所有等待在该线程对象上的线程。</p><p><strong>管道 IO 流</strong>用于线程间数据传输，媒介为内存。PipedOutputStream 和 PipedWriter 是输出流，相当于生产者，PipedInputStream 和 PipedReader 是输入流，相当于消费者。管道流使用一个默认大小为 1KB 的循环缓冲数组。输入流从缓冲数组读数据，输出流往缓冲数组中写数据。当数组已满时，输出流所在线程阻塞；当数组首次为空时，输入流所在线程阻塞。</p><p><strong>ThreadLocal</strong> 是线程共享变量，但它可以为每个线程创建单独的副本，副本值是线程私有的，互相之间不影响。</p><hr><h4 id="Q6：线程池有什么好处？"><a href="#Q6：线程池有什么好处？" class="headerlink" title="Q6：线程池有什么好处？"></a>Q6：线程池有什么好处？</h4><p>降低资源消耗，复用已创建的线程，降低开销、控制最大并发数。</p><p>隔离线程环境，可以配置独立线程池，将较慢的线程与较快的隔离开，避免相互影响。</p><p>实现任务线程队列缓冲策略和拒绝机制。</p><p>实现某些与时间相关的功能，如定时执行、周期执行等。</p><hr><h4 id="Q7：线程池处理任务的流程？"><a href="#Q7：线程池处理任务的流程？" class="headerlink" title="Q7：线程池处理任务的流程？"></a>Q7：线程池处理任务的流程？</h4><p>① 核心线程池未满，创建一个新的线程执行任务，此时 workCount &lt; corePoolSize。</p><p>② 如果核心线程池已满，工作队列未满，将线程存储在工作队列，此时 workCount &gt;= corePoolSize。</p><p>③ 如果工作队列已满，线程数小于最大线程数就创建一个新线程处理任务，此时 workCount &lt; maximumPoolSize，这一步也需要获取全局锁。</p><p>④ 如果超过大小线程数，按照拒绝策略来处理任务，此时 workCount &gt; maximumPoolSize。</p><p>线程池创建线程时，会将线程封装成工作线程 Worker，Worker 在执行完任务后还会循环获取工作队列中的任务来执行。</p><hr><h4 id="Q8：有哪些创建线程池的方法？"><a href="#Q8：有哪些创建线程池的方法？" class="headerlink" title="Q8：有哪些创建线程池的方法？"></a>Q8：有哪些创建线程池的方法？</h4><p>可以通过 Executors 的静态工厂方法创建线程池：</p><p>① <code>newFixedThreadPool</code>，固定大小的线程池，核心线程数也是最大线程数，不存在空闲线程，keepAliveTime = 0。该线程池使用的工作队列是无界阻塞队列 LinkedBlockingQueue，适用于负载较重的服务器。</p><p>② <code>newSingleThreadExecutor</code>，使用单线程，相当于单线程串行执行所有任务，适用于需要保证顺序执行任务的场景。</p><p>③ <code>newCachedThreadPool</code>，maximumPoolSize 设置为 Integer 最大值，是高度可伸缩的线程池。该线程池使用的工作队列是没有容量的 SynchronousQueue，如果主线程提交任务的速度高于线程处理的速度，线程池会不断创建新线程，极端情况下会创建过多线程而耗尽CPU 和内存资源。适用于执行很多短期异步任务的小程序或负载较轻的服务器。</p><p>④ <code>newScheduledThreadPool</code>：线程数最大为 Integer 最大值，存在 OOM 风险。支持定期及周期性任务执行，适用需要多个后台线程执行周期任务，同时需要限制线程数量的场景。相比 Timer 更安全，功能更强，与 <code>newCachedThreadPool</code> 的区别是不回收工作线程。</p><p>⑤ <code>newWorkStealingPool</code>：JDK8 引入，创建持有足够线程的线程池支持给定的并行度，通过多个队列减少竞争。</p><hr><h4 id="Q9：创建线程池有哪些参数？"><a href="#Q9：创建线程池有哪些参数？" class="headerlink" title="Q9：创建线程池有哪些参数？"></a>Q9：创建线程池有哪些参数？</h4><p>① corePoolSize：常驻核心线程数，如果为 0，当执行完任务没有任何请求时会消耗线程池；如果大于 0，即使本地任务执行完，核心线程也不会被销毁。该值设置过大会浪费资源，过小会导致线程的频繁创建与销毁。</p><p>② maximumPoolSize：线程池能够容纳同时执行的线程最大数，必须大于等于 1，如果与核心线程数设置相同代表固定大小线程池。</p><p>③ keepAliveTime：线程空闲时间，线程空闲时间达到该值后会被销毁，直到只剩下 corePoolSize 个线程为止，避免浪费内存资源。</p><p>④ unit：keepAliveTime 的时间单位。</p><p>⑤ workQueue：工作队列，当线程请求数大于等于 corePoolSize 时线程会进入阻塞队列。</p><p>⑥ threadFactory：线程工厂，用来生产一组相同任务的线程。可以给线程命名，有利于分析错误。</p><p>⑦ handler：拒绝策略，默认使用 AbortPolicy 丢弃任务并抛出异常，CallerRunsPolicy 表示重新尝试提交该任务，DiscardOldestPolicy 表示抛弃队列里等待最久的任务并把当前任务加入队列，DiscardPolicy 表示直接抛弃当前任务但不抛出异常。</p><hr><h4 id="Q10：如何关闭线程池？"><a href="#Q10：如何关闭线程池？" class="headerlink" title="Q10：如何关闭线程池？"></a>Q10：如何关闭线程池？</h4><p>可以调用 <code>shutdown</code> 或 <code>shutdownNow</code> 方法关闭线程池，原理是遍历线程池中的工作线程，然后逐个调用线程的 <code>interrupt</code> 方法中断线程，无法响应中断的任务可能永远无法终止。</p><p>区别是 <code>shutdownNow</code> 首先将线程池的状态设为 STOP，然后尝试停止正在执行或暂停任务的线程，并返回等待执行任务的列表。而 <code>shutdown</code> 只是将线程池的状态设为 SHUTDOWN，然后中断没有正在执行任务的线程。</p><p>通常调用 <code>shutdown</code> 来关闭线程池，如果任务不一定要执行完可调用 <code>shutdownNow</code>。</p><hr><h4 id="Q11：线程池的选择策略有什么？"><a href="#Q11：线程池的选择策略有什么？" class="headerlink" title="Q11：线程池的选择策略有什么？"></a>Q11：线程池的选择策略有什么？</h4><p>可以从以下角度分析：①任务性质：CPU 密集型、IO 密集型和混合型。②任务优先级。③任务执行时间。④任务依赖性：是否依赖其他资源，如数据库连接。</p><p>性质不同的任务可用不同规模的线程池处理，CPU 密集型任务应配置尽可能小的线程，如配置 N<del>cpu</del>+1 个线程的线程池。由于 IO 密集型任务线程并不是一直在执行任务，应配置尽可能多的线程，如 2*N<del>cpu</del>。混合型的任务，如果可以拆分，将其拆分为一个 CPU 密集型任务和一个 IO 密集型任务，只要两个任务执行的时间相差不大那么分解后的吞吐量将高于串行执行的吞吐量，如果相差太大则没必要分解。</p><p>优先级不同的任务可以使用优先级队列 PriorityBlockingQueue 处理。</p><p>执行时间不同的任务可以交给不同规模的线程池处理，或者使用优先级队列让执行时间短的任务先执行。</p><p>依赖数据库连接池的任务，由于线程提交 SQL 后需要等待数据库返回的结果，等待的时间越长 CPU 空闲的时间就越长，因此线程数应该尽可能地设置大一些，提高 CPU 的利用率。</p><p>建议使用有界队列，能增加系统的稳定性和预警能力，可以根据需要设置的稍微大一些。</p><hr><h4 id="Q12：阻塞队列有哪些选择"><a href="#Q12：阻塞队列有哪些选择" class="headerlink" title="Q12：阻塞队列有哪些选择?"></a>Q12：阻塞队列有哪些选择?</h4><p>阻塞队列支持阻塞插入和移除，当队列满时，阻塞插入元素的线程直到队列不满。当队列为空时，获取元素的线程会被阻塞直到队列非空。阻塞队列常用于生产者和消费者的场景，阻塞队列就是生产者用来存放元素，消费者用来获取元素的容器。</p><p><strong>Java 中的阻塞队列</strong></p><p>ArrayBlockingQueue，由数组组成的有界阻塞队列，默认情况下不保证线程公平，有可能先阻塞的线程最后才访问队列。</p><p>LinkedBlockingQueue，由链表结构组成的有界阻塞队列，队列的默认和最大长度为 Integer 最大值。</p><p>PriorityBlockingQueue，支持优先级的无界阻塞队列，默认情况下元素按照升序排序。可自定义 <code>compareTo</code> 方法指定排序规则，或者初始化时指定 Comparator 排序，不能保证同优先级元素的顺序。</p><p>DelayQueue，支持延时获取元素的无界阻塞队列，使用优先级队列实现。创建元素时可以指定多久才能从队列中获取当前元素，只有延迟期满时才能从队列中获取元素，适用于缓存和定时调度。</p><p>SynchronousQueue，不存储元素的阻塞队列，每一个 put 必须等待一个 take。默认使用非公平策略，也支持公平策略，适用于传递性场景，吞吐量高。</p><p>LinkedTransferQueue，链表组成的无界阻塞队列，相对于其他阻塞队列多了 <code>tryTransfer</code> 和 <code>transfer</code> 方法。<code>transfer</code>方法：如果当前有消费者正等待接收元素，可以把生产者传入的元素立刻传输给消费者，否则会将元素放在队列的尾节点并等到该元素被消费者消费才返回。<code>tryTransfer</code> 方法用来试探生产者传入的元素能否直接传给消费者，如果没有消费者等待接收元素则返回 false，和 <code>transfer</code> 的区别是无论消费者是否消费都会立即返回。</p><p>LinkedBlockingDeque，链表组成的双向阻塞队列，可从队列的两端插入和移出元素，多线程同时入队时减少了竞争。</p><p><strong>实现原理</strong></p><p>使用通知模式实现，生产者往满的队列里添加元素时会阻塞，当消费者消费后，会通知生产者当前队列可用。当往队列里插入一个元素，如果队列不可用，阻塞生产者主要通过 LockSupport 的 <code>park</code> 方法实现，不同操作系统中实现方式不同，在 Linux 下使用的是系统方法 <code>pthread_cond_wait</code> 实现。</p><hr><h4 id="Q13：谈一谈-ThreadLocal"><a href="#Q13：谈一谈-ThreadLocal" class="headerlink" title="Q13：谈一谈 ThreadLocal"></a>Q13：谈一谈 ThreadLocal</h4><p>ThreadLoacl 是线程共享变量，主要用于一个线程内跨类、方法传递数据。ThreadLoacl 有一个静态内部类 ThreadLocalMap，其 Key 是 ThreadLocal 对象，值是 Entry 对象，Entry 中只有一个 Object 类的 vaule 值。ThreadLocal 是线程共享的，但 ThreadLocalMap 是每个线程私有的。ThreadLocal 主要有 set、get 和 remove 三个方法。</p><p><strong>set 方法</strong></p><p>首先获取当前线程，然后再获取当前线程对应的 ThreadLocalMap 类型的对象 map。如果 map 存在就直接设置值，key 是当前的 ThreadLocal 对象，value 是传入的参数。</p><p>如果 map 不存在就通过 <code>createMap</code> 方法为当前线程创建一个 ThreadLocalMap 对象再设置值。</p><p><strong>get 方法</strong></p><p>首先获取当前线程，然后再获取当前线程对应的 ThreadLocalMap 类型的对象 map。如果 map 存在就以当前 ThreadLocal 对象作为 key 获取 Entry 类型的对象 e，如果 e 存在就返回它的 value 属性。</p><p>如果 e 不存在或者 map 不存在，就调用 <code>setInitialValue</code> 方法先为当前线程创建一个 ThreadLocalMap 对象然后返回默认的初始值 null。</p><p><strong>remove 方法</strong></p><p>首先通过当前线程获取其对应的 ThreadLocalMap 类型的对象 m，如果 m 不为空，就解除 ThreadLocal 这个 key 及其对应的 value 值的联系。</p><p><strong>存在的问题</strong></p><p>线程复用会产生脏数据，由于线程池会重用 Thread 对象，因此与 Thread 绑定的 ThreadLocal 也会被重用。如果没有调用 remove 清理与线程相关的 ThreadLocal 信息，那么假如下一个线程没有调用 set 设置初始值就可能 get 到重用的线程信息。</p><p>ThreadLocal 还存在内存泄漏的问题，由于 ThreadLocal 是弱引用，但 Entry 的 value 是强引用，因此当 ThreadLocal 被垃圾回收后，value 依旧不会被释放。因此需要及时调用 remove 方法进行清理操作。</p><hr><h3 id="JUC-11"><a href="#JUC-11" class="headerlink" title="JUC 11"></a>JUC 11</h3><h4 id="Q1：什么是-CAS？"><a href="#Q1：什么是-CAS？" class="headerlink" title="Q1：什么是 CAS？"></a>Q1：什么是 CAS？</h4><p>CAS 表示 Compare And Swap，比较并交换，CAS 需要三个操作数，分别是内存位置 V、旧的预期值 A 和准备设置的新值 B。CAS 指令执行时，当且仅当 V 符合 A 时，处理器才会用 B 更新 V 的值，否则它就不执行更新。但不管是否更新都会返回 V 的旧值，这些处理过程是原子操作，执行期间不会被其他线程打断。</p><p>在 JDK 5 后，Java 类库中才开始使用 CAS 操作，该操作由 Unsafe 类里的 <code>compareAndSwapInt</code> 等几个方法包装提供。HotSpot 在内部对这些方法做了特殊处理，即时编译的结果是一条平台相关的处理器 CAS 指令。Unsafe 类不是给用户程序调用的类，因此 JDK9 前只有 Java 类库可以使用 CAS，譬如 juc 包里的 AtomicInteger类中 <code>compareAndSet</code> 等方法都使用了Unsafe 类的 CAS 操作实现。</p><hr><h4 id="Q2：CAS-有什么问题？"><a href="#Q2：CAS-有什么问题？" class="headerlink" title="Q2：CAS 有什么问题？"></a>Q2：CAS 有什么问题？</h4><p>CAS 从语义上来说存在一个逻辑漏洞：如果 V 初次读取时是 A，并且在准备赋值时仍为 A，这依旧不能说明它没有被其他线程更改过，因为这段时间内假设它的值先改为 B 又改回 A，那么 CAS 操作就会误认为它从来没有被改变过。</p><p>这个漏洞称为 ABA 问题，juc 包提供了一个 AtomicStampedReference，原子更新带有版本号的引用类型，通过控制变量值的版本来解决 ABA 问题。大部分情况下 ABA 不会影响程序并发的正确性，如果需要解决，传统的互斥同步可能会比原子类更高效。</p><hr><h4 id="Q3：有哪些原子类？"><a href="#Q3：有哪些原子类？" class="headerlink" title="Q3：有哪些原子类？"></a>Q3：有哪些原子类？</h4><p>JDK 5 提供了 java.util.concurrent.atomic 包，这个包中的原子操作类提供了一种用法简单、性能高效、线程安全地更新一个变量的方式。到 JDK 8 该包共有17个类，依据作用分为四种：原子更新基本类型类、原子更新数组类、原子更新引用类以及原子更新字段类，atomic 包里的类基本都是使用 Unsafe 实现的包装类。</p><p>AtomicInteger 原子更新整形、 AtomicLong 原子更新长整型、AtomicBoolean 原子更新布尔类型。</p><p>AtomicIntegerArray，原子更新整形数组里的元素、 AtomicLongArray 原子更新长整型数组里的元素、 AtomicReferenceArray 原子更新引用类型数组里的元素。</p><p>AtomicReference 原子更新引用类型、AtomicMarkableReference 原子更新带有标记位的引用类型，可以绑定一个 boolean 标记、 AtomicStampedReference 原子更新带有版本号的引用类型，关联一个整数值作为版本号，解决 ABA 问题。</p><p>AtomicIntegerFieldUpdater 原子更新整形字段的更新器、 AtomicLongFieldUpdater 原子更新长整形字段的更新器AtomicReferenceFieldUpdater 原子更新引用类型字段的更新器。</p><hr><h4 id="Q4：AtomicIntger-实现原子更新的原理是什么？"><a href="#Q4：AtomicIntger-实现原子更新的原理是什么？" class="headerlink" title="Q4：AtomicIntger 实现原子更新的原理是什么？"></a>Q4：AtomicIntger 实现原子更新的原理是什么？</h4><p>AtomicInteger 原子更新整形、 AtomicLong 原子更新长整型、AtomicBoolean 原子更新布尔类型。</p><p><code>getAndIncrement</code> 以原子方式将当前的值加 1，首先在 for 死循环中取得 AtomicInteger  里存储的数值，第二步对 AtomicInteger  当前的值加 1 ，第三步调用 <code>compareAndSet</code> 方法进行原子更新，先检查当前数值是否等于 expect，如果等于则说明当前值没有被其他线程修改，则将值更新为 next，否则会更新失败返回 false，程序会进入 for 循环重新进行 <code>compareAndSet</code> 操作。</p><p>atomic 包中只提供了三种基本类型的原子更新，atomic 包里的类基本都是使用 Unsafe 实现的，Unsafe 只提供三种 CAS 方法：<code>compareAndSwapInt</code>、<code>compareAndSwapLong</code> 和 <code>compareAndSwapObject</code>，例如原子更新 Boolean 是先转成整形再使用 <code>compareAndSwapInt</code> 。</p><hr><h4 id="Q5：CountDownLatch-是什么？"><a href="#Q5：CountDownLatch-是什么？" class="headerlink" title="Q5：CountDownLatch 是什么？"></a>Q5：CountDownLatch 是什么？</h4><p>CountDownLatch 是基于执行时间的同步类，允许一个或多个线程等待其他线程完成操作，构造方法接收一个 int 参数作为计数器，如果要等待 n 个点就传入 n。每次调用 <code>countDown</code> 方法时计数器减 1，<code>await</code> 方***阻塞当前线程直到计数器变为0，由于 <code>countDown</code> 方法可用在任何地方，所以 n 个点既可以是 n 个线程也可以是一个线程里的 n 个执行步骤。</p><hr><h4 id="Q6：-CyclicBarrier-是什么？"><a href="#Q6：-CyclicBarrier-是什么？" class="headerlink" title="Q6： CyclicBarrier 是什么？"></a>Q6： CyclicBarrier 是什么？</h4><p>循环屏障是基于同步到达某个点的信号量触发机制，作用是让一组线程到达一个屏障时被阻塞，直到最后一个线程到达屏障才会解除。构造方法中的参数表示拦截线程数量，每个线程调用 <code>await</code> 方法告诉 CyclicBarrier 自己已到达屏障，然后被阻塞。还支持在构造方法中传入一个 Runnable 任务，当线程到达屏障时会优先执行该任务。适用于多线程计算数据，最后合并计算结果的应用场景。</p><p>CountDownLacth 的计数器只能用一次，而 CyclicBarrier 的计数器可使用 <code>reset</code> 方法重置，所以 CyclicBarrier 能处理更为复杂的业务场景，例如计算错误时可用重置计数器重新计算。</p><hr><h4 id="Q7：Semaphore-是什么？"><a href="#Q7：Semaphore-是什么？" class="headerlink" title="Q7：Semaphore 是什么？"></a>Q7：Semaphore 是什么？</h4><p>信号量用来控制同时访问特定资源的线程数量，通过协调各个线程以保证合理使用公共资源。信号量可以用于流量控制，特别是公共资源有限的应用场景，比如数据库连接。</p><p>Semaphore 的构造方法参数接收一个 int 值，表示可用的许可数量即最大并发数。使用 <code>acquire</code> 方法获得一个许可证，使用 <code>release</code> 方法归还许可，还可以用 <code>tryAcquire</code> 尝试获得许可。</p><hr><h4 id="Q8：-Exchanger-是什么？"><a href="#Q8：-Exchanger-是什么？" class="headerlink" title="Q8： Exchanger 是什么？"></a>Q8： Exchanger 是什么？</h4><p>交换者是用于线程间协作的工具类，用于进行线程间的数据交换。它提供一个同步点，在这个同步点两个线程可以交换彼此的数据。</p><p>两个线程通过 <code>exchange</code> 方法交换数据，第一个线程执行 <code>exchange</code> 方法后会阻塞等待第二个线程执行该方法，当两个线程都到达同步点时这两个线程就可以交换数据，将本线程生产出的数据传递给对方。应用场景包括遗传算法、校对工作等。</p><hr><h4 id="P9：JDK7-的-ConcurrentHashMap-原理？"><a href="#P9：JDK7-的-ConcurrentHashMap-原理？" class="headerlink" title="P9：JDK7 的 ConcurrentHashMap 原理？"></a>P9：JDK7 的 ConcurrentHashMap 原理？</h4><p>ConcurrentHashMap 用于解决 HashMap 的线程不安全和 HashTable 的并发效率低，HashTable 之所以效率低是因为所有线程都必须竞争同一把锁，假如容器里有多把锁，每一把锁用于锁容器的部分数据，那么多线程访问容器不同数据段的数据时，线程间就不会存在锁竞争，从而有效提高并发效率，这就是 ConcurrentHashMap 的锁分段技术。首先将数据分成 Segment 数据段，然后给每一个数据段配一把锁，当一个线程占用锁访问其中一个段的数据时，其他段的数据也能被其他线程访问。</p><p>get 实现简单高效，先经过一次再散列，再用这个散列值通过散列运算定位到 Segment，最后通过散列算法定位到元素。get 的高效在于不需要加锁，除非读到空值才会加锁重读。get 方法中将共享变量定义为 volatile，在 get 操作里只需要读所以不用加锁。</p><p>put 必须加锁，首先定位到 Segment，然后进行插入操作，第一步判断是否需要对 Segment 里的 HashEntry 数组进行扩容，第二步定位添加元素的位置，然后将其放入数组。</p><p>size 操作用于统计元素的数量，必须统计每个 Segment 的大小然后求和，在统计结果累加的过程中，之前累加过的 count 变化几率很小，因此先尝试两次通过不加锁的方式统计结果，如果统计过程中容器大小发生了变化，再加锁统计所有 Segment 大小。判断容器是否发生变化根据 modCount 确定。</p><hr><h4 id="P10：JDK8-的-ConcurrentHashMap-原理？"><a href="#P10：JDK8-的-ConcurrentHashMap-原理？" class="headerlink" title="P10：JDK8 的 ConcurrentHashMap 原理？"></a>P10：JDK8 的 ConcurrentHashMap 原理？</h4><p>主要对 JDK7 做了三点改造：① 取消分段锁机制，进一步降低冲突概率。② 引入红黑树结构，同一个哈希槽上的元素个数超过一定阈值后，单向链表改为红黑树结构。③ 使用了更加优化的方式统计集合内的元素数量。具体优化表现在：在 put、resize 和 size 方法中设计元素总数的更新和计算都避免了锁，使用 CAS 代替。</p><p>get 同样不需要同步，put 操作时如果没有出现哈希冲突，就使用 CAS 添加元素，否则使用 synchronized 加锁添加元素。</p><p>当某个槽内的元素个数达到 7 且 table 容量不小于 64 时，链表转为红黑树。当某个槽内的元素减少到 6 时，由红黑树重新转为链表。在转化过程中，使用同步块锁住当前槽的首元素，防止其他线程对当前槽进行增删改操作，转化完成后利用 CAS 替换原有链表。由于 TreeNode 节点也存储了 next 引用，因此红黑树转为链表很简单，只需从 first 元素开始遍历所有节点，并把节点从 TreeNode 转为 Node 类型即可，当构造好新链表后同样用 CAS 替换红黑树。</p><hr><h4 id="P11：ArrayList-的线程安全集合是什么？"><a href="#P11：ArrayList-的线程安全集合是什么？" class="headerlink" title="P11：ArrayList 的线程安全集合是什么？"></a>P11：ArrayList 的线程安全集合是什么？</h4><p>可以使用 CopyOnWriteArrayList 代替 ArrayList，它实现了读写分离。写操作复制一个新的集合，在新集合内添加或删除元素，修改完成后再将原集合的引用指向新集合。这样做的好处是可以高并发地进行读写操作而不需要加锁，因为当前集合不会添加任何元素。使用时注意尽量设置容量初始值，并且可以使用批量添加或删除，避免多次扩容，比如只增加一个元素却复制整个集合。</p><p>适合读多写少，单个添加时效率极低。CopyOnWriteArrayList 是 fail-safe 的，并发包的集合都是这种机制，fail-safe 在安全的副本上遍历，集合修改与副本遍历没有任何关系，缺点是无法读取最新数据。这也是 CAP 理论中 C 和 A 的矛盾，即一致性与可用性的矛盾。</p><hr><h2 id="框架-27"><a href="#框架-27" class="headerlink" title="框架 27"></a>框架 27</h2><h3 id="Spring-IoC-11"><a href="#Spring-IoC-11" class="headerlink" title="Spring IoC 11"></a>Spring IoC 11</h3><h4 id="Q1：IoC-是什么？"><a href="#Q1：IoC-是什么？" class="headerlink" title="Q1：IoC 是什么？"></a>Q1：IoC 是什么？</h4><p>IoC 即控制反转，简单来说就是把原来代码里需要实现的对象创建、依赖反转给容器来帮忙实现，需要创建一个容器并且需要一种描述让容器知道要创建的对象间的关系，在 Spring 中管理对象及其依赖关系是通过 Spring 的 IoC 容器实现的。</p><p>IoC 的实现方式有依赖注入和依赖查找，由于依赖查找使用的很少，因此 IoC 也叫做依赖注入。依赖注入指对象被动地接受依赖类而不用自己主动去找，对象不是从容器中查找它依赖的类，而是在容器实例化对象时主动将它依赖的类注入给它。假设一个 Car 类需要一个 Engine 的对象，那么一般需要需要手动 new 一个 Engine，利用 IoC 就只需要定义一个私有的 Engine 类型的成员变量，容器会在运行时自动创建一个 Engine 的实例对象并将引用自动注入给成员变量。</p><hr><h4 id="Q2：IoC-容器初始化过程？"><a href="#Q2：IoC-容器初始化过程？" class="headerlink" title="Q2：IoC 容器初始化过程？"></a>Q2：IoC 容器初始化过程？</h4><p><strong>基于 XML 的容器初始化</strong></p><p>当创建一个 ClassPathXmlApplicationContext 时，构造方法做了两件事：① 调用父容器的构造方法为容器设置好 Bean 资源加载器。② 调用父类的 <code>setConfigLocations</code> 方法设置 Bean 配置信息的定位路径。</p><p>ClassPathXmlApplicationContext 通过调用父类 AbstractApplicationContext 的 <code>refresh</code> 方法启动整个 IoC 容器对 Bean 定义的载入过程，<code>refresh</code> 是一个模板方法，规定了 IoC 容器的启动流程。在创建 IoC 容器前如果已有容器存在，需要把已有的容器销毁，保证在 <code>refresh</code> 方法后使用的是新创建的 IoC 容器。</p><p>容器创建后通过 <code>loadBeanDefinitions</code> 方法加载 Bean 配置资源，该方法做两件事：① 调用资源加载器的方法获取要加载的资源。② 真正执行加载功能，由子类 XmlBeanDefinitionReader 实现。加载资源时首先解析配置文件路径，读取配置文件的内容，然后通过 XML 解析器将 Bean 配置信息转换成文档对象，之后按照 Spring Bean 的定义规则对文档对象进行解析。</p><p>Spring IoC 容器中注册解析的 Bean 信息存放在一个 HashMap 集合中，key 是字符串，值是 BeanDefinition，注册过程中需要使用 synchronized 保证线程安全。当配置信息中配置的 Bean 被解析且被注册到 IoC 容器中后，初始化就算真正完成了，Bean 定义信息已经可以使用且可被检索。Spring IoC 容器的作用就是对这些注册的 Bean 定义信息进行处理和维护，注册的 Bean 定义信息是控制反转和依赖注入的基础。</p><p><strong>基于注解的容器初始化</strong></p><p>分为两种：① 直接将注解 Bean 注册到容器中，可以在初始化容器时注册，也可以在容器创建之后手动注册，然后刷新容器使其对注册的注解 Bean 进行处理。② 通过扫描指定的包及其子包的所有类处理，在初始化注解容器时指定要自动扫描的路径。</p><hr><h4 id="Q3：依赖注入的实现方法有哪些？"><a href="#Q3：依赖注入的实现方法有哪些？" class="headerlink" title="Q3：依赖注入的实现方法有哪些？"></a>Q3：依赖注入的实现方法有哪些？</h4><p><strong>构造方法注入：</strong> IoC Service Provider 会检查被注入对象的构造方法，取得它所需要的依赖对象列表，进而为其注入相应的对象。这种方法的优点是在对象构造完成后就处于就绪状态，可以马上使用。缺点是当依赖对象较多时，构造方法的参数列表会比较长，构造方法无法被继承，无法设置默认值。对于非必需的依赖处理可能需要引入多个构造方法，参数数量的变动可能会造成维护的困难。</p><p><strong>setter 方法注入：</strong> 当前对象只需要为其依赖对象对应的属性添加 setter 方法，就可以通过 setter 方法将依赖对象注入到被依赖对象中。setter 方法注入在描述性上要比构造方法注入强，并且可以被继承，允许设置默认值。缺点是无法在对象构造完成后马上进入就绪状态。</p><p><strong>接口注入：</strong> 必须实现某个接口，接口提供方法来为其注入依赖对象。使用少，因为它强制要求被注入对象实现不必要接口，侵入性强。</p><hr><h4 id="Q4：依赖注入的相关注解？"><a href="#Q4：依赖注入的相关注解？" class="headerlink" title="Q4：依赖注入的相关注解？"></a>Q4：依赖注入的相关注解？</h4><p><code>@Autowired</code>：自动按类型注入，如果有多个匹配则按照指定 Bean 的 id 查找，查找不到会报错。</p><p><code>@Qualifier</code>：在自动按照类型注入的基础上再按照 Bean 的 id 注入，给变量注入时必须搭配 <code>@Autowired</code>，给方法注入时可单独使用。</p><p><code>@Resource</code> ：直接按照 Bean 的 id 注入，只能注入 Bean 类型。</p><p><code>@Value</code> ：用于注入基本数据类型和 String 类型。</p><hr><h4 id="Q5：依赖注入的过程？"><a href="#Q5：依赖注入的过程？" class="headerlink" title="Q5：依赖注入的过程？"></a>Q5：依赖注入的过程？</h4><p><code>getBean</code> 方法获取 Bean 实例，该方***调用 <code>doGetBean</code> ，<code>doGetBean</code> 真正实现从 IoC 容器获取 Bean 的功能，也是触发依赖注入的地方。</p><p>具体创建 Bean 对象的过程由 ObjectFactory 的 <code>createBean</code> 完成，该方法主要通过 <code>createBeanInstance</code> 方法生成 Bean 包含的 Java 对象实例和 <code>populateBean</code> 方法对 Bean 属性的依赖注入进行处理。</p><p>在 <code>populateBean</code>方法中，注入过程主要分为两种情况：① 属性值类型不需要强制转换时，不需要解析属性值，直接进行依赖注入。② 属性值类型需要强制转换时，首先解析属性值，然后对解析后的属性值进行依赖注入。依赖注入的过程就是将 Bean 对象实例设置到它所依赖的 Bean 对象属性上，真正的依赖注入是通过 <code>setPropertyValues</code> 方法实现的，该方法使用了委派模式。</p><p>BeanWrapperImpl 类负责对完成初始化的 Bean 对象进行依赖注入，对于非集合类型属性，使用 JDK 反射，通过属性的 setter 方法为属性设置注入后的值。对于集合类型的属性，将属性值解析为目标类型的集合后直接赋值给属性。</p><p>当容器对 Bean 的定位、载入、解析和依赖注入全部完成后就不再需要手动创建对象，IoC 容器会自动为我们创建对象并且注入依赖。</p><hr><h4 id="Q6：Bean-的生命周期？"><a href="#Q6：Bean-的生命周期？" class="headerlink" title="Q6：Bean 的生命周期？"></a>Q6：Bean 的生命周期？</h4><p>在 IoC 容器的初始化过程中会对 Bean 定义完成资源定位，加载读取配置并解析，最后将解析的 Bean 信息放在一个 HashMap 集合中。当 IoC 容器初始化完成后，会进行对 Bean 实例的创建和依赖注入过程，注入对象依赖的各种属性值，在初始化时可以指定自定义的初始化方法。经过这一系列初始化操作后 Bean 达到可用状态，接下来就可以使用 Bean 了，当使用完成后会调用 destroy 方法进行销毁，此时也可以指定自定义的销毁方法，最终 Bean 被销毁且从容器中移除。</p><p>XML 方式通过配置 bean 标签中的 init-Method 和 destory-Method 指定自定义初始化和销毁方法。 </p><p>注解方式通过 <code>@PreConstruct</code> 和 <code>@PostConstruct</code> 注解指定自定义初始化和销毁方法。</p><hr><h4 id="Q7：Bean-的作用范围？"><a href="#Q7：Bean-的作用范围？" class="headerlink" title="Q7：Bean 的作用范围？"></a>Q7：Bean 的作用范围？</h4><p>通过 scope 属性指定 bean 的作用范围，包括：</p><p>① singleton：单例模式，是默认作用域，不管收到多少 Bean 请求每个容器中只有一个唯一的 Bean 实例。</p><p>② prototype：原型模式，和 singleton 相反，每次 Bean 请求都会创建一个新的实例。</p><p>③ request：每次 HTTP 请求都会创建一个新的 Bean 并把它放到 request 域中，在请求完成后 Bean 会失效并被垃圾收集器回收。</p><p>④ session：和 request 类似，确保每个 session 中有一个 Bean 实例，session 过期后 bean 会随之失效。</p><p>⑤ global session：当应用部署在 Portlet 容器时，如果想让所有 Portlet 共用全局存储变量，那么该变量需要存储在 global session 中。</p><hr><h4 id="Q8：如何通过-XML-方式创建-Bean？"><a href="#Q8：如何通过-XML-方式创建-Bean？" class="headerlink" title="Q8：如何通过 XML 方式创建 Bean？"></a>Q8：如何通过 XML 方式创建 Bean？</h4><p>默认无参构造方法，只需要指明 bean 标签中的 id 和 class 属性，如果没有无参构造方***报错。</p><p>静态工厂方法，通过 bean 标签中的 class 属性指明静态工厂，factory-method 属性指明静态工厂方法。</p><p>实例工厂方法，通过 bean 标签中的 factory-bean 属性指明实例工厂，factory-method 属性指明实例工厂方法。</p><hr><h4 id="Q9：如何通过注解创建-Bean？"><a href="#Q9：如何通过注解创建-Bean？" class="headerlink" title="Q9：如何通过注解创建 Bean？"></a>Q9：如何通过注解创建 Bean？</h4><p><code>@Component</code> 把当前类对象存入 Spring 容器中，相当于在 xml 中配置一个 bean 标签。value 属性指定 bean 的 id，默认使用当前类的首字母小写的类名。</p><p><code>@Controller</code>，<code>@Service</code>，<code>@Repository</code> 三个注解都是 <code>@Component</code>  的衍生注解，作用及属性都是一模一样的。只是提供了更加明确语义，<code>@Controller</code> 用于表现层，<code>@Service</code>用于业务层，<code>@Repository</code>用于持久层。如果注解中有且只有一个 value 属性要赋值时可以省略 value。</p><p>如果想将第三方的类变成组件又没有源代码，也就没办法使用 <code>@Component</code> 进行自动配置，这种时候就要使用 <code>@Bean</code> 注解。被 <code>@Bean</code> 注解的方法返回值是一个对象，将会实例化，配置和初始化一个新对象并返回，这个对象由 Spring 的 IoC 容器管理。name 属性用于给当前 <code>@Bean</code>  注解方法创建的对象指定一个名称，即 bean 的 id。当使用注解配置方法时，如果方法有参数，Spring 会去容器查找是否有可用 bean对象，查找方式和 <code>@Autowired</code> 一样。</p><hr><h4 id="Q10：如何通过注解配置文件？"><a href="#Q10：如何通过注解配置文件？" class="headerlink" title="Q10：如何通过注解配置文件？"></a>Q10：如何通过注解配置文件？</h4><p><code>@Configuration</code> 用于指定当前类是一个 spring 配置类，当创建容器时会从该类上加载注解，value 属性用于指定配置类的字节码。</p><p><code>@ComponentScan</code> 用于指定 Spring 在初始化容器时要扫描的包。basePackages 属性用于指定要扫描的包。</p><p><code>@PropertySource</code> 用于加载 <code>.properties</code> 文件中的配置。value 属性用于指定文件位置，如果是在类路径下需要加上 classpath。</p><p><code>@Import</code> 用于导入其他配置类，在引入其他配置类时可以不用再写 <code>@Configuration</code> 注解。有 <code>@Import</code> 的是父配置类，引入的是子配置类。value 属性用于指定其他配置类的字节码。</p><hr><h4 id="Q11：BeanFactory、FactoryBean-和-ApplicationContext-的区别？"><a href="#Q11：BeanFactory、FactoryBean-和-ApplicationContext-的区别？" class="headerlink" title="Q11：BeanFactory、FactoryBean 和 ApplicationContext 的区别？"></a>Q11：BeanFactory、FactoryBean 和 ApplicationContext 的区别？</h4><p>BeanFactory 是一个 Bean 工厂，使用简单工厂模式，是 Spring IoC 容器顶级接口，可以理解为含有 Bean 集合的工厂类，作用是管理 Bean，包括实例化、定位、配置对象及建立这些对象间的依赖。BeanFactory 实例化后并不会自动实例化 Bean，只有当 Bean 被使用时才实例化与装配依赖关系，属于延迟加载，适合多例模式。</p><p>FactoryBean 是一个工厂 Bean，使用了工厂方法模式，作用是生产其他 Bean 实例，可以通过实现该接口，提供一个工厂方法来自定义实例化 Bean 的逻辑。FactoryBean 接口由 BeanFactory 中配置的对象实现，这些对象本身就是用于创建对象的工厂，如果一个 Bean 实现了这个接口，那么它就是创建对象的工厂 Bean，而不是 Bean 实例本身。</p><p>ApplicationConext 是 BeanFactory 的子接口，扩展了 BeanFactory 的功能，提供了支持国际化的文本消息，统一的资源文件读取方式，事件传播以及应用层的特别配置等。容器会在初始化时对配置的 Bean 进行预实例化，Bean 的依赖注入在容器初始化时就已经完成，属于立即加载，适合单例模式，一般推荐使用。</p><hr><h3 id="Spring-AOP-4"><a href="#Spring-AOP-4" class="headerlink" title="Spring AOP 4"></a>Spring AOP 4</h3><h4 id="Q1：AOP-是什么？"><a href="#Q1：AOP-是什么？" class="headerlink" title="Q1：AOP 是什么？"></a>Q1：AOP 是什么？</h4><p>AOP 即面向切面编程，简单地说就是将代码中重复的部分抽取出来，在需要执行的时候使用动态代理技术，在不修改源码的基础上对方法进行增强。</p><p>Spring 根据类是否实现接口来判断动态代理方式，如果实现接口会使用 JDK 的动态代理，核心是 InvocationHandler 接口和 Proxy 类，如果没有实现接口会使用 CGLib 动态代理，CGLib 是在运行时动态生成某个类的子类，如果某个类被标记为 final，不能使用 CGLib 。</p><p>JDK 动态代理主要通过重组字节码实现，首先获得被代理对象的引用和所有接口，生成新的类必须实现被代理类的所有接口，动态生成Java 代码后编译新生成的 <code>.class</code> 文件并重新加载到 JVM 运行。JDK 代理直接写 Class 字节码，CGLib 是采用 ASM 框架写字节码，生成代理类的效率低。但是 CGLib 调用方法的效率高，因为 JDK 使用反射调用方法，CGLib 使用 FastClass 机制为代理类和被代理类各生成一个类，这个类会为代理类或被代理类的方法生成一个 index，这个 index 可以作为参数直接定位要调用的方法。</p><p>常用场景包括权限认证、自动缓存、错误处理、日志、调试和事务等。</p><hr><h4 id="Q2：AOP-的相关注解有哪些？"><a href="#Q2：AOP-的相关注解有哪些？" class="headerlink" title="Q2：AOP 的相关注解有哪些？"></a>Q2：AOP 的相关注解有哪些？</h4><p><code>@Aspect</code>：声明被注解的类是一个切面 Bean。</p><p><code>@Before</code>：前置通知，指在某个连接点之前执行的通知。</p><p><code>@After</code>：后置通知，指某个连接点退出时执行的通知（不论正常返回还是异常退出）。</p><p><code>@AfterReturning</code>：返回后通知，指某连接点正常完成之后执行的通知，返回值使用returning属性接收。</p><p><code>@AfterThrowing</code>：异常通知，指方法抛出异常导致退出时执行的通知，和<code>@AfterReturning</code>只会有一个执行，异常使用throwing属性接收。</p><hr><h4 id="Q3：AOP-的相关术语有什么？"><a href="#Q3：AOP-的相关术语有什么？" class="headerlink" title="Q3：AOP 的相关术语有什么？"></a>Q3：AOP 的相关术语有什么？</h4><p><code>Aspect</code>：切面，一个关注点的模块化，这个关注点可能会横切多个对象。</p><p><code>Joinpoint</code>：连接点，程序执行过程中的某一行为，即业务层中的所有方法。。</p><p><code>Advice</code>：通知，指切面对于某个连接点所产生的动作，包括前置通知、后置通知、返回后通知、异常通知和环绕通知。</p><p><code>Pointcut</code>：切入点，指被拦截的连接点，切入点一定是连接点，但连接点不一定是切入点。</p><p><code>Proxy</code>：代理，Spring AOP 中有 JDK 动态代理和 CGLib 代理，目标对象实现了接口时采用 JDK 动态代理，反之采用 CGLib 代理。</p><p><code>Target</code>：代理的目标对象，指一个或多个切面所通知的对象。</p><p><code>Weaving</code> ：织入，指把增强应用到目标对象来创建代理对象的过程。</p><hr><h4 id="Q4：AOP-的过程？"><a href="#Q4：AOP-的过程？" class="headerlink" title="Q4：AOP 的过程？"></a>Q4：AOP 的过程？</h4><p>Spring AOP 由 BeanPostProcessor 后置处理器开始，这个后置处理器是一个***，可以监听容器触发的 Bean 生命周期事件，向容器注册后置处理器以后，容器中管理的 Bean 就具备了接收 IoC 容器回调事件的能力。BeanPostProcessor 的调用发生在 Spring IoC 容器完成 Bean 实例对象的创建和属性的依赖注入后，为 Bean 对象添加后置处理器的入口是 <code>initializeBean</code> 方法。</p><p>Spring 中 JDK 动态代理通过 JdkDynamicAopProxy 调用 Proxy 的 <code>newInstance</code> 方法来生成代理类，JdkDynamicAopProxy 也实现了 InvocationHandler 接口，<code>invoke</code> 方法的具体逻辑是先获取应用到此方法上的拦截器链，如果有拦截器则创建 MethodInvocation 并调用其 <code>proceed</code> 方法，否则直接反射调用目标方法。因此 Spring AOP 对目标对象的增强是通过拦截器实现的。</p><hr><h3 id="Spring-MVC-3"><a href="#Spring-MVC-3" class="headerlink" title="Spring MVC 3"></a>Spring MVC 3</h3><h4 id="Q1：Spring-MVC-的处理流程？"><a href="#Q1：Spring-MVC-的处理流程？" class="headerlink" title="Q1：Spring MVC 的处理流程？"></a>Q1：Spring MVC 的处理流程？</h4><p>Web 容器启动时会通知 Spring 初始化容器，加载 Bean 的定义信息并初始化所有单例 Bean，然后遍历容器中的 Bean，获取每一个 Controller 中的所有方法访问的 URL，将 URL 和对应的 Controller 保存到一个 Map 集合中。</p><p>所有的请求会转发给 DispatcherServlet 前端处理器处理，DispatcherServlet 会请求 HandlerMapping 找出容器中被 <code>@Controler</code> 注解修饰的 Bean 以及被 <code>@RequestMapping</code> 修饰的方法和类，生成 Handler 和 HandlerInterceptor 并以一个 HandlerExcutionChain 处理器执行链的形式返回。</p><p>之后 DispatcherServlet 使用 Handler 找到对应的 HandlerApapter，通过 HandlerApapter 调用 Handler 的方法，将请求参数绑定到方法的形参上，执行方法处理请求并得到 ModelAndView。</p><p>最后 DispatcherServlet 根据使用 ViewResolver 试图解析器对得到的 ModelAndView 逻辑视图进行解析得到 View 物理视图，然后对视图渲染，将数据填充到视图中并返回给客户端。</p><hr><h4 id="Q2：Spring-MVC-有哪些组件？"><a href="#Q2：Spring-MVC-有哪些组件？" class="headerlink" title="Q2：Spring MVC 有哪些组件？"></a>Q2：Spring MVC 有哪些组件？</h4><p><code>DispatcherServlet</code>：SpringMVC 中的前端控制器，是整个流程控制的核心，负责接收请求并转发给对应的处理组件。</p><p><code>Handler</code>：处理器，完成具体业务逻辑，相当于 Servlet 或 Action。</p><p><code>HandlerMapping</code>：完成 URL 到 Controller 映射，DispatcherServlet 通过 HandlerMapping 将不同请求映射到不同 Handler。</p><p><code>HandlerInterceptor</code>：处理器拦截器，是一个接口，如果需要完成一些拦截处理，可以实现该接口。</p><p><code>HandlerExecutionChain</code>：处理器执行链，包括两部分内容：Handler 和 HandlerInterceptor。</p><p><code>HandlerAdapter</code>：处理器适配器，Handler执行业务方法前需要进行一系列操作，包括表单数据验证、数据类型转换、将表单数据封装到JavaBean等，这些操作都由 HandlerAdapter 完成。DispatcherServlet 通过 HandlerAdapter 来执行不同的 Handler。</p><p><code>ModelAndView</code>：装载模型数据和视图信息，作为 Handler 处理结果返回给 DispatcherServlet。</p><p><code>ViewResolver</code>：视图解析器，DispatcherServlet 通过它将逻辑视图解析为物理视图，最终将渲染的结果响应给客户端。</p><hr><h4 id="Q3：Spring-MVC-的相关注解？"><a href="#Q3：Spring-MVC-的相关注解？" class="headerlink" title="Q3：Spring MVC 的相关注解？"></a>Q3：Spring MVC 的相关注解？</h4><p><code>@Controller</code>：在类定义处添加，将类交给IoC容器管理。</p><p><code>@RequtestMapping</code>：将URL请求和业务方法映射起来，在类和方法定义上都可以添加该注解。<code>value</code> 属性指定URL请求的实际地址，是默认值。<code>method</code> 属性限制请求的方法类型，包括GET、POST、PUT、DELETE等。如果没有使用指定的请求方法请求URL，会报405 Method Not Allowed 错误。<code>params</code> 属性限制必须提供的参数，如果没有会报错。</p><p><code>@RequestParam</code>：如果 Controller 方法的形参和 URL 参数名一致可以不添加注解，如果不一致可以使用该注解绑定。<code>value</code> 属性表示HTTP请求中的参数名。<code>required</code> 属性设置参数是否必要，默认false。<code>defaultValue</code> 属性指定没有给参数赋值时的默认值。</p><p><code>@PathVariable</code>：Spring MVC 支持 RESTful 风格 URL，通过 <code>@PathVariable</code> 完成请求参数与形参的绑定。</p><hr><h3 id="Spring-Data-JPA-4"><a href="#Spring-Data-JPA-4" class="headerlink" title="Spring Data JPA 4"></a>Spring Data JPA 4</h3><h4 id="Q1：ORM-是什么？"><a href="#Q1：ORM-是什么？" class="headerlink" title="Q1：ORM 是什么？"></a>Q1：ORM 是什么？</h4><p>ORM 即 Object-Relational Mapping ，表示对象关系映射，映射的不只是对象的值还有对象之间的关系，通过 ORM 就可以把对象映射到关系型数据库中。操作实体类就相当于操作数据库表，可以不再重点关注 SQL 语句。</p><hr><h4 id="Q2：JPA-如何使用？"><a href="#Q2：JPA-如何使用？" class="headerlink" title="Q2：JPA 如何使用？"></a>Q2：JPA 如何使用？</h4><p>只需要持久层接口继承 JpaRepository 即可，泛型参数列表中第一个参数是实体类类型，第二个参数是主键类型。</p><p>运行时通过 <code>JdkDynamicAopProxy</code> 的 <code>invoke</code> 方法创建了一个动态代理对象 <code>SimpleJpaRepository</code>，<code>SimpleJpaRepository</code> 中封装了 JPA 的操作，通过 <code>hibernate</code>（封装了JDBC）完成数据库操作。</p><hr><h4 id="Q3：JPA-实体类相关注解有哪些？"><a href="#Q3：JPA-实体类相关注解有哪些？" class="headerlink" title="Q3：JPA 实体类相关注解有哪些？"></a>Q3：JPA 实体类相关注解有哪些？</h4><p><code>@Entity</code>：表明当前类是一个实体类。</p><p><code>@Table</code> ：关联实体类和数据库表。</p><p><code>@Column</code> ：关联实体类属性和数据库表中字段。</p><p><code>@Id</code> ：声明当前属性为数据库表主键对应的属性。</p><p><code>@GeneratedValue</code>： 配置主键生成策略。</p><p><code>@OneToMany</code> ：配置一对多关系，mappedBy 属性值为主表实体类在从表实体类中对应的属性名。</p><p><code>@ManyToOne</code> ：配置多对一关系，targetEntity 属性值为主表对应实体类的字节码。</p><p><code>@JoinColumn</code>：配置外键关系，name 属性值为外键名称，referencedColumnName 属性值为主表主键名称。</p><hr><h4 id="Q4：对象导航查询是什么？"><a href="#Q4：对象导航查询是什么？" class="headerlink" title="Q4：对象导航查询是什么？"></a>Q4：对象导航查询是什么？</h4><p>通过 get 方法查询一个对象的同时，通过此对象可以查询它的关联对象。</p><p>对象导航查询一到多默认使用延迟加载的形式， 关联对象是集合，因此使用立即加载可能浪费资源。</p><p>对象导航查询多到一默认使用立即加载的形式， 关联对象是一个对象，因此使用立即加载。</p><p>如果要改变加载方式，在实体类注解配置加上 fetch 属性即可，LAZY 表示延迟加载，EAGER 表示立即加载。</p><hr><h3 id="Mybatis-5"><a href="#Mybatis-5" class="headerlink" title="Mybatis 5"></a>Mybatis 5</h3><h4 id="Q1：Mybatis-的优缺点？"><a href="#Q1：Mybatis-的优缺点？" class="headerlink" title="Q1：Mybatis 的优缺点？"></a>Q1：Mybatis 的优缺点？</h4><p><strong>优点</strong></p><p>相比 JDBC 减少了大量代码量，减少冗余代码。</p><p>使用灵活，SQL 语句写在 XML 里，从程序代码中彻底分离，降低了耦合度，便于管理。</p><p>提供 XML 标签，支持编写动态 SQL 语句。</p><p>提供映射标签，支持对象与数据库的 ORM 字段映射关系。</p><p><strong>缺点</strong></p><p>SQL 语句编写工作量较大，尤其是字段和关联表多时。</p><p>SQL 语句依赖于数据库，导致数据库移植性差，不能随意更换数据库。</p><hr><h4 id="Q2：Mybatis-的-XML-文件有哪些标签属性？"><a href="#Q2：Mybatis-的-XML-文件有哪些标签属性？" class="headerlink" title="Q2：Mybatis 的 XML 文件有哪些标签属性？"></a>Q2：Mybatis 的 XML 文件有哪些标签属性？</h4><p><code>select</code>、<code>insert</code>、<code>update</code>、<code>delete</code> 标签分别对应查询、添加、更新、删除操作。</p><p><code>parameterType</code>  属性表示参数的数据类型，包括基本数据类型和对应的包装类型、String 和 Java Bean 类型，当有多个参数时可以使用 <code>#{argn}</code> 的形式表示第 n 个参数。除了基本数据类型都要以全限定类名的形式指定参数类型。</p><p><code>resultType</code>  表示返回的结果类型，包括基本数据类型和对应的包装类型、String 和 Java Bean 类型。还可以使用把返回结果封装为复杂类型的 <code>resultMap</code> 。</p><hr><h4 id="Q3：Mybatis-的一级缓存是什么？"><a href="#Q3：Mybatis-的一级缓存是什么？" class="headerlink" title="Q3：Mybatis 的一级缓存是什么？"></a>Q3：Mybatis 的一级缓存是什么？</h4><p>一级缓存是 SqlSession 级别，默认开启且不能关闭。</p><p>操作数据库时需要创建 SqlSession 对象，对象中有一个 HashMap 存储缓存数据，不同 SqlSession 之间缓存数据区域互不影响。</p><p>一级缓存的作用域是 SqlSession 范围的，在同一个 SqlSession 中执行两次相同的 SQL 语句时，第一次执行完毕会将结果保存在缓存中，第二次查询直接从缓存中获取。</p><p>如果 SqlSession 执行了 DML 操作（insert、update、delete），Mybatis 必须将缓存清空保证数据有效性。 </p><hr><h4 id="Q4：Mybatis-的二级缓存是什么？"><a href="#Q4：Mybatis-的二级缓存是什么？" class="headerlink" title="Q4：Mybatis 的二级缓存是什么？"></a>Q4：Mybatis 的二级缓存是什么？</h4><p>二级缓存是Mapper 级别，默认关闭。</p><p>使用二级缓存时多个 SqlSession 使用同一个 Mapper 的 SQL 语句操作数据库，得到的数据会存在二级缓存区，同样使用 HashMap 进行数据存储，相比于一级缓存，二级缓存范围更大，多个 SqlSession 可以共用二级缓存，作用域是 Mapper 的同一个 namespace，不同 SqlSession 两次执行相同的 namespace 下的 SQL 语句，参数也相等，则第一次执行成功后会将数据保存在二级缓存中，第二次可直接从二级缓存中取出数据。</p><p>要使用二级缓存，需要在全局配置文件中配置 <code>，再在对应的映射文件中配置一个</code> 标签。</p><hr><h4 id="Q5：Mybatis-和-的区别？"><a href="#Q5：Mybatis-和-的区别？" class="headerlink" title="Q5：Mybatis  #{} 和 ${} 的区别？"></a>Q5：Mybatis  <code>#{}</code> 和 <code>${}</code> 的区别？</h4><p>使用 <code>${}</code>  相当于使用字符串拼接，存在 SQL 注入的风险。</p><p>使用 <code>#{}</code> 相当于使用占位符，可以防止 SQL 注入，不支持使用占位符的地方就只能使用 <code>${}</code> ，典型情况就是动态参数。</p><hr><h2 id="数据结构和算法-13"><a href="#数据结构和算法-13" class="headerlink" title="数据结构和算法 13"></a>数据结构和算法 13</h2><h3 id="数据结构-4"><a href="#数据结构-4" class="headerlink" title="数据结构 4"></a>数据结构 4</h3><h4 id="Q1：什么是-AVL-树？"><a href="#Q1：什么是-AVL-树？" class="headerlink" title="Q1：什么是 AVL 树？"></a>Q1：什么是 AVL 树？</h4><p>AVL 树是平衡二叉查找树，增加和删除节点后通过树形旋转重新达到平衡。右旋是以某个节点为中心，将它沉入当前右子节点的位置，而让当前的左子节点作为新树的根节点，也称为顺时针旋转。同理左旋是以某个节点为中心，将它沉入当前左子节点的位置，而让当前的右子节点作为新树的根节点，也称为逆时针旋转。</p><hr><h4 id="Q2：什么是红黑树？"><a href="#Q2：什么是红黑树？" class="headerlink" title="Q2：什么是红黑树？"></a>Q2：什么是红黑树？</h4><p>红黑树是 1972 年发明的，称为对称二叉 B 树，1978 年正式命名红黑树。主要特征是在每个节点上增加一个属性表示节点颜色，可以红色或黑色。红黑树和 AVL 树类似，都是在进行插入和删除时通过旋转保持自身平衡，从而获得较高的查找性能。与 AVL 树相比，红黑树不追求所有递归子树的高度差不超过 1，保证从根节点到叶尾的最长路径不超过最短路径的 2 倍，所以最差时间复杂度是 O(log<del>n</del>)。红黑树通过重新着色和左右旋转，更加高效地完成了插入和删除之后的自平衡调整。</p><p>红黑树在本质上还是二叉查找树，它额外引入了 5 个约束条件：① 节点只能是红色或黑色。② 根节点必须是黑色。③ 所有 NIL 节点都是黑色的。④ 一条路径上不能出现相邻的两个红色节点。⑤ 在任何递归子树中，根节点到叶子节点的所有路径上包含相同数目的黑色节点。这五个约束条件保证了红黑树的新增、删除、查找的最坏时间复杂度均为 O(log<del>n</del>)。如果一个树的左子节点或右子节点不存在，则均认定为黑色。红黑树的任何旋转在 3 次之内均可完成。</p><hr><h4 id="Q3：AVL-树和红黑树的区别？"><a href="#Q3：AVL-树和红黑树的区别？" class="headerlink" title="Q3：AVL 树和红黑树的区别？"></a>Q3：AVL 树和红黑树的区别？</h4><p>红黑树的平衡性不如 AVL 树，它维持的只是一种大致的平衡，不严格保证左右子树的高度差不超过 1。这导致节点数相同的情况下，红黑树的高度可能更高，也就是说平均查找次数会高于相同情况的 AVL 树。</p><p>在插入时，红黑树和 AVL 树都能在至多两次旋转内恢复平衡，在删除时由于红黑树只追求大致平衡，因此红黑树至多三次旋转可以恢复平衡，而 AVL 树最多需要 O(log<del>n</del>) 次。AVL 树在插入和删除时，将向上回溯确定是否需要旋转，这个回溯的时间成本最差为 O(log<del>n</del>)，而红黑树每次向上回溯的步长为 2，回溯成本低。因此面对频繁地插入与删除红黑树更加合适。</p><hr><h4 id="Q4：B-树和B-树的区别？"><a href="#Q4：B-树和B-树的区别？" class="headerlink" title="Q4：B 树和B+ 树的区别？"></a>Q4：B 树和B+ 树的区别？</h4><p>B 树中每个节点同时存储 key 和 data，而 B+ 树中只有叶子节点才存储 data，非叶子节点只存储 key。InnoDB 对 B+ 树进行了优化，在每个叶子节点上增加了一个指向相邻叶子节点的链表指针，形成了带有顺序指针的 B+ 树，提高区间访问的性能。</p><p>B+ 树的优点在于：① 由于 B+ 树在非叶子节点上不含数据信息，因此在内存页中能够存放更多的 key，数据存放得更加紧密，具有更好的空间利用率，访问叶子节点上关联的数据也具有更好的缓存命中率。② B+树的叶子结点都是相连的，因此对整棵树的遍历只需要一次线性遍历叶子节点即可。而 B 树则需要进行每一层的递归遍历，相邻的元素可能在内存中不相邻，所以缓存命中性没有 B+树好。但是 B 树也有优点，由于每个节点都包含 key 和 value，因此经常访问的元素可能离根节点更近，访问也更迅速。</p><hr><h3 id="排序-9"><a href="#排序-9" class="headerlink" title="排序 9"></a>排序 9</h3><h4 id="Q1：排序有哪些分类？"><a href="#Q1：排序有哪些分类？" class="headerlink" title="Q1：排序有哪些分类？"></a>Q1：排序有哪些分类？</h4><p>排序可以分为内部排序和外部排序，在内存中进行的称为内部排序，当数据量很大时无法全部拷贝到内存需要使用外存，称为外部排序。</p><p>内部排序包括比较排序和非比较排序，比较排序包括插入/选择/交换/归并排序，非比较排序包括计数/基数/桶排序。</p><p>插入排序包括直接插入/希尔排序，选择排序包括直接选择/堆排序，交换排序包括冒泡/快速排序。</p><hr><h4 id="Q2：直接插入排序的原理？"><a href="#Q2：直接插入排序的原理？" class="headerlink" title="Q2：直接插入排序的原理？"></a>Q2：直接插入排序的原理？</h4><p>稳定，平均/最差时间复杂度 O(n²)，元素基本有序时最好时间复杂度 O(n)，空间复杂度 O(1)。</p><p>每一趟将一个待排序记录按其关键字的大小插入到已排好序的一组记录的适当位置上，直到所有待排序记录全部插入为止。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line">public void insertionSort(int[] nums) &#123;</span><br><span class="line">    for (int i = 1; i &lt; nums.length; i++) &#123;</span><br><span class="line">        int insertNum = nums[i];</span><br><span class="line">        int insertIndex;</span><br><span class="line">        for (insertIndex = i - 1; insertIndex &gt;= 0 &amp;&amp;</span><br><span class="line">nums[insertIndex] &gt; insertNum; insertIndex--) &#123;</span><br><span class="line">            nums[insertIndex + 1] = nums[insertIndex];</span><br><span class="line">        &#125;</span><br><span class="line">        nums[insertIndex + 1] = insertNum;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>直接插入没有利用到要插入的序列已有序的特点，插入第 i 个元素时可以通过二分查找找到插入位置 insertIndex，再把 i~insertIndex 之间的所有元素后移一位，把第 i 个元素放在插入位置上。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br></pre></td><td class="code"><pre><span class="line">public void binaryInsertionSort(int[] nums) &#123;</span><br><span class="line">    for (int i = 1; i &lt; nums.length; i++) &#123;</span><br><span class="line">        int insertNum = nums[i];</span><br><span class="line">        int insertIndex = -1;</span><br><span class="line">        int start = 0;</span><br><span class="line">        int end = i - 1;</span><br><span class="line">        while (start &lt;= end) &#123;</span><br><span class="line">            int mid = start + (end - start) / 2;</span><br><span class="line">            if (insertNum &gt; nums[mid])</span><br><span class="line">                start = mid + 1;</span><br><span class="line">            else if (insertNum &lt; nums[mid])</span><br><span class="line">                end = mid - 1;</span><br><span class="line">            else &#123;</span><br><span class="line">                insertIndex = mid + 1;</span><br><span class="line">                break;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        if (insertIndex == -1)</span><br><span class="line">            insertIndex = start;</span><br><span class="line">        if (i - insertIndex &gt;= 0)</span><br><span class="line">            System.arraycopy(nums, insertIndex, nums, insertIndex + 1, i - insertIndex);</span><br><span class="line">        nums[insertIndex] = insertNum;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="Q3：希尔排序的原理？"><a href="#Q3：希尔排序的原理？" class="headerlink" title="Q3：希尔排序的原理？"></a>Q3：希尔排序的原理？</h4><p>又称缩小增量排序，是对直接插入排序的改进，不稳定，平均时间复杂度 O(n^1.3^)，最差时间复杂度 O(n²)，最好时间复杂度 O(n)，空间复杂度 O(1)。</p><p>把记录按下标的一定增量分组，对每组进行直接插入排序，每次排序后减小增量，当增量减至 1 时排序完毕。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">public void shellSort(int[] nums) &#123;</span><br><span class="line">    for (int d = nums.length / 2; d &gt; 0 ; d /= 2) &#123;</span><br><span class="line">        for (int i = d; i &lt; nums.length; i++) &#123;</span><br><span class="line">            int insertNum = nums[i];</span><br><span class="line">            int insertIndex;</span><br><span class="line">            for (insertIndex = i - d; insertIndex &gt;= 0 &amp;&amp; nums[insertIndex] &gt; insertNum; insertIndex -= d) &#123;</span><br><span class="line">                nums[insertIndex + d] = nums[insertIndex];</span><br><span class="line">            &#125;</span><br><span class="line">            nums[insertIndex + d] = insertNum;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="Q4：直接选择排序的原理？"><a href="#Q4：直接选择排序的原理？" class="headerlink" title="Q4：直接选择排序的原理？"></a>Q4：直接选择排序的原理？</h4><p>不稳定，时间复杂度 O(n²)，空间复杂度 O(1)。</p><p>每次在未排序序列中找到最小元素，和未排序序列的第一个元素交换位置，再在剩余未排序序列中重复该操作直到所有元素排序完毕。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line">public void selectSort(int[] nums) &#123;</span><br><span class="line">    int minIndex;</span><br><span class="line">    for (int index = 0; index &lt; nums.length - 1; index++)&#123;</span><br><span class="line">        minIndex = index;</span><br><span class="line">        for (int i = index + 1;i &lt; nums.length; i++)&#123;</span><br><span class="line">            if(nums[i] &lt; nums[minIndex]) </span><br><span class="line">                minIndex = i;</span><br><span class="line">        &#125;</span><br><span class="line">        if (index != minIndex)&#123;</span><br><span class="line">            swap(nums, index, minIndex);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="Q5：堆排序的原理？"><a href="#Q5：堆排序的原理？" class="headerlink" title="Q5：堆排序的原理？"></a>Q5：堆排序的原理？</h4><p>是对直接选择排序的改进，不稳定，时间复杂度 O(nlogn)，空间复杂度 O(1)。</p><p>将待排序记录看作完全二叉树，可以建立大根堆或小根堆，大根堆中每个节点的值都不小于它的子节点值，小根堆中每个节点的值都不大于它的子节点值。</p><p>以大根堆为例，在建堆时首先将最后一个节点作为当前节点，如果当前节点存在父节点且值大于父节点，就将当前节点和父节点交换。在移除时首先暂存根节点的值，然后用最后一个节点代替根节点并作为当前节点，如果当前节点存在子节点且值小于子节点，就将其与值较大的子节点进行交换，调整完堆后返回暂存的值。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line">public void add(int[] nums, int i, int num)&#123;</span><br><span class="line">    nums[i] = num;</span><br><span class="line">    int curIndex = i;</span><br><span class="line">    while (curIndex &gt; 0) &#123;</span><br><span class="line">        int parentIndex = (curIndex - 1) / 2;</span><br><span class="line">        if (nums[parentIndex] &lt; nums[curIndex]) </span><br><span class="line">            swap(nums, parentIndex, curIndex);</span><br><span class="line">        else break;</span><br><span class="line">        curIndex = parentIndex;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">public int remove(int[] nums, int size)&#123;</span><br><span class="line">    int result = nums[0];</span><br><span class="line">    nums[0] = nums[size - 1];</span><br><span class="line">    int curIndex = 0;</span><br><span class="line">    while (true) &#123;</span><br><span class="line">        int leftIndex = curIndex * 2 + 1;</span><br><span class="line">        int rightIndex = curIndex * 2 + 2;</span><br><span class="line">        if (leftIndex &gt;= size) break;</span><br><span class="line">        int maxIndex = leftIndex;</span><br><span class="line">        if (rightIndex &lt; size &amp;&amp; nums[maxIndex] &lt; nums[rightIndex])</span><br><span class="line">            maxIndex = rightIndex;</span><br><span class="line">        if (nums[curIndex] &lt; nums[maxIndex])</span><br><span class="line">            swap(nums, curIndex, maxIndex);</span><br><span class="line">        else break;</span><br><span class="line">        curIndex = maxIndex;</span><br><span class="line">    &#125;</span><br><span class="line">    return result;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="Q6：冒泡排序的原理？"><a href="#Q6：冒泡排序的原理？" class="headerlink" title="Q6：冒泡排序的原理？"></a>Q6：冒泡排序的原理？</h4><p>稳定，平均/最坏时间复杂度 O(n²)，元素基本有序时最好时间复杂度 O(n)，空间复杂度 O(1)。</p><p>比较相邻的元素，如果第一个比第二个大就进行交换，对每一对相邻元素做同样的工作，从开始第一对到结尾的最后一对，每一轮排序后末尾元素都是有序的，针对 n 个元素重复以上步骤 n -1 次排序完毕。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">public void bubbleSort(int[] nums) &#123;</span><br><span class="line">    for (int i = 0; i &lt; nums.length - 1; i++) &#123;</span><br><span class="line">        for (int index = 0; index &lt; nums.length - 1 - i; index++) &#123;</span><br><span class="line">            if (nums[index] &gt; nums[index + 1]) </span><br><span class="line">                swap(nums, index, index + 1)</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>当序列已经有序时仍会进行不必要的比较，可以设置一个标志记录是否有元素交换，如果没有直接结束比较。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line">public void betterBubbleSort(int[] nums) &#123;</span><br><span class="line">    boolean swap;</span><br><span class="line">    for (int i = 0; i &lt; nums.length - 1; i++) &#123;</span><br><span class="line">        swap = true;</span><br><span class="line">        for (int index = 0; index &lt; nums.length - 1 - i; index++) &#123;</span><br><span class="line">            if (nums[index] &gt; nums[index + 1]) &#123;</span><br><span class="line">                swap(nums, index ,index + 1);</span><br><span class="line">                swap = false;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        if (swap) break;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="Q7：快速排序的原理？"><a href="#Q7：快速排序的原理？" class="headerlink" title="Q7：快速排序的原理？"></a>Q7：快速排序的原理？</h4><p>是对冒泡排序的一种改进，不稳定，平均/最好时间复杂度 O(nlogn)，元素基本有序时最坏时间复杂度 O(n²)，空间复杂度 O(logn)。</p><p>首先选择一个基准元素，通过一趟排序将要排序的数据分割成独立的两部分，一部分全部小于等于基准元素，一部分全部大于等于基准元素，再按此方法递归对这两部分数据进行快速排序。</p><p>快速排序的一次划分从两头交替搜索，直到 low 和 high 指针重合，一趟时间复杂度 O(n)，整个算法的时间复杂度与划分趟数有关。</p><p>最好情况是每次划分选择的中间数恰好将当前序列等分，经过 log(n) 趟划分便可得到长度为 1 的子表，这样时间复杂度 O(nlogn)。</p><p>最坏情况是每次所选中间数是当前序列中的最大或最小元素，这使每次划分所得子表其中一个为空表 ，这样长度为 n 的数据表需要 n 趟划分，整个排序时间复杂度 O(n²)。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line">public void quickSort(int[] nums, int start, int end) &#123;</span><br><span class="line">    if (start &lt; end) &#123;</span><br><span class="line">        int pivotIndex = getPivotIndex(nums, start, end);</span><br><span class="line">        quickSort(nums, start, pivotIndex - 1);</span><br><span class="line">        quickSort(nums, pivotIndex + 1, end);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">public int getPivotIndex(int[] nums, int start, int end) &#123;</span><br><span class="line">    int pivot = nums[start];</span><br><span class="line">    int low = start;</span><br><span class="line">    int high = end;</span><br><span class="line">    while (low &lt; high) &#123;</span><br><span class="line">        while (low &lt;= high &amp;&amp; nums[low] &lt;= pivot) </span><br><span class="line">            low++;</span><br><span class="line">        while (low &lt;= high &amp;&amp; nums[high] &gt; pivot) </span><br><span class="line">            high--;</span><br><span class="line">        if (low &lt; high) </span><br><span class="line">            swap(nums, low, high);</span><br><span class="line">    &#125;</span><br><span class="line">    swap(nums, start, high);</span><br><span class="line">    return high;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>优化：</strong>当规模足够小时，例如 <code>end - start &lt; 10</code> 时，采用直接插入排序。</p><hr><h4 id="Q8：归并排序的原理？"><a href="#Q8：归并排序的原理？" class="headerlink" title="Q8：归并排序的原理？"></a>Q8：归并排序的原理？</h4><p>归并排序基于归并操作，是一种稳定的排序算法，任何情况时间复杂度都为 O(nlogn)，空间复杂度为 O(n)。</p><p><strong>基本原理：</strong>应用分治法将待排序序列分成两部分，然后对两部分分别递归排序，最后进行合并，使用一个辅助空间并设定两个指针分别指向两个有序序列的起始元素，将指针对应的较小元素添加到辅助空间，重复该步骤到某一序列到达末尾，然后将另一序列剩余元素合并到辅助空间末尾。</p><p><strong>适用场景：</strong>数据量大且对稳定性有要求的情况。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br></pre></td><td class="code"><pre><span class="line">int[] help;</span><br><span class="line"></span><br><span class="line">public void mergeSort(int[] arr) &#123;</span><br><span class="line">    int[] help = new int[arr.length];</span><br><span class="line">    sort(arr, 0, arr.length - 1);</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">public void sort(int[] arr, int start, int end) &#123;</span><br><span class="line">    if (start == end) return;</span><br><span class="line">    int mid = start + (end - start) / 2;</span><br><span class="line">    sort(arr, start, mid);</span><br><span class="line">    sort(arr, mid + 1, end);</span><br><span class="line">    merge(arr, start, mid, end);</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">public void merge(int[] arr, int start, int mid, int end) &#123;</span><br><span class="line">    if (end + 1 - start &gt;= 0) System.arraycopy(arr, start, help, start, end + 1 - start);</span><br><span class="line">    int p = start;</span><br><span class="line">    int q = mid + 1;</span><br><span class="line">    int index = start;</span><br><span class="line">    while (p &lt;= mid &amp;&amp; q &lt;= end) &#123;</span><br><span class="line">        if (help[p] &lt; help[q]) </span><br><span class="line">            arr[index++] = help[p++];</span><br><span class="line">        else </span><br><span class="line">            arr[index++] = help[q++];</span><br><span class="line">    &#125;</span><br><span class="line">    while (p &lt;= mid) arr[index++] = help[p++];</span><br><span class="line">    while (q &lt;= end) arr[index++] = help[q++];</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="Q9：排序算法怎么选择？"><a href="#Q9：排序算法怎么选择？" class="headerlink" title="Q9：排序算法怎么选择？"></a>Q9：排序算法怎么选择？</h4><p>数据量规模较小，考虑直接插入或直接选择。当元素分布有序时直接插入将大大减少比较和移动记录的次数，如果不要求稳定性，可以使用直接选择，效率略高于直接插入。</p><p>数据量规模中等，选择希尔排序。</p><p>数据量规模较大，考虑堆排序（元素分布接近正序或逆序）、快速排序（元素分布随机）和归并排序（稳定性）。</p><p>一般不使用冒泡。</p><hr><h2 id="设计模式-15"><a href="#设计模式-15" class="headerlink" title="设计模式 15"></a>设计模式 15</h2><h4 id="Q1：设计模式有哪些原则？"><a href="#Q1：设计模式有哪些原则？" class="headerlink" title="Q1：设计模式有哪些原则？"></a>Q1：设计模式有哪些原则？</h4><p><strong>开闭原则：</strong>OOP 中最基础的原则，指一个软件实体（类、模块、方法等）应该对扩展开放，对修改关闭。强调用抽象构建框架，用实现扩展细节，提高代码的可复用性和可维护性。</p><p><strong>单一职责原则：</strong>一个类、接口或方法只负责一个职责，降低代码复杂度以及变更引起的风险。</p><p><strong>依赖倒置原则：</strong>程序应该依赖于抽象类或接口，而不是具体的实现类。</p><p><strong>接口隔离原则：</strong>将不同功能定义在不同接口中实现接口隔离，避免了类依赖它不需要的接口，减少了接口之间依赖的冗余性和复杂性。</p><p><strong>里氏替换原则：</strong>开闭原则的补充，规定了任何父类可以出现的地方子类都一定可以出现，可以约束继承泛滥，加强程序健壮性。</p><p><strong>迪米特原则：</strong>也叫最少知道原则，每个模块对其他模块都要尽可能少地了解和依赖，降低代码耦合度。</p><p><strong>合成/聚合原则：</strong>尽量使用组合(has-a)/聚合(contains-a)而不是继承(is-a)达到软件复用的目的，避免滥用继承带来的方法污染和方法爆炸，方法污染指父类的行为通过继承传递给子类，但子类并不具备执行此行为的能力；方法爆炸指继承树不断扩大，底层类拥有的方法过于繁杂，导致很容易选择错误。</p><hr><h4 id="Q2：设计模式的分类，你知道哪些设计模式？"><a href="#Q2：设计模式的分类，你知道哪些设计模式？" class="headerlink" title="Q2：设计模式的分类，你知道哪些设计模式？"></a>Q2：设计模式的分类，你知道哪些设计模式？</h4><p><strong>创建型：</strong> 在创建对象的同时隐藏创建逻辑，不使用 new 直接实例化对象，程序在判断需要创建哪些对象时更灵活。包括工厂/抽象工厂/单例/建造者/原型模式。</p><p>*<em>结构型： *</em>通过类和接口间的继承和引用实现创建复杂结构的对象。包括适配器/桥接模式/过滤器/组合/装饰器/外观/享元/代理模式。</p><p>*<em>行为型： *</em>通过类之间不同通信方式实现不同行为。包括责任链/命名/解释器/迭代器/中介者/备忘录/观察者/状态/策略/模板/访问者模式。</p><hr><h4 id="Q3：说一说简单工厂模式"><a href="#Q3：说一说简单工厂模式" class="headerlink" title="Q3：说一说简单工厂模式"></a>Q3：说一说简单工厂模式</h4><p>简单工厂模式指由一个工厂对象来创建实例，客户端不需要关注创建逻辑，只需提供传入工厂的参数。</p><p>适用于工厂类负责创建对象较少的情况，缺点是如果要增加新产品，就需要修改工厂类的判断逻辑，违背开闭原则，且产品多的话会使工厂类比较复杂。</p><p>Calendar 抽象类的 <code>getInstance</code> 方法，调用 <code>createCalendar</code> 方法根据不同的地区参数创建不同的日历对象。</p><p>Spring 中的 BeanFactory 使用简单工厂模式，根据传入一个唯一的标识来获得 Bean 对象。</p><hr><h4 id="Q4：说一说工厂方法模式"><a href="#Q4：说一说工厂方法模式" class="headerlink" title="Q4：说一说工厂方法模式"></a>Q4：说一说工厂方法模式</h4><p>工厂方法模式指定义一个创建对象的接口，让接口的实现类决定创建哪种对象，让类的实例化推迟到子类中进行。</p><p>客户端只需关心对应工厂而无需关心创建细节，主要解决了产品扩展的问题，在简单工厂模式中如果产品种类变多，工厂的职责会越来越多，不便于维护。</p><p>Collection 接口这个抽象工厂中定义了一个抽象的 <code>iterator</code> 工厂方法，返回一个 Iterator 类的抽象产品。该方法通过 ArrayList 、HashMap 等具体工厂实现，返回 Itr、KeyIterator 等具体产品。</p><p>Spring 的 FactoryBean 接口的 <code>getObject</code> 方法也是工厂方法。</p><hr><h4 id="Q5：抽象工厂模式了解吗？"><a href="#Q5：抽象工厂模式了解吗？" class="headerlink" title="Q5：抽象工厂模式了解吗？"></a>Q5：抽象工厂模式了解吗？</h4><p>抽象工厂模式指提供一个创建一系列相关或相互依赖对象的接口，无需指定它们的具体类。</p><p>客户端不依赖于产品类实例如何被创建和实现的细节，主要用于系统的产品有多于一个的产品族，而系统只消费其中某一个产品族产品的情况。抽象工厂模式的缺点是不方便扩展产品族，并且增加了系统的抽象性和理解难度。</p><p>java.sql.Connection 接口就是一个抽象工厂，其中包括很多抽象产品如 Statement、Blob、Savepoint 等。</p><hr><h4 id="Q6：单例模式的特点是什么？"><a href="#Q6：单例模式的特点是什么？" class="headerlink" title="Q6：单例模式的特点是什么？"></a>Q6：单例模式的特点是什么？</h4><p>单例模式属于创建型模式，一个单例类在任何情况下都只存在一个实例，构造方法必须是私有的、由自己创建一个静态变量存储实例，对外提供一个静态公有方法获取实例。</p><p>优点是内存中只有一个实例，减少了开销，尤其是频繁创建和销毁实例的情况下并且可以避免对资源的多重占用。缺点是没有抽象层，难以扩展，与单一职责原则冲突。</p><p>Spring 的 ApplicationContext 创建的 Bean 实例都是单例对象，还有 ServletContext、数据库连接池等也都是单例模式。</p><hr><h4 id="Q7：单例模式有哪些实现？"><a href="#Q7：单例模式有哪些实现？" class="headerlink" title="Q7：单例模式有哪些实现？"></a>Q7：单例模式有哪些实现？</h4><p><strong>饿汉式：</strong>在类加载时就初始化创建单例对象，线程安全，但不管是否使用都创建对象可能会浪费内存。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">public class HungrySingleton &#123;</span><br><span class="line">    private HungrySingleton()&#123;&#125;</span><br><span class="line"></span><br><span class="line">    private static HungrySingleton instance = new HungrySingleton();</span><br><span class="line"></span><br><span class="line">    public static HungrySingleton getInstance() &#123;</span><br><span class="line">        return instance;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>懒汉式：</strong>在外部调用时才会加载，线程不安全，可以加锁保证线程安全但效率低。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line">public class LazySingleton &#123;</span><br><span class="line">    private LazySingleton()&#123;&#125;</span><br><span class="line"></span><br><span class="line">    private static LazySingleton instance;</span><br><span class="line"></span><br><span class="line">    public static LazySingleton getInstance() &#123;</span><br><span class="line">        if(instance == null) &#123;</span><br><span class="line">            instance = new LazySingleton();</span><br><span class="line">        &#125;</span><br><span class="line">        return instance;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>双重检查锁：</strong>使用 volatile 以及多重检查来减小锁范围，提升效率。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line">public class DoubleCheckSingleton &#123;</span><br><span class="line">    private DoubleCheckSingleton()&#123;&#125;</span><br><span class="line"></span><br><span class="line">    private volatile static DoubleCheckSingleton instance;</span><br><span class="line"></span><br><span class="line">    public static DoubleCheckSingleton getInstance() &#123;</span><br><span class="line">        if(instance == null) &#123;</span><br><span class="line">            synchronized (DoubleCheckSingleton.class) &#123;</span><br><span class="line">                if (instance == null) &#123;</span><br><span class="line">                    instance = new DoubleCheckSingleton();</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        return instance;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>静态内部类：</strong>同时解决饿汉式的内存浪费问题和懒汉式的线程安全问题。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line">public class StaticSingleton &#123;</span><br><span class="line">    private StaticSingleton()&#123;&#125;</span><br><span class="line"></span><br><span class="line">    public static StaticSingleton getInstance() &#123;</span><br><span class="line">        return StaticClass.instance;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    private static class StaticClass &#123;</span><br><span class="line">        private static final StaticSingleton instance = new StaticSingleton();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>枚举：</strong>《Effective Java》提倡的方式，不仅能避免线程安全问题，还能防止反序列化重新创建新的对象，绝对防止多次实例化，也能防止反射破解单例的问题。</p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">public enum EnumSingleton &#123;</span><br><span class="line">    INSTANCE;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="Q8：讲一讲代理模式"><a href="#Q8：讲一讲代理模式" class="headerlink" title="Q8：讲一讲代理模式"></a>Q8：讲一讲代理模式</h4><p>代理模式属于结构型模式，为其他对象提供一种代理以控制对这个对象的访问。优点是可以增强目标对象的功能，降低代码耦合度，扩展性好。缺点是在客户端和目标对象之间增加代理对象会导致请求处理速度变慢，增加系统复杂度。</p><p>Spring 利用动态代理实现 AOP，如果 Bean 实现了接口就使用 JDK 代理，否则使用 CGLib 代理。</p><p><strong>静态代理：</strong>代理对象持有被代理对象的引用，调用代理对象方法时也会调用被代理对象的方法，但是会在被代理对象方法的前后增加其他逻辑。需要手动完成，在程序运行前就已经存在代理类的字节码文件，代理类和被代理类的关系在运行前就已经确定了。 缺点是一个代理类只能为一个目标服务，如果要服务多种类型会增加工作量。</p><p><strong>动态代理：</strong>动态代理在程序运行时通过反射创建具体的代理类，代理类和被代理类的关系在运行前是不确定的。动态代理的适用性更强，主要分为 JDK 动态代理和 CGLib 动态代理。</p><ul><li><strong>JDK 动态代理：</strong>通过 <code>Proxy</code> 类的 <code>newInstance</code> 方法获取一个动态代理对象，需要传入三个参数，被代理对象的类加载器、被代理对象实现的接口，以及一个 <code>InvocationHandler</code> 调用处理器来指明具体的逻辑，相比静态代理的优势是接口中声明的所有方法都被转移到 <code>InvocationHandler</code> 的 <code>invoke</code> 方法集中处理。 </li><li><strong>CGLib 动态代理：</strong>JDK 动态代理要求实现被代理对象的接口，而 CGLib 要求继承被代理对象，如果一个类是 final 类则不能使用 CGLib 代理。两种代理都在运行期生成字节码，JDK 动态代理直接写字节码，而 CGLib 动态代理使用 ASM 框架写字节码，ASM 的目的是生成、转换和分析以字节数组表示的已编译 Java 类。 JDK 动态代理调用代理方法通过反射机制实现，而 GCLib 动态代理通过 FastClass 机制直接调用方法，它为代理类和被代理类各生成一个类，该类为代理类和被代理类的方法分配一个 int 参数，调用方法时可以直接定位，因此调用效率更高。 </li></ul><hr><h4 id="Q9：讲一讲装饰器模式"><a href="#Q9：讲一讲装饰器模式" class="headerlink" title="Q9：讲一讲装饰器模式"></a>Q9：讲一讲装饰器模式</h4><p>装饰器模式属于结构型模式，在不改变原有对象的基础上将功能附加到对象，相比继承可以更加灵活地扩展原有对象的功能。</p><p>装饰器模式适合的场景：在不想增加很多子类的前提下扩展一个类的功能。</p><p>java.io 包中，InputStream 字节输入流通过装饰器 BufferedInputStream 增强为缓冲字节输入流。</p><hr><h4 id="Q10：装饰器模式和动态代理的区别？"><a href="#Q10：装饰器模式和动态代理的区别？" class="headerlink" title="Q10：装饰器模式和动态代理的区别？"></a>Q10：装饰器模式和动态代理的区别？</h4><p>装饰器模式的关注点在于给对象动态添加方法，而动态代理更注重对象的访问控制。动态代理通常会在代理类中创建被代理对象的实例，而装饰器模式会将装饰者作为构造方法的参数。</p><hr><h4 id="Q11：讲一讲适配器模式"><a href="#Q11：讲一讲适配器模式" class="headerlink" title="Q11：讲一讲适配器模式"></a>Q11：讲一讲适配器模式</h4><p>适配器模式属于结构型模式，它作为两个不兼容接口之间的桥梁，结合了两个独立接口的功能，将一个类的接口转换成另外一个接口使得原本由于接口不兼容而不能一起工作的类可以一起工作。 </p><p>缺点是过多使用适配器会让系统非常混乱，不易整体把握。</p><p>java.io 包中，InputStream 字节输入流通过适配器 InputStreamReader 转换为 Reader 字符输入流。</p><p>Spring MVC 中的 HandlerAdapter，由于 handler 有很多种形式，包括 Controller、HttpRequestHandler、Servlet 等，但调用方式又是确定的，因此需要适配器来进行处理，根据适配规则调用 handle 方法。</p><p>Arrays.asList 方法，将数组转换为对应的集合（注意不能使用修改集合的方法，因为返回的 ArrayList 是 Arrays 的一个内部类）。</p><hr><h4 id="Q12：适配器模式和和装饰器模式以及代理模式的区别？"><a href="#Q12：适配器模式和和装饰器模式以及代理模式的区别？" class="headerlink" title="Q12：适配器模式和和装饰器模式以及代理模式的区别？"></a>Q12：适配器模式和和装饰器模式以及代理模式的区别？</h4><p>适配器模式没有层级关系，适配器和被适配者没有必然连续，满足 has-a 的关系，解决不兼容的问题，是一种后置考虑。</p><p>装饰器模式具有层级关系，装饰器与被装饰者实现同一个接口，满足 is-a 的关系，注重覆盖和扩展，是一种前置考虑。</p><p>适配器模式主要改变所考虑对象的接口，而代理模式不能改变所代理类的接口。</p><hr><h4 id="Q13：讲一讲策略模式"><a href="#Q13：讲一讲策略模式" class="headerlink" title="Q13：讲一讲策略模式"></a>Q13：讲一讲策略模式</h4><p>策略模式属于行为型模式，定义了一系列算法并封装起来，之间可以互相替换。策略模式主要解决在有多种算法相似的情况下，使用 if/else 所带来的难以维护。</p><p>优点是算法可以自由切换，可以避免使用多重条件判断并且扩展性良好，缺点是策略类会增多并且所有策略类都需要对外暴露。</p><p>在集合框架中，经常需要通过构造方法传入一个比较器 Comparator 进行比较排序。Comparator 就是一个抽象策略，一个类通过实现该接口并重写 compare 方法成为具体策略类。</p><p>创建线程池时，需要传入拒绝策略，当创建新线程使当前运行的线程数超过 maximumPoolSize 时会使用相应的拒绝策略处理。</p><hr><h4 id="Q14：讲一讲模板模式"><a href="#Q14：讲一讲模板模式" class="headerlink" title="Q14：讲一讲模板模式"></a>Q14：讲一讲模板模式</h4><p>模板模式属于行为型模式，使子类可以在不改变算法结构的情况下重新定义算法的某些步骤，适用于抽取子类重复代码到公共父类。</p><p>优点是可以封装固定不变的部分，扩展可变的部分。缺点是每一个不同实现都需要一个子类维护，会增加类的数量。</p><p>为防止恶意操作，一般模板方法都以 final 修饰。</p><p>HttpServlet 定义了一套处理 HTTP 请求的模板，service 方法为模板方法，定义了处理HTTP请求的基本流程，doXXX 等方法为基本方法，根据请求方法的类型做相应的处理，子类可重写这些方法。</p><hr><h4 id="Q15：讲一讲观察者模式"><a href="#Q15：讲一讲观察者模式" class="headerlink" title="Q15：讲一讲观察者模式"></a>Q15：讲一讲观察者模式</h4><p>观察者模式属于行为型模式，也叫发布订阅模式，定义对象间的一种一对多的依赖关系，当一个对象的状态发生改变时，所有依赖于它的对象都得到通知并被自动更新。主要解决一个对象状态改变给其他对象通知的问题，缺点是如果被观察者对象有很多的直接和间接观察者的话通知很耗时， 如果存在循环依赖的话可能导致系统崩溃，另外观察者无法知道目标对象具体是怎么发生变化的。</p><p>ServletContextListener 能够监听 ServletContext 对象的生命周期，实际上就是监听 Web 应用。当 Servlet 容器启动 Web 应用时调用 <code>contextInitialized</code> 方法，终止时调用 <code>contextDestroyed</code> 方法。</p><hr><h2 id="MySQL-33"><a href="#MySQL-33" class="headerlink" title="MySQL 33"></a>MySQL 33</h2><h3 id="逻辑架构-13"><a href="#逻辑架构-13" class="headerlink" title="逻辑架构 13"></a>逻辑架构 13</h3><h4 id="Q1：MySQL-的逻辑架构了解吗？"><a href="#Q1：MySQL-的逻辑架构了解吗？" class="headerlink" title="Q1：MySQL 的逻辑架构了解吗？"></a>Q1：MySQL 的逻辑架构了解吗？</h4><p>第一层是服务器层，主要提供连接处理、授权认证、安全等功能。</p><p>第二层实现了 MySQL 核心服务功能，包括查询解析、分析、优化、缓存以及日期和时间等所有内置函数，所有跨存储引擎的功能都在这一层实现，例如存储过程、触发器、视图等。</p><p>第三层是存储引擎层，存储引擎负责 MySQL 中数据的存储和提取。服务器通过 API 与存储引擎通信，这些接口屏蔽了不同存储引擎的差异，使得差异对上层查询过程透明。除了会解析外键定义的 InnoDB 外，存储引擎不会解析 SQL，不同存储引擎之间也不会相互通信，只是简单响应上层服务器请求。</p><hr><h4 id="Q2：谈一谈-MySQL-的读写锁"><a href="#Q2：谈一谈-MySQL-的读写锁" class="headerlink" title="Q2：谈一谈 MySQL 的读写锁"></a>Q2：谈一谈 MySQL 的读写锁</h4><p>在处理并发读或写时，可以通过实现一个由两种类型组成的锁系统来解决问题。这两种类型的锁通常被称为共享锁和排它锁，也叫读锁和写锁。读锁是共享的，相互不阻塞，多个客户在同一时刻可以同时读取同一个资源而不相互干扰。写锁则是排他的，也就是说一个写锁会阻塞其他的写锁和读锁，确保在给定时间内只有一个用户能执行写入并防止其他用户读取正在写入的同一资源。</p><p>在实际的数据库系统中，每时每刻都在发生锁定，当某个用户在修改某一部分数据时，MySQL 会通过锁定防止其他用户读取同一数据。写锁比读锁有更高的优先级，一个写锁请求可能会被插入到读锁队列的前面，但是读锁不能插入到写锁前面。</p><hr><h4 id="Q3：MySQL-的锁策略有什么？"><a href="#Q3：MySQL-的锁策略有什么？" class="headerlink" title="Q3：MySQL 的锁策略有什么？"></a>Q3：MySQL 的锁策略有什么？</h4><p><strong>表锁</strong>是MySQL中最基本的锁策略，并且是开销最小的策略。表锁会锁定整张表，一个用户在对表进行写操作前需要先获得写锁，这会阻塞其他用户对该表的所有读写操作。只有没有写锁时，其他读取的用户才能获取读锁，读锁之间不相互阻塞。</p><p><strong>行锁</strong>可以最大程度地支持并发，同时也带来了最大开销。InnoDB 和 XtraDB 以及一些其他存储引擎实现了行锁。行锁只在存储引擎层实现，而服务器层没有实现。</p><hr><h4 id="Q4：数据库死锁如何解决？"><a href="#Q4：数据库死锁如何解决？" class="headerlink" title="Q4：数据库死锁如何解决？"></a>Q4：数据库死锁如何解决？</h4><p>死锁是指多个事务在同一资源上相互占用并请求锁定对方占用的资源而导致恶性循环的现象。当多个事务试图以不同顺序锁定资源时就可能会产生死锁，多个事务同时锁定同一个资源时也会产生死锁。</p><p>为了解决死锁问题，数据库系统实现了各种死锁检测和死锁超时机制。越复杂的系统，例如InnoDB 存储引擎，越能检测到死锁的循环依赖，并立即返回一个错误。这种解决方式很有效，否则死锁会导致出现非常慢的查询。还有一种解决方法，就是当查询的时间达到锁等待超时的设定后放弃锁请求，这种方式通常来说不太好。InnoDB 目前处理死锁的方法是将持有最少行级排它锁的事务进行回滚。</p><p>死锁发生之后，只有部分或者完全回滚其中一个事务，才能打破死锁。对于事务型系统这是无法避免的，所以应用程序在设计时必须考虑如何处理死锁。大多数情况下只需要重新执行因死锁回滚的事务即可。</p><hr><h4 id="Q5：事务是什么"><a href="#Q5：事务是什么" class="headerlink" title="Q5：事务是什么?"></a>Q5：事务是什么?</h4><p>事务是一组原子性的 SQL 查询，或者说一个独立的工作单元。如果数据库引擎能够成功地对数据库应用该组查询的全部语句，那么就执行该组查询。如果其中有任何一条语句因为崩溃或其他原因无法执行，那么所有的语句都不会执行。也就是说事务内的语句要么全部执行成功，要么全部执行失败。</p><hr><h4 id="Q6：事务有什么特性？"><a href="#Q6：事务有什么特性？" class="headerlink" title="Q6：事务有什么特性？"></a>Q6：事务有什么特性？</h4><p><strong>原子性 atomicity</strong></p><p>一个事务在逻辑上是必须不可分割的最小工作单元，整个事务中的所有操作要么全部提交成功，要么全部失败回滚，对于一个事务来说不可能只执行其中的一部分。</p><p><strong>一致性 consistency</strong></p><p>数据库总是从一个一致性的状态转换到另一个一致性的状态。</p><p><strong>隔离性 isolation</strong></p><p>针对并发事务而言，隔离性就是要隔离并发运行的多个事务之间的相互影响，一般来说一个事务所做的修改在最终提交以前，对其他事务是不可见的。</p><p><strong>持久性 durability</strong></p><p>一旦事务提交成功，其修改就会永久保存到数据库中，此时即使系统崩溃，修改的数据也不会丢失。</p><hr><h4 id="Q7：MySQL-的隔离级别有哪些？"><a href="#Q7：MySQL-的隔离级别有哪些？" class="headerlink" title="Q7：MySQL 的隔离级别有哪些？"></a>Q7：MySQL 的隔离级别有哪些？</h4><p><strong>未提交读 READ UNCOMMITTED</strong></p><p>在该级别事务中的修改即使没有被提交，对其他事务也是可见的。事务可以读取其他事务修改完但未提交的数据，这种问题称为脏读。这个级别还会导致不可重复读和幻读，性能没有比其他级别好很多，很少使用。</p><p><strong>提交读 READ COMMITTED</strong></p><p>多数数据库系统默认的隔离级别。提交读满足了隔离性的简单定义：一个事务开始时只能”看见”已经提交的事务所做的修改。换句话说，一个事务从开始直到提交之前的任何修改对其他事务都是不可见的。也叫不可重复读，因为两次执行同样的查询可能会得到不同结果。</p><p><strong>可重复读 REPEATABLE READ</strong>（MySQL默认的隔离级别）</p><p>可重复读解决了不可重复读的问题，保证了在同一个事务中多次读取同样的记录结果一致。但还是无法解决幻读，所谓幻读指的是当某个事务在读取某个范围内的记录时，会产生幻行。InnoDB 存储引擎通过多版本并发控制MVCC 解决幻读的问题。</p><p><strong>可串行化 SERIALIZABLE</strong></p><p>最高的隔离级别，通过强制事务串行执行，避免幻读。可串行化会在读取的每一行数据上都加锁，可能导致大量的超时和锁争用的问题。实际应用中很少用到这个隔离级别，只有非常需要确保数据一致性且可以接受没有并发的情况下才考虑该级别。</p><hr><h4 id="Q8：MVCC-是什么？"><a href="#Q8：MVCC-是什么？" class="headerlink" title="Q8：MVCC 是什么？"></a>Q8：MVCC 是什么？</h4><p>MVCC 是多版本并发控制，在很多情况下避免加锁，大都实现了非阻塞的读操作，写操作也只锁定必要的行。</p><p>InnoDB 的MVCC 通过在每行记录后面保存两个隐藏的列来实现，这两个列一个保存了行的创建时间，一个保存行的过期时间间。不过存储的不是实际的时间值而是系统版本号，每开始一个新的事务系统版本号都会自动递增，事务开始时刻的系统版本号会作为事务的版本号，用来和查询到的每行记录的版本号进行比较。</p><p>MVCC 只能在 <code>READ COMMITTED</code> 和 <code>REPEATABLE READ</code> 两个隔离级别下工作，因为 <code>READ UNCOMMITTED</code> 总是读取最新的数据行，而不是符合当前事务版本的数据行，而 <code>SERIALIZABLE</code> 则会对所有读取的行都加锁。</p><hr><h4 id="Q9：谈一谈-InnoDB"><a href="#Q9：谈一谈-InnoDB" class="headerlink" title="Q9：谈一谈 InnoDB"></a>Q9：谈一谈 InnoDB</h4><p>InnoDB 是 MySQL 的默认事务型引擎，用来处理大量短期事务。InnoDB 的性能和自动崩溃恢复特性使得它在非事务型存储需求中也很流行，除非有特别原因否则应该优先考虑 InnoDB。</p><p>InnoDB 的数据存储在表空间中，表空间由一系列数据文件组成。MySQL4.1 后 InnoDB 可以将每个表的数据和索引放在单独的文件中。</p><p>InnoDB 采用 MVCC 来支持高并发，并且实现了四个标准的隔离级别。其默认级别是 <code>REPEATABLE READ</code>，并通过间隙锁策略防止幻读，间隙锁使 InnoDB 不仅仅锁定查询涉及的行，还会对索引中的间隙进行锁定防止幻行的插入。</p><p>InnoDB 表是基于聚簇索引建立的，InnoDB 的索引结构和其他存储引擎有很大不同，聚簇索引对主键查询有很高的性能，不过它的二级索引中必须包含主键列，所以如果主键很大的话其他所有索引都会很大，因此如果表上索引较多的话主键应当尽可能小。</p><p>InnoDB 的存储格式是平***立的，可以将数据和索引文件从一个平台复制到另一个平台。</p><p>InnoDB 内部做了很多优化，包括从磁盘读取数据时采用的可预测性预读，能够自动在内存中创建加速读操作的自适应哈希索引，以及能够加速插入操作的插入缓冲区等。</p><hr><h4 id="Q10：谈一谈-MyISAM"><a href="#Q10：谈一谈-MyISAM" class="headerlink" title="Q10：谈一谈 MyISAM"></a>Q10：谈一谈 MyISAM</h4><p>MySQL5.1及之前，MyISAM 是默认存储引擎，MyISAM 提供了大量的特性，包括全文索引、压缩、空间函数等，但不支持事务和行锁，最大的缺陷就是崩溃后无法安全恢复。对于只读的数据或者表比较小、可以忍受修复操作的情况仍然可以使用 MyISAM。</p><p>MyISAM 将表存储在数据文件和索引文件中，分别以 <code>.MYD</code> 和 <code>.MYI</code> 作为扩展名。MyISAM 表可以包含动态或者静态行，MySQL 会根据表的定义决定行格式。MyISAM 表可以存储的行记录数一般受限于可用磁盘空间或者操作系统中单个文件的最大尺寸。</p><p>MyISAM 对整张表进行加锁，读取时会对需要读到的所有表加共享锁，写入时则对表加排它锁。但是在表有读取查询的同时，也支持并发往表中插入新的记录。</p><p>对于MyISAM 表，MySQL 可以手动或自动执行检查和修复操作，这里的修复和事务恢复以及崩溃恢复的概念不同。执行表的修复可能导致一些数据丢失，而且修复操作很慢。</p><p>对于 MyISAM 表，即使是 BLOB 和 TEXT 等长字段，也可以基于其前 500 个字符创建索引。MyISAM 也支持全文索引，这是一种基于分词创建的索引，可以支持复杂的查询。</p><p>MyISAM 设计简单，数据以紧密格式存储，所以在某些场景下性能很好。MyISAM 最典型的性能问题还是表锁问题，如果所有的查询长期处于 Locked 状态，那么原因毫无疑问就是表锁。</p><hr><h4 id="Q12：谈一谈-Memory"><a href="#Q12：谈一谈-Memory" class="headerlink" title="Q12：谈一谈 Memory"></a>Q12：谈一谈 Memory</h4><p>如果需要快速访问数据且这些数据不会被修改，重启以后丢失也没有关系，那么使用 Memory 表是非常有用的。Memory 表至少要比 MyISAM 表快一个数量级，因为所有数据都保存在内存，不需要磁盘 IO，Memory 表的结构在重启后会保留，但数据会丢失。</p><p>Memory 表适合的场景：查找或者映射表、缓存周期性聚合数据的结果、保存数据分析中产生的中间数据。</p><p>Memory 表支持哈希索引，因此查找速度极快。虽然速度很快但还是无法取代传统的基于磁盘的表，Memory 表使用表级锁，因此并发写入的性能较低。它不支持 BLOB 和 TEXT 类型的列，并且每行的长度是固定的，所以即使指定了 VARCHAR 列，实际存储时也会转换成CHAR，这可能导致部分内存的浪费。</p><p>如果 MySQL 在执行查询的过程中需要使用临时表来保持中间结果，内部使用的临时表就是 Memory 表。如果中间结果太大超出了Memory 表的限制，或者含有 BLOB 或 TEXT 字段，临时表会转换成 MyISAM 表。</p><hr><h4 id="Q13：查询执行流程是什么？"><a href="#Q13：查询执行流程是什么？" class="headerlink" title="Q13：查询执行流程是什么？"></a>Q13：查询执行流程是什么？</h4><p>简单来说分为五步：① 客户端发送一条查询给服务器。② 服务器先检查查询缓存，如果命中了缓存则立刻返回存储在缓存中的结果，否则进入下一阶段。③ 服务器端进行 SQL 解析、预处理，再由优化器生成对应的执行计划。④ MySQL 根据优化器生成的执行计划，调用存储引擎的 API 来执行查询。⑤ 将结果返回给客户端。 </p><hr><h3 id="数据类型-3"><a href="#数据类型-3" class="headerlink" title="数据类型 3"></a>数据类型 3</h3><h4 id="Q1：VARCHAR-和-CHAR-的区别？"><a href="#Q1：VARCHAR-和-CHAR-的区别？" class="headerlink" title="Q1：VARCHAR 和 CHAR 的区别？"></a>Q1：VARCHAR 和 CHAR 的区别？</h4><p><strong>VARCHAR</strong> 用于存储可变字符串，是最常见的字符串数据类型。它比 CHAR 更节省空间，因为它仅使用必要的空间。VARCHAR 需要 1 或 2 个额外字节记录字符串长度，如果列的最大长度不大于 255 字节则只需要 1 字节。VARCHAR 不会删除末尾空格。</p><p>VARCHAR 适用场景：字符串列的最大长度比平均长度大很多、列的更新很少、使用了 UTF8 这种复杂字符集，每个字符都使用不同的字节数存储。</p><p><strong>CHAR</strong> 是定长的，根据定义的字符串长度分配足够的空间。CHAR 会删除末尾空格。</p><p>CHAR 适合存储很短的字符串，或所有值都接近同一个长度，例如存储密码的 MD5 值。对于经常变更的数据，CHAR 也比 VARCHAR更好，因为定长的 CHAR 不容易产生碎片。对于非常短的列，CHAR 在存储空间上也更有效率，例如用 CHAR 来存储只有 Y 和 N 的值只需要一个字节，但是 VARCHAR 需要两个字节，因为还有一个记录长度的额外字节。</p><hr><h4 id="Q2：DATETIME-和-TIMESTAMP-的区别？"><a href="#Q2：DATETIME-和-TIMESTAMP-的区别？" class="headerlink" title="Q2：DATETIME 和 TIMESTAMP 的区别？"></a>Q2：DATETIME 和 TIMESTAMP 的区别？</h4><p><strong>DATETIME</strong> 能保存大范围的值，从 1001~9999 年，精度为秒。把日期和时间封装到了一个整数中，与时区无关，使用 8 字节存储空间。</p><p><strong>TIMESTAMP</strong> 和 UNIX 时间戳相同，只使用 4 字节的存储空间，范围比 DATETIME 小得多，只能表示 1970 ~2038 年，并且依赖于时区。</p><hr><h4 id="Q3：数据类型有哪些优化策略？"><a href="#Q3：数据类型有哪些优化策略？" class="headerlink" title="Q3：数据类型有哪些优化策略？"></a>Q3：数据类型有哪些优化策略？</h4><p><strong>更小的通常更好</strong></p><p>一般情况下尽量使用可以正确存储数据的最小数据类型，更小的数据类型通常也更快，因为它们占用更少的磁盘、内存和 CPU 缓存。</p><p><strong>尽可能简单</strong></p><p>简单数据类型的操作通常需要更少的 CPU 周期，例如整数比字符操作代价更低，因为字符集和校对规则使字符相比整形更复杂。应该使用 MySQL 的内建类型 date、time 和 datetime 而不是字符串来存储日期和时间，另一点是应该使用整形存储 IP 地址。</p><p><strong>尽量避免 NULL</strong></p><p>通常情况下最好指定列为 NOT NULL，除非需要存储 NULL值。因为如果查询中包含可为 NULL 的列对 MySQL 来说更难优化，可为 NULL 的列使索引、索引统计和值比较都更复杂，并且会使用更多存储空间。当可为 NULL 的列被索引时，每个索引记录需要一个额外字节，在MyISAM 中还可能导致固定大小的索引变成可变大小的索引。</p><p>如果计划在列上建索引，就应该尽量避免设计成可为 NULL 的列。</p><hr><h3 id="索引-10"><a href="#索引-10" class="headerlink" title="索引 10"></a>索引 10</h3><h4 id="Q1：索引有什么作用？"><a href="#Q1：索引有什么作用？" class="headerlink" title="Q1：索引有什么作用？"></a>Q1：索引有什么作用？</h4><p>索引也叫键，是存储引擎用于快速找到记录的一种数据结构。索引对于良好的性能很关键，尤其是当表中数据量越来越大时，索引对性能的影响愈发重要。在数据量较小且负载较低时，不恰当的索引对性能的影响可能还不明显，但数据量逐渐增大时，性能会急剧下降。</p><p>索引大大减少了服务器需要扫描的数据量、可以帮助服务器避免排序和临时表、可以将随机 IO 变成顺序 IO。但索引并不总是最好的工具，对于非常小的表，大部分情况下会采用全表扫描。对于中到大型的表，索引就非常有效。但对于特大型的表，建立和使用索引的代价也随之增长，这种情况下应该使用分区技术。</p><p>在MySQL中，首先在索引中找到对应的值，然后根据匹配的索引记录找到对应的数据行。索引可以包括一个或多个列的值，如果索引包含多个列，那么列的顺序也十分重要，因为 MySQL 只能使用索引的最左前缀。</p><hr><h4 id="Q2：谈一谈-MySQL-的-B-Tree-索引"><a href="#Q2：谈一谈-MySQL-的-B-Tree-索引" class="headerlink" title="Q2：谈一谈 MySQL 的 B-Tree 索引"></a>Q2：谈一谈 MySQL 的 B-Tree 索引</h4><p>大多数 MySQL 引擎都支持这种索引，但底层的存储引擎可能使用不同的存储结构，例如 NDB 使用 T-Tree，而 InnoDB 使用 B+ Tree。</p><p>B-Tree 通常意味着所有的值都是按顺序存储的，并且每个叶子页到根的距离相同。B-Tree 索引能够加快访问数据的速度，因为存储引擎不再需要进行全表扫描来获取需要的数据，取而代之的是从索引的根节点开始进行搜索。根节点的槽中存放了指向子节点的指针，存储引擎根据这些指针向下层查找。通过比较节点页的值和要查找的值可以找到合适的指针进入下层子节点，这些指针实际上定义了子节点页中值的上限和下限。最终存储引擎要么找到对应的值，要么该记录不存在。叶子节点的指针指向的是被索引的数据，而不是其他的节点页。</p><p>B-Tree索引的限制：</p><ul><li>如果不是按照索引的最左列开始查找，则无法使用索引。 </li><li>不能跳过索引中的列，例如索引为 (id,name,sex)，不能只使用 id 和 sex 而跳过 name。 </li><li>如果查询中有某个列的范围查询，则其右边的所有列都无法使用索引。 </li></ul><hr><h4 id="Q3：了解-Hash-索引吗？"><a href="#Q3：了解-Hash-索引吗？" class="headerlink" title="Q3：了解 Hash 索引吗？"></a>Q3：了解 Hash 索引吗？</h4><p>哈希索引基于哈希表实现，只有精确匹配索引所有列的查询才有效。对于每一行数据，存储引擎都会对所有的索引列计算一个哈希码，哈希码是一个较小的值，并且不同键值的行计算出的哈希码也不一样。哈希索引将所有的哈希码存储在索引中，同时在哈希表中保存指向每个数据行的指针。</p><p>只有 Memory 引擎显式支持哈希索引，这也是 Memory 引擎的默认索引类型。</p><p>因为索引自身只需存储对应的哈希值，所以索引的结构十分紧凑，这让哈希索引的速度非常快，但它也有一些限制：</p><ul><li>哈希索引数据不是按照索引值顺序存储的，无法用于排序。 </li><li>哈希索引不支持部分索引列匹配查找，因为哈希索引始终是使用索引列的全部内容来计算哈希值的。例如在数据列(a,b)上建立哈希索引，如果查询的列只有a就无法使用该索引。 </li><li>哈希索引只支持等值比较查询，不支持任何范围查询。 </li></ul><hr><h4 id="Q4：什么是自适应哈希索引？"><a href="#Q4：什么是自适应哈希索引？" class="headerlink" title="Q4：什么是自适应哈希索引？"></a>Q4：什么是自适应哈希索引？</h4><p>自适应哈希索引是 InnoDB 引擎的一个特殊功能，当它注意到某些索引值被使用的非常频繁时，会在内存中基于 B-Tree 索引之上再创键一个哈希索引，这样就让 B-Tree 索引也具有哈希索引的一些优点，比如快速哈希查找。这是一个完全自动的内部行为，用户无法控制或配置，但如果有必要可以关闭该功能。</p><hr><h4 id="Q5-：什么是空间索引？"><a href="#Q5-：什么是空间索引？" class="headerlink" title="Q5 ：什么是空间索引？"></a>Q5 ：什么是空间索引？</h4><p>MyISAM 表支持空间索引，可以用作地理数据存储。和 B-Tree 索引不同，这类索引无需前缀查询。空间索引会从所有维度来索引数据，查询时可以有效地使用任意维度来组合查询。必须使用 MySQL 的 GIS 即地理信息系统的相关函数来维护数据，但 MySQL 对 GIS 的支持并不完善，因此大部分人都不会使用这个特性。</p><hr><h4 id="Q6：什么是全文索引？"><a href="#Q6：什么是全文索引？" class="headerlink" title="Q6：什么是全文索引？"></a>Q6：什么是全文索引？</h4><p>通过数值比较、范围过滤等就可以完成绝大多数需要的查询，但如果希望通过关键字匹配进行查询，就需要基于相似度的查询，而不是精确的数值比较，全文索引就是为这种场景设计的。</p><p>MyISAM 的全文索引是一种特殊的 B-Tree 索引，一共有两层。第一层是所有关键字，然后对于每一个关键字的第二层，包含的是一组相关的”文档指针”。全文索引不会索引文档对象中的所有词语，它会根据规则过滤掉一些词语，例如停用词列表中的词都不会被索引。</p><hr><h4 id="Q7：什么是聚簇索引？"><a href="#Q7：什么是聚簇索引？" class="headerlink" title="Q7：什么是聚簇索引？"></a>Q7：什么是聚簇索引？</h4><p>聚簇索引不是一种索引类型，而是一种数据存储方式。InnoDB 的聚簇索引实际上在同一个结构中保存了 B-Tree 索引和数据行。当表有聚餐索引时，它的行数据实际上存放在索引的叶子页中，因为无法同时把数据行存放在两个不同的地方，所以一个表只能有一个聚簇索引。</p><p>优点：① 可以把相关数据保存在一起。② 数据访问更快，聚簇索引将索引和数据保存在同一个 B-Tree 中，因此获取数据比非聚簇索引要更快。③ 使用覆盖索引扫描的查询可以直接使用页节点中的主键值。</p><p>缺点：① 聚簇索引最大限度提高了 IO 密集型应用的性能，如果数据全部在内存中将会失去优势。② 更新聚簇索引列的代价很高，因为会强制每个被更新的行移动到新位置。③ 基于聚簇索引的表插入新行或主键被更新导致行移动时，可能导致页分裂，表会占用更多磁盘空间。④ 当行稀疏或由于页分裂导致数据存储不连续时，全表扫描可能很慢。</p><hr><h4 id="Q8：什么是覆盖索引？"><a href="#Q8：什么是覆盖索引？" class="headerlink" title="Q8：什么是覆盖索引？"></a>Q8：什么是覆盖索引？</h4><p>覆盖索引指一个索引包含或覆盖了所有需要查询的字段的值，不再需要根据索引回表查询数据。覆盖索引必须要存储索引列的值，因此 MySQL 只能使用 B-Tree 索引做覆盖索引。</p><p>优点：① 索引条目通常远小于数据行大小，可以极大减少数据访问量。② 因为索引按照列值顺序存储，所以对于 IO 密集型防伪查询回避随机从磁盘读取每一行数据的 IO 少得多。③ 由于 InnoDB 使用聚簇索引，覆盖索引对 InnoDB 很有帮助。InnoDB 的二级索引在叶子节点保存了行的主键值，如果二级主键能覆盖查询那么可以避免对主键索引的二次查询。</p><hr><h4 id="Q9：你知道哪些索引使用原则？"><a href="#Q9：你知道哪些索引使用原则？" class="headerlink" title="Q9：你知道哪些索引使用原则？"></a>Q9：你知道哪些索引使用原则？</h4><p><strong>建立索引</strong></p><p>对查询频次较高且数据量比较大的表建立索引。索引字段的选择，最佳候选列应当从 WHERE 子句的条件中提取，如果 WHERE 子句中的组合比较多，应当挑选最常用、过滤效果最好的列的组合。业务上具有唯一特性的字段，即使是多个字段的组合，也必须建成唯一索引。</p><p><strong>使用前缀索引</strong></p><p>索引列开始的部分字符，索引创建后也是使用硬盘来存储的，因此短索引可以提升索引访问的 IO 效率。对于 BLOB、TEXT 或很长的 VARCHAR 列必须使用前缀索引，MySQL 不允许索引这些列的完整长度。前缀索引是一种能使索引更小更快的有效方法，但缺点是 MySQL 无法使用前缀索引做 ORDER BY 和 GROUP BY，也无法使用前缀索引做覆盖扫描。</p><p><strong>选择合适的索引顺序</strong></p><p>当不需要考虑排序和分组时，将选择性最高的列放在前面。索引的选择性是指不重复的索引值和数据表的记录总数之比，索引的选择性越高则查询效率越高，唯一索引的选择性是 1，因此也可以使用唯一索引提升查询效率。</p><p><strong>删除无用索引</strong></p><p>MySQL 允许在相同列上创建多个索引，重复的索引需要单独维护，并且优化器在优化查询时也需要逐个考虑，这会影响性能。重复索引是指在相同的列上按照相同的顺序创建的相同类型的索引，应该避免创建重复索引。如果创建了索引 (A,B) 再创建索引 (A) 就是冗余索引，因为这只是前一个索引的前缀索引，对于 B-Tree 索引来说是冗余的。解决重复索引和冗余索引的方法就是删除这些索引。除了重复索引和冗余索引，可能还会有一些服务器永远不用的索引，也应该考虑删除。</p><hr><h4 id="Q10：索引失效的情况有哪些？"><a href="#Q10：索引失效的情况有哪些？" class="headerlink" title="Q10：索引失效的情况有哪些？"></a>Q10：索引失效的情况有哪些？</h4><p>如果索引列出现了隐式类型转换，则 MySQL 不会使用索引。常见的情况是在 SQL 的 WHERE 条件中字段类型为字符串，其值为数值，如果没有加引号那么 MySQL 不会使用索引。</p><p>如果 WHERE 条件中含有 OR，除非 OR 前使用了索引列而 OR 之后是非索引列，索引会失效。</p><p>MySQL 不能在索引中执行 LIKE 操作，这是底层存储引擎 API 的限制，最左匹配的 LIKE 比较会被转换为简单的比较操作，但如果是以通配符开头的 LIKE 查询，存储引擎就无法做比较。这种情况下 MySQL 只能提取数据行的值而不是索引值来做比较。</p><p>如果查询中的列不是独立的，则 MySQL 不会使用索引。独立的列是指索引列不能是表达式的一部分，也不能是函数的参数。</p><p>对于多个范围条件查询，MySQL 无法使用第一个范围列后面的其他索引列，对于多个等值查询则没有这种限制。</p><p>如果 MySQL 判断全表扫描比使用索引查询更快，则不会使用索引。</p><p>索引文件具有 B-Tree 的最左前缀匹配特性，如果左边的值未确定，那么无法使用此索引。</p><hr><h3 id="优化-5"><a href="#优化-5" class="headerlink" title="优化 5"></a>优化 5</h3><h4 id="Q1：如何定位低效-SQL？"><a href="#Q1：如何定位低效-SQL？" class="headerlink" title="Q1：如何定位低效 SQL？"></a>Q1：如何定位低效 SQL？</h4><p>可以通过两种方式来定位执行效率较低的 SQL 语句。一种是通过慢查询日志定位，可以通过慢查询日志定位那些已经执行完毕的 SQL 语句。另一种是使用 SHOW PROCESSLIST 查询，慢查询日志在查询结束以后才记录，所以在应用反应执行效率出现问题的时候查询慢查询日志不能定位问题，此时可以使用 SHOW PROCESSLIST 命令查看当前 MySQL 正在进行的线程，包括线程的状态、是否锁表等，可以实时查看 SQL 的执行情况，同时对一些锁表操作进行优化。找到执行效率低的 SQL 语句后，就可以通过 SHOW PROFILE、EXPLAIN 或 trace 等丰富来继续优化语句。</p><hr><h4 id="Q2：SHOW-PROFILE-的作用？"><a href="#Q2：SHOW-PROFILE-的作用？" class="headerlink" title="Q2：SHOW PROFILE 的作用？"></a>Q2：SHOW PROFILE 的作用？</h4><p>通过 SHOW PROFILE 可以分析 SQL 语句性能消耗，例如查询到 SQL 会执行多少时间，并显示 CPU、内存使用量，执行过程中系统锁及表锁的花费时间等信息。例如 <code>SHOW PROFILE CPU/MEMORY/BLOCK IO FOR QUERY N</code> 分别查询 id 为 N 的 SQL 语句的 CPU、内存以及 IO 的消耗情况。</p><hr><h4 id="Q3：trace-是干什么的？"><a href="#Q3：trace-是干什么的？" class="headerlink" title="Q3：trace 是干什么的？"></a>Q3：trace 是干什么的？</h4><p>从 MySQL5.6 开始，可以通过 trace 文件进一步获取优化器是是如何选择执行计划的，在使用时需要先打开设置，然后执行一次 SQL，最后查看 information_schema.optimizer_trace 表而都内容，该表为联合i表，只能在当前会话进行查询，每次查询后返回的都是最近一次执行的 SQL 语句。</p><hr><h4 id="Q4：EXPLAIN-的字段有哪些，具有什么含义？"><a href="#Q4：EXPLAIN-的字段有哪些，具有什么含义？" class="headerlink" title="Q4：EXPLAIN 的字段有哪些，具有什么含义？"></a>Q4：EXPLAIN 的字段有哪些，具有什么含义？</h4><p>执行计划是 SQL 调优的一个重要依据，可以通过 EXPLAIN 命令查看 SQL 语句的执行计划，如果作用在表上，那么该命令相当于 DESC。EXPLAIN 的指标及含义如下：</p><table><thead><tr><th>指标名</th><th>含义</th></tr></thead><tbody><tr><td>id</td><td>表示 SELECT 子句或操作表的顺序，执行顺序从大到小执行，当 id 一样时，执行顺序从上往下。</td></tr><tr><td>select_type</td><td>表示查询中每个 SELECT 子句的类型，例如 SIMPLE 表示不包含子查询、表连接或其他复杂语法的简单查询，PRIMARY 表示复杂查询的最外层查询，SUBQUERY 表示在 SELECT 或 WHERE 列表中包含了子查询。</td></tr><tr><td>type</td><td>表示访问类型，性能由差到好为：ALL 全表扫描、index 索引全扫描、range 索引范围扫描、ref 返回匹配某个单独值得所有行，常见于使用非唯一索引或唯一索引的非唯一前缀进行的查找，也经常出现在 join 操作中、eq_ref 唯一性索引扫描，对于每个索引键只有一条记录与之匹配、const 当 MySQL 对查询某部分进行优化，并转为一个常量时，使用这些访问类型，例如将主键或唯一索引置于 WHERE 列表就能将该查询转为一个 const、system 表中只有一行数据或空表，只能用于 MyISAM 和 Memory 表、NULL 执行时不用访问表或索引就能得到结果。SQL 性能优化的目标：至少要达到 range 级别，要求是 ref 级别，如果可以是consts 最好。</td></tr><tr><td>possible_keys</td><td>表示查询时可能用到的索引，但不一定使用。列出大量可能索引时意味着备选索引数量太多了。</td></tr><tr><td>key</td><td>显示 MySQL 在查询时实际使用的索引，如果没有使用则显示为 NULL。</td></tr><tr><td>key_len</td><td>表示使用到索引字段的长度，可通过该列计算查询中使用的索引的长度，对于确认索引有效性以及多列索引中用到的列数目很重要。</td></tr><tr><td>ref</td><td>表示上述表的连接匹配条件，即哪些列或常量被用于查找索引列上的值。</td></tr><tr><td>rows</td><td>表示 MySQL 根据表统计信息及索引选用情况，估算找到所需记录所需要读取的行数。</td></tr><tr><td>Extra</td><td>表示额外信息，例如 Using temporary 表示需要使用临时表存储结果集，常见于排序和分组查询。Using filesort 表示无法利用索引完成的文件排序，这是 ORDER BY 的结果，可以通过合适的索引改进性能。Using index 表示只需要使用索引就可以满足查询表得要求，说明表正在使用覆盖索引。</td></tr></tbody></table><hr><h4 id="Q5：有哪些优化-SQL-的策略？"><a href="#Q5：有哪些优化-SQL-的策略？" class="headerlink" title="Q5：有哪些优化 SQL 的策略？"></a>Q5：有哪些优化 SQL 的策略？</h4><p><strong>优化 COUNT 查询</strong></p><p>COUNT 是一个特殊的函数，它可以统计某个列值的数量，在统计列值时要求列值是非空的，不会统计 NULL 值。如果在 COUNT 中指定了列或列的表达式，则统计的就是这个表达式有值的结果数，而不是 NULL。</p><p>COUNT 的另一个作用是统计结果集的行数，当 MySQL 确定括号内的表达式不可能为 NULL 时，实际上就是在统计行数。当使用 COUNT(<em>) 时，\</em> 不会扩展成所有列，它会忽略所有的列而直接统计所有的行数。</p><p>某些业务场景并不要求完全精确的 COUNT 值，此时可以使用近似值来代替，EXPLAIN 出来的优化器估算的行数就是一个不错的近似值，因为执行 EXPLAIN 并不需要真正地执行查询。</p><p>通常来说 COUNT 都需要扫描大量的行才能获取精确的结果，因此很难优化。在 MySQL 层还能做的就只有覆盖扫描了，如果还不够就需要修改应用的架构，可以增加汇总表或者外部缓存系统。</p><p><strong>优化关联查询</strong></p><p>确保 ON 或 USING 子句中的列上有索引，在创建索引时就要考虑到关联的顺序。</p><p>确保任何 GROUP BY 和 ORDER BY 的表达式只涉及到一个表中的列，这样 MySQL 才有可能使用索引来优化这个过程。</p><p>在 MySQL 5.5 及以下版本尽量避免子查询，可以用关联查询代替，因为执行器会先执行外部的 SQL 再执行内部的 SQL。</p><p><strong>优化 GROUP BY</strong></p><p>如果没有通过 ORDER BY 子句显式指定要排序的列，当查询使用 GROUP BY 时，结果***自动按照分组的字段进行排序，如果不关心结果集的顺序，可以使用 ORDER BY NULL 禁止排序。</p><p><strong>优化 LIMIT 分页</strong></p><p>在偏移量非常大的时候，需要查询很多条数据再舍弃，这样的代价非常高。要优化这种查询，要么是在页面中限制分页的数量，要么是优化大偏移量的性能。最简单的办法是尽可能地使用覆盖索引扫描，而不是查询所有的列，然后根据需要做一次关联操作再返回所需的列。</p><p>还有一种方法是从上一次取数据的位置开始扫描，这样就可以避免使用 OFFSET。其他优化方法还包括使用预先计算的汇总表，或者关联到一个冗余表，冗余表只包含主键列和需要做排序的数据列。</p><p><strong>优化 UNION 查询</strong></p><p>MySQL 通过创建并填充临时表的方式来执行 UNION 查询，除非确实需要服务器消除重复的行，否则一定要使用 UNION ALL，如果没有 ALL 关键字，MySQL 会给临时表加上 DISTINCT 选项，这会导致对整个临时表的数据做唯一性检查，这样做的代价非常高。</p><p><strong>使用用户自定义变量</strong></p><p>在查询中混合使用过程化和关系化逻辑的时候，自定义变量可能会非常有用。用户自定义变量是一个用来存储内容的临时容器，在连接 MySQL 的整个过程中都存在，可以在任何可以使用表达式的地方使用自定义变量。例如可以使用变量来避免重复查询刚刚更新过的数据、统计更新和插入的数量等。</p><p><strong>优化 INSERT</strong> </p><p>需要对一张表插入很多行数据时，应该尽量使用一次性插入多个值的 INSERT 语句，这种方式将缩减客户端与数据库之间的连接、关闭等消耗，效率比多条插入单个值的 INSERT 语句高。也可以关闭事务的自动提交，在插入完数据后提交。当插入的数据是按主键的顺序插入时，效率更高。</p><hr><h3 id="复制-2"><a href="#复制-2" class="headerlink" title="复制 2"></a>复制 2</h3><h4 id="Q1：MySQL-主从复制的作用？"><a href="#Q1：MySQL-主从复制的作用？" class="headerlink" title="Q1：MySQL 主从复制的作用？"></a>Q1：MySQL 主从复制的作用？</h4><p>复制解决的基本问题是让一台服务器的数据与其他服务器保持同步，一台主库的数据可以同步到多台备库上，备库本身也可以被配置成另外一台服务器的主库。主库和备库之间可以有多种不同的组合方式。</p><p>MySQL 支持两种复制方式：基于行的复制和基于语句的复制，基于语句的复制也称为逻辑复制，从 MySQL 3.23 版本就已存在，基于行的复制方式在 5.1 版本才被加进来。这两种方式都是通过在主库上记录二进制日志、在备库重放日志的方式来实现异步的数据复制。因此同一时刻备库的数据可能与主库存在不一致，并且无法包装主备之间的延迟。</p><p>MySQL 复制大部分是向后兼容的，新版本的服务器可以作为老版本服务器的备库，但是老版本不能作为新版本服务器的备库，因为它可能无法解析新版本所用的新特性或语法，另外所使用的二进制文件格式也可能不同。</p><p>复制解决的问题：数据分布、负载均衡、备份、高可用性和故障切换、MySQL 升级测试。</p><hr><h4 id="Q2：MySQL-主从复制的步骤？"><a href="#Q2：MySQL-主从复制的步骤？" class="headerlink" title="Q2：MySQL 主从复制的步骤？"></a>Q2：MySQL 主从复制的步骤？</h4><p>① 在主库上把数据更改记录到二进制日志中。② 备库将主库的日志复制到自己的中继日志中。 ③ 备库读取中继日志中的事件，将其重放到备库数据之上。</p><p>第一步是在主库上记录二进制日志，每次准备提交事务完成数据更新前，主库将数据更新的事件记录到二进制日志中。MySQL 会按事务提交的顺序而非每条语句的执行顺序来记录二进制日志，在记录二进制日志后，主库会告诉存储引擎可以提交事务了。</p><p>下一步，备库将主库的二进制日志复制到其本地的中继日志中。备库首先会启动一个工作的 IO 线程，IO 线程跟主库建立一个普通的客户端连接，然后在主库上启动一个特殊的二进制转储线程，这个线程会读取主库上二进制日志中的事件。它不会对事件进行轮询。如果该线程追赶上了主库将进入睡眠状态，直到主库发送信号量通知其有新的事件产生时才会被唤醒，备库 IO 线程会将接收到的事件记录到中继日志中。</p><p>备库的 SQL 线程执行最后一步，该线程从中继日志中读取事件并在备库执行，从而实现备库数据的更新。当 SQL 线程追赶上 IO 线程时，中继日志通常已经在系统缓存中，所以中继日志的开销很低。SQL 线程执行的时间也可以通过配置选项来决定是否写入其自己的二进制日志中。</p><hr><h2 id="Redis-37"><a href="#Redis-37" class="headerlink" title="Redis 37"></a>Redis 37</h2><h3 id="架构-3"><a href="#架构-3" class="headerlink" title="架构 3"></a>架构 3</h3><h4 id="Q1：Redis-有什么特点？"><a href="#Q1：Redis-有什么特点？" class="headerlink" title="Q1：Redis 有什么特点？"></a>Q1：Redis 有什么特点？</h4><p><strong>基于键值对的数据结构服务器</strong></p><p>Redis 中的值不仅可以是字符串，还可以是具体的数据结构，这样不仅能应用于多种场景开发，也可以提高开发效率。它主要提供五种数据结构：字符串、哈希、列表、集合、有序集合，同时在字符串的基础上演变出了 Bitmaps 和 HyperLogLog 两种数据结构，Redis 3.2 还加入了有关 GEO 地理信息定位的功能。</p><p><strong>丰富的功能</strong></p><p>① 提供了键过期功能，可以实现缓存。② 提供了发布订阅功能，可以实现消息系统。③ 支持 Lua 脚本，可以创造新的 Redis 命令。④ 提供了简单的事务功能，能在一定程度上保证事务特性。⑤ 提供了流水线功能，客户端能将一批命令一次性传到 Redis，减少网络开销。</p><p><strong>简单稳定</strong></p><p>Redis 的简单主要体现在三个方面：① 源码很少，早期只有 2 万行左右，在 3.0 版本由于添加了集群特性，增加到了 5 万行左右，相对于很多 NoSQL 数据库来说代码量要少很多。② 采用单线程模型，使得服务端处理模型更简单，也使客户端开发更简单。③ 不依赖底层操作系统的类库，自己实现了事件处理的相关功能。虽然 Redis 比较简单，但也很稳定。</p><p><strong>客户端语言多</strong></p><p>Redis 提供了简单的 TCP 通信协议，很多编程语言可以方便地接入 Redis，例如 Java、PHP、Python、C、C++ 等。</p><p><strong>持久化</strong></p><p>通常来说数据放在内存中是不安全的，一旦发生断电或故障数据就可能丢失，因此 Redis 提供了两种持久化方式 RDB 和 AOF 将内存的数据保存到硬盘中。</p><p><strong>高性能</strong></p><p>Redis 使用了单线程架构和 IO 多路复用模型来实现高性能的内存数据库服务。</p><p>每次客户端调用都经历了发送命令、执行命令、返回结果三个过程，因为 Redis 是单线程处理命令的，所以一条命令从客户端到达服务器不会立即执行，所有命令都会进入一个队列中，然后逐个被执行。客户端的执行顺序可能不确定，但是可以确定不会有两条命令被同时执行，不存在并发问题。</p><p>通常来说单线程处理能力要比多线程差，Redis 快的原因：① 纯内存访问，Redis 将所有数据放在内存中。② 非阻塞 IO，Redis 使用 epoll 作为 IO 多路复用技术的实现，再加上 Redis 本身的事件处理模型将 epoll 中的连接、读写、关闭都转换为时间，不在网络 IO 上浪费过多的时间。③ 单线程避免了线程切换和竞争产生的消耗。单线程的一个问题是对于每个命令的执行时间是有要求的，如果某个命令执行时间过长会造成其他命令的阻塞，对于 Redis 这种高性能服务来说是致命的，因此 Redis 是面向快速执行场景的数据库。</p><hr><h4 id="Q2：Redis-的数据结构有哪些？"><a href="#Q2：Redis-的数据结构有哪些？" class="headerlink" title="Q2：Redis 的数据结构有哪些？"></a>Q2：Redis 的数据结构有哪些？</h4><p>可以使用 type 命令查看当前键的数据类型结构，它们分别是：string、hash、list、set、zset，但这些只是 Redis 对外的数据结构。实际上每种数据结构都有自己底层的内部编码实现，这样 Redis 会在合适的场景选择合适的内部编码，string 包括了 raw、int 和 embstr，hash 包括了 hashtable 和 ziplist，list 包括了 linkedlist 和 ziplist，set 包括了 hashtable 和 intset，zset 包括了 skiplist 和 ziplist。可以使用 <code>object encoding</code> 查看内部编码。</p><hr><h4 id="Q3：Redis-为什么要使用内部编码？"><a href="#Q3：Redis-为什么要使用内部编码？" class="headerlink" title="Q3：Redis 为什么要使用内部编码？"></a>Q3：Redis 为什么要使用内部编码？</h4><p>① 可以改进内部编码，而对外的数据结构和命令没有影响。</p><p>② 多种内部编码实现可以在不同场景下发挥各自的优势，例如 ziplist 比较节省内存，但在列表元素较多的情况下性能有所下降，这时 Redis 会根据配置选项将列表类型的内部实现转换为 linkedlist。</p><hr><h3 id="string-4"><a href="#string-4" class="headerlink" title="string 4"></a>string 4</h3><h4 id="Q1：简单说一说-string-类型"><a href="#Q1：简单说一说-string-类型" class="headerlink" title="Q1：简单说一说 string 类型"></a>Q1：简单说一说 string 类型</h4><p>字符串类型是 Redis 最基础的数据结构，键都是字符串类型，而且其他几种数据结构都是在字符串类型的基础上构建的。字符串类型的值可以实际可以是字符串（简单的字符串、复杂的字符串如 JSON、XML）、数字（整形、浮点数）、甚至二进制（图片、音频、视频），但是值最大不能超过 512 MB。</p><hr><h4 id="Q2：你知道哪些-string-的命令？"><a href="#Q2：你知道哪些-string-的命令？" class="headerlink" title="Q2：你知道哪些 string 的命令？"></a>Q2：你知道哪些 string 的命令？</h4><p><strong>设置值</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">set key value [ex seconds] [px millseconds] [nx|xx]</span><br></pre></td></tr></table></figure><ul><li>ex seconds：为键设置秒级过期时间，跟 setex 效果一样 </li><li>px millseconds：为键设置毫秒级过期时间 </li><li>nx：键必须不存在才可以设置成功，用于添加，跟 setnx 效果一样。由于 Redis 的单线程命令处理机制，如果多个客户端同时执行，则只有一个客户端能设置成功，可以用作分布式锁的一种实现。 </li><li>xx：键必须存在才可以设置成功，用于更新 </li></ul><p><strong>获取值</strong></p><p><code>get key</code>，如果不存在返回 nil</p><p><strong>批量设置值</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">mset key value [key value...]</span><br></pre></td></tr></table></figure><p><strong>批量获取值</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">mget key [key...]</span><br></pre></td></tr></table></figure><p>批量操作命令可以有效提高开发效率，假如没有 mget，执行 n 次 get 命令需要 n 次网络时间 + n 次命令时间，使用 mget 只需要 1 次网络时间 + n 次命令时间。Redis 可以支持每秒数万的读写操作，但这指的是 Redis 服务端的处理能力，对于客户端来说一次命令处理命令时间还有网络时间。因为 Redis 的处理能力已足够高，对于开发者来说，网络可能会成为性能瓶颈。</p><p><strong>计数</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">incr key</span><br></pre></td></tr></table></figure><p>incr 命令用于对值做自增操作，返回结果分为三种：① 值不是整数返回错误。② 值是整数，返回自增后的结果。③ 值不存在，按照值为 0 自增，返回结果 1。除了 incr 命令，还有自减 decr、自增指定数字 incrby、自减指定数组 decrby、自增浮点数 incrbyfloat。</p><hr><h4 id="Q3：string-的内部编码是什么？"><a href="#Q3：string-的内部编码是什么？" class="headerlink" title="Q3：string 的内部编码是什么？"></a>Q3：string 的内部编码是什么？</h4><ul><li>int：8 个字节的长整形 </li><li>embstr：小于等于 39 个字节的字符串 </li><li>raw：大于 39 个字节的字符串 </li></ul><hr><h4 id="Q4：string-的应用场景有什么？"><a href="#Q4：string-的应用场景有什么？" class="headerlink" title="Q4：string 的应用场景有什么？"></a>Q4：string 的应用场景有什么？</h4><p><strong>缓存功能</strong></p><p>Redis 作为缓存层，MySQL 作为存储层，首先从 Redis 获取数据，如果失败就从 MySQL 获取并将结果写回 Redis 并添加过期时间。</p><p><strong>计数</strong></p><p>Redis 可以实现快速计数功能，例如视频每播放一次就用 incy 把播放数加 1。</p><p><strong>共享 Session</strong></p><p>一个分布式 Web 服务将用户的 Session 信息保存在各自服务器，但会造成一个问题，出于负载均衡的考虑，分布式服务会将用户的访问负载到不同服务器上，用户刷新一次可能会发现需要重新登陆。为解决该问题，可以使用 Redis 将用户的 Session 进行集中管理，在这种模式下只要保证 Redis 是高可用和扩展性的，每次用户更新或查询登录信息都直接从 Redis 集中获取。</p><p><strong>限速</strong></p><p>例如为了短信接口不被频繁访问会限制用户每分钟获取验证码的次数或者网站限制一个 IP 地址不能在一秒内访问超过 n 次。可以使用键过期策略和自增计数实现。</p><hr><h3 id="hash-4"><a href="#hash-4" class="headerlink" title="hash 4"></a>hash 4</h3><h4 id="Q1：简单说一说-hash-类型"><a href="#Q1：简单说一说-hash-类型" class="headerlink" title="Q1：简单说一说 hash 类型"></a>Q1：简单说一说 hash 类型</h4><p>哈希类型指键值本身又是一个键值对结构，哈希类型中的映射关系叫 field-value，这里的 value 是指 field 对于的值而不是键对于的值。</p><hr><h4 id="Q2：你知道哪些-hash-的命令？"><a href="#Q2：你知道哪些-hash-的命令？" class="headerlink" title="Q2：你知道哪些 hash 的命令？"></a>Q2：你知道哪些 hash 的命令？</h4><p><strong>设置值</strong></p><p><code>hset key field value</code>，如果设置成功会返回 1，反之会返回 0，此外还提供了 hsetnx 命令，作用和 setnx 类似，只是作用于由键变为 field。</p><p><strong>获取值</strong></p><p><code>hget key field</code>，如果不存在会返回 nil。</p><p><strong>删除 field</strong></p><p><code>hdel key field [field...]</code>，会删除一个或多个 field，返回结果为删除成功 field 的个数。</p><p><strong>计算 field 个数</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">hlen key</span><br></pre></td></tr></table></figure><p><strong>批量设置或获取 field-value</strong></p><p><a href="#">复制代码</a></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">hmget key field [field...]</span><br><span class="line">hmset key field value [field value...]</span><br></pre></td></tr></table></figure><p><strong>判断 field 是否存在</strong></p><p><code>hexists key field</code>，存在返回 1，否则返回  0。</p><p><strong>获取所有的 field</strong></p><p><code>hkeys key</code>，返回指定哈希键的所有 field。</p><p><strong>获取所有 value</strong></p><p><code>hvals key</code>，获取指定键的所有 value。</p><p><strong>获取所有的 field-value</strong></p><p><code>hgetall key</code>，获取指定键的所有 field-value。</p><hr><h4 id="Q3：hash-的内部编码是什么？"><a href="#Q3：hash-的内部编码是什么？" class="headerlink" title="Q3：hash 的内部编码是什么？"></a>Q3：hash 的内部编码是什么？</h4><p>ziplist 压缩列表：当哈希类型元素个数和值小于配置值（默认 512 个和 64 字节）时会使用 ziplist 作为内部实现，使用更紧凑的结构实现多个元素的连续存储，在节省内存方面比 hashtable 更优秀。</p><p>hashtable 哈希表：当哈希类型无法满足 ziplist 的条件时会使用 hashtable 作为哈希的内部实现，因为此时 ziplist 的读写效率会下降，而 hashtable 的读写时间复杂度都为 O(1)。</p><hr><h4 id="Q4：hash-的应用场景有什么？"><a href="#Q4：hash-的应用场景有什么？" class="headerlink" title="Q4：hash 的应用场景有什么？"></a>Q4：hash 的应用场景有什么？</h4><p>缓存用户信息，每个用户属性使用一对 field-value，但只用一个键保存。</p><p>优点：简单直观，如果合理使用可以减少内存空间使用。</p><p>缺点：要控制哈希在 ziplist 和 hashtable 两种内部编码的转换，hashtable 会消耗更多内存。</p><hr><h3 id="list-4"><a href="#list-4" class="headerlink" title="list 4"></a>list 4</h3><h4 id="Q1：简单说一说-list-类型"><a href="#Q1：简单说一说-list-类型" class="headerlink" title="Q1：简单说一说 list 类型"></a>Q1：简单说一说 list 类型</h4><p>list 是用来存储多个有序的字符串，列表中的每个字符串称为元素，一个列表最多可以存储 2^32^-1 个元素。可以对列表两端插入（push）和弹出（pop），还可以获取指定范围的元素列表、获取指定索引下标的元素等。列表是一种比较灵活的数据结构，它可以充当栈和队列的角色，在实际开发中有很多应用场景。</p><p>list 有两个特点：① 列表中的元素是有序的，可以通过索引下标获取某个元素或者某个范围内的元素列表。② 列表中的元素可以重复。</p><hr><h4 id="Q2：你知道哪些-list-的命令？"><a href="#Q2：你知道哪些-list-的命令？" class="headerlink" title="Q2：你知道哪些 list 的命令？"></a>Q2：你知道哪些 list 的命令？</h4><p><strong>添加</strong></p><p>从右边插入元素：<code>rpush key value [value...]</code></p><p>从左到右获取列表的所有元素：<code>lrange 0 -1</code></p><p>从左边插入元素：<code>lpush key value [value...]</code></p><p>向某个元素前或者后插入元素：<code>linsert key before|after pivot value</code>，会在列表中找到等于 pivot 的元素，在其前或后插入一个新的元素 value。</p><p><strong>查找</strong></p><p>获取指定范围内的元素列表：<code>lrange key start end</code>，索引从左到右的范围是 0<del>N-1，从右到左是 -1</del>-N，lrange 中的 end 包含了自身。</p><p>获取列表指定索引下标的元素：<code>lindex key index</code>，获取最后一个元素可以使用 <code>lindex key -1</code>。</p><p>获取列表长度：<code>llen key</code></p><p><strong>删除</strong></p><p>从列表左侧弹出元素：<code>lpop key</code></p><p>从列表右侧弹出元素：<code>rpop key</code></p><p>删除指定元素：<code>lrem key count value</code>，如果 count 大于 0，从左到右删除最多 count 个元素，如果 count 小于 0，从右到左删除最多个 count 绝对值个元素，如果 count 等于 0，删除所有。</p><p>按照索引范围修剪列表：<code>ltrim key start end</code>，只会保留 start ~ end 范围的元素。</p><p><strong>修改</strong></p><p>修改指定索引下标的元素：<code>lset key index newValue</code>。</p><p><strong>阻塞操作</strong></p><p>阻塞式弹出：<code>blpop/brpop key [key...] timeout</code>，timeout 表示阻塞时间。</p><p>当列表为空时，如果 timeout = 0，客户端会一直阻塞，如果在此期间添加了元素，客户端会立即返回。</p><p>如果是多个键，那么brpop会从左至右遍历键，一旦有一个键能弹出元素，客户端立即返回。</p><p>如果多个客户端对同一个键执行 brpop，那么最先执行该命令的客户端可以获取弹出的值。</p><hr><h4 id="Q3：list-的内部编码是什么？"><a href="#Q3：list-的内部编码是什么？" class="headerlink" title="Q3：list 的内部编码是什么？"></a>Q3：list 的内部编码是什么？</h4><p>ziplist 压缩列表：跟哈希的 zipilist 相同，元素个数和大小小于配置值（默认 512 个和 64 字节）时使用。</p><p>linkedlist 链表：当列表类型无法满足 ziplist 的条件时会使用linkedlist。</p><p>Redis 3.2 提供了 quicklist 内部编码，它是以一个 ziplist 为节点的 linkedlist，它结合了两者的优势，为列表类提供了一种更为优秀的内部编码实现。</p><hr><h4 id="Q4：list-的应用场景有什么？"><a href="#Q4：list-的应用场景有什么？" class="headerlink" title="Q4：list 的应用场景有什么？"></a>Q4：list 的应用场景有什么？</h4><p><strong>消息队列</strong></p><p>Redis 的 lpush + brpop 即可实现阻塞队列，生产者客户端使用 lpush 从列表左侧插入元素，多个消费者客户端使用 brpop 命令阻塞式地抢列表尾部的元素，多个客户端保证了消费的负载均衡和高可用性。</p><p><strong>文章列表</strong></p><p>每个用户有属于自己的文章列表，现在需要分页展示文章列表，就可以考虑使用列表。因为列表不但有序，同时支持按照索引范围获取元素。每篇文章使用哈希结构存储。</p><p>lpush + lpop = 栈、lpush + rpop  = 队列、lpush + ltrim = 优先集合、lpush + brpop = 消息队列。</p><hr><h3 id="set-4"><a href="#set-4" class="headerlink" title="set 4"></a>set 4</h3><h4 id="Q1：简单说一说-set-类型"><a href="#Q1：简单说一说-set-类型" class="headerlink" title="Q1：简单说一说 set 类型"></a>Q1：简单说一说 set 类型</h4><p>集合类型也是用来保存多个字符串元素，和列表不同的是集合不允许有重复元素，并且集合中的元素是无序的，不能通过索引下标获取元素。一个集合最多可以存储 2^32^-1 个元素。Redis 除了支持集合内的增删改查，还支持多个集合取交集、并集、差集。</p><hr><h4 id="Q2：你知道哪些-set-的命令？"><a href="#Q2：你知道哪些-set-的命令？" class="headerlink" title="Q2：你知道哪些 set 的命令？"></a>Q2：你知道哪些 set 的命令？</h4><p><strong>添加元素</strong></p><p><code>sadd key element [element...]</code>，返回结果为添加成功的元素个数。</p><p><strong>删除元素</strong></p><p><code>srem key element [element...]</code>，返回结果为成功删除的元素个数。</p><p><strong>计算元素个数</strong></p><p><code>scard key</code>，时间复杂度为 O(1)，会直接使用 Redis 内部的遍历。</p><p><strong>判断元素是否在集合中</strong></p><p><code>sismember key element</code>，如果存在返回 1，否则返回 0。</p><p><strong>随机从集合返回指定个数个元素</strong></p><p><code>srandmember key [count]</code>，如果不指定 count 默认为 1。</p><p><strong>从集合随机弹出元素</strong></p><p><code>spop key</code>，可以从集合中随机弹出一个元素。</p><p><strong>获取所有元素</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">smembers key</span><br></pre></td></tr></table></figure><p><strong>求多个集合的交集/并集/差集</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">sinter key [key...]</span><br><span class="line">sunion key [key...]</span><br><span class="line">sdiff key [key...]</span><br></pre></td></tr></table></figure><p><strong>保存交集、并集、差集的结果</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">sinterstore/sunionstore/sdiffstore destination key [key...]</span><br></pre></td></tr></table></figure><p>集合间运算在元素较多情况下比较耗时，Redis 提供这三个指令将集合间交集、并集、差集的结果保存在 destination key 中。</p><hr><h4 id="Q3：set-的内部编码是什么？"><a href="#Q3：set-的内部编码是什么？" class="headerlink" title="Q3：set 的内部编码是什么？"></a>Q3：set 的内部编码是什么？</h4><p>intset 整数集合：当集合中的元素个数小于配置值（默认 512 个时），使用 intset。</p><p>hashtable 哈希表：当集合类型无法满足 intset 条件时使用 hashtable。当某个元素不为整数时，也会使用 hashtable。</p><hr><h4 id="Q4：set-的应用场景有什么？"><a href="#Q4：set-的应用场景有什么？" class="headerlink" title="Q4：set 的应用场景有什么？"></a>Q4：set 的应用场景有什么？</h4><p>set 比较典型的使用场景是标签，例如一个用户可能与娱乐、体育比较感兴趣，另一个用户可能对例时、新闻比较感兴趣，这些兴趣点就是标签。这些数据对于用户体验以及增强用户黏度比较重要。</p><p>sadd = 标签、spop/srandmember = 生成随机数，比如抽奖、sadd + sinter = 社交需求。</p><hr><h3 id="zset-4"><a href="#zset-4" class="headerlink" title="zset 4"></a>zset 4</h3><h4 id="Q1：简单说一说-zset-类型"><a href="#Q1：简单说一说-zset-类型" class="headerlink" title="Q1：简单说一说 zset 类型"></a>Q1：简单说一说 zset 类型</h4><p>有序集合保留了集合不能有重复成员的特性，不同的是可以排序。但是它和列表使用索引下标作为排序依据不同的是，他给每个元素设置一个分数（score）作为排序的依据。有序集合提供了获取指定分数和元素查询范围、计算成员排名等功能。</p><hr><h4 id="Q2：你知道哪些-zset-的命令？"><a href="#Q2：你知道哪些-zset-的命令？" class="headerlink" title="Q2：你知道哪些 zset 的命令？"></a>Q2：你知道哪些 zset 的命令？</h4><p><strong>添加成员</strong></p><p><code>zadd key score member [score member...]</code>，返回结果是成功添加成员的个数</p><p>Redis 3.2 为 zadd 命令添加了 nx、xx、ch、incr 四个选项：</p><ul><li>nx：member 必须不存在才可以设置成功，用于添加。 </li><li>xx：member 必须存在才能设置成功，用于更新。 </li><li>ch：返回此次操作后，有序集合元素和分数变化的个数。 </li><li>incr：对 score 做增加，相当于 zincrby。 </li></ul><p>zadd 的时间复杂度为 O(log<del>n</del>)，sadd 的时间复杂度为 O(1)。</p><p><strong>计算成员个数</strong></p><p><code>zcard key</code>，时间复杂度为 O(1)。</p><p><strong>计算某个成员的分数</strong></p><p><code>zscore key member</code> ，如果不存在则返回 nil。</p><p><strong>计算成员排名</strong></p><p><code>zrank key member</code>，从低到高返回排名。</p><p><code>zrevrank key member</code>，从高到低返回排名。</p><p><strong>删除成员</strong></p><p><code>zrem key member [member...]</code>，返回结果是成功删除的个数。</p><p><strong>增加成员的分数</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">zincrby key increment member</span><br></pre></td></tr></table></figure><p><strong>返回指定排名范围的成员</strong></p><p><code>zrange key start end [withscores]</code>，从低到高返回</p><p><code>zrevrange key start end [withscores]</code>， 从高到底返回</p><p><strong>返回指定分数范围的成员</strong></p><p><code>zrangebyscore key min max [withscores] [limit offset count]</code>，从低到高返回</p><p><code>zrevrangebyscore key min max [withscores] [limit offset count]</code>， 从高到底返回</p><p><strong>返回指定分数范围成员个数</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">zcount key min max</span><br></pre></td></tr></table></figure><p><strong>删除指定分数范围内的成员</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">zremrangebyscore key min max</span><br></pre></td></tr></table></figure><p><strong>交集和并集</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">zinterstore/zunionstore destination numkeys key [key...] [weights weight [weight...]] [aggregate sum|min|max]</span><br></pre></td></tr></table></figure><ul><li><code>destination</code>：交集结果保存到这个键</li><li><code>numkeys</code>：要做交集计算键的个数</li><li><code>key</code>：需要做交集计算的键</li><li><code>weight</code>：每个键的权重，默认 1</li><li><code>aggregate sum|min|max</code>：计算交集后，分值可以按和、最小值、最大值汇总，默认 sum。</li></ul><hr><h4 id="Q3：zset-的内部编码是什么？"><a href="#Q3：zset-的内部编码是什么？" class="headerlink" title="Q3：zset 的内部编码是什么？"></a>Q3：zset 的内部编码是什么？</h4><p>ziplist 压缩列表：当有序集合元素个数和值小于配置值（默认128 个和 64 字节）时会使用 ziplist 作为内部实现。</p><p>skiplist 跳跃表：当 ziplist 不满足条件时使用，因为此时 ziplist 的读写效率会下降。</p><hr><h4 id="Q4：zset-的应用场景有什么？"><a href="#Q4：zset-的应用场景有什么？" class="headerlink" title="Q4：zset 的应用场景有什么？"></a>Q4：zset 的应用场景有什么？</h4><p>有序集合的典型使用场景就是排行榜系统，例如用户上传了一个视频并获得了赞，可以使用 zadd 和 zincrby。如果需要将用户从榜单删除，可以使用 zrem。如果要展示获取赞数最多的十个用户，可以使用 zrange。</p><hr><h3 id="键和数据库管理-5"><a href="#键和数据库管理-5" class="headerlink" title="键和数据库管理 5"></a>键和数据库管理 5</h3><h4 id="Q1：如何对键重命名？"><a href="#Q1：如何对键重命名？" class="headerlink" title="Q1：如何对键重命名？"></a>Q1：如何对键重命名？</h4><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">rename key newkey</span><br></pre></td></tr></table></figure><p>如果 rename 前键已经存在，那么它的值也会被覆盖。为了防止强行覆盖，Redis 提供了 renamenx 命令，确保只有 newkey 不存在时才被覆盖。由于重命名键期间会执行 del 命令删除旧的键，如果键对应值比较大会存在阻塞的可能。</p><hr><h4 id="Q2：如何设置键过期？"><a href="#Q2：如何设置键过期？" class="headerlink" title="Q2：如何设置键过期？"></a>Q2：如何设置键过期？</h4><p><code>expire key seconds</code>：键在 seconds 秒后过期。</p><p>如果过期时间为负值，键会被立即删除，和 del 命令一样。persist 命令可以将键的过期时间清除。</p><p>对于字符串类型键，执行 set 命令会去掉过期时间，set 命令对应的函数 setKey 最后执行了 removeExpire 函数去掉了过期时间。setex 命令作为 set + expire 的组合，不单是原子执行并且减少了一次网络通信的时间。</p><hr><h4 id="Q3：如何进行键迁移？"><a href="#Q3：如何进行键迁移？" class="headerlink" title="Q3：如何进行键迁移？"></a>Q3：如何进行键迁移？</h4><ul><li><p>move</p><p>move 命令用于在 Redis 内部进行数据迁移，<code>move key db</code> 把指定的键从源数据库移动到目标数据库中。</p></li><li><p>dump + restore</p><p>可以实现在不同的 Redis 实例之间进行数据迁移，分为两步：</p><p>① <code>dump key</code> ，在源 Redis 上，dump 命令会将键值序列化，格式采用 RDB 格式。</p><p>② <code>restore key ttl value</code>，在目标 Redis 上，restore 命令将序列化的值进行复原，ttl 代表过期时间， ttl = 0 则没有过期时间。</p><p>整个迁移并非原子性的，而是通过客户端分步完成，并且需要两个客户端。</p></li><li><p>migrate</p><p>实际上 migrate 命令就是将 dump、restore、del 三个命令进行组合，从而简化操作流程。migrate 具有原子性，支持多个键的迁移，有效提高了迁移效率。实现过程和 dump + restore 类似，有三点不同：</p><p>① 整个过程是原子执行，不需要在多个 Redis 实例开启客户端。</p><p>② 数据传输直接在源 Redis 和目标 Redis 完成。</p><p>③ 目标 Redis 完成 restore 后会发送 OK 给源 Redis，源 Redis 接收后根据 migrate 对应选项来决定是否在源 Redis 上删除对应键。</p></li></ul><hr><h4 id="Q4：如何切换数据库？"><a href="#Q4：如何切换数据库？" class="headerlink" title="Q4：如何切换数据库？"></a>Q4：如何切换数据库？</h4><p><code>select dbIndex</code>，Redis 中默认配置有 16 个数据库，例如 select 0 将切换到第一个数据库，数据库之间的数据是隔离的。</p><hr><h4 id="Q5：如何清除数据库？"><a href="#Q5：如何清除数据库？" class="headerlink" title="Q5：如何清除数据库？"></a>Q5：如何清除数据库？</h4><p>用于清除数据库，flushdb 只清除当前数据库，flushall 会清除所有数据库。如果当前数据库键值数量比较多，flushdb/flushall 存在阻塞 Redis 的可能性。</p><hr><h3 id="持久化-9"><a href="#持久化-9" class="headerlink" title="持久化 9"></a>持久化 9</h3><h4 id="Q1：RDB-持久化的原理？"><a href="#Q1：RDB-持久化的原理？" class="headerlink" title="Q1：RDB 持久化的原理？"></a>Q1：RDB 持久化的原理？</h4><p>RDB 持久化是把当前进程数据生成快照保存到硬盘的过程，触发 RDB 持久化过程分为手动触发和自动触发。</p><p>手动触发分别对应 save 和 bgsave 命令：</p><ul><li>save：阻塞当前 Redis 服务器，直到 RDB 过程完成为止，对于内存比较大的实例会造成长时间阻塞，线上环境不建议使用。 </li><li>bgasve：Redis 进程执行 fork 操作创建子进程，RDB 持久化过程由子进程负责，完成后自动结束。阻塞只发生在 fork 阶段，一般时间很短。bgsave 是针对 save 阻塞问题做的优化，因此 Redis 内部所有涉及 RDB 的操作都采用 bgsave 的方式，而 save 方式已经废弃。 </li></ul><p>除了手动触发外，Redis 内部还存在自动触发 RDB 的持久化机制，例如：</p><ul><li>使用 save 相关配置，如 save m n，表示 m 秒内数据集存在 n 次修改时，自动触发 bgsave。 </li><li>如果从节点执行全量复制操作，主节点自动执行 bgsave 生成 RDB 文件并发送给从节点。 </li><li>执行 debug reload 命令重新加载 Redis 时也会自动触发 save 操作。 </li><li>默认情况下执行 shutdown 命令时，如果没有开启 AOF 持久化功能则自动执行 bgsave。 </li></ul><hr><h4 id="Q2：bgsave-的原理？"><a href="#Q2：bgsave-的原理？" class="headerlink" title="Q2：bgsave 的原理？"></a>Q2：bgsave 的原理？</h4><p>① 执行 bgsave 命令，Redis 父进程判断当前是否存在正在执行的子进程，如 RDB/AOF 子进程，如果存在 bgsave 命令直接返回。</p><p>② 父进程执行 fork 操作创建子进程，fork 操作过程中父进程会阻塞。</p><p>③ 父进程 fork 完成后，bgsave 命令返回并不再阻塞父进程，可以继续响应其他命令。</p><p>④ 子进程创建 RDB 文件，根据父进程内存生成临时快照文件，完成后对原有文件进行原子替换。</p><p>⑤ 进程发送信号给父进程表示完成，父进程更新统计信息。</p><hr><h4 id="Q3：RDB-持久化的优点？"><a href="#Q3：RDB-持久化的优点？" class="headerlink" title="Q3：RDB 持久化的优点？"></a>Q3：RDB 持久化的优点？</h4><p>RDB 是一个紧凑压缩的二进制文件，代表 Redis 在某个时间点上的数据快照。非常适合于备份，全量复制等场景。例如每 6 个消时执行 bgsave 备份，并把 RDB 文件拷贝到远程机器或者文件系统中，用于灾难恢复。</p><p>Redis 加载 RDB 恢复数据远远快于 AOF 的方式。</p><hr><h4 id="Q4：RDB-持久化的缺点？"><a href="#Q4：RDB-持久化的缺点？" class="headerlink" title="Q4：RDB 持久化的缺点？"></a>Q4：RDB 持久化的缺点？</h4><p>RDB 方式数据无法做到实时持久化/秒级持久化，因为 bgsave 每次运行都要执行 fork 操作创建子进程，属于重量级操作，频繁执行成本过高。针对 RDB 不适合实时持久化的问题，Redis 提供了 AOF 持久化方式。</p><p>RDB 文件使用特定二进制格式保存，Redis 版本演进过程中有多个格式的 RDB 版本，存在老版本 Redis 服务无法兼容新版 RDB 格式的问题。</p><hr><h4 id="Q5：AOF-持久化的原理？"><a href="#Q5：AOF-持久化的原理？" class="headerlink" title="Q5：AOF 持久化的原理？"></a>Q5：AOF 持久化的原理？</h4><p>AOF 持久化以独立日志的方式记录每次写命令，重启时再重新执行 AOF 文件中的命令达到恢复数据的目的。AOF 的主要作用是解决了数据持久化的实时性，目前是 Redis 持久化的主流方式。</p><p>开启 AOF 功能需要设置：<code>appendonly yes</code>，默认不开启。保存路径同 RDB 方式一致，通过 dir 配置指定。</p><p>AOF 的工作流程操作：命令写入 append、文件同步 sync、文件重写 rewrite、重启加载 load：</p><ul><li>所有的写入命令会追加到 aof_buf 缓冲区中。 </li><li>AOF 缓冲区根据对应的策略向硬盘做同步操作。 </li><li>随着 AOF 文件越来越大，需要定期对 AOF 文件进行重写，达到压缩的目的。 </li><li>当服务器重启时，可以加载 AOF 文件进行数据恢复。 </li></ul><hr><h4 id="Q6：AOF-命令写入的原理？"><a href="#Q6：AOF-命令写入的原理？" class="headerlink" title="Q6：AOF 命令写入的原理？"></a>Q6：AOF 命令写入的原理？</h4><p>AOF 命令写入的内容直接是文本协议格式，采用文本协议格式的原因：</p><ul><li>文本协议具有很好的兼容性。 </li><li>开启 AOF 后所有写入命令都包含追加操作，直接采用协议格式避免了二次处理开销。 </li><li>文本协议具有可读性，方便直接修改和处理。 </li></ul><p>AOF 把命令追加到缓冲区的原因：</p><p>Redis 使用单线程响应命令，如果每次写 AOF 文件命令都直接追加到硬盘，那么性能完全取决于当前硬盘负载。先写入缓冲区中还有另一个好处，Redis 可以提供多种缓冲区同步硬盘策略，在性能和安全性方面做出平衡。</p><hr><h4 id="Q7：AOF-文件同步的原理？"><a href="#Q7：AOF-文件同步的原理？" class="headerlink" title="Q7：AOF 文件同步的原理？"></a>Q7：AOF 文件同步的原理？</h4><p>Redis 提供了多种 AOF 缓冲区文件同步策略，由参数 <code>appendfsync</code> 控制，不同值的含义如下：</p><ul><li>always：命令写入缓冲区后调用系统 fsync 操作同步到 AOF 文件，fsync 完成后线程返回。每次写入都要同步 AOF，性能较低，不建议配置。</li><li>everysec：命令写入缓冲区后调用系统 write 操作，write 完成后线程返回。fsync 同步文件操作由专门线程每秒调用一次。是建议的策略，也是默认配置，兼顾性能和数据安全。</li><li>no：命令写入缓冲区后调用系统 write 操作，不对 AOF 文件做 fsync 同步，同步硬盘操作由操作系统负责，周期通常最长 30 秒。由于操作系统每次同步 AOF 文件的周期不可控，而且会加大每次同步硬盘的数据量，虽然提升了性能，但安全性无法保证。</li></ul><hr><h4 id="Q8：AOF-文件重写的原理？"><a href="#Q8：AOF-文件重写的原理？" class="headerlink" title="Q8：AOF 文件重写的原理？"></a>Q8：AOF 文件重写的原理？</h4><p>文件重写是把 Redis 进程内的数据转化为写命令同步到新 AOF 文件的过程，可以降低文件占用空间，更小的文件可以更快地被加载。</p><p>重写后 AOF 文件变小的原因：</p><ul><li>进程内已经超时的数据不再写入文件。 </li><li>旧的 AOF 文件含有无效命令，重写使用进程内数据直接生成，这样新的 AOF 文件只保留最终数据写入命令。 </li><li>多条写命令可以合并为一个，为了防止单条命令过大造成客户端缓冲区溢出，对于 list、set、hash、zset 等类型操作，以 64 个元素为界拆分为多条。 </li></ul><p>AOF 重写分为手动触发和自动触发，手动触发直接调用 bgrewriteaof 命令，自动触发根据 <code>auto-aof-rewrite-min-size</code> 和  <code>auto-aof-rewrite-percentage</code> 参数确定自动触发时机。</p><p>重写流程：</p><p>① 执行 AOF 重写请求，如果当前进程正在执行 AOF 重写，请求不执行并返回，如果当前进程正在执行 bgsave 操作，重写命令延迟到 bgsave 完成之后再执行。</p><p>② 父进程执行 fork 创建子进程，开销等同于 bgsave 过程。</p><p>③ 父进程 fork 操作完成后继续响应其他命令，所有修改命令依然写入 AOF 缓冲区并同步到硬盘，保证原有 AOF 机制正确性。</p><p>④ 子进程根据内存快照，按命令合并规则写入到新的 AOF 文件。每次批量写入数据量默认为 32 MB，防止单次刷盘数据过多造成阻塞。</p><p>⑤ 新 AOF 文件写入完成后，子进程发送信号给父进程，父进程更新统计信息。</p><p>⑥ 父进程把 AOF 重写缓冲区的数据写入到新的 AOF 文件并替换旧文件，完成重写。</p><hr><h4 id="Q9：AOF-重启加载的原理？"><a href="#Q9：AOF-重启加载的原理？" class="headerlink" title="Q9：AOF 重启加载的原理？"></a>Q9：AOF 重启加载的原理？</h4><p>AOF 和 RDB 文件都可以用于服务器重启时的数据恢复。Redis 持久化文件的加载流程：</p><p>① AOF 持久化开启且存在 AOF 文件时，优先加载 AOF 文件。</p><p>② AOF 关闭时且存在 RDB 文件时，记载 RDB 文件。</p><p>③ 加载 AOF/RDB 文件成功后，Redis 启动成功。</p><p>④ AOF/RDB 文件存在错误导致加载失败时，Redis 启动失败并打印错误信息。</p>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;Java面试常见问题汇总&quot;&gt;&lt;a href=&quot;#Java面试常见问题汇总&quot; class=&quot;headerlink&quot; title=&quot;Java面试常见问题汇总&quot;&gt;&lt;/a&gt;Java面试常见问题汇总&lt;/h2&gt;&lt;h3 id=&quot;语言特性-12&quot;&gt;&lt;a href=&quot;#语言特性-12&quot; class=&quot;headerlink&quot; title=&quot;语言特性 12&quot;&gt;&lt;/a&gt;语言特性 12&lt;/h3&gt;&lt;h4 id=&quot;Q1：Java-语言的优点？&quot;&gt;&lt;a href=&quot;#Q1：Java-语言的优点？&quot; class=&quot;headerlink&quot; title=&quot;Q1：Java 语言的优点？&quot;&gt;&lt;/a&gt;Q1：Java 语言的优点？&lt;/h4&gt;&lt;p&gt;① 平台无关性，摆脱硬件束缚，”一次编写，到处运行”。&lt;/p&gt;
&lt;p&gt;② 相对安全的内存管理和访问机制，避免大部分内存泄漏和指针越界。&lt;/p&gt;
&lt;p&gt;③ 热点代码检测和运行时编译及优化，使程序随运行时间增长获得更高性能。&lt;/p&gt;
&lt;p&gt;④ 完善的应用程序接口，支持第三方类库。&lt;/p&gt;
&lt;hr&gt;
&lt;h4 id=&quot;Q2：Java-如何实现平台无关？&quot;&gt;&lt;a href=&quot;#Q2：Java-如何实现平台无关？&quot; class=&quot;headerlink&quot; title=&quot;Q2：Java 如何实现平台无关？&quot;&gt;&lt;/a&gt;Q2：Java 如何实现平台无关？&lt;/h4&gt;&lt;p&gt;&lt;strong&gt;JVM：&lt;/strong&gt; Java 编译器可生成与计算机体系结构无关的字节码指令，字节码文件不仅可以轻易地在任何机器上解释执行，还可以动态地转换成本地机器代码，转换是由 JVM 实现的，JVM 是平台相关的，屏蔽了不同操作系统的差异。&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;语言规范：&lt;/strong&gt; 基本数据类型大小有明确规定，例如 int 永远为 32 位，而 C/C++ 中可能是 16 位、32 位，也可能是编译器开发商指定的其他大小。Java 中数值类型有固定字节数，二进制数据以固定格式存储和传输，字符串采用标准的 Unicode 格式存储。&lt;/p&gt;
&lt;hr&gt;
    
    </summary>
    
    
      <category term="面试" scheme="https://zrbac.github.io/categories/%E9%9D%A2%E8%AF%95/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>http相关内容</title>
    <link href="https://zrbac.github.io/2020/08/23/http%E7%9B%B8%E5%85%B3%E5%86%85%E5%AE%B9/"/>
    <id>https://zrbac.github.io/2020/08/23/http%E7%9B%B8%E5%85%B3%E5%86%85%E5%AE%B9/</id>
    <published>2020-08-23T07:36:35.000Z</published>
    <updated>2020-08-23T07:38:28.921Z</updated>
    
    <content type="html"><![CDATA[<h1 id="HTTP相关内容"><a href="#HTTP相关内容" class="headerlink" title="HTTP相关内容"></a>HTTP相关内容</h1><h2 id="HTTP-和-HTTPS-的区别"><a href="#HTTP-和-HTTPS-的区别" class="headerlink" title="HTTP 和 HTTPS 的区别"></a>HTTP 和 HTTPS 的区别</h2><p>HTTP 是一种 <code>超文本传输协议(Hypertext Transfer Protocol)</code>，<strong>HTTP 是一个在计算机世界里专门在两点之间传输文字、图片、音频、视频等超文本数据的约定和规范</strong></p><p><img src="http://qiniu.zrbac.fun/1.png" alt="img"></p><p>HTTP 主要内容分为三部分，<strong>超文本（Hypertext）、传输（Transfer）、协议（Protocol）</strong>。</p><ul><li>超文本就是不单单只是本文，它还可以传输图片、音频、视频，甚至点击文字或图片能够进行<code>超链接</code>的跳转。</li><li>上面这些概念可以统称为数据，传输就是数据需要经过一系列的物理介质从一个端系统传送到另外一个端系统的过程。通常我们把传输数据包的一方称为<code>请求方</code>，把接到二进制数据包的一方称为<code>应答方</code>。</li><li>而协议指的就是是网络中(包括互联网)传递、管理信息的一些规范。如同人与人之间相互交流是需要遵循一定的规矩一样，计算机之间的相互通信需要共同遵守一定的规则，这些规则就称为协议，只不过是网络协议。</li></ul><a id="more"></a><p>说到 HTTP，不得不提的就是 TCP/IP 网络模型，一般是五层模型。如下图所示</p><p><img src="http://qiniu.zrbac.fun/2.png" alt="img"></p><p>但是也可以分为四层，就是<strong>把链路层和物理层都表示为网络接口层</strong></p><p><img src="http://qiniu.zrbac.fun/3.png" alt="img"></p><p>还有一种就是 OSI 七层网络模型，它就是在五层协议之上加了<strong>表示层和会话层</strong></p><p><img src="http://qiniu.zrbac.fun/4.png" alt="img"></p><p>而 HTTPS 的全称是 <code>Hypertext Transfer Protocol Secure</code>，从名称我们可以看出 HTTPS 要比 HTTPS 多了 secure 安全性这个概念，实际上， HTTPS 并不是一个新的应用层协议，它其实就是 HTTP + TLS/SSL 协议组合而成，而安全性的保证正是 TLS/SSL 所做的工作。</p><p>也就是说，<strong>HTTPS 就是身披了一层 SSL 的 HTTP</strong>。</p><p><img src="http://qiniu.zrbac.fun/5.png" alt="img"></p><p>那么，HTTP 和 HTTPS 的主要区别是什么呢？</p><ul><li>最简单的，HTTP 在地址栏上的协议是以 <code>http://</code> 开头，而 HTTPS 在地址栏上的协议是以 <code>https://</code> 开头</li></ul><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">http://www.cxuanblog.com/https://www.cxuanblog.com/</span><br></pre></td></tr></table></figure><ul><li>HTTP 是未经安全加密的协议，它的传输过程容易被攻击者监听、数据容易被窃取、发送方和接收方容易被伪造；而 HTTPS 是安全的协议，它通过 <strong>密钥交换算法 - 签名算法 - 对称加密算法 - 摘要算法</strong> 能够解决上面这些问题。</li></ul><p><img src="http://qiniu.zrbac.fun/6.png" alt="img"></p><ul><li>HTTP 的默认端口是 80，而 HTTPS 的默认端口是 443。</li></ul><h2 id="HTTP-Get-和-Post-区别"><a href="#HTTP-Get-和-Post-区别" class="headerlink" title="HTTP Get 和 Post 区别"></a>HTTP Get 和 Post 区别</h2><p>HTTP 中包括许多方法，<strong>Get 和 Post 是 HTTP 中最常用的两个方法</strong>，基本上使用 HTTP 方法中有 99% 都是在使用 Get 方法和 Post 方法，所以有必要我们对这两个方法有更加深刻的认识。</p><ul><li><p>get 方法一般用于请求，比如你在浏览器地址栏输入 <code>www.cxuanblog.com</code> 其实就是发送了一个 get 请求，它的主要特征是请求服务器返回资源，而 post 方法一般用于``</p><p><code>表单</code>的提交，相当于是把信息提交给服务器，等待服务器作出响应，get 相当于一个是 pull/拉的操作，而 post 相当于是一个 push/推的操作。</p></li><li><p>get 方法是不安全的，因为你在发送请求的过程中，你的请求参数会拼在 URL 后面，从而导致容易被攻击者窃取，对你的信息造成破坏和伪造；</p></li></ul><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">/test/demo_form.asp?name1=value1&amp;name2=value2</span><br></pre></td></tr></table></figure><p>而 post 方法是把参数放在请求体 body 中的，这对用户来说不可见。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">POST /test/demo_form.asp HTTP/1.1Host: w3schools.comname1=value1&amp;name2=value2</span><br></pre></td></tr></table></figure><ul><li>get 请求的 URL 有长度限制，而 post 请求会把参数和值放在消息体中，对数据长度没有要求。</li><li>get 请求会被浏览器主动 cache，而 post 不会，除非手动设置。</li><li>get 请求在浏览器反复的 <code>回退/前进</code> 操作是无害的，而 post 操作会再次提交表单请求。</li><li>get 请求在发送过程中会产生一个 TCP 数据包；post 在发送过程中会产生两个 TCP 数据包。对于 get 方式的请求，浏览器会把 http header 和 data 一并发送出去，服务器响应 200（返回数据）；而对于 post，浏览器先发送 header，服务器响应 100 continue，浏览器再发送 data，服务器响应 200 ok（返回数据）。</li></ul><h2 id="什么是无状态协议，HTTP-是无状态协议吗，怎么解决"><a href="#什么是无状态协议，HTTP-是无状态协议吗，怎么解决" class="headerlink" title="什么是无状态协议，HTTP 是无状态协议吗，怎么解决"></a>什么是无状态协议，HTTP 是无状态协议吗，怎么解决</h2><p><code>无状态协议(Stateless Protocol)</code> 就是指<strong>浏览器对于事务的处理没有记忆能力</strong>。举个例子来说就是比如客户请求获得网页之后关闭浏览器，然后再次启动浏览器，登录该网站，但是服务器并不知道客户关闭了一次浏览器。</p><p>HTTP 就是一种无状态的协议，他对用户的操作没有记忆能力。可能大多数用户不相信，他可能觉得每次输入用户名和密码登陆一个网站后，下次登陆就不再重新输入用户名和密码了。这其实不是 HTTP 做的事情，起作用的是一个叫做 <code>小甜饼(Cookie)</code> 的机制。它能够让浏览器具有<code>记忆</code>能力。</p><p>如果你的浏览器允许 cookie 的话，查看方式 <strong>chrome://settings/content/cookies</strong></p><p><img src="http://qiniu.zrbac.fun/7.png" alt="img"></p><p>也就说明你的记忆芯片通电了…… 当你向服务端发送请求时，服务端会给你发送一个认证信息，服务器第一次接收到请求时，开辟了一块 Session 空间（创建了Session对象），同时生成一个 sessionId ，并通过响应头的 Set-Cookie：JSESSIONID=XXXXXXX 命令，向客户端发送要求设置 Cookie 的响应；客户端收到响应后，在本机客户端设置了一个 JSESSIONID=XXXXXXX 的 Cookie 信息，该 Cookie 的过期时间为浏览器会话结束；</p><p><img src="http://qiniu.zrbac.fun/8.png" alt="img"></p><p>接下来客户端每次向同一个网站发送请求时，请求头都会带上该 Cookie信息（包含 sessionId ）， 然后，服务器通过读取请求头中的 Cookie 信息，获取名称为 JSESSIONID 的值，得到此次请求的 sessionId。这样，你的浏览器才具有了记忆能力。</p><p><img src="http://qiniu.zrbac.fun/9.png" alt="img"></p><p>还有一种方式是使用 JWT 机制，它也是能够让你的浏览器具有记忆能力的一种机制。与 Cookie 不同，JWT 是保存在客户端的信息，它广泛的应用于单点登录的情况。JWT 具有两个特点</p><ul><li>JWT 的 Cookie 信息存储在<code>客户端</code>，而不是服务端内存中。也就是说，JWT 直接本地进行验证就可以，验证完毕后，这个 Token 就会在 Session 中随请求一起发送到服务器，通过这种方式，可以节省服务器资源，并且 token 可以进行多次验证。</li><li>JWT 支持跨域认证，Cookies 只能用在<code>单个节点的域</code>或者它的<code>子域</code>中有效。如果它们尝试通过第三个节点访问，就会被禁止。使用 JWT 可以解决这个问题，使用 JWT 能够通过<code>多个节点</code>进行用户认证，也就是我们常说的<code>跨域认证</code>。</li></ul><h2 id="UDP-和-TCP-的区别"><a href="#UDP-和-TCP-的区别" class="headerlink" title="UDP 和 TCP 的区别"></a>UDP 和 TCP 的区别</h2><p>TCP 和 UDP 都位于计算机网络模型中的运输层，它们负责传输应用层产生的数据。下面我们就来聊一聊 TCP 和 UDP 分别的特征和他们的区别</p><h3 id="UDP-是什么"><a href="#UDP-是什么" class="headerlink" title="UDP 是什么"></a>UDP 是什么</h3><p>UDP 的全称是 <code>User Datagram Protocol</code>，用户数据报协议。它不需要所谓的<code>握手</code>操作，从而加快了通信速度，允许网络上的其他主机在接收方同意通信之前进行数据传输。</p><blockquote><p>数据报是与分组交换网络关联的传输单元。</p></blockquote><p>UDP 的特点主要有</p><ul><li>UDP 能够支持容忍数据包丢失的带宽密集型应用程序</li><li>UDP 具有低延迟的特点</li><li>UDP 能够发送大量的数据包</li><li>UDP 能够允许 DNS 查找，DNS 是建立在 UDP 之上的应用层协议。</li></ul><h3 id="TCP-是什么"><a href="#TCP-是什么" class="headerlink" title="TCP 是什么"></a>TCP 是什么</h3><p>TCP 的全称是<code>Transmission Control Protocol</code> ，传输控制协议。它能够帮助你确定计算机连接到 Internet 以及它们之间的数据传输。通过三次握手来建立 TCP 连接，三次握手就是用来启动和确认 TCP 连接的过程。一旦连接建立后，就可以发送数据了，当数据传输完成后，会通过关闭虚拟电路来断开连接。</p><p>TCP 的主要特点有</p><ul><li>TCP 能够确保连接的建立和数据包的发送</li><li>TCP 支持错误重传机制</li><li>TCP 支持拥塞控制，能够在网络拥堵的情况下延迟发送</li><li>TCP 能够提供错误校验和，甄别有害的数据包。</li></ul><h3 id="TCP-和-UDP-的不同"><a href="#TCP-和-UDP-的不同" class="headerlink" title="TCP 和 UDP 的不同"></a>TCP 和 UDP 的不同</h3><p><img src="http://qiniu.zrbac.fun/10.png" alt="img"></p><p>下面为你罗列了一些 TCP 和 UDP 的不同点，方便理解，方便记忆。</p><p><img src="http://qiniu.zrbac.fun/11.png" alt="img"></p><h2 id="TCP-三次握手和四次挥手"><a href="#TCP-三次握手和四次挥手" class="headerlink" title="TCP 三次握手和四次挥手"></a>TCP 三次握手和四次挥手</h2><p>TCP 三次握手和四次挥手也是面试题的热门考点，它们分别对应 TCP 的连接和释放过程。下面就来简单认识一下这两个过程</p><h3 id="TCP-三次握手"><a href="#TCP-三次握手" class="headerlink" title="TCP 三次握手"></a>TCP 三次握手</h3><p>在了解具体的流程前，我们需要先认识几个概念</p><p><img src="http://qiniu.zrbac.fun/12.png" alt="img"></p><ul><li>SYN：它的全称是 <code>Synchronize Sequence Numbers</code>，同步序列编号。是 TCP/IP 建立连接时使用的握手信号。在客户机和服务器之间建立 TCP 连接时，首先会发送的一个信号。客户端在接受到 SYN 消息时，就会在自己的段内生成一个随机值 X。</li><li>SYN-ACK：服务器收到 SYN 后，打开客户端连接，发送一个 SYN-ACK 作为答复。确认号设置为比接收到的序列号多一个，即 X + 1，服务器为数据包选择的序列号是另一个随机数 Y。</li><li>ACK：<code>Acknowledge character</code>, 确认字符，表示发来的数据已确认接收无误。最后，客户端将 ACK 发送给服务器。序列号被设置为所接收的确认值即 Y + 1。</li></ul><p><img src="http://qiniu.zrbac.fun/13.png" alt="img"></p><p>如果用现实生活来举例的话就是</p><p>小明 - 客户端 小红 - 服务端</p><ul><li>小明给小红打电话，接通了后，小明说<strong>喂，能听到吗</strong>，这就相当于是连接建立。</li><li>小红给小明回应，<strong>能听到，你能听到我说的话吗</strong>，这就相当于是请求响应。</li><li>小明听到小红的回应后，<strong>好的</strong>，这相当于是连接确认。在这之后小明和小红就可以通话/交换信息了。</li></ul><h3 id="TCP-四次挥手"><a href="#TCP-四次挥手" class="headerlink" title="TCP 四次挥手"></a>TCP 四次挥手</h3><p>在连接终止阶段使用四次挥手，连接的每一端都会独立的终止。下面我们来描述一下这个过程。</p><p><img src="http://qiniu.zrbac.fun/14.png" alt="img"></p><ul><li>首先，客户端应用程序决定要终止连接(这里服务端也可以选择断开连接)。这会使客户端将 FIN 发送到服务器，并进入 <code>FIN_WAIT_1</code> 状态。当客户端处于 FIN_WAIT_1 状态时，它会等待来自服务器的 ACK 响应。</li><li>然后第二步，当服务器收到 FIN 消息时，服务器会立刻向客户端发送 ACK 确认消息。</li><li>当客户端收到服务器发送的 ACK 响应后，客户端就进入 <code>FIN_WAIT_2</code> 状态，然后等待来自服务器的 <code>FIN</code> 消息</li><li>服务器发送 ACK 确认消息后，一段时间（可以进行关闭后）会发送 FIN 消息给客户端，告知客户端可以进行关闭。</li><li>当客户端收到从服务端发送的 FIN 消息时，客户端就会由 FIN_WAIT_2 状态变为 <code>TIME_WAIT</code> 状态。处于 TIME_WAIT 状态的客户端允许重新发送 ACK 到服务器为了防止信息丢失。客户端在 TIME_WAIT 状态下花费的时间取决于它的实现，在等待一段时间后，连接关闭，客户端上所有的资源（包括端口号和缓冲区数据）都被释放。</li></ul><p>还是可以用上面那个通话的例子来进行描述</p><ul><li>小明对小红说，我所有的东西都说完了，我要挂电话了。</li><li>小红说，收到，我这边还有一些东西没说。</li><li>经过若干秒后，小红也说完了，小红说，我说完了，现在可以挂断了</li><li>小明收到消息后，又等了若干时间后，挂断了电话。</li></ul><h2 id="简述-HTTP1-0-1-1-2-0-的区别"><a href="#简述-HTTP1-0-1-1-2-0-的区别" class="headerlink" title="简述 HTTP1.0/1.1/2.0 的区别"></a>简述 HTTP1.0/1.1/2.0 的区别</h2><h3 id="HTTP-1-0"><a href="#HTTP-1-0" class="headerlink" title="HTTP 1.0"></a>HTTP 1.0</h3><p>HTTP 1.0 是在 1996 年引入的，从那时开始，它的普及率就达到了惊人的效果。</p><ul><li>HTTP 1.0 仅仅提供了最基本的认证，这时候用户名和密码还未经加密，因此很容易收到窥探。</li><li>HTTP 1.0 被设计用来使用短链接，即每次发送数据都会经过 TCP 的三次握手和四次挥手，效率比较低。</li><li>HTTP 1.0 只使用 header 中的 If-Modified-Since 和 Expires 作为缓存失效的标准。</li><li>HTTP 1.0 不支持断点续传，也就是说，每次都会传送全部的页面和数据。</li><li>HTTP 1.0 认为每台计算机只能绑定一个 IP，所以请求消息中的 URL 并没有传递主机名（hostname）。</li></ul><h3 id="HTTP-1-1"><a href="#HTTP-1-1" class="headerlink" title="HTTP 1.1"></a>HTTP 1.1</h3><p>HTTP 1.1 是 HTTP 1.0 开发三年后出现的，也就是 1999 年，它做出了以下方面的变化</p><ul><li>HTTP 1.1 使用了摘要算法来进行身份验证</li><li>HTTP 1.1 默认使用长连接，长连接就是只需一次建立就可以传输多次数据，传输完成后，只需要一次切断连接即可。长连接的连接时长可以通过请求头中的 <code>keep-alive</code> 来设置</li><li>HTTP 1.1 中新增加了 E-tag，If-Unmodified-Since, If-Match, If-None-Match 等缓存控制标头来控制缓存失效。</li><li>HTTP 1.1 支持断点续传，通过使用请求头中的 <code>Range</code> 来实现。</li><li>HTTP 1.1 使用了虚拟网络，在一台物理服务器上可以存在多个虚拟主机（Multi-homed Web Servers），并且它们共享一个IP地址。</li></ul><h3 id="HTTP-2-0"><a href="#HTTP-2-0" class="headerlink" title="HTTP 2.0"></a>HTTP 2.0</h3><p>HTTP 2.0 是 2015 年开发出来的标准，它主要做的改变如下</p><ul><li><code>头部压缩</code>，由于 HTTP 1.1 经常会出现 <strong>User-Agent、Cookie、Accept、Server、Range</strong> 等字段可能会占用几百甚至几千字节，而 Body 却经常只有几十字节，所以导致头部偏重。HTTP 2.0 使用 <code>HPACK</code> 算法进行压缩。</li><li><code>二进制格式</code>，HTTP 2.0 使用了更加靠近 TCP/IP 的二进制格式，而抛弃了 ASCII 码，提升了解析效率</li><li><code>强化安全</code>，由于安全已经成为重中之重，所以 HTTP2.0 一般都跑在 HTTPS 上。</li><li><code>多路复用</code>，即每一个请求都是是用作连接共享。一个请求对应一个id，这样一个连接上可以有多个请求。</li></ul><p><img src="http://qiniu.zrbac.fun/15.png" alt="img"></p><h2 id="请你说一下-HTTP-常见的请求头"><a href="#请你说一下-HTTP-常见的请求头" class="headerlink" title="请你说一下 HTTP 常见的请求头"></a>请你说一下 HTTP 常见的请求头</h2><p>这个问题比较开放，因为 HTTP 请求头有很多，这里只简单举出几个例子。</p><p>HTTP 标头会分为四种，分别是 <code>通用标头</code>、<code>实体标头</code>、<code>请求标头</code>、<code>响应标头</code>。分别介绍一下</p><h3 id="通用标头"><a href="#通用标头" class="headerlink" title="通用标头"></a>通用标头</h3><p>通用标头主要有三个，分别是 <code>Date</code>、<code>Cache-Control</code> 和 <code>Connection</code></p><p><strong>Date</strong></p><p>Date 是一个通用标头，它可以出现在请求标头和响应标头中，它的基本表示如下</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Date: Wed, 21 Oct 2015 07:28:00 GMT</span><br></pre></td></tr></table></figure><p>表示的是格林威治标准时间，这个时间要比北京时间慢八个小时</p><p><img src="http://qiniu.zrbac.fun/16.png" alt="img"></p><p><strong>Cache-Control</strong></p><p>Cache-Control 是一个通用标头，他可以出现在<code>请求标头</code>和<code>响应标头</code>中，Cache-Control 的种类比较多，虽然说这是一个通用标头，但是有一些特性是请求标头具有的，有一些是响应标头才有的。主要大类有 <code>可缓存性</code>、<code>阈值性</code>、 <code>重新验证并重新加载</code> 和<code>其他特性</code></p><p><strong>Connection</strong></p><p>Connection 决定当前事务（一次三次握手和四次挥手）完成后，是否会关闭网络连接。Connection 有两种，一种是<code>持久性连接</code>，即一次事务完成后不关闭网络连接</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Connection: keep-alive</span><br></pre></td></tr></table></figure><p>另一种是<code>非持久性连接</code>，即一次事务完成后关闭网络连接</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Connection: close</span><br></pre></td></tr></table></figure><p>HTTP1.1 其他通用标头如下</p><p><img src="http://qiniu.zrbac.fun/17.png" alt="img"></p><h3 id="实体标头"><a href="#实体标头" class="headerlink" title="实体标头"></a>实体标头</h3><p>实体标头是描述消息正文内容的 HTTP 标头。实体标头用于 HTTP 请求和响应中。头部<code>Content-Length</code>、 <code>Content-Language</code>、 <code>Content-Encoding</code> 是实体头。</p><ul><li><p>Content-Length 实体报头指示实体主体的大小，以字节为单位，发送到接收方。</p></li><li><p>Content-Language 实体报头描述了客户端或者服务端能够接受的语言。</p></li><li><p>Content-Encoding 这又是一个比较麻烦的属性，这个实体报头用来压缩媒体类型。Content-Encoding 指示对实体应用了何种编码。</p><p>常见的内容编码有这几种： <strong>gzip、compress、deflate、identity</strong> ，这个属性可以应用在请求报文和响应报文中</p></li></ul><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Accept-Encoding: gzip, deflate //请求头Content-Encoding: gzip  //响应头</span><br></pre></td></tr></table></figure><p>下面是一些实体标头字段</p><p><img src="http://qiniu.zrbac.fun/18.png" alt="img"></p><h3 id="请求标头"><a href="#请求标头" class="headerlink" title="请求标头"></a>请求标头</h3><p><strong>Host</strong></p><p>Host 请求头指明了服务器的域名（对于虚拟主机来说），以及（可选的）服务器监听的 TCP 端口号。如果没有给定端口号，会自动使用被请求服务的默认端口（比如请求一个 HTTP 的 URL 会自动使用 80 作为端口）。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Host: developer.mozilla.org</span><br></pre></td></tr></table></figure><p>上面的 <code>Accpet</code>、 <code>Accept-Language</code>、<code>Accept-Encoding</code> 都是属于内容协商的请求标头。</p><p><strong>Referer</strong></p><p>HTTP Referer 属性是请求标头的一部分，当浏览器向 web 服务器发送请求的时候，一般会带上 Referer，告诉服务器该网页是从哪个页面链接过来的，服务器因此可以获得一些信息用于处理。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Referer: https://developer.mozilla.org/testpage.html</span><br></pre></td></tr></table></figure><p><strong>If-Modified-Since</strong></p><p>If-Modified-Since 通常会与 If-None-Match 搭配使用，If-Modified-Since 用于确认代理或客户端拥有的本地资源的有效性。获取资源的更新日期时间，可通过确认首部字段 <code>Last-Modified</code> 来确定。</p><p>大白话说就是如果在 <code>Last-Modified</code> 之后更新了服务器资源，那么服务器会响应 200，如果在 <code>Last-Modified</code> 之后没有更新过资源，则返回 304。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">If-Modified-Since: Mon, 18 Jul 2016 02:36:04 GMT</span><br></pre></td></tr></table></figure><p><strong>If-None-Match</strong></p><p>If-None-Match HTTP 请求标头使请求成为条件请求。对于 GET 和 HEAD 方法，仅当服务器没有与给定资源匹配的 <code>ETag</code> 时，服务器才会以 200 状态发送回请求的资源。对于其他方法，仅当最终现有资源的<code>ETag</code>与列出的任何值都不匹配时，才会处理请求。</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">If-None-Match: &quot;c561c68d0ba92bbeb8b0fff2a9199f722e3a621a&quot;</span><br></pre></td></tr></table></figure><p><strong>Accept</strong></p><p>接受请求 HTTP 标头会通告客户端其能够理解的 MIME 类型</p><p><strong>Accept-Charset</strong></p><p>accept-charset 属性规定服务器处理表单数据所接受的字符集。</p><p>常用的字符集有：UTF-8 - Unicode 字符编码 ；ISO-8859-1 - 拉丁字母表的字符编码</p><p><strong>Accept-Language</strong></p><p>首部字段 Accept-Language 用来告知服务器用户代理能够处理的自然语言集（指中文或英文等），以及自然语言集的相对优先级。可一次指定多种自然语言集。</p><p>请求标头我们大概就介绍这几种，后面会有一篇文章详细深挖所有的响应头的，下面是一个响应头的汇总，基于 HTTP 1.1</p><p><img src="http://qiniu.zrbac.fun/19.png" alt="img"></p><h3 id="响应标头"><a href="#响应标头" class="headerlink" title="响应标头"></a>响应标头</h3><p><strong>Access-Control-Allow-Origin</strong></p><p>一个返回的 HTTP 标头可能会具有 Access-Control-Allow-Origin ，<code>Access-Control-Allow-Origin</code> 指定一个来源，它告诉浏览器允许该来源进行资源访问。</p><p><strong>Keep-Alive</strong></p><p>Keep-Alive 表示的是 Connection 非持续连接的存活时间，可以进行指定。</p><p><strong>Server</strong></p><p>服务器标头包含有关原始服务器用来处理请求的软件的信息。</p><p>应该避免使用过于冗长和详细的 Server 值，因为它们可能会泄露内部实施细节，这可能会使攻击者容易地发现并利用已知的安全漏洞。例如下面这种写法</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">Server: Apache/2.4.1 (Unix)</span><br></pre></td></tr></table></figure><p><strong>Set-Cookie</strong></p><p>Set-Cookie 用于服务器向客户端发送 sessionID。</p><p><strong>Transfer-Encoding</strong></p><p>首部字段 Transfer-Encoding 规定了传输报文主体时采用的编码方式。</p><p>HTTP /1.1 的传输编码方式仅对分块传输编码有效。</p><p><strong>X-Frame-Options</strong></p><p>HTTP 首部字段是可以自行扩展的。所以在 Web 服务器和浏览器的应用上，会出现各种非标准的首部字段。</p><p>首部字段 <code>X-Frame-Options</code> 属于 HTTP 响应首部，用于控制网站内容在其他 Web 网站的 Frame 标签内的显示问题。其主要目的是为了防止点击劫持（clickjacking）攻击。</p><p>下面是一个响应头的汇总，基于 HTTP 1.1</p><p><img src="http://qiniu.zrbac.fun/20.png" alt="img"></p><h2 id="地址栏输入-URL-发生了什么"><a href="#地址栏输入-URL-发生了什么" class="headerlink" title="地址栏输入 URL 发生了什么"></a>地址栏输入 URL 发生了什么</h2><p>这道题也是一道经常会考的面试题。那么下面我们就来探讨一下从你输入 URL 后到响应，都经历了哪些过程。</p><ul><li>首先，你需要在浏览器中的 URL 地址上，输入你想访问的地址，如下</li></ul><p><img src="http://qiniu.zrbac.fun/21.png" alt="img"></p><p>你应该访问不到的，对不对~</p><ul><li>然后，浏览器会根据你输入的 URL 地址，去查找域名是否被本地 DNS 缓存，不同浏览器对 DNS 的设置不同，如果浏览器缓存了你想访问的 URL 地址，那就直接返回 ip。如果没有缓存你的 URL 地址，浏览器就会发起系统调用来查询本机 <code>hosts</code> 文件是否有配置 ip 地址，如果找到，直接返回。如果找不到，就向网络中发起一个 DNS 查询。</li></ul><blockquote><p>首先来看一下 DNS 是啥，互联网中识别主机的方式有两种，通过<code>主机名</code>和 <code>IP 地址</code>。我们人喜欢用名字的方式进行记忆，但是通信链路中的路由却喜欢定长、有层次结构的 IP 地址。所以就需要一种能够把主机名到 IP 地址的转换服务，这种服务就是由 DNS 提供的。DNS 的全称是 <code>Domain Name System</code> 域名系统。DNS 是一种由分层的 DNS 服务器实现的分布式数据库。DNS 运行在 UDP 上，使用 53 端口。</p><p><img src="http://qiniu.zrbac.fun/22.png" alt="img"></p></blockquote><p>DNS 是一种分层数据库，它的主要层次结构如下</p><p><img src="http://qiniu.zrbac.fun/23.png" alt="img"></p><p>一般域名服务器的层次结构主要是以上三种，除此之外，还有另一类重要的 DNS 服务器，它是 <code>本地 DNS 服务器(local DNS server)</code>。严格来说，本地 DNS 服务器并不属于上述层次结构，但是本地 DNS 服务器又是至关重要的。每个 <code>ISP(Internet Service Provider)</code> 比如居民区的 ISP 或者一个机构的 ISP 都有一台本地 DNS 服务器。当主机和 ISP 进行连接时，该 ISP 会提供一台主机的 IP 地址，该主机会具有一台或多台其本地 DNS 服务器的 IP地址。通过访问网络连接，用户能够容易的确定 DNS 服务器的 IP地址。当主机发出 DNS 请求后，该请求被发往本地 DNS 服务器，它起着代理的作用，并将该请求转发到 DNS 服务器层次系统中。</p><p>首先，查询请求会先找到本地 DNS 服务器来查询是否包含 IP 地址，如果本地 DNS 无法查询到目标 IP 地址，就会向根域名服务器发起一个 DNS 查询。</p><blockquote><p>注意：DNS 涉及两种查询方式：一种是<code>递归查询(Recursive query)</code> ，一种是<code>迭代查询(Iteration query)</code>。《计算机网络：自顶向下方法》竟然没有给出递归查询和迭代查询的区别，找了一下网上的资料大概明白了下。</p><p>如果根域名服务器无法告知本地 DNS 服务器下一步需要访问哪个顶级域名服务器，就会使用递归查询；</p><p>如果根域名服务器能够告知 DNS 服务器下一步需要访问的顶级域名服务器，就会使用迭代查询。</p></blockquote><p>在由根域名服务器 -&gt; 顶级域名服务器 -&gt; 权威 DNS 服务器后，由权威服务器告诉本地服务器目标 IP 地址，再有本地 DNS 服务器告诉用户需要访问的 IP 地址。</p><ul><li>第三步，浏览器需要和目标服务器建立 TCP 连接，需要经过三次握手的过程，具体的握手过程请参考上面的回答。</li><li>在建立连接后，浏览器会向目标服务器发起 <code>HTTP-GET</code> 请求，包括其中的 URL，HTTP 1.1 后默认使用长连接，只需要一次握手即可多次传输数据。</li><li>如果目标服务器只是一个简单的页面，就会直接返回。但是对于某些大型网站的站点，往往不会直接返回主机名所在的页面，而会直接重定向。返回的状态码就不是 200 ，而是 301,302 以 3 开头的重定向码，浏览器在获取了重定向响应后，在响应报文中 Location 项找到重定向地址，浏览器重新第一步访问即可。</li><li>然后浏览器重新发送请求，携带新的 URL，返回状态码 200 OK，表示服务器可以响应请求，返回报文。</li></ul><h2 id="HTTPS-的工作原理"><a href="#HTTPS-的工作原理" class="headerlink" title="HTTPS 的工作原理"></a>HTTPS 的工作原理</h2><p>我们上面描述了一下 HTTP 的工作原理，下面来讲述一下 HTTPS 的工作原理。因为我们知道 HTTPS 不是一种新出现的协议，而是</p><p><img src="http://qiniu.zrbac.fun/24.png" alt="img"></p><p>所以，我们探讨 HTTPS 的握手过程，其实就是 SSL/TLS 的握手过程。</p><p>TLS 旨在为 Internet 提供通信安全的加密协议。TLS 握手是启动和使用 TLS 加密的通信会话的过程。在 TLS 握手期间，Internet 中的通信双方会彼此交换信息，验证密码套件，交换会话密钥。</p><p>每当用户通过 HTTPS 导航到具体的网站并发送请求时，就会进行 TLS 握手。除此之外，每当其他任何通信使用HTTPS（包括 API 调用和在 HTTPS 上查询 DNS）时，也会发生 TLS 握手。</p><p>TLS 具体的握手过程会根据所使用的<code>密钥交换算法的类型</code>和双方支持的<code>密码套件</code>而不同。我们以<code>RSA 非对称加密</code>来讨论这个过程。整个 TLS 通信流程图如下</p><p><img src="http://qiniu.zrbac.fun/25.png" alt="img"></p><ul><li>在进行通信前，首先会进行 HTTP 的三次握手，握手完成后，再进行 TLS 的握手过程</li><li>ClientHello：客户端通过向服务器发送 <code>hello</code> 消息来发起握手过程。这个消息中会夹带着客户端支持的 <code>TLS 版本号(TLS1.0 、TLS1.2、TLS1.3)</code> 、客户端支持的密码套件、以及一串 <code>客户端随机数</code>。</li><li>ServerHello：在客户端发送 hello 消息后，服务器会发送一条消息，这条消息包含了服务器的 SSL 证书、服务器选择的密码套件和服务器生成的随机数。</li><li>认证(Authentication)：客户端的证书颁发机构会认证 SSL 证书，然后发送 <code>Certificate</code> 报文，报文中包含公开密钥证书。最后服务器发送 <code>ServerHelloDone</code> 作为 <code>hello</code> 请求的响应。第一部分握手阶段结束。</li><li><code>加密阶段</code>：在第一个阶段握手完成后，客户端会发送 <code>ClientKeyExchange</code> 作为响应，这个响应中包含了一种称为 <code>The premaster secret</code> 的密钥字符串，这个字符串就是使用上面公开密钥证书进行加密的字符串。随后客户端会发送 <code>ChangeCipherSpec</code>，告诉服务端使用私钥解密这个 <code>premaster secret</code> 的字符串，然后客户端发送 <code>Finished</code> 告诉服务端自己发送完成了。</li></ul><blockquote><p>Session key 其实就是用公钥证书加密的公钥。</p></blockquote><ul><li><code>实现了安全的非对称加密</code>：然后，服务器再发送 <code>ChangeCipherSpec</code> 和 <code>Finished</code> 告诉客户端解密完成，至此实现了 RSA 的非对称加密。</li></ul>]]></content>
    
    <summary type="html">
    
      &lt;h1 id=&quot;HTTP相关内容&quot;&gt;&lt;a href=&quot;#HTTP相关内容&quot; class=&quot;headerlink&quot; title=&quot;HTTP相关内容&quot;&gt;&lt;/a&gt;HTTP相关内容&lt;/h1&gt;&lt;h2 id=&quot;HTTP-和-HTTPS-的区别&quot;&gt;&lt;a href=&quot;#HTTP-和-HTTPS-的区别&quot; class=&quot;headerlink&quot; title=&quot;HTTP 和 HTTPS 的区别&quot;&gt;&lt;/a&gt;HTTP 和 HTTPS 的区别&lt;/h2&gt;&lt;p&gt;HTTP 是一种 &lt;code&gt;超文本传输协议(Hypertext Transfer Protocol)&lt;/code&gt;，&lt;strong&gt;HTTP 是一个在计算机世界里专门在两点之间传输文字、图片、音频、视频等超文本数据的约定和规范&lt;/strong&gt;&lt;/p&gt;
&lt;p&gt;&lt;img src=&quot;http://qiniu.zrbac.fun/1.png&quot; alt=&quot;img&quot;&gt;&lt;/p&gt;
&lt;p&gt;HTTP 主要内容分为三部分，&lt;strong&gt;超文本（Hypertext）、传输（Transfer）、协议（Protocol）&lt;/strong&gt;。&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;超文本就是不单单只是本文，它还可以传输图片、音频、视频，甚至点击文字或图片能够进行&lt;code&gt;超链接&lt;/code&gt;的跳转。&lt;/li&gt;
&lt;li&gt;上面这些概念可以统称为数据，传输就是数据需要经过一系列的物理介质从一个端系统传送到另外一个端系统的过程。通常我们把传输数据包的一方称为&lt;code&gt;请求方&lt;/code&gt;，把接到二进制数据包的一方称为&lt;code&gt;应答方&lt;/code&gt;。&lt;/li&gt;
&lt;li&gt;而协议指的就是是网络中(包括互联网)传递、管理信息的一些规范。如同人与人之间相互交流是需要遵循一定的规矩一样，计算机之间的相互通信需要共同遵守一定的规则，这些规则就称为协议，只不过是网络协议。&lt;/li&gt;
&lt;/ul&gt;
    
    </summary>
    
    
      <category term="计算机网络" scheme="https://zrbac.github.io/categories/%E8%AE%A1%E7%AE%97%E6%9C%BA%E7%BD%91%E7%BB%9C/"/>
    
    
      <category term="HTTP/S" scheme="https://zrbac.github.io/tags/HTTP-S/"/>
    
  </entry>
  
  <entry>
    <title>排序算法总结</title>
    <link href="https://zrbac.github.io/2020/08/21/%E6%8E%92%E5%BA%8F%E7%AE%97%E6%B3%95%E6%80%BB%E7%BB%93/"/>
    <id>https://zrbac.github.io/2020/08/21/%E6%8E%92%E5%BA%8F%E7%AE%97%E6%B3%95%E6%80%BB%E7%BB%93/</id>
    <published>2020-08-21T03:22:31.000Z</published>
    <updated>2020-09-17T02:01:29.246Z</updated>
    
    <content type="html"><![CDATA[<h2 id="排序算法总结"><a href="#排序算法总结" class="headerlink" title="排序算法总结"></a>排序算法总结</h2><h3 id="总览"><a href="#总览" class="headerlink" title="总览"></a>总览</h3><ul><li><strong>稳定</strong>：排序前后相等元素之间的相对位置不变</li><li><strong>不稳定</strong>：排序前后相等元素的相对位置发生变化</li><li><strong>内排序</strong>：所有排序操作在内存中完成</li><li><strong>外排序</strong>：排序方法通过磁盘和内存的数据传输对大数据进行排序</li></ul><p><img src="http://qiniu.zrbac.fun/%E6%8E%92%E5%BA%8F%E7%AE%97%E6%B3%95%E6%80%BB%E7%BB%93.png" alt="排序算法总结"></p><ul><li><strong>比较排序</strong>：在排序的最终结果里，元素之间的次序依赖于它们之间的比较，每个数必须与其他数进行比较，才能确定自己的位置，其优势在于，适用于各种规模的数据，不在乎数据的分布。比较排序适用于一切需要排序的情况。</li></ul><p>常见的<strong>快速排序、归并排序、堆排序、冒泡排序等</strong>属于比较排序。</p><ul><li><strong>非比较排序</strong>：只确定每个元素之前的已有元素个数即可进行排序，一次遍历即可解决，非比较排序时间复杂度低，但由于非比较排序需要占用空间来确定唯一位置，所以对数据规模和数据分布有一定的要求。</li></ul><p><strong>基数排序、计数排序、桶排序</strong>属于非比较排序。</p><a id="more"></a><h3 id="一、冒泡排序"><a href="#一、冒泡排序" class="headerlink" title="一、冒泡排序"></a>一、冒泡排序</h3><p>简单的排序算法，通过重复遍历需要排序的数组，比较相邻元素的大小并交换位置，一次遍历使一个元素归位到数组末端。</p><p><img src="http://qiniu.zrbac.fun/%E5%86%92%E6%B3%A1%E6%8E%92%E5%BA%8F.gif" alt="冒泡排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">BubbleSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;<span class="number">1</span>, <span class="number">5</span>, <span class="number">8</span>, <span class="number">2</span>, <span class="number">6</span>, -<span class="number">3</span>, <span class="number">0</span>, <span class="number">7</span>, -<span class="number">3</span>, <span class="number">3</span>, <span class="number">4</span>, <span class="number">9</span>&#125;;</span><br><span class="line">        bubbleSort(arr);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[-3, -3, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">bubbleSort</span><span class="params">(<span class="keyword">int</span>[] arr)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">boolean</span> flag = <span class="keyword">false</span>;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; arr.length; i++) &#123;</span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">0</span>; j &lt; arr.length - i - <span class="number">1</span>; j++) &#123;</span><br><span class="line">                <span class="keyword">if</span> (arr[j] &gt; arr[j + <span class="number">1</span>]) &#123;</span><br><span class="line">                    flag = <span class="keyword">true</span>;</span><br><span class="line">                    <span class="keyword">int</span> tmp = arr[j];</span><br><span class="line">                    arr[j] = arr[j + <span class="number">1</span>];</span><br><span class="line">                    arr[j + <span class="number">1</span>] = tmp;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="comment">//若某次内层循环没有进行交换操作，则说明已经有序，可直接退出循环</span></span><br><span class="line">            <span class="keyword">if</span> (flag)</span><br><span class="line">                flag = <span class="keyword">false</span>;</span><br><span class="line">            <span class="keyword">else</span></span><br><span class="line">                <span class="keyword">break</span>;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(1)</p><p>时间复杂度O(n^2^)</p><h3 id="二、选择排序"><a href="#二、选择排序" class="headerlink" title="二、选择排序"></a>二、选择排序</h3><p>表现最稳定的排序算法之一，总是O(n^2^)的时间复杂度，一般在数据规模较小的时候使用。其首先在未排序的序列中找到最小元素，将其放在序列起始位置，再从剩余未排序元素中继续寻找最小元素，放到已排序序列队尾，以此类推，直至排序完毕。</p><p><img src="http://qiniu.zrbac.fun/%E9%80%89%E6%8B%A9%E6%8E%92%E5%BA%8F.gif" alt="选择排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">SelectSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;<span class="number">1</span>, <span class="number">5</span>, <span class="number">8</span>, <span class="number">2</span>, <span class="number">6</span>, -<span class="number">3</span>, <span class="number">0</span>, <span class="number">7</span>, -<span class="number">3</span>, <span class="number">3</span>, <span class="number">4</span>, <span class="number">9</span>&#125;;</span><br><span class="line">        selectSort(arr);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[-3, -3, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">selectSort</span><span class="params">(<span class="keyword">int</span>[] arr)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; arr.length; i++) &#123;</span><br><span class="line">            <span class="keyword">int</span> minIndex = i;</span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> j = i; j &lt; arr.length; j++) &#123;</span><br><span class="line">                <span class="keyword">if</span> (arr[j] &lt; arr[minIndex])</span><br><span class="line">                    minIndex = j;</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="keyword">int</span> tmp = arr[minIndex];</span><br><span class="line">            arr[minIndex] = arr[i];</span><br><span class="line">            arr[i] = tmp;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(1)</p><p>时间复杂度O(n^2^)</p><h3 id="三、插入排序"><a href="#三、插入排序" class="headerlink" title="三、插入排序"></a>三、插入排序</h3><p>通过构建有序序列，对于未排序数据，在已排序序列中从后向前扫描，找到相应位置并插入。</p><p><img src="http://qiniu.zrbac.fun/%E6%8F%92%E5%85%A5%E6%8E%92%E5%BA%8F.gif" alt="插入排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">InsertSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;-<span class="number">2</span>, -<span class="number">3</span>, <span class="number">1</span>, <span class="number">9</span>, <span class="number">3</span>, <span class="number">0</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">4</span>, <span class="number">7</span>, <span class="number">6</span>, <span class="number">8</span>&#125;;</span><br><span class="line">        insertSort(arr);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[-3, -2, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">insertSort</span><span class="params">(<span class="keyword">int</span>[] arr)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">1</span>; i &lt; arr.length; i++) &#123;</span><br><span class="line">            <span class="keyword">int</span> current = arr[i];</span><br><span class="line">            <span class="keyword">int</span> index = i - <span class="number">1</span>;</span><br><span class="line">            <span class="keyword">while</span> (index &gt;= <span class="number">0</span> &amp;&amp; current &lt; arr[index]) &#123;</span><br><span class="line">                arr[index + <span class="number">1</span>] = arr[index];</span><br><span class="line">                index--;</span><br><span class="line">            &#125;</span><br><span class="line">            arr[index + <span class="number">1</span>] = current;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(1)</p><p>时间复杂度O(n^2^)</p><h3 id="四、快速排序（重要）"><a href="#四、快速排序（重要）" class="headerlink" title="四、快速排序（重要）"></a>四、快速排序（重要）</h3><p>通过一次排序将待排数据分隔为两部分，一部分数据均比另一部分数据小，再分别在两部分数据中继续排序，最后达到整体有序。</p><p>1、算法先从序列中挑出一个元素作为基准，然后将序列中所有比其小的元素放在左边，大的放在右边，即确定该基准在序列中的位置。</p><p>2、再递归地把小于基准值元素的子序列和大于基准值元素的子序列排序。</p><p><img src="http://qiniu.zrbac.fun/%E5%BF%AB%E9%80%9F%E6%8E%92%E5%BA%8F.gif" alt="快速排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">QuickSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;-<span class="number">3</span>, -<span class="number">2</span>, <span class="number">0</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">7</span>, <span class="number">4</span>, <span class="number">1</span>, <span class="number">3</span>, <span class="number">9</span>, <span class="number">8</span>, <span class="number">6</span>&#125;;</span><br><span class="line">        quickSort(arr, <span class="number">0</span>, arr.length - <span class="number">1</span>);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[-3, -2, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">quickSort</span><span class="params">(<span class="keyword">int</span>[] arr, <span class="keyword">int</span> left, <span class="keyword">int</span> right)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span> (left &gt; right)</span><br><span class="line">            <span class="keyword">return</span>;</span><br><span class="line">        <span class="keyword">int</span> l = left, r = right;</span><br><span class="line">        <span class="comment">//一般设首位为基准值</span></span><br><span class="line">        <span class="keyword">int</span> base = arr[left];</span><br><span class="line">        <span class="keyword">while</span> (l &lt; r) &#123;</span><br><span class="line">            <span class="comment">//寻找比base大的数准备交换</span></span><br><span class="line">            <span class="keyword">while</span> (arr[l] &lt;= base &amp;&amp; l &lt; r)</span><br><span class="line">                l++;</span><br><span class="line">            <span class="comment">//寻找比base小的数准备交换</span></span><br><span class="line">            <span class="keyword">while</span> (arr[r] &gt;= base &amp;&amp; l &lt;= r)</span><br><span class="line">                r--;</span><br><span class="line">            <span class="comment">//交换需保证l&lt;r，否则直接退出，交换base和arr[r]</span></span><br><span class="line">            <span class="keyword">if</span> (l &lt; r) &#123;</span><br><span class="line">                <span class="keyword">int</span> tmp = arr[l];</span><br><span class="line">                arr[l] = arr[r];</span><br><span class="line">                arr[r] = tmp;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">//确定了base排序后的位置，交换</span></span><br><span class="line">        arr[left] = arr[r];</span><br><span class="line">        arr[r] = base;</span><br><span class="line">        <span class="comment">//分别对两部分进行快速排序</span></span><br><span class="line">        quickSort(arr, left, r - <span class="number">1</span>);</span><br><span class="line">        quickSort(arr, r + <span class="number">1</span>, right);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(logn)</p><p>时间复杂度O(nlogn)</p><h3 id="五、归并排序（重要）"><a href="#五、归并排序（重要）" class="headerlink" title="五、归并排序（重要）"></a>五、归并排序（重要）</h3><p>建立在归并操作上的一种有效的排序算法，是分治法的一个典型应用。</p><p>1、算法先将长度为n的序列分为两个n/2的子序列，再对子序列分别进行归并排序。</p><p>2、然后将两个排序好的子序列合并为最终的有序序列。</p><p><img src="http://qiniu.zrbac.fun/%E5%BD%92%E5%B9%B6%E6%8E%92%E5%BA%8F.gif" alt="归并排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">MergeSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;<span class="number">1</span>, <span class="number">5</span>, <span class="number">8</span>, <span class="number">2</span>, <span class="number">6</span>, -<span class="number">3</span>, <span class="number">0</span>, <span class="number">7</span>, -<span class="number">3</span>, <span class="number">3</span>, <span class="number">4</span>, <span class="number">9</span>&#125;;</span><br><span class="line">        mergeSort(arr, <span class="number">0</span>, arr.length - <span class="number">1</span>);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[-3, -3, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">mergeSort</span><span class="params">(<span class="keyword">int</span>[] arr, <span class="keyword">int</span> left, <span class="keyword">int</span> right)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> mid = (right + left) / <span class="number">2</span>;</span><br><span class="line">        <span class="keyword">if</span> (left &lt; right) &#123;</span><br><span class="line">            mergeSort(arr, left, mid);</span><br><span class="line">            mergeSort(arr, mid + <span class="number">1</span>, right);</span><br><span class="line">            merge(arr, left, mid, right);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">merge</span><span class="params">(<span class="keyword">int</span>[] arr, <span class="keyword">int</span> left, <span class="keyword">int</span> mid, <span class="keyword">int</span> right)</span> </span>&#123;</span><br><span class="line">        <span class="comment">//初始化，i指向左半部分的起始，j指向右半部分起始索引位置mid+1</span></span><br><span class="line">        <span class="keyword">int</span> i = left, j = mid + <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">int</span> t = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">int</span>[] tmp = <span class="keyword">new</span> <span class="keyword">int</span>[right + <span class="number">1</span>];</span><br><span class="line">        <span class="keyword">while</span> (i &lt;= mid &amp;&amp; j &lt;= right) &#123;</span><br><span class="line">            <span class="keyword">if</span> (i &lt;= mid &amp;&amp; arr[i] &lt;= arr[j])</span><br><span class="line">                <span class="comment">//左半部分所指元素&lt;右半部分所指元素</span></span><br><span class="line">                tmp[t++] = arr[i++];</span><br><span class="line">            <span class="keyword">else</span></span><br><span class="line">                tmp[t++] = arr[j++];</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">while</span> (i &lt;= mid) &#123;</span><br><span class="line">            <span class="comment">//右半部分元素已经全部处理完毕，剩余左半部分</span></span><br><span class="line">            tmp[t++] = arr[i++];</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">while</span> (j &lt;= right) &#123;</span><br><span class="line">            <span class="comment">//左半部分元素已经全部处理完毕，剩余右半部分</span></span><br><span class="line">            tmp[t++] = arr[j++];</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="keyword">int</span> index = left;</span><br><span class="line">        t = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">while</span> (index &lt;= right) &#123;</span><br><span class="line">            arr[index++] = tmp[t++];</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(n)</p><p>时间复杂度O(nlogn)</p><h3 id="六、堆排序（重要）"><a href="#六、堆排序（重要）" class="headerlink" title="六、堆排序（重要）"></a>六、堆排序（重要）</h3><p>利用堆的数据结构所设计的一种排序算法，堆是一个近似完全二叉树的结构，子节点的键值或索引总是小于（或大于）其父节点。</p><p>将堆的逻辑结构映射到数组中，则有以下性质：</p><ul><li><p>对于大顶堆：arr[i] &gt;= arr[2i + 1] &amp;&amp; arr[i] &gt;= arr[2i + 2]</p></li><li><p>对于小顶堆：arr[i] &lt;= arr[2i + 1] &amp;&amp; arr[i] &lt;= arr[2i + 2]</p></li></ul><p>1、 将带排序的序列构造成一个大顶堆，根据大顶堆的性质，当前堆的根节点（堆顶）就是序列中最大的元素。</p><p>2、将堆顶元素和最后一个元素交换，然后将剩下的节点重新构造成一个大顶堆。</p><p>3、重复步骤2，如此反复，从第一次构建大顶堆开始，每一次构建，我们都能获得一个序列的最大值，然后把它放到大顶堆的尾部。最后，就得到一个有序的序列。</p><p><img src="http://qiniu.zrbac.fun/%E5%A0%86%E6%8E%92%E5%BA%8F.gif" alt="堆排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">HeapSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;-<span class="number">2</span>, -<span class="number">3</span>, <span class="number">1</span>, <span class="number">9</span>, <span class="number">3</span>, <span class="number">0</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">4</span>, <span class="number">7</span>, <span class="number">6</span>, <span class="number">8</span>&#125;;</span><br><span class="line">        heapSort(arr);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[-3, -2, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">heapSort</span><span class="params">(<span class="keyword">int</span>[] arr)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> len = arr.length;</span><br><span class="line">        <span class="comment">//构建大顶堆，将待排序序列，变成一个大顶堆结构的数组</span></span><br><span class="line">        buildMaxHeap(arr, len);</span><br><span class="line"></span><br><span class="line">        <span class="comment">//交换堆顶和当前末尾的节点，调整大顶堆</span></span><br><span class="line">        <span class="keyword">while</span> (len &gt; <span class="number">0</span>) &#123;</span><br><span class="line">            swap(arr, <span class="number">0</span>, len - <span class="number">1</span>);</span><br><span class="line">            len--;</span><br><span class="line">            adjustHeap(arr, <span class="number">0</span>, len);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">buildMaxHeap</span><span class="params">(<span class="keyword">int</span>[] arr, <span class="keyword">int</span> len)</span> </span>&#123;</span><br><span class="line">        <span class="comment">//从最后一个非叶节点开始向前遍历，调整节点性质，使之成为大顶堆</span></span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = (len / <span class="number">2</span> - <span class="number">1</span>); i &gt;= <span class="number">0</span>; i--) &#123;</span><br><span class="line">            adjustHeap(arr, i, len);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">adjustHeap</span><span class="params">(<span class="keyword">int</span>[] arr, <span class="keyword">int</span> i, <span class="keyword">int</span> len)</span> </span>&#123;</span><br><span class="line">        <span class="comment">//根据堆性质，找出其左右节点的索引</span></span><br><span class="line">        <span class="keyword">int</span> left = <span class="number">2</span> * i + <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">int</span> right = <span class="number">2</span> * i + <span class="number">2</span>;</span><br><span class="line">        <span class="comment">//默认当前节点（父节点）是最大值</span></span><br><span class="line">        <span class="keyword">int</span> maxIndex = i;</span><br><span class="line">        <span class="keyword">if</span> (left &lt; len &amp;&amp; arr[left] &gt; arr[maxIndex])</span><br><span class="line">            <span class="comment">//若有左节点，且左节点值更大，更新最大值索引</span></span><br><span class="line">            maxIndex = left;</span><br><span class="line">        <span class="keyword">if</span> (right &lt; len &amp;&amp; arr[right] &gt; arr[maxIndex])</span><br><span class="line">            <span class="comment">//若有右节点，且右节点值更大，更新最大值索引</span></span><br><span class="line">            maxIndex = right;</span><br><span class="line">        <span class="keyword">if</span> (maxIndex != i) &#123;</span><br><span class="line">            <span class="comment">//若最大值不是当前非叶子节点的值，将当前节点和最大值的子节点互换,并调整堆</span></span><br><span class="line">            swap(arr, i, maxIndex);</span><br><span class="line">            adjustHeap(arr, maxIndex, len);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">swap</span><span class="params">(<span class="keyword">int</span>[] arr, <span class="keyword">int</span> i, <span class="keyword">int</span> j)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> tmp = arr[i];</span><br><span class="line">        arr[i] = arr[j];</span><br><span class="line">        arr[j] = tmp;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(1)</p><p>时间复杂度O(nlogn)</p><h3 id="七、希尔排序"><a href="#七、希尔排序" class="headerlink" title="七、希尔排序"></a>七、希尔排序</h3><p>希尔排序是一种插入排序，是简单插入排序的改进，也称为缩小增量排序。算法将数据按一定增量分组，对每组使用直接插入排序算法排序，随着增量逐渐减少，每组包含的数据越来越多，当增量减至1时，排序完毕。</p><p><img src="http://qiniu.zrbac.fun/%E5%B8%8C%E5%B0%94%E6%8E%92%E5%BA%8F.jpg" alt="希尔排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">ShellSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;-<span class="number">2</span>, -<span class="number">3</span>, <span class="number">1</span>, <span class="number">9</span>, <span class="number">3</span>, <span class="number">0</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">4</span>, <span class="number">7</span>, <span class="number">6</span>, <span class="number">8</span>&#125;;</span><br><span class="line">        shellSort(arr);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[-3, -2, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">shellSort</span><span class="params">(<span class="keyword">int</span>[] arr)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> gap = arr.length / <span class="number">2</span>; gap &gt; <span class="number">0</span>; gap /= <span class="number">2</span>) &#123;</span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> i = gap; i &lt; arr.length; i++) &#123;</span><br><span class="line">                <span class="keyword">int</span> index = i;</span><br><span class="line">                <span class="keyword">int</span> tmp = arr[i];</span><br><span class="line">                <span class="keyword">while</span> (index - gap &gt;= <span class="number">0</span> &amp;&amp; tmp &lt; arr[index - gap]) &#123;</span><br><span class="line">                    arr[index] = arr[index - gap];</span><br><span class="line">                    index -= gap;</span><br><span class="line">                &#125;</span><br><span class="line">                arr[index] = tmp;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(1)</p><p>时间复杂度O(nlog^2^n)~O(n^1.3–2^)</p><h3 id="八、计数排序"><a href="#八、计数排序" class="headerlink" title="八、计数排序"></a>八、计数排序</h3><p>计数排序使用一个额外的数组tmp，其中第i个元素时待排序数组arr中值等于i的元素的个数，然后根据数组tmp来将arr中的元素排到正确的位置。</p><p>计数排序只能对整数进行排序。</p><p>1、找出待排序数组中最大和最小的元素。</p><p>2、统计数组中每个元素i出现的次数，存入数组tmp的第i项。</p><p>3、对所有的计数累加，反向填充目标数组。</p><p><img src="http://qiniu.zrbac.fun/%E8%AE%A1%E6%95%B0%E6%8E%92%E5%BA%8F.gif" alt="计数排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">CountingSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;-<span class="number">2</span>, -<span class="number">3</span>, <span class="number">1</span>, <span class="number">9</span>, <span class="number">3</span>, <span class="number">0</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">4</span>, <span class="number">7</span>, <span class="number">6</span>, <span class="number">8</span>&#125;;</span><br><span class="line">        countingSort(arr);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[-3, -2, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">countingSort</span><span class="params">(<span class="keyword">int</span>[] arr)</span> </span>&#123;</span><br><span class="line">        <span class="comment">//定义两个变量来存放数组中的最大最小值</span></span><br><span class="line">        <span class="keyword">int</span> min = arr[<span class="number">0</span>], max = arr[<span class="number">0</span>];</span><br><span class="line">        <span class="keyword">int</span> len = arr.length;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">1</span>; i &lt; len; i++) &#123;</span><br><span class="line">            <span class="keyword">if</span> (max &lt; arr[i])</span><br><span class="line">                max = arr[i];</span><br><span class="line">            <span class="keyword">if</span> (min &gt; arr[i])</span><br><span class="line">                min = arr[i];</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">//定义一个长度为n的数组，存储待排序元素</span></span><br><span class="line">        <span class="keyword">int</span> n = max - min + <span class="number">1</span>;</span><br><span class="line">        <span class="keyword">int</span>[] tmp = <span class="keyword">new</span> <span class="keyword">int</span>[n];</span><br><span class="line">        <span class="comment">//哪个数字出现一次，就将该数字作为下标存起来，例如2020出现了一次，就将tmp[2020]加一</span></span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; len; i++)</span><br><span class="line">            tmp[arr[i] - min]++;</span><br><span class="line">        <span class="keyword">int</span> k = <span class="number">0</span>;</span><br><span class="line">        <span class="comment">//对tmp进行遍历，tmp[i]的值为i出现的次数</span></span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; n; i++) &#123;</span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> j = tmp[i]; j &gt; <span class="number">0</span>; j--)</span><br><span class="line">                arr[k++] = i + min;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>空间复杂度O(n)</p><p>时间复杂度O(n)</p><h3 id="九、基数排序"><a href="#九、基数排序" class="headerlink" title="九、基数排序"></a>九、基数排序</h3><p>非比较排序算法，基数排序按照低位先排序，然后收集；再按照高位排序，收集；以此类推，直至最高位。</p><p>基数排序的两种方式：</p><ul><li><p>高位优先，又称为最有效键(MSD),它的比较方向是由右至左；</p></li><li><p>低位优先，又称为最无效键(LSD),它的比较方向是由左至右；</p></li></ul><p>基数排序只能对自然数进行排序。</p><p>1、取得数组中的最大数，并取得位数。</p><p>2、arr为原始数组，从最低位开始取每个位组成radix数组。</p><p>3、对radix进行计数排序</p><p><img src="http://qiniu.zrbac.fun/%E5%9F%BA%E6%95%B0%E6%8E%92%E5%BA%8F.png" alt="基数排序"></p><p><img src="http://qiniu.zrbac.fun/%E5%9F%BA%E6%95%B0%E6%8E%92%E5%BA%8F.gif" alt="基数排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">RadixSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;<span class="number">12</span>, <span class="number">13</span>, <span class="number">1</span>, <span class="number">9</span>, <span class="number">3</span>, <span class="number">0</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">4</span>, <span class="number">7</span>, <span class="number">6</span>, <span class="number">8</span>&#125;;</span><br><span class="line">        radixSort(arr);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">        <span class="comment">//[0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 12, 13]</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">radixSort</span><span class="params">(<span class="keyword">int</span>[] arr)</span> </span>&#123;</span><br><span class="line">        <span class="comment">//待排序列最大值</span></span><br><span class="line">        <span class="keyword">int</span> max = arr[<span class="number">0</span>];</span><br><span class="line">        <span class="keyword">int</span> exp;<span class="comment">//指数</span></span><br><span class="line">        <span class="comment">//计算最大值</span></span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> anArr : arr) &#123;</span><br><span class="line">            <span class="keyword">if</span> (anArr &gt; max)</span><br><span class="line">                max = anArr;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">//从个位开始，对数组进行排序</span></span><br><span class="line">        <span class="keyword">for</span> (exp = <span class="number">1</span>; max / exp &gt; <span class="number">0</span>; exp *= <span class="number">10</span>) &#123;</span><br><span class="line">            <span class="comment">//存储待排元素的临时数组</span></span><br><span class="line">            <span class="keyword">int</span>[] temp = <span class="keyword">new</span> <span class="keyword">int</span>[arr.length];</span><br><span class="line">            <span class="comment">//分桶个数</span></span><br><span class="line">            <span class="keyword">int</span>[] buckets = <span class="keyword">new</span> <span class="keyword">int</span>[<span class="number">10</span>];</span><br><span class="line">            <span class="comment">//将数据出现的次数存储在buckets中</span></span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> value : arr)</span><br><span class="line">                <span class="comment">//(value / exp) % 10 :value的最底位(个位)</span></span><br><span class="line">                buckets[(value / exp) % <span class="number">10</span>]++;</span><br><span class="line">            <span class="comment">//更改buckets[i]，</span></span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">1</span>; i &lt; <span class="number">10</span>; i++)</span><br><span class="line">                buckets[i] += buckets[i - <span class="number">1</span>];</span><br><span class="line">            <span class="comment">//将数据存储到临时数组temp中</span></span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> i = arr.length - <span class="number">1</span>; i &gt;= <span class="number">0</span>; i--) &#123;</span><br><span class="line">                temp[buckets[(arr[i] / exp) % <span class="number">10</span>] - <span class="number">1</span>] = arr[i];</span><br><span class="line">                buckets[(arr[i] / exp) % <span class="number">10</span>]--;</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="comment">//将有序元素temp赋给arr</span></span><br><span class="line">            System.arraycopy(temp, <span class="number">0</span>, arr, <span class="number">0</span>, arr.length);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(n)</p><p>时间复杂度O(n)</p><h3 id="十、桶排序"><a href="#十、桶排序" class="headerlink" title="十、桶排序"></a>十、桶排序</h3><p>桶排序就是把最大值和最小值之间的数进行瓜分，例如分成 10 个区间，10个区间对应10个桶，我们把各元素放到对应区间的桶中去，再对每个桶中的数进行排序，可以采用归并排序，也可以采用快速排序之类的。</p><p>之后每个桶里面的数据就是有序的了，我们在进行合并汇总。</p><p><img src="http://qiniu.zrbac.fun/%E6%A1%B6%E6%8E%92%E5%BA%8F.png" alt="桶排序"></p><p><strong>代码</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> sortalgorithms;</span><br><span class="line"></span><br><span class="line"><span class="keyword">import</span> java.util.ArrayList;</span><br><span class="line"><span class="keyword">import</span> java.util.Arrays;</span><br><span class="line"><span class="keyword">import</span> java.util.Collections;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">BucketSort</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span>[] arr = &#123;<span class="number">12</span>, <span class="number">13</span>, <span class="number">1</span>, <span class="number">9</span>, <span class="number">3</span>, <span class="number">0</span>, <span class="number">5</span>, <span class="number">2</span>, <span class="number">4</span>, <span class="number">7</span>, <span class="number">6</span>, <span class="number">8</span>&#125;;</span><br><span class="line">        bucketSort(arr);</span><br><span class="line">        System.out.println(Arrays.toString(arr));</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">bucketSort</span><span class="params">(<span class="keyword">int</span>[] arr)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> max = Integer.MIN_VALUE;</span><br><span class="line">        <span class="keyword">int</span> min = Integer.MAX_VALUE;</span><br><span class="line"></span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;arr.length; i++) &#123;</span><br><span class="line">            min = Math.min(arr[i], min);</span><br><span class="line">            max = Math.max(arr[i], max);</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="comment">//初始化桶</span></span><br><span class="line">        <span class="keyword">int</span> bucketSize = (max-min)/arr.length + <span class="number">1</span>;</span><br><span class="line">        ArrayList&lt;ArrayList&lt;Integer&gt;&gt; bucket = <span class="keyword">new</span> ArrayList&lt;&gt;(bucketSize);</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;bucketSize; i++)</span><br><span class="line">            bucket.add(<span class="keyword">new</span> ArrayList&lt;&gt;());</span><br><span class="line"></span><br><span class="line">        <span class="comment">//将每个元素放入桶中</span></span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;arr.length; i++) &#123;</span><br><span class="line">            <span class="keyword">int</span> num = (arr[i] - min)/arr.length;</span><br><span class="line">            bucket.get(num).add(arr[i]);</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="comment">//每个桶中的元素排序</span></span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;bucketSize; i++)</span><br><span class="line">            Collections.sort(bucket.get(i));</span><br><span class="line"></span><br><span class="line">        <span class="comment">//将排序好的数据合并汇总至原数组</span></span><br><span class="line">        <span class="keyword">int</span> k = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>; i&lt;bucketSize; i++) &#123;</span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> num : bucket.get(i))</span><br><span class="line">                arr[k++] = min + num;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><strong>分析</strong></p><p>空间复杂度O(n)</p><p>时间复杂度O(n)</p>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;排序算法总结&quot;&gt;&lt;a href=&quot;#排序算法总结&quot; class=&quot;headerlink&quot; title=&quot;排序算法总结&quot;&gt;&lt;/a&gt;排序算法总结&lt;/h2&gt;&lt;h3 id=&quot;总览&quot;&gt;&lt;a href=&quot;#总览&quot; class=&quot;headerlink&quot; title=&quot;总览&quot;&gt;&lt;/a&gt;总览&lt;/h3&gt;&lt;ul&gt;
&lt;li&gt;&lt;strong&gt;稳定&lt;/strong&gt;：排序前后相等元素之间的相对位置不变&lt;/li&gt;
&lt;li&gt;&lt;strong&gt;不稳定&lt;/strong&gt;：排序前后相等元素的相对位置发生变化&lt;/li&gt;
&lt;li&gt;&lt;strong&gt;内排序&lt;/strong&gt;：所有排序操作在内存中完成&lt;/li&gt;
&lt;li&gt;&lt;strong&gt;外排序&lt;/strong&gt;：排序方法通过磁盘和内存的数据传输对大数据进行排序&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;&lt;img src=&quot;http://qiniu.zrbac.fun/%E6%8E%92%E5%BA%8F%E7%AE%97%E6%B3%95%E6%80%BB%E7%BB%93.png&quot; alt=&quot;排序算法总结&quot;&gt;&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;&lt;strong&gt;比较排序&lt;/strong&gt;：在排序的最终结果里，元素之间的次序依赖于它们之间的比较，每个数必须与其他数进行比较，才能确定自己的位置，其优势在于，适用于各种规模的数据，不在乎数据的分布。比较排序适用于一切需要排序的情况。&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;常见的&lt;strong&gt;快速排序、归并排序、堆排序、冒泡排序等&lt;/strong&gt;属于比较排序。&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;&lt;strong&gt;非比较排序&lt;/strong&gt;：只确定每个元素之前的已有元素个数即可进行排序，一次遍历即可解决，非比较排序时间复杂度低，但由于非比较排序需要占用空间来确定唯一位置，所以对数据规模和数据分布有一定的要求。&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;&lt;strong&gt;基数排序、计数排序、桶排序&lt;/strong&gt;属于非比较排序。&lt;/p&gt;
    
    </summary>
    
    
      <category term="算法" scheme="https://zrbac.github.io/categories/%E7%AE%97%E6%B3%95/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>Java-面向对象</title>
    <link href="https://zrbac.github.io/2020/05/11/Java-%E9%9D%A2%E5%90%91%E5%AF%B9%E8%B1%A1/"/>
    <id>https://zrbac.github.io/2020/05/11/Java-%E9%9D%A2%E5%90%91%E5%AF%B9%E8%B1%A1/</id>
    <published>2020-05-11T01:16:26.000Z</published>
    <updated>2020-07-21T09:47:28.324Z</updated>
    
    <content type="html"><![CDATA[<h2 id="面向对象"><a href="#面向对象" class="headerlink" title="面向对象"></a>面向对象</h2><p>基本数据类型和引用数据类型传参的区别</p><p>Java内存空间<br>栈区：</p><ul><li>每个线程包含一个栈区，栈中只保存基础数据类型的值和对象的引用，当一段代码或一个方法调用完毕后，栈中为这段代码提供的基本数据类型或对象的引用被立即释放。</li><li>每个栈中的数据(原始类型和对象引用)私有，其他栈不能访问。</li><li>栈分为3个部分：基本类型变量区、执行环境上下文、操作指令去(存放操作指令)。</li></ul><p>堆区：</p><ul><li>存储的都是对象，每个对象都包含一个与之对应的class信息。(class用来得到操作指令)</li><li>Jvm只有一个堆区(heap)被所有线程共享，堆中不存放基本类型和对象引用，只存放对象本身。</li></ul><p>方法区</p><ul><li>也叫静态区，和堆一样，被所有线程共享，方法区包含所有的class和static变量。</li><li>方法区中包含的都是在整个程序中永远唯一的元素，如class，static变量。</li></ul><p><img src="https://user-images.githubusercontent.com/33156501/81540262-f655ec80-93a3-11ea-9879-0c45124a433c.png" alt="内存空间"><br>1.整数、浮点数、字符为基本数据类型。<br>2.字符串、数组为引用类型(内存数据的索引)。</p><ul><li>基本数据类型参数的传递，是调用方值的复制，其各自的后续修改，互不影响。</li><li>引用数据类型参数的传递，若在方法体中修改形参指向的数据内容，则会对实参变量的数值产生影响，因为形参和实参变量共享同一块堆区。</li><li>当使用引用数据类型作为方法的形参时，若在方法体中修改形参变量的指向，此时不会对实参变量的数值产生影响，因为此时形参变量和实参变量分别指向不同的堆区。</li></ul><a id="more"></a><h3 id="封装"><a href="#封装" class="headerlink" title="封装"></a>封装</h3><p>将类的某些信息隐藏在类的内部，不允许外部程序直接访问，而是通过该类提供的方法来对隐藏的信息进行操作和访问。</p><p>Java中的权限修饰符：</p><p>1.公共类型public</p><ul><li>public可修饰类、成员变量、构造方法、方法成员。</li><li>被public修饰的成员，可以在任何一个类中被调用，无论同不同包。</li><li>public是权限最大的修饰符。</li></ul><p>2.私有类型private</p><ul><li>可修饰成员变量，构造方法、方法成员，不能修饰类(不考虑内部类)。</li><li>被private修饰的成员，只能在定义他们的类中使用，在其他类中不能调用。</li></ul><p>3.保护类型protect</p><ul><li>可修饰成员变量，构造方法、方法成员，不能修饰类(不考虑内部类)。</li><li>被protected修饰的成员，能在定义它们的类中、同包的类中被调用，如果有不同包的类想调用它们，那么这个类必须是定义它们的类的子类。</li></ul><p>4.默认类型default</p><ul><li>可修饰类、成员变量、构造方法、方法成员，均可使用默认权限，即不写任何关键字。</li><li>默认权限即同包权限，同包权限的元素只能在定义它们的类中，以及同包的类中被调用。</li></ul><p><strong>yes表示该权限修饰符所修饰的成员可被该处访问</strong></p><p> 修饰符 | 类内部 | 同包 | 子类 | 任何地方<br> :-: | :-: | :-: | :-: | :-: | :-:<br>private | yes |<br>default | yes | yes |<br>protected | yes | yes | yes |<br>public  | yes | yes | yes | yes |</p><h3 id="继承"><a href="#继承" class="headerlink" title="继承"></a>继承</h3><p>继承(Inheritance)是一种联结类与类的层次模型。指的是一个类(称为子类、子接口)继承另外的一个类(称为父类、父接口)的功能，并可以增加它自己的新功能的能力，继承是类与类或者接口与接口之间最常见的关系；继承是一种is-a关系。</p><p><img src="https://user-images.githubusercontent.com/33156501/86781847-febf6080-c090-11ea-8086-f678faf02c2a.png" alt="继承"></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Main</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">        Student s = <span class="keyword">new</span> Student(<span class="string">"Xiao Ming"</span>, <span class="number">12</span>, <span class="number">89</span>);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Person</span> </span>&#123;</span><br><span class="line">    <span class="keyword">protected</span> String name;</span><br><span class="line">    <span class="keyword">protected</span> <span class="keyword">int</span> age;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">Person</span><span class="params">(String name, <span class="keyword">int</span> age)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">this</span>.name = name;</span><br><span class="line">        <span class="keyword">this</span>.age = age;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Student</span> <span class="keyword">extends</span> <span class="title">Person</span> </span>&#123;</span><br><span class="line">    <span class="keyword">protected</span> <span class="keyword">int</span> score;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">Student</span><span class="params">(String name, <span class="keyword">int</span> age, <span class="keyword">int</span> score)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">super</span>(name,age);        <span class="comment">//父类的构造器有参数，需要显式调用。默认时为super(),不含参数。</span></span><br><span class="line">        <span class="keyword">this</span>.score = score;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>子类是不继承父类的构造器（构造方法或者构造函数）的，它只是调用（隐式或显式）。如果父类的构造器带有参数，则必须在子类的构造器中显式地通过<strong>super</strong>关键字调用父类的构造器并配以适当的参数列表。如果父类构造器没有参数，则在子类的构造器中不需要使用<strong>super</strong>关键字调用父类构造器，系统会自动调用父类的无参构造器。</p><p><strong>向上转型</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> com.java.starter;</span><br><span class="line"> <span class="class"><span class="keyword">class</span> <span class="title">Animal</span> </span>&#123;</span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">eat</span><span class="params">()</span> </span>&#123;</span><br><span class="line">System.out.println(<span class="string">"父类的 eating..."</span>);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Bird</span> <span class="keyword">extends</span> <span class="title">Animal</span> </span>&#123;</span><br><span class="line"><span class="meta">@Override</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">eat</span><span class="params">()</span> </span>&#123;</span><br><span class="line">System.out.println(<span class="string">"子类重写的父类的  eatting..."</span>);</span><br><span class="line">&#125;</span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">fly</span><span class="params">()</span> </span>&#123;</span><br><span class="line">System.out.println(<span class="string">"子类新方法  flying..."</span>);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Main</span> </span>&#123;</span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">Animal b=<span class="keyword">new</span> Bird(); <span class="comment">//向上转型</span></span><br><span class="line">b.eat(); </span><br><span class="line"><span class="comment">//  b.fly(); b虽指向子类对象，但此时子类作为向上的代价丢失和父类不同的fly()方法</span></span><br><span class="line">sleep(<span class="keyword">new</span> Male());</span><br><span class="line">sleep(<span class="keyword">new</span> Female()); <span class="comment">//传入的参数是子类-----！！</span></span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">sleep</span><span class="params">(Human h)</span> </span>&#123; <span class="comment">//方法的参数是父类------！！！</span></span><br><span class="line">  h.sleep();</span><br><span class="line">        &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> com.java.starter;</span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Human</span> </span>&#123;</span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">sleep</span><span class="params">()</span> </span>&#123;</span><br><span class="line">System.out.println(<span class="string">"父类人类   sleep.."</span>);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Male</span> <span class="keyword">extends</span> <span class="title">Human</span> </span>&#123;</span><br><span class="line"><span class="meta">@Override</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">sleep</span><span class="params">()</span> </span>&#123;</span><br><span class="line">System.out.println(<span class="string">"男人 sleep.."</span>);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Female</span> <span class="keyword">extends</span> <span class="title">Human</span> </span>&#123;</span><br><span class="line"><span class="meta">@Override</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">sleep</span><span class="params">()</span> </span>&#123;</span><br><span class="line">System.out.println(<span class="string">"女人 sleep.."</span>);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>如上，若是不使用向上转型，那么有多少个子类就得写多少种sleep()方法。</p><p><strong>向下转型</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">package</span> com.java.starter;</span><br><span class="line"> <span class="class"><span class="keyword">class</span> <span class="title">Fruit</span> </span>&#123;</span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">myName</span><span class="params">()</span> </span>&#123;</span><br><span class="line">System.out.println(<span class="string">"我是父类  水果..."</span>);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"> </span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Apple</span> <span class="keyword">extends</span> <span class="title">Fruit</span> </span>&#123; </span><br><span class="line"><span class="meta">@Override</span></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">myName</span><span class="params">()</span> </span>&#123; </span><br><span class="line">System.out.println(<span class="string">"我是子类  苹果..."</span>);</span><br><span class="line">&#125;</span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">myMore</span><span class="params">()</span> </span>&#123;</span><br><span class="line">System.out.println(<span class="string">"我是你的小呀小苹果~~~~~~"</span>);</span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br><span class="line"> </span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Main</span> </span>&#123; </span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123; </span><br><span class="line">Fruit a=<span class="keyword">new</span> Apple(); <span class="comment">//向上转型</span></span><br><span class="line">a.myName();</span><br><span class="line"></span><br><span class="line">Apple aa=(Apple)a; <span class="comment">//向下转型,编译和运行皆不会出错(正确的)</span></span><br><span class="line">aa.myName();<span class="comment">//向下转型时调用的是子类的</span></span><br><span class="line">aa.myMore();;</span><br><span class="line">  </span><br><span class="line">Fruit f=<span class="keyword">new</span> Fruit();</span><br><span class="line">        Apple aaa=(Apple)f; <span class="comment">//-不安全的---向下转型,编译无错但会运行会出错</span></span><br><span class="line">  aaa.myName();    <span class="comment">//f是父类对象，子类的实例aaa不能指向f</span></span><br><span class="line">  aaa.myMore(); </span><br><span class="line">&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>向下转型指向子类对象，所以调用子类的方法。</p><p>组合(Composition)体现的是整体与部分、拥有的关系，即has-a的关系，组合通过对现有的对象进行拼装产生新的、更复杂的功能。<br>推荐多使用组合的形式编写代码。</p><p><strong>继承与组合优缺点</strong></p><table><thead><tr><th align="center">组合关系</th><th align="center">继承关系</th></tr></thead><tbody><tr><td align="center">优点：不破坏封装，整体类与局部类之间松耦合，彼此相对独立</td><td align="center">缺点：破坏封装，子类与父类之间耦合，子类依赖于父类的实现</td></tr><tr><td align="center">优点：具有较好的可拓展性</td><td align="center">缺点：支持扩展，但通常会增加系统结构复杂度</td></tr><tr><td align="center">优点：支持动态组合，在运行时整体对象可以选择不同类型的局部对象</td><td align="center">缺点：不支持动态继承，运行时子类无法选择不同的父类</td></tr><tr><td align="center">优点：整体可以对局部类进行包装，封装局部类的接口，提供新接口</td><td align="center">缺点：子类不能改变父类接口</td></tr><tr><td align="center">缺点：整体类不能自动获得和局部类同样的接口</td><td align="center">优点：子类自动继承父类接口</td></tr><tr><td align="center">缺点：创建整体类的对象时，需要创建所有局部类的对象</td><td align="center">优点：创建子类对象时，无需创建父类对象</td></tr></tbody></table><h3 id="多态"><a href="#多态" class="headerlink" title="多态"></a>多态</h3><p>多态指，针对某个类型的方法调用，其真正执行的方法取决于运行时期实际类型的方法。<br>多态的三个必要条件：继承、重写、向上转型</p><h2 id="接口"><a href="#接口" class="headerlink" title="接口"></a>接口</h2><h2 id="容器"><a href="#容器" class="headerlink" title="容器"></a>容器</h2><h2 id="异常"><a href="#异常" class="headerlink" title="异常"></a>异常</h2><h2 id="泛型"><a href="#泛型" class="headerlink" title="泛型"></a>泛型</h2><h2 id="反射"><a href="#反射" class="headerlink" title="反射"></a>反射</h2><p>Java反射机制是指在运行状态中，对于任意一个类，都能够知道这个类的所有属性和方法；对于任意一个对象，都能够调用它的任意一个方法和属性；这种动态获取信息和调用对象的方法的功能即为反射。</p><h2 id="注解"><a href="#注解" class="headerlink" title="注解"></a>注解</h2><h2 id="I-O"><a href="#I-O" class="headerlink" title="I/O"></a>I/O</h2><h2 id="图形化-Swing"><a href="#图形化-Swing" class="headerlink" title="图形化(Swing)"></a>图形化(Swing)</h2>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;面向对象&quot;&gt;&lt;a href=&quot;#面向对象&quot; class=&quot;headerlink&quot; title=&quot;面向对象&quot;&gt;&lt;/a&gt;面向对象&lt;/h2&gt;&lt;p&gt;基本数据类型和引用数据类型传参的区别&lt;/p&gt;
&lt;p&gt;Java内存空间&lt;br&gt;栈区：&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;每个线程包含一个栈区，栈中只保存基础数据类型的值和对象的引用，当一段代码或一个方法调用完毕后，栈中为这段代码提供的基本数据类型或对象的引用被立即释放。&lt;/li&gt;
&lt;li&gt;每个栈中的数据(原始类型和对象引用)私有，其他栈不能访问。&lt;/li&gt;
&lt;li&gt;栈分为3个部分：基本类型变量区、执行环境上下文、操作指令去(存放操作指令)。&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;堆区：&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;存储的都是对象，每个对象都包含一个与之对应的class信息。(class用来得到操作指令)&lt;/li&gt;
&lt;li&gt;Jvm只有一个堆区(heap)被所有线程共享，堆中不存放基本类型和对象引用，只存放对象本身。&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;方法区&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;也叫静态区，和堆一样，被所有线程共享，方法区包含所有的class和static变量。&lt;/li&gt;
&lt;li&gt;方法区中包含的都是在整个程序中永远唯一的元素，如class，static变量。&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;&lt;img src=&quot;https://user-images.githubusercontent.com/33156501/81540262-f655ec80-93a3-11ea-9879-0c45124a433c.png&quot; alt=&quot;内存空间&quot;&gt;&lt;br&gt;1.整数、浮点数、字符为基本数据类型。&lt;br&gt;2.字符串、数组为引用类型(内存数据的索引)。&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;基本数据类型参数的传递，是调用方值的复制，其各自的后续修改，互不影响。&lt;/li&gt;
&lt;li&gt;引用数据类型参数的传递，若在方法体中修改形参指向的数据内容，则会对实参变量的数值产生影响，因为形参和实参变量共享同一块堆区。&lt;/li&gt;
&lt;li&gt;当使用引用数据类型作为方法的形参时，若在方法体中修改形参变量的指向，此时不会对实参变量的数值产生影响，因为此时形参变量和实参变量分别指向不同的堆区。&lt;/li&gt;
&lt;/ul&gt;
    
    </summary>
    
    
      <category term="语言基础" scheme="https://zrbac.github.io/categories/%E8%AF%AD%E8%A8%80%E5%9F%BA%E7%A1%80/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>红黑树算法、原理分析</title>
    <link href="https://zrbac.github.io/2019/12/24/%E7%BA%A2%E9%BB%91%E6%A0%91%E7%AE%97%E6%B3%95%E3%80%81%E5%8E%9F%E7%90%86%E5%88%86%E6%9E%90/"/>
    <id>https://zrbac.github.io/2019/12/24/%E7%BA%A2%E9%BB%91%E6%A0%91%E7%AE%97%E6%B3%95%E3%80%81%E5%8E%9F%E7%90%86%E5%88%86%E6%9E%90/</id>
    <published>2019-12-24T05:00:47.000Z</published>
    <updated>2020-07-08T02:58:22.696Z</updated>
    
    <content type="html"><![CDATA[<h3 id="红黑树"><a href="#红黑树" class="headerlink" title="红黑树"></a>红黑树</h3><p>Red-Black Tree，自平衡(整体较平衡)的二叉查找树，查找性能较高。</p><p>五个重要特性：</p><ul><li>节点为红色或黑色</li><li>根为黑色</li><li>叶子（NIL节点）节点为黑色</li><li>每个红色节点必须有两个黑色子节点（从每个叶子到根的所有路径上不能有连续的两个红色节点）</li><li>从任一节点到其每个叶子（NIL节点）的所有简单路径都包含相同数目的黑色节点</li></ul><p>以上性质保证了红黑树具有：<br><strong>从根到叶子的最长可能路径不多于最短可能路径的两倍</strong>（因为红黑树中最短可能路径都是黑色节点，最长可能路径为红黑节点交替，而两者由于性质4具有相同数量的黑色节点）<br>这一特征。从而使其在大致上是平衡的，插入、删除、查找操作的最坏情况与树的高度成比例，不会出现左右子树极其失衡的情况</p><p>下图为一红黑树：<br><img src="https://user-images.githubusercontent.com/33156501/86772988-9a4bd380-c087-11ea-8715-677b69c67d4e.png" alt="红黑树示例"></p><a id="more"></a><h3 id="红黑树插入操作"><a href="#红黑树插入操作" class="headerlink" title="红黑树插入操作"></a>红黑树插入操作</h3><p>插入操作分为两步：</p><ul><li>找到新节点在红黑树中插入的位置</li><li>调整红黑树，使其满足红黑树的5个特性</li></ul><p>重点为第二步，调整红黑树的方式也可分为两种</p><ul><li>重新定色(recolor)</li><li>旋转操作(rotation)</li></ul><p>首先recolor，若调整颜色后仍无法满足红黑树的性质，则需要进一步rotation。</p><p><strong>具体方式</strong></p><ul><li><p><strong>1.假设新插入节点为X，标记其为红色（保证性质5）</strong></p></li><li><p><strong>2.若X为root，标记为黑色</strong></p></li><li><p><strong>3.若X父节点为黑色，无需处理</strong></p></li><li><p><strong>4.若X父节点为红色：</strong></p><ul><li>① 若X叔父节点也为红色：<ul><li>将父节点与叔父节点标记为黑色</li><li>将祖父节点标记为红色</li><li>对X的祖父节点重复<strong>2、3</strong>操作</li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86773108-c6ffeb00-c087-11ea-8eb8-2e9eb3abb18a.png" alt="父红叔父红"></p><ul><li>② 若X叔父节点为黑色，可分为四种情况：<ul><li>左左（<strong>X为父P左节点，X父P为祖父G左节点</strong>）<br>对祖父G进行右旋，然后交换父P和祖父G的颜色</li></ul></li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86773113-ca937200-c087-11ea-9911-fd7d1553b965.png" alt="父红叔父黑左左"></p><ul><li><ul><li><ul><li>左右（<strong>P为G左节点，X为P右节点</strong>）<br>先对P进行左旋，用X节点替换P节点，再应用左左情况进行处理 </li></ul></li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86773708-7a68df80-c088-11ea-8581-e21ccdbc64f2.png" alt="父红叔父黑左右"></p><ul><li><ul><li><ul><li>右右（<strong>P为G右节点，X为P右节点</strong>）<br>对G进行左旋，然后交换P、G的颜色</li></ul></li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86773867-9cfaf880-c088-11ea-8138-33999d3166f7.png" alt="父红叔父黑右右"></p><ul><li><ul><li><ul><li>右左（<strong>P为G右节点，X为P左节点</strong>）<br>先对P进行右旋，用X节点替换P节点，再应用右右情况进行处理</li></ul></li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86773888-a1271600-c088-11ea-97eb-2e3d38c91a03.png" alt="父红叔父黑右左"></p><h3 id="红黑树删除操作"><a href="#红黑树删除操作" class="headerlink" title="红黑树删除操作"></a>红黑树删除操作</h3><p>基本思路</p><ul><li>删除节点：<ul><li>若删除的节点无子节点，则直接删除</li><li>若删除的节点有一个子节点，删除节点后，子节点顶替</li><li>若删除的节点有两个子节点，可将问题转换为删除另一个只有一个子节点的节点</li></ul></li><li>节点删除后，调整红黑树使其满足性质</li></ul><p><strong>删除带有两个子节点的节点</strong></p><ul><li>在删除有两个子节点的节点时，可以去寻找左子树的最大元素或者右子树的最小元素，将其值复制给要删除的节点（颜色不复制），然后删除找到的这个节点。</li></ul><p>如下图所示：</p><p><img src="https://user-images.githubusercontent.com/33156501/86774444-21e61200-c089-11ea-98cf-206f996b53e0.png" alt="删除两子节点节点"><br>（图中使用的是左子树最大元素6替换8，实际也可用右子树最小值来替换）</p><ul><li><p><strong>删除有一个子节点的节点操作（删除X，其子节点为N）</strong></p><ul><li>X为红色，删除后用N替换，红黑树性质未破坏</li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86774587-42ae6780-c089-11ea-9256-1f07cb8a1522.png" alt="删红"></p><ul><li><strong>X为黑色：</strong><ul><li><strong>子节点N为红色</strong><br>删除X后用N替换，由于经过N的路径上少了一个黑色节点，所以将其改为黑色</li><li><strong>子节点N为黑色：</strong><ul><li><strong>1.节点X为根</strong><br>N成为新根，在所有路径上少了一个黑色节点， 但也多了一个黑色根，故红黑树性质未破坏</li><li><strong>2.兄弟节点S为红色</strong><br>对节点P左旋，互换P和S的颜色，然后按照<strong>步骤4、5、6进行处理</strong></li></ul></li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86775384-ebf55d80-c089-11ea-9bc7-4c1e43c6bca9.png" alt="删黑子黑弟红"></p><ul><li><ul><li><strong>3.节点P、S、S的子节点均为黑色</strong><br>将节点S改为红色，转换为<strong>步骤2处理</strong></li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86775448-f7e11f80-c089-11ea-814d-d8ef5874869a.png" alt="删黑父红弟侄黑"></p><ul><li><ul><li><strong>4.节点P是红色，节点S和S子节点为黑色</strong><br>交换节点p和S的颜色即可。经过S的路径上黑色节点数不变，经过N的路径新增黑色节点P，正好填补了删除的黑色节点X</li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86775680-28c15480-c08a-11ea-867b-b70572a36f3a.png" alt="删黑父红弟侄黑"></p><ul><li><ul><li><strong>5.节点S为黑，S左子节点为红，S右子节点为黑，且N是P的左子节点</strong><br>对节点S右旋，交换L和S的颜色，然后按照<strong>步骤6处理</strong></li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86776165-91103600-c08a-11ea-9fc5-e2d3c9430ec0.png" alt="删黑父红弟黑左侄红右侄黑"></p><ul><li><ul><li><strong>6.节点S为黑，S右子节点为红，N为P左子节点</strong><br>对节点p左旋，交换S和P的颜色，并将R改为黑色。如此，路径经过节点N、L、R的黑色数目保持不变</li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/86776177-940b2680-c08a-11ea-8919-ff1284b2758b.png" alt="删黑弟黑右侄红"></p></li></ul><h3 id="红黑树源码"><a href="#红黑树源码" class="headerlink" title="红黑树源码"></a>红黑树源码</h3>  <figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">...</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;红黑树&quot;&gt;&lt;a href=&quot;#红黑树&quot; class=&quot;headerlink&quot; title=&quot;红黑树&quot;&gt;&lt;/a&gt;红黑树&lt;/h3&gt;&lt;p&gt;Red-Black Tree，自平衡(整体较平衡)的二叉查找树，查找性能较高。&lt;/p&gt;
&lt;p&gt;五个重要特性：&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;节点为红色或黑色&lt;/li&gt;
&lt;li&gt;根为黑色&lt;/li&gt;
&lt;li&gt;叶子（NIL节点）节点为黑色&lt;/li&gt;
&lt;li&gt;每个红色节点必须有两个黑色子节点（从每个叶子到根的所有路径上不能有连续的两个红色节点）&lt;/li&gt;
&lt;li&gt;从任一节点到其每个叶子（NIL节点）的所有简单路径都包含相同数目的黑色节点&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;以上性质保证了红黑树具有：&lt;br&gt;&lt;strong&gt;从根到叶子的最长可能路径不多于最短可能路径的两倍&lt;/strong&gt;（因为红黑树中最短可能路径都是黑色节点，最长可能路径为红黑节点交替，而两者由于性质4具有相同数量的黑色节点）&lt;br&gt;这一特征。从而使其在大致上是平衡的，插入、删除、查找操作的最坏情况与树的高度成比例，不会出现左右子树极其失衡的情况&lt;/p&gt;
&lt;p&gt;下图为一红黑树：&lt;br&gt;&lt;img src=&quot;https://user-images.githubusercontent.com/33156501/86772988-9a4bd380-c087-11ea-8715-677b69c67d4e.png&quot; alt=&quot;红黑树示例&quot;&gt;&lt;/p&gt;
    
    </summary>
    
    
      <category term="数据结构" scheme="https://zrbac.github.io/categories/%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>HashMap 源码分析</title>
    <link href="https://zrbac.github.io/2019/12/23/HashMap-%E6%BA%90%E7%A0%81%E5%88%86%E6%9E%90/"/>
    <id>https://zrbac.github.io/2019/12/23/HashMap-%E6%BA%90%E7%A0%81%E5%88%86%E6%9E%90/</id>
    <published>2019-12-23T02:09:22.000Z</published>
    <updated>2019-12-24T12:36:23.109Z</updated>
    
    <content type="html"><![CDATA[<h2 id="HashMap概述"><a href="#HashMap概述" class="headerlink" title="HashMap概述"></a>HashMap概述</h2><p>HashMap时常用的Java集合之一，是基于哈希表的Map接口的实现。HashMap的底层是哈希数组，数组元素为Entry，HashMap通过key的hashCode来计算hash值，当hashCode相同时，通过“拉链法”解决冲突。</p><h2 id="HashMap数据结构"><a href="#HashMap数据结构" class="headerlink" title="HashMap数据结构"></a>HashMap数据结构</h2><p>在jdk1.8之后，解决哈希冲突的方式有了较大变化，当链表长度大于阈值(默认为8)时，将链表转化为红黑树，以减少搜索时间，原本Map.Entry接口的实现类Entry改名为Node，转化为红黑树时改用另一种实现TreeNode。</p><a id="more"></a><p><strong>Node类</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">static</span> <span class="class"><span class="keyword">class</span> <span class="title">Node</span>&lt;<span class="title">K</span>,<span class="title">V</span>&gt; <span class="keyword">implements</span> <span class="title">Map</span>.<span class="title">Entry</span>&lt;<span class="title">K</span>,<span class="title">V</span>&gt; </span>&#123;</span><br><span class="line">        <span class="keyword">final</span> <span class="keyword">int</span> hash; <span class="comment">// 哈希值</span></span><br><span class="line">        <span class="keyword">final</span> K key;</span><br><span class="line">        V value;</span><br><span class="line">        Node&lt;K,V&gt; next; <span class="comment">// 指向下一个节点</span></span><br><span class="line"></span><br><span class="line">        Node(<span class="keyword">int</span> hash, K key, V value, Node&lt;K,V&gt; next) &#123;</span><br><span class="line">            <span class="keyword">this</span>.hash = hash;</span><br><span class="line">            <span class="keyword">this</span>.key = key;</span><br><span class="line">            <span class="keyword">this</span>.value = value;</span><br><span class="line">            <span class="keyword">this</span>.next = next;</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> K <span class="title">getKey</span><span class="params">()</span>        </span>&#123; <span class="keyword">return</span> key; &#125;</span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> V <span class="title">getValue</span><span class="params">()</span>      </span>&#123; <span class="keyword">return</span> value; &#125;</span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> String <span class="title">toString</span><span class="params">()</span> </span>&#123; <span class="keyword">return</span> key + <span class="string">"="</span> + value; &#125;</span><br><span class="line"></span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">int</span> <span class="title">hashCode</span><span class="params">()</span> </span>&#123;</span><br><span class="line">            <span class="keyword">return</span> Objects.hashCode(key) ^ Objects.hashCode(value);</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> V <span class="title">setValue</span><span class="params">(V newValue)</span> </span>&#123;</span><br><span class="line">            V oldValue = value;</span><br><span class="line">            value = newValue;</span><br><span class="line">            <span class="keyword">return</span> oldValue;</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="function"><span class="keyword">public</span> <span class="keyword">final</span> <span class="keyword">boolean</span> <span class="title">equals</span><span class="params">(Object o)</span> </span>&#123;</span><br><span class="line">            <span class="keyword">if</span> (o == <span class="keyword">this</span>)</span><br><span class="line">                <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">            <span class="keyword">if</span> (o <span class="keyword">instanceof</span> Map.Entry) &#123;</span><br><span class="line">                Map.Entry&lt;?,?&gt; e = (Map.Entry&lt;?,?&gt;)o;</span><br><span class="line">                <span class="keyword">if</span> (Objects.equals(key, e.getKey()) &amp;&amp;</span><br><span class="line">                    Objects.equals(value, e.getValue()))</span><br><span class="line">                    <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure><p><strong>TreeNode类</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">static</span> <span class="keyword">final</span> <span class="class"><span class="keyword">class</span> <span class="title">TreeNode</span>&lt;<span class="title">K</span>,<span class="title">V</span>&gt; <span class="keyword">extends</span> <span class="title">LinkedHashMap</span>.<span class="title">Entry</span>&lt;<span class="title">K</span>,<span class="title">V</span>&gt; </span>&#123;</span><br><span class="line">        TreeNode&lt;K,V&gt; parent;  <span class="comment">// red-black tree links</span></span><br><span class="line">        TreeNode&lt;K,V&gt; left;</span><br><span class="line">        TreeNode&lt;K,V&gt; right;</span><br><span class="line">        TreeNode&lt;K,V&gt; prev;    <span class="comment">// needed to unlink next upon deletion</span></span><br><span class="line">        <span class="keyword">boolean</span> red;</span><br><span class="line">        TreeNode(<span class="keyword">int</span> hash, K key, V val, Node&lt;K,V&gt; next) &#123;</span><br><span class="line">            <span class="keyword">super</span>(hash, key, val, next);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure><p>HashMap就是这样一个Entry（包括Node和TreeNode）数组，Node对象中包含键、值和hash值，next指向下一个Entry，用来处理哈希冲突。TreeNode对象包含指向父节点、子节点和前一个节点（移除对象时使用）的指针，以及表示红黑节点的boolean标识。</p><h2 id="HashMap源码分析"><a href="#HashMap源码分析" class="headerlink" title="HashMap源码分析"></a>HashMap源码分析</h2><h3 id="1、定位哈希桶数组索引位置"><a href="#1、定位哈希桶数组索引位置" class="headerlink" title="1、定位哈希桶数组索引位置"></a>1、定位哈希桶数组索引位置</h3><p>不管增加、删除、查找键值对，定位到哈希桶数组的位置都是很关键的第一步。前面说过HashMap的数据结构是“数组+链表+红黑树”的结合，所以我们当然希望这个HashMap里面的元素位置尽量分布均匀些，尽量使得每个位置上的元素数量只有一个，那么当我们用hash算法求得这个位置的时候，马上就可以知道对应位置的元素就是我们要的，不用遍历链表/红黑树，大大优化了查询的效率。HashMap定位数组索引位置，直接决定了hash方法的离散性能。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">// 代码1</span></span><br><span class="line"><span class="function"><span class="keyword">static</span> <span class="keyword">final</span> <span class="keyword">int</span> <span class="title">hash</span><span class="params">(Object key)</span> </span>&#123; <span class="comment">// 计算key的hash值</span></span><br><span class="line"><span class="keyword">int</span> h;</span><br><span class="line"><span class="comment">// 1.先拿到key的hashCode值; 2.将hashCode的高16位参与运算</span></span><br><span class="line"><span class="keyword">return</span> (key == <span class="keyword">null</span>) ? <span class="number">0</span> : (h = key.hashCode()) ^ (h &gt;&gt;&gt; <span class="number">16</span>);</span><br><span class="line">&#125;</span><br><span class="line"><span class="comment">// 代码2</span></span><br><span class="line"><span class="keyword">int</span> n = tab.length;</span><br><span class="line"><span class="comment">// 将(tab.length - 1) 与 hash值进行&amp;运算</span></span><br><span class="line"><span class="keyword">int</span> index = (n - <span class="number">1</span>) &amp; hash;</span><br><span class="line"><span class="comment">/*整个过程本质上就是三步：</span></span><br><span class="line"><span class="comment">拿到key的hashCode值</span></span><br><span class="line"><span class="comment">将hashCode的高位参与运算，重新计算hash值</span></span><br><span class="line"><span class="comment">将计算出来的hash值与(table.length - 1)进行&amp;运算</span></span><br><span class="line"><span class="comment">*/</span></span><br></pre></td></tr></table></figure><p>方法解读：</p><p>对于任意给定的对象，只要它的hashCode()返回值相同，那么计算得到的hash值总是相同的。我们首先想到的就是把hash值对table长度取模运算，这样一来，元素的分布相对来说是比较均匀的。</p><p>但是模运算消耗还是比较大的，我们知道计算机比较快的运算为位运算，因此JDK团队对取模运算进行了优化，使用上面代码2的位与运算来代替模运算。这个方法非常巧妙，它通过 “(table.length -1) &amp; h” 来得到该对象的索引位置，这个优化是基于以下公式：x mod 2^n = x &amp; (2^n - 1)。我们知道HashMap底层数组的长度总是2的n次方，并且取模运算为”h mod table.length”，对应上面的公式，可以得到该运算等同于”h &amp; (table.length - 1)”。这是HashMap在速度上的优化，因为&amp;比%具有更高的效率。</p><p>在JDK1.8的实现中，还优化了高位运算的算法，将hashCode的高16位与hashCode进行异或运算，主要是为了在table的length较小的时候，让高位也参与运算，并且不会有太大的开销</p><h3 id="2、主要属性"><a href="#2、主要属性" class="headerlink" title="2、主要属性"></a>2、主要属性</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">transient</span> Node&lt;K,V&gt;[] table;            <span class="comment">//哈希数组</span></span><br><span class="line"><span class="keyword">transient</span> Set&lt;Map.Entry&lt;K,V&gt;&gt; entrySet  <span class="comment">//entry缓存Set</span></span><br><span class="line"><span class="keyword">transient</span> <span class="keyword">int</span> size;                     <span class="comment">//元素个数</span></span><br><span class="line"><span class="keyword">transient</span> <span class="keyword">int</span> modCount;                 <span class="comment">//修改次数</span></span><br><span class="line"><span class="keyword">int</span> threhold;     <span class="comment">//阈值，等于加载因子*容量，当实际大小超过阈值时进行扩容</span></span><br><span class="line"><span class="keyword">final</span> <span class="keyword">float</span> loadFactor;                 <span class="comment">//加载因子，默认为0.75</span></span><br></pre></td></tr></table></figure><h3 id="3、构造方法"><a href="#3、构造方法" class="headerlink" title="3、构造方法"></a>3、构造方法</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment">     * 根据初始化容量和加载因子构建一个空的HashMap.</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">HashMap</span><span class="params">(<span class="keyword">int</span> initialCapacity, <span class="keyword">float</span> loadFactor)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span> (initialCapacity &lt; <span class="number">0</span>)</span><br><span class="line">            <span class="keyword">throw</span> <span class="keyword">new</span> IllegalArgumentException(<span class="string">"Illegal initial capacity: "</span> +</span><br><span class="line">                                               initialCapacity);</span><br><span class="line">        <span class="keyword">if</span> (initialCapacity &gt; MAXIMUM_CAPACITY)</span><br><span class="line">            initialCapacity = MAXIMUM_CAPACITY;</span><br><span class="line">        <span class="keyword">if</span> (loadFactor &lt;= <span class="number">0</span> || Float.isNaN(loadFactor))</span><br><span class="line">            <span class="keyword">throw</span> <span class="keyword">new</span> IllegalArgumentException(<span class="string">"Illegal load factor: "</span> +</span><br><span class="line">                                               loadFactor);</span><br><span class="line">        <span class="keyword">this</span>.loadFactor = loadFactor;</span><br><span class="line">        <span class="keyword">this</span>.threshold = tableSizeFor(initialCapacity);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">/**</span></span><br><span class="line"><span class="comment">     * 使用初始化容量和默认加载因子(0.75).</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">HashMap</span><span class="params">(<span class="keyword">int</span> initialCapacity)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">this</span>(initialCapacity, DEFAULT_LOAD_FACTOR);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">/**</span></span><br><span class="line"><span class="comment">     * 使用默认初始化大小(16)和默认加载因子(0.75).</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">HashMap</span><span class="params">()</span> </span>&#123;</span><br><span class="line">        <span class="keyword">this</span>.loadFactor = DEFAULT_LOAD_FACTOR; <span class="comment">// all other fields defaulted</span></span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">/**</span></span><br><span class="line"><span class="comment">     * 用已有的Map构造一个新的HashMap.</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="title">HashMap</span><span class="params">(Map&lt;? extends K, ? extends V&gt; m)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">this</span>.loadFactor = DEFAULT_LOAD_FACTOR;</span><br><span class="line">        putMapEntries(m, <span class="keyword">false</span>);</span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure><h3 id="4、数据存取"><a href="#4、数据存取" class="headerlink" title="4、数据存取"></a>4、数据存取</h3><p><strong><code>putAll</code>方法</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">putAll</span><span class="params">(Map&lt;? extends K, ? extends V&gt; m)</span> </span>&#123;</span><br><span class="line">        putMapEntries(m, <span class="keyword">true</span>);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">/**</span></span><br><span class="line"><span class="comment">     * Implements Map.putAll and Map constructor</span></span><br><span class="line"><span class="comment">     *</span></span><br><span class="line"><span class="comment">     * <span class="doctag">@param</span> m the map</span></span><br><span class="line"><span class="comment">     * <span class="doctag">@param</span> evict false when initially constructing this map, else</span></span><br><span class="line"><span class="comment">     * true (relayed to method afterNodeInsertion).</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    <span class="function"><span class="keyword">final</span> <span class="keyword">void</span> <span class="title">putMapEntries</span><span class="params">(Map&lt;? extends K, ? extends V&gt; m, <span class="keyword">boolean</span> evict)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> s = m.size();</span><br><span class="line">        <span class="keyword">if</span> (s &gt; <span class="number">0</span>) &#123;</span><br><span class="line">            <span class="keyword">if</span> (table == <span class="keyword">null</span>) &#123; <span class="comment">// pre-size</span></span><br><span class="line">                <span class="keyword">float</span> ft = ((<span class="keyword">float</span>)s / loadFactor) + <span class="number">1.0F</span>;</span><br><span class="line">                <span class="keyword">int</span> t = ((ft &lt; (<span class="keyword">float</span>)MAXIMUM_CAPACITY) ?</span><br><span class="line">                         (<span class="keyword">int</span>)ft : MAXIMUM_CAPACITY);</span><br><span class="line">                <span class="keyword">if</span> (t &gt; threshold)</span><br><span class="line">                    threshold = tableSizeFor(t);</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="keyword">else</span> <span class="keyword">if</span> (s &gt; threshold)</span><br><span class="line">                resize();</span><br><span class="line">            <span class="keyword">for</span> (Map.Entry&lt;? extends K, ? extends V&gt; e : m.entrySet()) &#123;</span><br><span class="line">                K key = e.getKey();</span><br><span class="line">                V value = e.getValue();</span><br><span class="line">                putVal(hash(key), key, value, <span class="keyword">false</span>, evict); <span class="comment">// put核心方法</span></span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure><p><strong><code>put</code>方法</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> V <span class="title">put</span><span class="params">(K key, V value)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">return</span> putVal(hash(key), key, value, <span class="keyword">false</span>, <span class="keyword">true</span>);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">final</span> V <span class="title">putVal</span><span class="params">(<span class="keyword">int</span> hash, K key, V value, <span class="keyword">boolean</span> onlyIfAbsent,</span></span></span><br><span class="line"><span class="function"><span class="params">                   <span class="keyword">boolean</span> evict)</span> </span>&#123;</span><br><span class="line">        Node&lt;K,V&gt;[] tab; Node&lt;K,V&gt; p; <span class="keyword">int</span> n, i;</span><br><span class="line">        <span class="keyword">if</span> ((tab = table) == <span class="keyword">null</span> || (n = tab.length) == <span class="number">0</span>) <span class="comment">// table为空或length为0</span></span><br><span class="line">            n = (tab = resize()).length; <span class="comment">// 初始化</span></span><br><span class="line">        <span class="keyword">if</span> ((p = tab[i = (n - <span class="number">1</span>) &amp; hash]) == <span class="keyword">null</span>) <span class="comment">// 如果hash所在位置为null，直接put</span></span><br><span class="line">            tab[i] = newNode(hash, key, value, <span class="keyword">null</span>);</span><br><span class="line">        <span class="keyword">else</span> &#123; <span class="comment">// tab[i]有元素，遍历节点后添加</span></span><br><span class="line">            Node&lt;K,V&gt; e; K k;</span><br><span class="line">            <span class="comment">// 如果hash、key都相等，直接覆盖</span></span><br><span class="line">            <span class="keyword">if</span> (p.hash == hash &amp;&amp;</span><br><span class="line">                ((k = p.key) == key || (key != <span class="keyword">null</span> &amp;&amp; key.equals(k))))</span><br><span class="line">                e = p;</span><br><span class="line">            <span class="keyword">else</span> <span class="keyword">if</span> (p <span class="keyword">instanceof</span> TreeNode) <span class="comment">// 红黑树添加节点</span></span><br><span class="line">                e = ((TreeNode&lt;K,V&gt;)p).putTreeVal(<span class="keyword">this</span>, tab, hash, key, value);</span><br><span class="line">            <span class="keyword">else</span> &#123; <span class="comment">// 链表</span></span><br><span class="line">                <span class="keyword">for</span> (<span class="keyword">int</span> binCount = <span class="number">0</span>; ; ++binCount) &#123;</span><br><span class="line">                    <span class="keyword">if</span> ((e = p.next) == <span class="keyword">null</span>) &#123; <span class="comment">// 找到链表最后一个节点，插入新节点</span></span><br><span class="line">                        p.next = newNode(hash, key, value, <span class="keyword">null</span>);</span><br><span class="line">                        <span class="comment">// 链表节点大于阈值8，调用treeifyBin方法，当tab.length大于64将链表改为红黑树</span></span><br><span class="line">                        <span class="comment">// 如果tab.length &lt; 64或tab为null，则调用resize方法重构链表.</span></span><br><span class="line">                        <span class="keyword">if</span> (binCount &gt;= TREEIFY_THRESHOLD - <span class="number">1</span>) <span class="comment">// -1 for 1st</span></span><br><span class="line">                            treeifyBin(tab, hash);</span><br><span class="line">                        <span class="keyword">break</span>;</span><br><span class="line">                    &#125;</span><br><span class="line">                    <span class="comment">// hash、key都相等，此时节点即要更新节点</span></span><br><span class="line">                    <span class="keyword">if</span> (e.hash == hash &amp;&amp;</span><br><span class="line">                        ((k = e.key) == key || (key != <span class="keyword">null</span> &amp;&amp; key.equals(k))))</span><br><span class="line">                        <span class="keyword">break</span>;</span><br><span class="line">                    p = e;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="comment">// 当前节点e = p.next不为null，表示链表中原本存在相同的key，则返回oldValue</span></span><br><span class="line">            <span class="keyword">if</span> (e != <span class="keyword">null</span>) &#123; <span class="comment">// existing mapping for key</span></span><br><span class="line">                V oldValue = e.value;</span><br><span class="line">                <span class="comment">// onlyIfAbsent值为false，参数主要决定存在相同key时是否执行替换</span></span><br><span class="line">                <span class="keyword">if</span> (!onlyIfAbsent || oldValue == <span class="keyword">null</span>)</span><br><span class="line">                    e.value = value;</span><br><span class="line">                afterNodeAccess(e);</span><br><span class="line">                <span class="keyword">return</span> oldValue;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        ++modCount;</span><br><span class="line">        <span class="keyword">if</span> (++size &gt; threshold) <span class="comment">// 检查是否超过阈值</span></span><br><span class="line">            resize();</span><br><span class="line">        afterNodeInsertion(evict);</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">null</span>; <span class="comment">// 原HashMap中不存在相同的key，插入键值对后返回null</span></span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure><p><strong><code>treeifyBin</code>方法</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">void</span> <span class="title">treeifyBin</span><span class="params">(Node&lt;K,V&gt;[] tab, <span class="keyword">int</span> hash)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> n, index; Node&lt;K,V&gt; e;</span><br><span class="line">        <span class="comment">//当tab为null或tab.length&lt;64需要进行扩容</span></span><br><span class="line">        <span class="keyword">if</span> (tab == <span class="keyword">null</span> || (n = tab.length) &lt; MIN_TREEIFY_CAPACITY)</span><br><span class="line">            resize();</span><br><span class="line">        <span class="keyword">else</span> <span class="keyword">if</span> ((e = tab[index = (n - <span class="number">1</span>) &amp; hash]) != <span class="keyword">null</span>) &#123;</span><br><span class="line">            TreeNode&lt;K,V&gt; hd = <span class="keyword">null</span>, tl = <span class="keyword">null</span>;</span><br><span class="line">            <span class="keyword">do</span> &#123;</span><br><span class="line">                TreeNode&lt;K,V&gt; p = replacementTreeNode(e, <span class="keyword">null</span>);</span><br><span class="line">                <span class="keyword">if</span> (tl == <span class="keyword">null</span>)</span><br><span class="line">                    hd = p;</span><br><span class="line">                <span class="keyword">else</span> &#123;</span><br><span class="line">                    p.prev = tl;</span><br><span class="line">                    tl.next = p;</span><br><span class="line">                &#125;</span><br><span class="line">                tl = p;</span><br><span class="line">            &#125; <span class="keyword">while</span> ((e = e.next) != <span class="keyword">null</span>);</span><br><span class="line">            <span class="keyword">if</span> ((tab[index] = hd) != <span class="keyword">null</span>)</span><br><span class="line">                <span class="comment">//存储在红黑树</span></span><br><span class="line">                hd.treeify(tab);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure><h3 id="5、get查找"><a href="#5、get查找" class="headerlink" title="5、get查找"></a>5、get查找</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> V <span class="title">get</span><span class="params">(Object key)</span> </span>&#123;</span><br><span class="line">        Node&lt;K,V&gt; e;</span><br><span class="line">        <span class="keyword">return</span> (e = getNode(hash(key), key)) == <span class="keyword">null</span> ? <span class="keyword">null</span> : e.value;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="comment">/**</span></span><br><span class="line"><span class="comment">     * Implements Map.get and related methods</span></span><br><span class="line"><span class="comment">     *</span></span><br><span class="line"><span class="comment">     * <span class="doctag">@param</span> hash hash for key</span></span><br><span class="line"><span class="comment">     * <span class="doctag">@param</span> key the key</span></span><br><span class="line"><span class="comment">     * <span class="doctag">@return</span> the node, or null if none</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    <span class="function"><span class="keyword">final</span> Node&lt;K,V&gt; <span class="title">getNode</span><span class="params">(<span class="keyword">int</span> hash, Object key)</span> </span>&#123;</span><br><span class="line">        Node&lt;K,V&gt;[] tab; Node&lt;K,V&gt; first, e; <span class="keyword">int</span> n; K k;</span><br><span class="line">        <span class="keyword">if</span> ((tab = table) != <span class="keyword">null</span> &amp;&amp; (n = tab.length) &gt; <span class="number">0</span> &amp;&amp;</span><br><span class="line">            (first = tab[(n - <span class="number">1</span>) &amp; hash]) != <span class="keyword">null</span>) &#123;</span><br><span class="line">            <span class="keyword">if</span> (first.hash == hash &amp;&amp; <span class="comment">// always check first node</span></span><br><span class="line">                ((k = first.key) == key || (key != <span class="keyword">null</span> &amp;&amp; key.equals(k))))</span><br><span class="line">                <span class="keyword">return</span> first;</span><br><span class="line">            <span class="keyword">if</span> ((e = first.next) != <span class="keyword">null</span>) &#123;</span><br><span class="line">                <span class="keyword">if</span> (first <span class="keyword">instanceof</span> TreeNode)</span><br><span class="line">                    <span class="keyword">return</span> ((TreeNode&lt;K,V&gt;)first).getTreeNode(hash, key);</span><br><span class="line">                <span class="keyword">do</span> &#123;</span><br><span class="line">                    <span class="keyword">if</span> (e.hash == hash &amp;&amp;</span><br><span class="line">                        ((k = e.key) == key || (key != <span class="keyword">null</span> &amp;&amp; key.equals(k))))</span><br><span class="line">                        <span class="keyword">return</span> e;</span><br><span class="line">                &#125; <span class="keyword">while</span> ((e = e.next) != <span class="keyword">null</span>);</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">null</span>;</span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure><h3 id="6、resize扩容"><a href="#6、resize扩容" class="headerlink" title="6、resize扩容"></a>6、resize扩容</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment">     * Initializes or doubles table size.  If null, allocates in</span></span><br><span class="line"><span class="comment">     * accord with initial capacity target held in field threshold.</span></span><br><span class="line"><span class="comment">     * Otherwise, because we are using power-of-two expansion, the</span></span><br><span class="line"><span class="comment">     * elements from each bin must either stay at same index, or move</span></span><br><span class="line"><span class="comment">     * with a power of two offset in the new table.</span></span><br><span class="line"><span class="comment">     *</span></span><br><span class="line"><span class="comment">     * <span class="doctag">@return</span> the table</span></span><br><span class="line"><span class="comment">     */</span></span><br><span class="line">    <span class="keyword">final</span> Node&lt;K,V&gt;[] resize() &#123;</span><br><span class="line">        Node&lt;K,V&gt;[] oldTab = table;</span><br><span class="line">        <span class="keyword">int</span> oldCap = (oldTab == <span class="keyword">null</span>) ? <span class="number">0</span> : oldTab.length;</span><br><span class="line">        <span class="keyword">int</span> oldThr = threshold;</span><br><span class="line">        <span class="keyword">int</span> newCap, newThr = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">if</span> (oldCap &gt; <span class="number">0</span>) &#123;</span><br><span class="line">            <span class="keyword">if</span> (oldCap &gt;= MAXIMUM_CAPACITY) &#123;</span><br><span class="line">                threshold = Integer.MAX_VALUE;</span><br><span class="line">                <span class="keyword">return</span> oldTab;</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="keyword">else</span> <span class="keyword">if</span> ((newCap = oldCap &lt;&lt; <span class="number">1</span>) &lt; MAXIMUM_CAPACITY &amp;&amp;</span><br><span class="line">                     oldCap &gt;= DEFAULT_INITIAL_CAPACITY)</span><br><span class="line">                newThr = oldThr &lt;&lt; <span class="number">1</span>; <span class="comment">// double threshold</span></span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">else</span> <span class="keyword">if</span> (oldThr &gt; <span class="number">0</span>) <span class="comment">// initial capacity was placed in threshold</span></span><br><span class="line">            newCap = oldThr;</span><br><span class="line">        <span class="keyword">else</span> &#123;               <span class="comment">// zero initial threshold signifies using defaults</span></span><br><span class="line">            newCap = DEFAULT_INITIAL_CAPACITY;</span><br><span class="line">            newThr = (<span class="keyword">int</span>)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">if</span> (newThr == <span class="number">0</span>) &#123;</span><br><span class="line">            <span class="keyword">float</span> ft = (<span class="keyword">float</span>)newCap * loadFactor;</span><br><span class="line">            newThr = (newCap &lt; MAXIMUM_CAPACITY &amp;&amp; ft &lt; (<span class="keyword">float</span>)MAXIMUM_CAPACITY ?</span><br><span class="line">                      (<span class="keyword">int</span>)ft : Integer.MAX_VALUE);</span><br><span class="line">        &#125;</span><br><span class="line">        threshold = newThr;</span><br><span class="line">        <span class="meta">@SuppressWarnings</span>(&#123;<span class="string">"rawtypes"</span>,<span class="string">"unchecked"</span>&#125;)</span><br><span class="line">            Node&lt;K,V&gt;[] newTab = (Node&lt;K,V&gt;[])<span class="keyword">new</span> Node[newCap];</span><br><span class="line">        table = newTab;</span><br><span class="line">        <span class="keyword">if</span> (oldTab != <span class="keyword">null</span>) &#123;</span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">0</span>; j &lt; oldCap; ++j) &#123;</span><br><span class="line">                Node&lt;K,V&gt; e;</span><br><span class="line">                <span class="keyword">if</span> ((e = oldTab[j]) != <span class="keyword">null</span>) &#123;</span><br><span class="line">                    oldTab[j] = <span class="keyword">null</span>;</span><br><span class="line">                    <span class="keyword">if</span> (e.next == <span class="keyword">null</span>)</span><br><span class="line">                        newTab[e.hash &amp; (newCap - <span class="number">1</span>)] = e;</span><br><span class="line">                    <span class="keyword">else</span> <span class="keyword">if</span> (e <span class="keyword">instanceof</span> TreeNode)</span><br><span class="line">                        ((TreeNode&lt;K,V&gt;)e).split(<span class="keyword">this</span>, newTab, j, oldCap);</span><br><span class="line">                    <span class="keyword">else</span> &#123; <span class="comment">// preserve order</span></span><br><span class="line">                        Node&lt;K,V&gt; loHead = <span class="keyword">null</span>, loTail = <span class="keyword">null</span>;</span><br><span class="line">                        Node&lt;K,V&gt; hiHead = <span class="keyword">null</span>, hiTail = <span class="keyword">null</span>;</span><br><span class="line">                        Node&lt;K,V&gt; next;</span><br><span class="line">                        <span class="keyword">do</span> &#123;</span><br><span class="line">                            next = e.next;</span><br><span class="line">                            <span class="keyword">if</span> ((e.hash &amp; oldCap) == <span class="number">0</span>) &#123;</span><br><span class="line">                                <span class="keyword">if</span> (loTail == <span class="keyword">null</span>)</span><br><span class="line">                                    loHead = e;</span><br><span class="line">                                <span class="keyword">else</span></span><br><span class="line">                                    loTail.next = e;</span><br><span class="line">                                loTail = e;</span><br><span class="line">                            &#125;</span><br><span class="line">                            <span class="keyword">else</span> &#123;</span><br><span class="line">                                <span class="keyword">if</span> (hiTail == <span class="keyword">null</span>)</span><br><span class="line">                                    hiHead = e;</span><br><span class="line">                                <span class="keyword">else</span></span><br><span class="line">                                    hiTail.next = e;</span><br><span class="line">                                hiTail = e;</span><br><span class="line">                            &#125;</span><br><span class="line">                        &#125; <span class="keyword">while</span> ((e = next) != <span class="keyword">null</span>);</span><br><span class="line">                        <span class="keyword">if</span> (loTail != <span class="keyword">null</span>) &#123;</span><br><span class="line">                            loTail.next = <span class="keyword">null</span>;</span><br><span class="line">                            newTab[j] = loHead;</span><br><span class="line">                        &#125;</span><br><span class="line">                        <span class="keyword">if</span> (hiTail != <span class="keyword">null</span>) &#123;</span><br><span class="line">                            hiTail.next = <span class="keyword">null</span>;</span><br><span class="line">                            <span class="comment">//把节点移动新的位置j+oldCap,这种情况不适用与链表的节点数大于8的情况</span></span><br><span class="line">                            <span class="comment">//链表节点大于8的情况会转换为红黑树存储</span></span><br><span class="line">                            newTab[j + oldCap] = hiHead;</span><br><span class="line">                        &#125;</span><br><span class="line">                    &#125;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> newTab;</span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure><h3 id="7、HashMap红黑树存储"><a href="#7、HashMap红黑树存储" class="headerlink" title="7、HashMap红黑树存储"></a>7、HashMap红黑树存储</h3><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">final</span> <span class="keyword">void</span> <span class="title">treeify</span><span class="params">(Node&lt;K,V&gt;[] tab)</span> </span>&#123;</span><br><span class="line">            TreeNode&lt;K,V&gt; root = <span class="keyword">null</span>;</span><br><span class="line">            <span class="keyword">for</span> (TreeNode&lt;K,V&gt; x = <span class="keyword">this</span>, next; x != <span class="keyword">null</span>; x = next) &#123;</span><br><span class="line">                next = (TreeNode&lt;K,V&gt;)x.next;</span><br><span class="line">                x.left = x.right = <span class="keyword">null</span>;</span><br><span class="line">                <span class="keyword">if</span> (root == <span class="keyword">null</span>) &#123;</span><br><span class="line">                    x.parent = <span class="keyword">null</span>;</span><br><span class="line">                    x.red = <span class="keyword">false</span>;</span><br><span class="line">                    root = x;</span><br><span class="line">                &#125;</span><br><span class="line">                <span class="keyword">else</span> &#123;</span><br><span class="line">                    K k = x.key;</span><br><span class="line">                    <span class="keyword">int</span> h = x.hash;</span><br><span class="line">                    Class&lt;?&gt; kc = <span class="keyword">null</span>;</span><br><span class="line">                    <span class="comment">//遍历root，把节点x插入到红黑树中，执行先插入，然后进行红黑树修正</span></span><br><span class="line">                    <span class="keyword">for</span> (TreeNode&lt;K,V&gt; p = root;;) &#123;</span><br><span class="line">                        <span class="keyword">int</span> dir, ph;</span><br><span class="line">                        K pk = p.key;</span><br><span class="line">                        <span class="keyword">if</span> ((ph = p.hash) &gt; h)</span><br><span class="line">                            dir = -<span class="number">1</span>;</span><br><span class="line">                        <span class="keyword">else</span> <span class="keyword">if</span> (ph &lt; h)</span><br><span class="line">                            dir = <span class="number">1</span>;</span><br><span class="line">                        <span class="keyword">else</span> <span class="keyword">if</span> ((kc == <span class="keyword">null</span> &amp;&amp;</span><br><span class="line">                                  (kc = comparableClassFor(k)) == <span class="keyword">null</span>) ||</span><br><span class="line">                                 (dir = compareComparables(kc, k, pk)) == <span class="number">0</span>)</span><br><span class="line">                            dir = tieBreakOrder(k, pk);<span class="comment">//比较k和pk的值，用于判断是遍历左子树还是右子树</span></span><br><span class="line">                        TreeNode&lt;K,V&gt; xp = p;</span><br><span class="line">                        <span class="keyword">if</span> ((p = (dir &lt;= <span class="number">0</span>) ? p.left : p.right) == <span class="keyword">null</span>) &#123;</span><br><span class="line">                            x.parent = xp;</span><br><span class="line">                            <span class="keyword">if</span> (dir &lt;= <span class="number">0</span>)</span><br><span class="line">                                xp.left = x;</span><br><span class="line">                            <span class="keyword">else</span></span><br><span class="line">                                xp.right = x;</span><br><span class="line">                            <span class="comment">//修正红黑树</span></span><br><span class="line">                            root = balanceInsertion(root, x);</span><br><span class="line">                            <span class="comment">//退出循环</span></span><br><span class="line">                            <span class="keyword">break</span>;</span><br><span class="line">                        &#125;</span><br><span class="line">                    &#125;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">            moveRootToFront(tab, root);</span><br><span class="line">        &#125;</span><br></pre></td></tr></table></figure><p>上面主要做的是红黑树的insert，我们知道红黑树insert后是需要修复的，为了保持红黑树的平衡，我们来看下红黑树平衡的几条性质：</p><ul><li>节点是红色或黑色。</li><li>根是黑色。</li><li>所有叶子都是黑色（叶子是NULL节点）。</li><li>每个红色节点必须有两个黑色的子节点。（从每个叶子到根的所有路径上不能有两个连续的红色节点。）</li><li>从任一节点到其每个叶子的所有简单路径都包含相同数目的黑色节点。</li></ul><p>当insert一个节点之后为了达到平衡，我们可能需要对节点进行旋转和颜色翻转（上面的balanceInsertion方法）。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">static</span> &lt;K,V&gt; <span class="function">TreeNode&lt;K,V&gt; <span class="title">balanceInsertion</span><span class="params">(TreeNode&lt;K,V&gt; root,</span></span></span><br><span class="line"><span class="function"><span class="params">                                                    TreeNode&lt;K,V&gt; x)</span> </span>&#123;</span><br><span class="line">            <span class="comment">//插入的节点必须是红色的，除非是根节点                                            </span></span><br><span class="line">            x.red = <span class="keyword">true</span>;</span><br><span class="line">            <span class="comment">//遍历到x节点为黑色,整个过程是一个上滤的过程</span></span><br><span class="line">            <span class="comment">//xp=x.parent;xpp=xp.parent;xppl=xpp.left;xppr=xpp.right;</span></span><br><span class="line">            <span class="keyword">for</span> (TreeNode&lt;K,V&gt; xp, xpp, xppl, xppr;;) &#123;</span><br><span class="line">                <span class="keyword">if</span> ((xp = x.parent) == <span class="keyword">null</span>) &#123;</span><br><span class="line">                    x.red = <span class="keyword">false</span>;</span><br><span class="line">                    <span class="keyword">return</span> x;</span><br><span class="line">                &#125;</span><br><span class="line">                <span class="comment">//如果xp的黑色就直接完成，最简单的情况</span></span><br><span class="line">                <span class="keyword">else</span> <span class="keyword">if</span> (!xp.red || (xpp = xp.parent) == <span class="keyword">null</span>)</span><br><span class="line">                    <span class="keyword">return</span> root;</span><br><span class="line">                <span class="comment">//如果x的父节点是x父节点的左节点</span></span><br><span class="line">                <span class="keyword">if</span> (xp == (xppl = xpp.left)) &#123;</span><br><span class="line">                    <span class="comment">//x的父亲节点的兄弟是红色的（需要颜色翻转）</span></span><br><span class="line">                    <span class="keyword">if</span> ((xppr = xpp.right) != <span class="keyword">null</span> &amp;&amp; xppr.red) &#123;</span><br><span class="line">                        <span class="comment">//x父亲节点的兄弟节点置成黑色</span></span><br><span class="line">                        xppr.red = <span class="keyword">false</span>;</span><br><span class="line">                        <span class="comment">//父几点和其兄弟节点一样是黑色</span></span><br><span class="line">                        xp.red = <span class="keyword">false</span>;</span><br><span class="line">                        <span class="comment">//祖父节点置成红色</span></span><br><span class="line">                        xpp.red = <span class="keyword">true</span>;</span><br><span class="line">                        <span class="comment">//然后上滤（就是不断的重复上面的操作）</span></span><br><span class="line">                        x = xpp;</span><br><span class="line">                    &#125;</span><br><span class="line">                    <span class="keyword">else</span> &#123;</span><br><span class="line">                        <span class="comment">//如果x是xp的右节点整个要进行两次旋转,先左旋转再右旋转</span></span><br><span class="line">                        <span class="keyword">if</span> (x == xp.right) &#123;</span><br><span class="line">                            root = rotateLeft(root, x = xp);</span><br><span class="line">                            xpp = (xp = x.parent) == <span class="keyword">null</span> ? <span class="keyword">null</span> : xp.parent;</span><br><span class="line">                        &#125;</span><br><span class="line">                        <span class="keyword">if</span> (xp != <span class="keyword">null</span>) &#123;</span><br><span class="line">                            xp.red = <span class="keyword">false</span>;</span><br><span class="line">                            <span class="keyword">if</span> (xpp != <span class="keyword">null</span>) &#123;</span><br><span class="line">                                xpp.red = <span class="keyword">true</span>;</span><br><span class="line">                                root = rotateRight(root, xpp);</span><br><span class="line">                            &#125;</span><br><span class="line">                        &#125;</span><br><span class="line">                    &#125;</span><br><span class="line">                &#125;</span><br><span class="line">                <span class="comment">//以左节点镜像对称就不做具体分析了 </span></span><br><span class="line">                <span class="keyword">else</span> &#123;</span><br><span class="line">                    <span class="keyword">if</span> (xppl != <span class="keyword">null</span> &amp;&amp; xppl.red) &#123;</span><br><span class="line">                        xppl.red = <span class="keyword">false</span>;</span><br><span class="line">                        xp.red = <span class="keyword">false</span>;</span><br><span class="line">                        xpp.red = <span class="keyword">true</span>;</span><br><span class="line">                        x = xpp;</span><br><span class="line">                    &#125;</span><br><span class="line">                    <span class="keyword">else</span> &#123;</span><br><span class="line">                        <span class="keyword">if</span> (x == xp.left) &#123;</span><br><span class="line">                            root = rotateRight(root, x = xp);</span><br><span class="line">                            xpp = (xp = x.parent) == <span class="keyword">null</span> ? <span class="keyword">null</span> : xp.parent;</span><br><span class="line">                        &#125;</span><br><span class="line">                        <span class="keyword">if</span> (xp != <span class="keyword">null</span>) &#123;</span><br><span class="line">                            xp.red = <span class="keyword">false</span>;</span><br><span class="line">                            <span class="keyword">if</span> (xpp != <span class="keyword">null</span>) &#123;</span><br><span class="line">                                xpp.red = <span class="keyword">true</span>;</span><br><span class="line">                                root = rotateLeft(root, xpp);</span><br><span class="line">                            &#125;</span><br><span class="line">                        &#125;</span><br><span class="line">                    &#125;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;HashMap概述&quot;&gt;&lt;a href=&quot;#HashMap概述&quot; class=&quot;headerlink&quot; title=&quot;HashMap概述&quot;&gt;&lt;/a&gt;HashMap概述&lt;/h2&gt;&lt;p&gt;HashMap时常用的Java集合之一，是基于哈希表的Map接口的实现。HashMap的底层是哈希数组，数组元素为Entry，HashMap通过key的hashCode来计算hash值，当hashCode相同时，通过“拉链法”解决冲突。&lt;/p&gt;
&lt;h2 id=&quot;HashMap数据结构&quot;&gt;&lt;a href=&quot;#HashMap数据结构&quot; class=&quot;headerlink&quot; title=&quot;HashMap数据结构&quot;&gt;&lt;/a&gt;HashMap数据结构&lt;/h2&gt;&lt;p&gt;在jdk1.8之后，解决哈希冲突的方式有了较大变化，当链表长度大于阈值(默认为8)时，将链表转化为红黑树，以减少搜索时间，原本Map.Entry接口的实现类Entry改名为Node，转化为红黑树时改用另一种实现TreeNode。&lt;/p&gt;
    
    </summary>
    
    
      <category term="数据结构" scheme="https://zrbac.github.io/categories/%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>leetcode 739 Daily Temperatures</title>
    <link href="https://zrbac.github.io/2019/12/20/leetcode-739-Daily-Temperatures/"/>
    <id>https://zrbac.github.io/2019/12/20/leetcode-739-Daily-Temperatures/</id>
    <published>2019-12-20T07:12:36.000Z</published>
    <updated>2019-12-24T12:36:23.112Z</updated>
    
    <content type="html"><![CDATA[<h3 id="leetcode-739-Daily-Temperatures"><a href="#leetcode-739-Daily-Temperatures" class="headerlink" title="leetcode 739 :Daily Temperatures"></a>leetcode 739 :Daily Temperatures</h3><p>Given a list of daily temperatures <code>T</code>, return a list such that, for each day in the input, tells you how many days you would have to wait until a warmer temperature. If there is no future day for which this is possible, put <code>0</code> instead.</p><p>For example, given the list of temperatures <code>T = [73, 74, 75, 71, 69, 72, 76, 73]</code>, your output should be <code>[1, 1, 4, 2, 1, 1, 0, 0]</code>.</p><a id="more"></a><h4 id="solution-one"><a href="#solution-one" class="headerlink" title="solution one"></a>solution one</h4><p><code>list</code>,process each <code>i</code> in reverse order.</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] dailyTemperatures(<span class="keyword">int</span>[] T) &#123;</span><br><span class="line">        <span class="keyword">int</span> n = T.length;</span><br><span class="line">        <span class="keyword">int</span>[] ans = <span class="keyword">new</span> <span class="keyword">int</span>[n];</span><br><span class="line">        <span class="keyword">int</span>[] next = <span class="keyword">new</span> <span class="keyword">int</span>[<span class="number">101</span>];</span><br><span class="line">        Arrays.fill(next, Integer.MAX_VALUE);</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i=n-<span class="number">1</span>;i&gt;=<span class="number">0</span>;i--)&#123;</span><br><span class="line">            <span class="keyword">int</span> hotter = Integer.MAX_VALUE;</span><br><span class="line">            <span class="keyword">for</span>(<span class="keyword">int</span> j=T[i]+<span class="number">1</span>;j&lt;=<span class="number">100</span>;j++)&#123;</span><br><span class="line">                <span class="keyword">if</span>(next[j]&lt;hotter)</span><br><span class="line">                    hotter = next[j];</span><br><span class="line">            &#125;</span><br><span class="line">            <span class="keyword">if</span>(hotter&lt;Integer.MAX_VALUE)&#123;</span><br><span class="line">                ans[i] = hotter - i;</span><br><span class="line">            &#125;</span><br><span class="line">            </span><br><span class="line">            next[T[i]] = i;</span><br><span class="line">                           </span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> ans;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="solution-two"><a href="#solution-two" class="headerlink" title="solution two"></a>solution two</h4><p><code>stack</code>, reverse order, remember a list of indices representing a strictly increasing list of tempertures, the top of the stack is the first value in the list at last.</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] dailyTemperatures(<span class="keyword">int</span>[] T) &#123;</span><br><span class="line">        <span class="keyword">int</span>[] ans = <span class="keyword">new</span> <span class="keyword">int</span> [T.length];</span><br><span class="line">        <span class="keyword">int</span> n = T.length;</span><br><span class="line">        Stack&lt;Integer&gt; stack = <span class="keyword">new</span> Stack();</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = n-<span class="number">1</span>; i&gt;= <span class="number">0</span>; i--)&#123;</span><br><span class="line">            <span class="keyword">while</span>(!stack.isEmpty()&amp;&amp;T[i]&gt;=T[stack.peek()])</span><br><span class="line">                stack.pop();</span><br><span class="line">            <span class="keyword">if</span>(stack.isEmpty())</span><br><span class="line">                ans[i] = <span class="number">0</span>;</span><br><span class="line">            <span class="keyword">else</span></span><br><span class="line">                ans[i] = stack.peek() - i;</span><br><span class="line">            stack.push(i);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> ans;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;leetcode-739-Daily-Temperatures&quot;&gt;&lt;a href=&quot;#leetcode-739-Daily-Temperatures&quot; class=&quot;headerlink&quot; title=&quot;leetcode 739 :Daily Temperatures&quot;&gt;&lt;/a&gt;leetcode 739 :Daily Temperatures&lt;/h3&gt;&lt;p&gt;Given a list of daily temperatures &lt;code&gt;T&lt;/code&gt;, return a list such that, for each day in the input, tells you how many days you would have to wait until a warmer temperature. If there is no future day for which this is possible, put &lt;code&gt;0&lt;/code&gt; instead.&lt;/p&gt;
&lt;p&gt;For example, given the list of temperatures &lt;code&gt;T = [73, 74, 75, 71, 69, 72, 76, 73]&lt;/code&gt;, your output should be &lt;code&gt;[1, 1, 4, 2, 1, 1, 0, 0]&lt;/code&gt;.&lt;/p&gt;
    
    </summary>
    
    
      <category term="leetcode" scheme="https://zrbac.github.io/categories/leetcode/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>leetcode 647 palindromic substrings</title>
    <link href="https://zrbac.github.io/2019/12/20/leetcode-647-palindromic-substrings/"/>
    <id>https://zrbac.github.io/2019/12/20/leetcode-647-palindromic-substrings/</id>
    <published>2019-12-20T07:11:05.000Z</published>
    <updated>2019-12-24T12:36:23.112Z</updated>
    
    <content type="html"><![CDATA[<h3 id="leetcode-647-palindromic-substrings"><a href="#leetcode-647-palindromic-substrings" class="headerlink" title="leetcode 647 palindromic substrings"></a>leetcode 647 palindromic substrings</h3><p>Given a string, your task is to count how many palindromic substrings in this string.</p><p>The substrings with different start indexes or end indexes are counted as different substrings even they consist of same characters.</p><p><strong>Example 1:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">Input: &quot;abc&quot;</span><br><span class="line">Output: 3</span><br><span class="line">Explanation: Three palindromic strings: &quot;a&quot;, &quot;b&quot;, &quot;c&quot;.</span><br></pre></td></tr></table></figure><p><strong>Example 2:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">Input: &quot;aaa&quot;</span><br><span class="line">Output: 6</span><br><span class="line">Explanation: Six palindromic strings: &quot;a&quot;, &quot;a&quot;, &quot;a&quot;, &quot;aa&quot;, &quot;aa&quot;, &quot;aaa&quot;.</span><br></pre></td></tr></table></figure><hr><a id="more"></a><h4 id="solution-one"><a href="#solution-one" class="headerlink" title="solution one"></a>solution one</h4><p><code>expand around center</code></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span></span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">countSubstrings</span><span class="params">(String s)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> res = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">int</span> n = s.length();</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i= <span class="number">0</span>; i &lt; n; i++)&#123;</span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">0</span>; i-j &gt;= <span class="number">0</span> &amp;&amp; i+j &lt; n &amp;&amp; s.charAt(i-j) == s.charAt(i+j); j++)</span><br><span class="line">                res++;</span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">0</span>; i-j-<span class="number">1</span> &gt;= <span class="number">0</span> &amp;&amp; i+j &lt; n &amp;&amp; s.charAt(i-j-<span class="number">1</span>) == s.charAt(i+j); j++)</span><br><span class="line">                res++;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> res;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="solution-two"><a href="#solution-two" class="headerlink" title="solution two"></a>solution two</h4><p><code>dp</code></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">int</span> <span class="title">countSubstrings</span><span class="params">(String s)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">int</span> res = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">int</span> n = s.length();</span><br><span class="line">        <span class="keyword">boolean</span> dp[][] = <span class="keyword">new</span> <span class="keyword">boolean</span>[n][n];</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; n; i++) &#123;</span><br><span class="line">            <span class="keyword">for</span> ( <span class="keyword">int</span> j = i; j &gt;= <span class="number">0</span>; j--) &#123;</span><br><span class="line">                dp[i][j] = (s.charAt(i) == s.charAt(j)) &amp;&amp; (i-j &lt; <span class="number">3</span> || dp[i-<span class="number">1</span>][j+<span class="number">1</span>]);</span><br><span class="line">                <span class="keyword">if</span> (dp[i][j])&#123;</span><br><span class="line">                    res++;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;leetcode-647-palindromic-substrings&quot;&gt;&lt;a href=&quot;#leetcode-647-palindromic-substrings&quot; class=&quot;headerlink&quot; title=&quot;leetcode 647 palindromic substrings&quot;&gt;&lt;/a&gt;leetcode 647 palindromic substrings&lt;/h3&gt;&lt;p&gt;Given a string, your task is to count how many palindromic substrings in this string.&lt;/p&gt;
&lt;p&gt;The substrings with different start indexes or end indexes are counted as different substrings even they consist of same characters.&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;Example 1:&lt;/strong&gt;&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;3&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;Input: &amp;quot;abc&amp;quot;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Output: 3&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Explanation: Three palindromic strings: &amp;quot;a&amp;quot;, &amp;quot;b&amp;quot;, &amp;quot;c&amp;quot;.&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;


&lt;p&gt;&lt;strong&gt;Example 2:&lt;/strong&gt;&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;3&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;Input: &amp;quot;aaa&amp;quot;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Output: 6&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Explanation: Six palindromic strings: &amp;quot;a&amp;quot;, &amp;quot;a&amp;quot;, &amp;quot;a&amp;quot;, &amp;quot;aa&amp;quot;, &amp;quot;aa&amp;quot;, &amp;quot;aaa&amp;quot;.&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;hr&gt;
    
    </summary>
    
    
      <category term="leetcode" scheme="https://zrbac.github.io/categories/leetcode/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>leetcode 503 next greater element II</title>
    <link href="https://zrbac.github.io/2019/12/20/leetcode-503-next-greater-element-II/"/>
    <id>https://zrbac.github.io/2019/12/20/leetcode-503-next-greater-element-II/</id>
    <published>2019-12-20T07:07:51.000Z</published>
    <updated>2019-12-24T12:36:23.112Z</updated>
    
    <content type="html"><![CDATA[<h3 id="leetcode-503-next-greater-element-II"><a href="#leetcode-503-next-greater-element-II" class="headerlink" title="leetcode 503 next greater element II"></a>leetcode 503 next greater element II</h3><p>Given a circular array (the next element of the last element is the first element of the array), print the Next Greater Number for every element. The Next Greater Number of a number x is the first greater number to its traversing-order next in the array, which means you could search circularly to find its next greater number. If it doesn’t exist, output -1 for this number.</p><p><strong>for example:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">Input: [1,2,1]</span><br><span class="line">Output: [2,-1,2]</span><br><span class="line">Explanation: The first 1&apos;s next greater number is 2; The number 2 can&apos;t find next greater number; The second 1&apos;s next greater number needs to search circularly, which is also 2.</span><br></pre></td></tr></table></figure><hr><a id="more"></a><h4 id="solution-one"><a href="#solution-one" class="headerlink" title="solution one"></a>solution one</h4><p><code>brute force</code></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] nextGreaterElements(<span class="keyword">int</span>[] nums) &#123;</span><br><span class="line">        <span class="keyword">int</span> n = nums.length;</span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[n];</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; n; i++)&#123;</span><br><span class="line">            res[i] = -<span class="number">1</span>;</span><br><span class="line">            <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">1</span>; j &lt; n; j++)&#123;</span><br><span class="line">                <span class="keyword">if</span> (nums[(i + j) % n] &gt; nums[i])&#123;</span><br><span class="line">                    res[i] = nums[(i + j) % n];</span><br><span class="line">                    <span class="keyword">break</span>;</span><br><span class="line">                &#125;</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="solution-two"><a href="#solution-two" class="headerlink" title="solution two"></a>solution two</h4><p><code>stack</code></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">solution</span></span>&#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] nextGreaterElements(<span class="keyword">int</span>[] nums) &#123;</span><br><span class="line">        <span class="keyword">int</span> n = nums.length;</span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[n];</span><br><span class="line">        Stack&lt;Integer&gt; stack = <span class="keyword">new</span> Stack();</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">2</span>*n-<span class="number">1</span>; i &gt;= <span class="number">0</span>; i--) &#123;</span><br><span class="line">            <span class="keyword">while</span> (!stack.empty() &amp;&amp; nums[stack.peek()] &lt;= nums[i % n]) &#123;</span><br><span class="line">                stack.pop();</span><br><span class="line">            &#125;</span><br><span class="line">            res[i % n] = stack.empty() ? -<span class="number">1</span> : nums[stack.peek()];</span><br><span class="line">            stack.push(i % n);</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;leetcode-503-next-greater-element-II&quot;&gt;&lt;a href=&quot;#leetcode-503-next-greater-element-II&quot; class=&quot;headerlink&quot; title=&quot;leetcode 503 next greater element II&quot;&gt;&lt;/a&gt;leetcode 503 next greater element II&lt;/h3&gt;&lt;p&gt;Given a circular array (the next element of the last element is the first element of the array), print the Next Greater Number for every element. The Next Greater Number of a number x is the first greater number to its traversing-order next in the array, which means you could search circularly to find its next greater number. If it doesn’t exist, output -1 for this number.&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;for example:&lt;/strong&gt;&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;3&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;Input: [1,2,1]&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Output: [2,-1,2]&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Explanation: The first 1&amp;apos;s next greater number is 2; The number 2 can&amp;apos;t find next greater number; The second 1&amp;apos;s next greater number needs to search circularly, which is also 2.&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;hr&gt;
    
    </summary>
    
    
      <category term="leetcode" scheme="https://zrbac.github.io/categories/leetcode/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>leetcode 338 counting bits</title>
    <link href="https://zrbac.github.io/2019/12/20/leetcode-338-counting-bits/"/>
    <id>https://zrbac.github.io/2019/12/20/leetcode-338-counting-bits/</id>
    <published>2019-12-20T07:05:44.000Z</published>
    <updated>2019-12-24T12:36:23.112Z</updated>
    
    <content type="html"><![CDATA[<h3 id="leetcode-338-counting-bits"><a href="#leetcode-338-counting-bits" class="headerlink" title="leetcode 338 counting bits"></a>leetcode 338 counting bits</h3><p>Given a non negative integer number <strong>num</strong>. For every numbers <strong>i</strong> in the range <strong>0 ≤ i ≤ num</strong> calculate the number of 1’s in their binary representation and return them as an array.</p><p><strong>Example 1:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">Input: 2</span><br><span class="line">Output: [0,1,1]</span><br></pre></td></tr></table></figure><p><strong>Example 2:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">Input: 5</span><br><span class="line">Output: [0,1,1,2,1,2]</span><br></pre></td></tr></table></figure><hr><a id="more"></a><h4 id="solution-one"><a href="#solution-one" class="headerlink" title="solution one"></a>solution one</h4><p><code>easy to come up with</code></p><figure class="highlight markdown"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line">dp[0] = 0;</span><br><span class="line">dp[1] = dp[0] + 1;</span><br><span class="line">dp[2] = dp[0] + 1;</span><br><span class="line">dp[3] = dp[1] + 1;</span><br><span class="line">dp[4] = dp[0] + 1;</span><br><span class="line">dp[5] = dp[1] + 1;</span><br><span class="line">dp[6] = dp[2] + 1;</span><br><span class="line">dp[7] = dp[3] + 1;</span><br><span class="line">dp[8] = dp[0] + 1;</span><br><span class="line">...</span><br></pre></td></tr></table></figure><p><em>this is overlap sub problem, and we can come up the DP solution</em></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">classs Solution &#123;</span><br><span class="line">    <span class="keyword">public</span> <span class="keyword">int</span>[] countBits(<span class="keyword">int</span> num) &#123;</span><br><span class="line">        <span class="keyword">int</span>[] res = <span class="keyword">new</span> <span class="keyword">int</span>[num+<span class="number">1</span>];</span><br><span class="line">        res[<span class="number">0</span>] = <span class="number">0</span>;</span><br><span class="line">        <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">1</span>; i &lt;= num; i++)</span><br><span class="line">            res[i] = res[i/<span class="number">2</span>] + i%<span class="number">2</span>;</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="solution-two"><a href="#solution-two" class="headerlink" title="solution two"></a>solution two</h4><figure class="highlight markdown"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line">anthoer function(tricky one):</span><br><span class="line">dp[0] = 0;</span><br><span class="line">dp[1] = dp[1-1] + 1;</span><br><span class="line">dp[2] = dp[2-2] + 1;</span><br><span class="line">dp[3] = dp[3-2] +1;</span><br><span class="line">dp[4] = dp[4-4] + 1;</span><br><span class="line">dp[5] = dp[5-4] + 1;</span><br><span class="line">dp[6] = dp[6-4] + 1;</span><br><span class="line">dp[7] = dp[7-4] + 1;</span><br><span class="line">dp[8] = dp[8-8] + 1;</span><br><span class="line">...</span><br></pre></td></tr></table></figure><p><em>Obviously, we can find the pattern for above example, so now we get the general function</em></p><p><strong>dp[index] = dp[index - offset] + 1;</strong></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="keyword">int</span>[] countBits(<span class="keyword">int</span> num) &#123;</span><br><span class="line">    <span class="keyword">int</span> result[] = <span class="keyword">new</span> <span class="keyword">int</span>[num + <span class="number">1</span>];</span><br><span class="line">    <span class="keyword">int</span> offset = <span class="number">1</span>;</span><br><span class="line">    <span class="keyword">for</span> (<span class="keyword">int</span> index = <span class="number">1</span>; index &lt; num + <span class="number">1</span>; ++index)&#123;</span><br><span class="line">        <span class="keyword">if</span> (offset * <span class="number">2</span> == index)&#123;</span><br><span class="line">            offset *= <span class="number">2</span>;</span><br><span class="line">        &#125;</span><br><span class="line">        result[index] = result[index - offset] + <span class="number">1</span>;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> result;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;leetcode-338-counting-bits&quot;&gt;&lt;a href=&quot;#leetcode-338-counting-bits&quot; class=&quot;headerlink&quot; title=&quot;leetcode 338 counting bits&quot;&gt;&lt;/a&gt;leetcode 338 counting bits&lt;/h3&gt;&lt;p&gt;Given a non negative integer number &lt;strong&gt;num&lt;/strong&gt;. For every numbers &lt;strong&gt;i&lt;/strong&gt; in the range &lt;strong&gt;0 ≤ i ≤ num&lt;/strong&gt; calculate the number of 1’s in their binary representation and return them as an array.&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;Example 1:&lt;/strong&gt;&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;Input: 2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Output: [0,1,1]&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;p&gt;&lt;strong&gt;Example 2:&lt;/strong&gt;&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;Input: 5&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Output: [0,1,1,2,1,2]&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;hr&gt;
    
    </summary>
    
    
      <category term="leetcode" scheme="https://zrbac.github.io/categories/leetcode/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>leetcode 94 binary tree inorder traversal</title>
    <link href="https://zrbac.github.io/2019/12/20/leetcode-94-binary-tree-inorder-traversal/"/>
    <id>https://zrbac.github.io/2019/12/20/leetcode-94-binary-tree-inorder-traversal/</id>
    <published>2019-12-20T07:03:53.000Z</published>
    <updated>2019-12-24T12:36:23.112Z</updated>
    
    <content type="html"><![CDATA[<h3 id="leetcode-94-binary-tree-inorder-traversal"><a href="#leetcode-94-binary-tree-inorder-traversal" class="headerlink" title="leetcode 94 binary tree inorder traversal"></a>leetcode 94 binary tree inorder traversal</h3><p>Given a binary tree, return the <em>inorder</em> traversal of its nodes’ values.</p><p><strong>Example:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line">Input: [1,null,2,3]</span><br><span class="line">   1</span><br><span class="line">    \</span><br><span class="line">     2</span><br><span class="line">    /</span><br><span class="line">   3</span><br><span class="line"></span><br><span class="line">Output: [1,3,2]</span><br></pre></td></tr></table></figure><hr><a id="more"></a><h4 id="solution-one"><a href="#solution-one" class="headerlink" title="solution one"></a>solution one</h4><p><code>Recursive Approach</code></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * Definition for a binary tree node.</span></span><br><span class="line"><span class="comment"> * public class TreeNode &#123;</span></span><br><span class="line"><span class="comment"> *     int val;</span></span><br><span class="line"><span class="comment"> *     TreeNode left;</span></span><br><span class="line"><span class="comment"> *     TreeNode right;</span></span><br><span class="line"><span class="comment"> *     TreeNode(int x) &#123; val = x; &#125;</span></span><br><span class="line"><span class="comment"> * &#125;</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="keyword">public</span> List &lt; Integer &gt; inorderTraversal(TreeNode root) &#123;</span><br><span class="line">        List &lt; Integer &gt; res = <span class="keyword">new</span> ArrayList &lt; &gt; ();</span><br><span class="line">        helper(root, res);</span><br><span class="line">        <span class="keyword">return</span> res;</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">helper</span><span class="params">(TreeNode root, List &lt; Integer &gt; res)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span> (root != <span class="keyword">null</span>) &#123;</span><br><span class="line">            <span class="keyword">if</span> (root.left != <span class="keyword">null</span>) &#123;</span><br><span class="line">                helper(root.left, res);</span><br><span class="line">            &#125;</span><br><span class="line">            res.add(root.val);</span><br><span class="line">            <span class="keyword">if</span> (root.right != <span class="keyword">null</span>) &#123;</span><br><span class="line">                helper(root.right, res);</span><br><span class="line">            &#125;</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><h4 id="solution-two"><a href="#solution-two" class="headerlink" title="solution two"></a>solution two</h4><p><code>iterating method using stack</code></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> List&lt;Integer&gt; <span class="title">inorderTrversal</span><span class="params">(TreeNode root)</span></span>&#123;</span><br><span class="line">        List&lt;Integer&gt; list = <span class="keyword">new</span> ArrayList&lt;Integer&gt;();</span><br><span class="line">        Stack&lt;TreeNode&gt; stack = <span class="keyword">new</span> Stack&lt;TreeNode&gt;();</span><br><span class="line">        TreeNode cur = root;</span><br><span class="line">        <span class="keyword">while</span>(cur!=<span class="keyword">null</span> || !stack.empty()) &#123;</span><br><span class="line">            <span class="keyword">while</span>(cur!=<span class="keyword">null</span>)&#123;</span><br><span class="line">                stack.push(cur);</span><br><span class="line">                cur = cur.left;</span><br><span class="line">            &#125;</span><br><span class="line">            cur = stack.pop();</span><br><span class="line">            list.add(cur.val);</span><br><span class="line">            cur = cur.right;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">return</span> list;</span><br><span class="line">    &#125; </span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;leetcode-94-binary-tree-inorder-traversal&quot;&gt;&lt;a href=&quot;#leetcode-94-binary-tree-inorder-traversal&quot; class=&quot;headerlink&quot; title=&quot;leetcode 94 binary tree inorder traversal&quot;&gt;&lt;/a&gt;leetcode 94 binary tree inorder traversal&lt;/h3&gt;&lt;p&gt;Given a binary tree, return the &lt;em&gt;inorder&lt;/em&gt; traversal of its nodes’ values.&lt;/p&gt;
&lt;p&gt;&lt;strong&gt;Example:&lt;/strong&gt;&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;3&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;4&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;5&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;6&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;7&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;8&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;Input: [1,null,2,3]&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;   1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;    \&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;     2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;    /&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;   3&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;Output: [1,3,2]&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;hr&gt;
    
    </summary>
    
    
      <category term="leetcode" scheme="https://zrbac.github.io/categories/leetcode/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>leetcode 10 regular expression matching</title>
    <link href="https://zrbac.github.io/2019/12/20/leetcode-10-regular-expression-matching/"/>
    <id>https://zrbac.github.io/2019/12/20/leetcode-10-regular-expression-matching/</id>
    <published>2019-12-20T06:59:05.000Z</published>
    <updated>2019-12-24T12:36:23.111Z</updated>
    
    <content type="html"><![CDATA[<h3 id="leetcode-10-regular-expression-matching"><a href="#leetcode-10-regular-expression-matching" class="headerlink" title="leetcode 10 regular expression matching"></a>leetcode 10 regular expression matching</h3><p>Given an input string (<code>s</code>) and a pattern (<code>p</code>), implement regular expression matching with support for <code>&#39;.&#39;</code> and <code>&#39;*&#39;</code>.</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line">&apos;.&apos; Matches any single character.</span><br><span class="line">&apos;*&apos; Matches zero or more of the preceding element.</span><br></pre></td></tr></table></figure><p>The matching should cover the <strong>entire</strong> input string (not partial).</p><a id="more"></a><p><strong>Note:</strong></p><ul><li><code>s</code> could be empty and contains only lowercase letters <code>a-z</code>.</li><li><code>p</code> could be empty and contains only lowercase letters <code>a-z</code>, and characters like <code>.</code> or <code>*</code>.</li></ul><p><strong>Example 1:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">Input:</span><br><span class="line">s = &quot;aa&quot;</span><br><span class="line">p = &quot;a&quot;</span><br><span class="line">Output: false</span><br><span class="line">Explanation: &quot;a&quot; does not match the entire string &quot;aa&quot;.</span><br></pre></td></tr></table></figure><p><strong>Example 2:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">Input:</span><br><span class="line">s = &quot;aa&quot;</span><br><span class="line">p = &quot;a*&quot;</span><br><span class="line">Output: true</span><br><span class="line">Explanation: &apos;*&apos; means zero or more of the preceding element, &apos;a&apos;. Therefore, by repeating &apos;a&apos; once, it becomes &quot;aa&quot;.</span><br></pre></td></tr></table></figure><p><strong>Example 3:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">Input:</span><br><span class="line">s = &quot;ab&quot;</span><br><span class="line">p = &quot;.*&quot;</span><br><span class="line">Output: true</span><br><span class="line">Explanation: &quot;.*&quot; means &quot;zero or more (*) of any character (.)&quot;.</span><br></pre></td></tr></table></figure><p><strong>Example 4:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">Input:</span><br><span class="line">s = &quot;aab&quot;</span><br><span class="line">p = &quot;c*a*b&quot;</span><br><span class="line">Output: true</span><br><span class="line">Explanation: c can be repeated 0 times, a can be repeated 1 time. Therefore, it matches &quot;aab&quot;.</span><br></pre></td></tr></table></figure><p><strong>Example 5:</strong></p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line">Input:</span><br><span class="line">s = &quot;mississippi&quot;</span><br><span class="line">p = &quot;mis*is*p*.&quot;</span><br><span class="line">Output: false</span><br></pre></td></tr></table></figure><hr><h4 id="solution-one"><a href="#solution-one" class="headerlink" title="solution one"></a>solution one</h4><p><code>recursion</code></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Solution</span> </span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">isMatch</span><span class="params">(String s, String p)</span> </span>&#123;</span><br><span class="line">        <span class="keyword">if</span>(p.isEmpty())</span><br><span class="line">            <span class="keyword">return</span> s.isEmpty();</span><br><span class="line">        <span class="keyword">boolean</span> first_match = (!p.isEmpty() &amp;&amp; (p.charAt(<span class="number">0</span>) == s.charAt(<span class="number">0</span>) || </span><br><span class="line">                              p.charAt(<span class="number">0</span>) == <span class="string">'.'</span>));</span><br><span class="line">        </span><br><span class="line">        <span class="keyword">if</span>(p.length &gt;=<span class="number">2</span> &amp;&amp; p.charAt(<span class="number">1</span>) == <span class="string">'*'</span>) &#123;</span><br><span class="line">            <span class="keyword">return</span> (isMatch(s, p.substring(<span class="number">2</span>)) || </span><br><span class="line">                    (first_match &amp;&amp; isMatch(s.substring(<span class="number">1</span>),p)));</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">else</span> &#123;</span><br><span class="line">            <span class="keyword">return</span> first_match &amp;&amp; isMatch(s.substring(<span class="number">1</span>), p.substring(<span class="number">1</span>));</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;leetcode-10-regular-expression-matching&quot;&gt;&lt;a href=&quot;#leetcode-10-regular-expression-matching&quot; class=&quot;headerlink&quot; title=&quot;leetcode 10 regular expression matching&quot;&gt;&lt;/a&gt;leetcode 10 regular expression matching&lt;/h3&gt;&lt;p&gt;Given an input string (&lt;code&gt;s&lt;/code&gt;) and a pattern (&lt;code&gt;p&lt;/code&gt;), implement regular expression matching with support for &lt;code&gt;&amp;#39;.&amp;#39;&lt;/code&gt; and &lt;code&gt;&amp;#39;*&amp;#39;&lt;/code&gt;.&lt;/p&gt;
&lt;figure class=&quot;highlight plain&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;&amp;apos;.&amp;apos; Matches any single character.&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&amp;apos;*&amp;apos; Matches zero or more of the preceding element.&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;

&lt;p&gt;The matching should cover the &lt;strong&gt;entire&lt;/strong&gt; input string (not partial).&lt;/p&gt;
    
    </summary>
    
    
      <category term="leetcode" scheme="https://zrbac.github.io/categories/leetcode/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>线性表、链表、栈和队列</title>
    <link href="https://zrbac.github.io/2019/12/16/%E7%BA%BF%E6%80%A7%E8%A1%A8%E3%80%81%E9%93%BE%E8%A1%A8%E3%80%81%E6%A0%88%E5%92%8C%E9%98%9F%E5%88%97/"/>
    <id>https://zrbac.github.io/2019/12/16/%E7%BA%BF%E6%80%A7%E8%A1%A8%E3%80%81%E9%93%BE%E8%A1%A8%E3%80%81%E6%A0%88%E5%92%8C%E9%98%9F%E5%88%97/</id>
    <published>2019-12-16T06:13:26.000Z</published>
    <updated>2019-12-24T12:36:23.113Z</updated>
    
    <content type="html"><![CDATA[<p>线性表、链表、栈和队列是编程中常用的数据结构。</p><h2 id="数据的逻辑结构"><a href="#数据的逻辑结构" class="headerlink" title="数据的逻辑结构"></a>数据的逻辑结构</h2><p>逻辑结构：是数据的组织形式，用来表示数据之间的逻辑关系，其结构由数据元素的集合和元素之间的关系组成。  </p><p>三种基本逻辑结构</p><ul><li>线性结构：数据元素之间为一对一前后连接的关系</li><li>树形结构：只有一个处在最高层次的数据元素无前结点，为根；其余元素均有且只有一个前结点，后结点无个数限制</li><li>图结构：每一元素均可有任意的前后结点，任意两结点可连接</li></ul><a id="more"></a><h2 id="数据的物理结构"><a href="#数据的物理结构" class="headerlink" title="数据的物理结构"></a>数据的物理结构</h2><p>数据元素及其关系在存储器中的存放形式称为物理结构，即存储结构。</p><p>物理结构分类</p><ul><li>顺序存储：元素按某种顺序存储在连续的存储单元中，存储位置间关系反映元素间逻辑关系</li><li>链式存储：元素存储在不一定连续的存储单元，通过在元素中附加信息来表示与其想关的一个或多个其他元素的物理地址来建立元素间的逻辑关系</li><li>索引存储：将数据元素排成一个序列，每个元素对应一个索引，存储时建立附加的索引表，表中为元素的存储地址</li><li>散列存储：数据元素均匀存放在存储区中，在数据元素和其在存储器中的位置之间建立一个映射关系，根据该关系可得其存储地址</li></ul><h2 id="线性表"><a href="#线性表" class="headerlink" title="线性表"></a>线性表</h2><p>采用顺序存储结构的称为顺序表，采用链式存储结构的称为线性链表</p><h3 id="顺序存储特点"><a href="#顺序存储特点" class="headerlink" title="顺序存储特点"></a>顺序存储特点</h3><ul><li>优点：无需为元素间的逻辑关系增加额外存储空间；可随机存取</li><li>缺点：元素插入删除需进行大量元素移动，效率低；占用连续存储空间，且初始化时需确定大小</li></ul><p>顺序表的定义</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> <span class="keyword">int</span> maxsize=<span class="number">200</span>;      <span class="comment">//最大长度</span></span><br><span class="line"><span class="class"><span class="keyword">struct</span> <span class="title">SeqList</span> &#123;</span></span><br><span class="line">    ElemType data[maxsize]; <span class="comment">//存储数组的地址</span></span><br><span class="line">    <span class="keyword">int</span> length;             <span class="comment">//当前长度</span></span><br><span class="line">&#125;;</span><br><span class="line">SeqList List;</span><br><span class="line">List.length=<span class="number">0</span>;</span><br></pre></td></tr></table></figure><p>顺序表插入元素</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">Insert</span><span class="params">(SeqList *L,<span class="keyword">int</span> i,ElemType x)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(i&lt;<span class="number">1</span>||i&gt;L-&gt;length<span class="number">-1</span>||L-&gt;length==maxsize)</span><br><span class="line">    <span class="built_in">cout</span>&lt;&lt;<span class="string">"插入位置错误或表满"</span>；</span><br><span class="line">    <span class="keyword">else</span> &#123;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> j=L-&gt;length+<span class="number">1</span>;j&gt;=i<span class="number">-1</span>;j++)</span><br><span class="line">            L-&gt;data[j+<span class="number">1</span>]=l-&gt;data[j]; <span class="comment">//元素依次后移</span></span><br><span class="line">        L-&gt;data[i<span class="number">-1</span>]=x;              <span class="comment">//i位置存入新元素</span></span><br><span class="line">        L-&gt;length++;                 <span class="comment">//表长加一</span></span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>顺序表删除元素</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">Delete</span><span class="params">(SqeList *L,<span class="keyword">int</span> i)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(i&lt;<span class="number">1</span>||i&gt;L-&gt;length)</span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"表中无第"</span>&lt;&lt;i&lt;&lt;<span class="string">"个元素"</span>;</span><br><span class="line">    <span class="keyword">else</span> &#123;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> j=i;j&lt;L-&gt;length;j++)</span><br><span class="line">            L-&gt;data[j<span class="number">-1</span>]=L-&gt;data[j]; <span class="comment">//删除i位置元素，元素依次前移 </span></span><br><span class="line">        L-&gt;length--;                 <span class="comment">//表长减一</span></span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>顺序表查找元素</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">int</span> <span class="title">Find</span><span class="params">(SeqList *L,ElemType x)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">for</span>(<span class="keyword">int</span> i=<span class="number">0</span>;i&lt;L-&gt;length;i++) &#123;</span><br><span class="line">        <span class="keyword">if</span>(L-&gt;data[i]==x)</span><br><span class="line">        <span class="keyword">return</span> i+<span class="number">1</span>;        <span class="comment">//返回元素位置</span></span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> <span class="number">0</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="链式存储特点"><a href="#链式存储特点" class="headerlink" title="链式存储特点"></a>链式存储特点</h3><ul><li>优点：无需预先设置存储空间，灵活分配；插入删除无需移动额外元素</li><li>缺点：需要额外空间存储元素关系，数据域、指针域；查询效率低</li></ul><p>链表定义</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">struct</span> <span class="title">LNode</span> &#123;</span></span><br><span class="line">    ElemType data;         <span class="comment">//数据域，ElemType为某种数据类型</span></span><br><span class="line">    <span class="class"><span class="keyword">struct</span> <span class="title">LNode</span> *<span class="title">next</span>;</span>    <span class="comment">//指针域</span></span><br><span class="line">&#125;;</span><br><span class="line">LNode* head;               <span class="comment">//头指针</span></span><br><span class="line">head=<span class="keyword">new</span> LNode;            <span class="comment">//头结点</span></span><br><span class="line">head-&gt;next=<span class="literal">NULL</span>;           <span class="comment">//头结点指针域为空</span></span><br></pre></td></tr></table></figure><p>单链表长度</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">int</span> <span class="title">Length</span><span class="params">()</span> </span>&#123;</span><br><span class="line">    LNode *p=head-&gt;next;</span><br><span class="line">    <span class="keyword">int</span> len=<span class="number">0</span>;</span><br><span class="line">    <span class="keyword">while</span>(p!=<span class="literal">NULL</span>) &#123;</span><br><span class="line">        len++;</span><br><span class="line">        p=p-&gt;next;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> len;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>在链表i位置插入新结点</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">Insert</span><span class="params">(LNode *head,<span class="keyword">int</span> i,ElemType x)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(i&lt;<span class="number">1</span>)</span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"不存在第"</span>&lt;&lt;i&lt;&lt;<span class="string">"个位置"</span>；</span><br><span class="line">    <span class="keyword">else</span> &#123;</span><br><span class="line">        LNode *p=head;</span><br><span class="line">        <span class="keyword">int</span> k=<span class="number">0</span>;                         <span class="comment">//p指向头结点，最终指向第i-1个结点</span></span><br><span class="line">        <span class="keyword">while</span>(p!=<span class="literal">NULL</span>&amp;&amp;k&lt;i<span class="number">-1</span>) &#123;           </span><br><span class="line">            p=p-&gt;next;</span><br><span class="line">            k++;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">if</span>(p==<span class="literal">NULL</span>)</span><br><span class="line">            <span class="built_in">cout</span>&lt;&lt;i&lt;&lt;<span class="string">"超出链表最大可插入位置"</span>；</span><br><span class="line">        <span class="keyword">else</span> &#123;</span><br><span class="line">            LNode *s=<span class="keyword">new</span> LNode;          <span class="comment">//建立新结点s</span></span><br><span class="line">            s-&gt;data=x;</span><br><span class="line">            s-&gt;next=p-&gt;next;             <span class="comment">//修改结点s指针</span></span><br><span class="line">            p-&gt;next=s;                   <span class="comment">//修改结点p指针</span></span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>从单链表中删除第i个结点</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">Delete</span><span class="params">(LNode *head,<span class="keyword">int</span> i)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(i&lt;<span class="number">1</span>)</span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"不存在第"</span>&lt;&lt;i&lt;&lt;<span class="string">"个位置"</span>；</span><br><span class="line">    <span class="keyword">else</span> &#123;</span><br><span class="line">        LNode *p=head;                    <span class="comment">//p指向头结点</span></span><br><span class="line">        LNode *q;                         <span class="comment">//q和p最终分别指向第i-1和第i个结点</span></span><br><span class="line">        <span class="keyword">int</span> k=<span class="number">0</span>;   </span><br><span class="line">        <span class="keyword">while</span>(p!=<span class="literal">NULL</span>&amp;&amp;k&lt;i<span class="number">-1</span>) &#123;</span><br><span class="line">            q=p;</span><br><span class="line">            p=p-&gt;next;</span><br><span class="line">            k++;</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="keyword">if</span>(p==<span class="literal">NULL</span>)</span><br><span class="line">            <span class="built_in">cout</span>&lt;&lt;i&lt;&lt;<span class="string">"超出链表长度"</span>;</span><br><span class="line">        <span class="keyword">else</span> &#123;</span><br><span class="line">            q-&gt;next=p-&gt;next;              <span class="comment">//从链表中删除该结点</span></span><br><span class="line">            <span class="keyword">delete</span> p;                     <span class="comment">//释放结点p</span></span><br><span class="line">        &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>查找链表中的结点</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="function">LNode* <span class="title">Find</span><span class="params">(LNode *head,ElemType x)</span> </span>&#123;</span><br><span class="line">    LNode *p=head-&gt;next;                 <span class="comment">//p指向第一个元素所在结点</span></span><br><span class="line">    <span class="keyword">while</span>(p!=<span class="literal">NULL</span>&amp;&amp;p-&gt;data!=x)</span><br><span class="line">        p=p-&gt;next;</span><br><span class="line">    <span class="keyword">return</span> p;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>其他形式链表</p><ul><li>循环链表：将单链表尾结点的指针由NULL改为指向头结点，首尾连接形成一个环形，为循环链表</li><li>双向链表：每个结点的指针域再增加一个指针，指向该结点的前一结点，形成两个不同方向的链</li><li>双向循环链表：将双链表的头结点的前趋指针指向尾结点，将尾结点的后继指针指向头结点</li></ul><h3 id="栈"><a href="#栈" class="headerlink" title="栈"></a>栈</h3><ul><li>只能在一端进行插入和删除操作的特殊线性表，允许进行插入删除操作的一端为栈顶，另一端为栈底</li><li>特点为先进后出(FILO,first in last out)或后进先出(LIFO,last in first out)</li><li>可应用于进制转换、括号/引号匹配检查、递归算法等</li></ul><p>顺序栈定义</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="class"><span class="keyword">struct</span> <span class="title">SqStack</span> &#123;</span></span><br><span class="line">    ElemType *data;     <span class="comment">//存储元素的变量</span></span><br><span class="line">    <span class="keyword">int</span> top;            <span class="comment">//栈顶指针，存储元素下标</span></span><br><span class="line">    <span class="keyword">int</span> stacksize;      <span class="comment">//栈空间大小</span></span><br><span class="line">&#125;;</span><br><span class="line">SqStack s;              <span class="comment">//定义一个栈</span></span><br></pre></td></tr></table></figure><p>元素入栈</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">Push</span><span class="params">(SqStack *s,ElemType x)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(s-&gt;top &lt; s-&gt;stacksize<span class="number">-1</span>) &#123;</span><br><span class="line">        s-&gt;top++;</span><br><span class="line">        s-&gt;data[top]=x;</span><br><span class="line">    &#125; <span class="keyword">else</span> </span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"栈满"</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>元素出栈</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">Pop</span><span class="params">(SqStack *s,ElemType &amp;e)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(s-&gt;top &gt; <span class="number">-1</span>) &#123;</span><br><span class="line">        e=s-&gt;data[s-&gt;top];</span><br><span class="line">        s-&gt;top--;</span><br><span class="line">    &#125; <span class="keyword">else</span> </span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"栈空"</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>取栈顶元素</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">Peek</span><span class="params">(SqStack *s,ElemType &amp;e)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(s-&gt;top &gt; <span class="number">-1</span>) &#123;</span><br><span class="line">        e=s-&gt;data[s-&gt;top];</span><br><span class="line">    &#125; <span class="keyword">else</span> </span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"栈空"</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h3 id="队列"><a href="#队列" class="headerlink" title="队列"></a>队列</h3><ul><li>只能在表的一端进行插入操作，另一端进行删除操作的特殊线性表</li><li>允许删除元素的一端为队头(指针指空)，允许插入元素的一端为队尾(指针指队尾元素)，先进先出</li><li>主要应用于缓存，打印队列等</li></ul><p>循环队列</p><ul><li>将队列的头尾相连</li><li>当队尾和队头重叠时，约定为队空；当队尾加一后等于队头时，队满</li></ul><p>链式队列</p><ul><li>为队列的每一元素附加一个存储元素关系的指针域</li></ul><p>队列定义</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">const</span> <span class="keyword">int</span> MAX=<span class="number">100</span></span><br><span class="line">struct SqQueue &#123;</span><br><span class="line">    <span class="keyword">int</span> data[MAX];     <span class="comment">//存放元素的数组</span></span><br><span class="line">    <span class="keyword">int</span> front;         <span class="comment">//队头指针</span></span><br><span class="line">    <span class="keyword">int</span> rear;          <span class="comment">//队尾指针</span></span><br><span class="line">&#125;;</span><br><span class="line">SqQueue q;             <span class="comment">//定义队列q</span></span><br><span class="line">q.front=q.rear;        <span class="comment">//指针初始化</span></span><br></pre></td></tr></table></figure><p>入队操作</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">EnQueue</span><span class="params">(SqQueue &amp;q,ElemType x)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>((q.rear+<span class="number">1</span>)%MAX==q.front)</span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"队列已满"</span>;</span><br><span class="line">    <span class="keyword">else</span> &#123;</span><br><span class="line">        q.rear=(q.rear+<span class="number">1</span>)%MAX;</span><br><span class="line">        q.data[q.rear]=x;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>出队操作</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">void</span> <span class="title">DeQueue</span><span class="params">(SqQueue &amp;q)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(q.rear==q.front)</span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"队列为空"</span>;</span><br><span class="line">    <span class="keyword">else</span> </span><br><span class="line">        q.front=(q.front+<span class="number">1</span>)%MAX;</span><br><span class="line">    <span class="keyword">return</span> q.data[q.front];</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>取队头元素</p><figure class="highlight c++"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br></pre></td><td class="code"><pre><span class="line"><span class="function">ElemType <span class="title">GetHead</span><span class="params">(SqQueue &amp;q)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">int</span> i;</span><br><span class="line">    <span class="keyword">if</span>(q.rear==q.front)</span><br><span class="line">        <span class="built_in">cout</span>&lt;&lt;<span class="string">"队列为空"</span>;</span><br><span class="line">    <span class="keyword">else</span> </span><br><span class="line">        i=(q.front+<span class="number">1</span>)%MAX;</span><br><span class="line">    <span class="keyword">return</span> q.data[i];</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;p&gt;线性表、链表、栈和队列是编程中常用的数据结构。&lt;/p&gt;
&lt;h2 id=&quot;数据的逻辑结构&quot;&gt;&lt;a href=&quot;#数据的逻辑结构&quot; class=&quot;headerlink&quot; title=&quot;数据的逻辑结构&quot;&gt;&lt;/a&gt;数据的逻辑结构&lt;/h2&gt;&lt;p&gt;逻辑结构：是数据的组织形式，用来表示数据之间的逻辑关系，其结构由数据元素的集合和元素之间的关系组成。  &lt;/p&gt;
&lt;p&gt;三种基本逻辑结构&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;线性结构：数据元素之间为一对一前后连接的关系&lt;/li&gt;
&lt;li&gt;树形结构：只有一个处在最高层次的数据元素无前结点，为根；其余元素均有且只有一个前结点，后结点无个数限制&lt;/li&gt;
&lt;li&gt;图结构：每一元素均可有任意的前后结点，任意两结点可连接&lt;/li&gt;
&lt;/ul&gt;
    
    </summary>
    
    
      <category term="数据结构" scheme="https://zrbac.github.io/categories/%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
      <category term="C++" scheme="https://zrbac.github.io/tags/C/"/>
    
  </entry>
  
  <entry>
    <title>Random Notes</title>
    <link href="https://zrbac.github.io/2019/12/10/Random-Notes/"/>
    <id>https://zrbac.github.io/2019/12/10/Random-Notes/</id>
    <published>2019-12-10T11:16:31.000Z</published>
    <updated>2020-09-09T09:57:09.004Z</updated>
    
    <content type="html"><![CDATA[<h3 id="notes"><a href="#notes" class="headerlink" title="notes"></a>notes</h3><hr><p><code>抽象类</code></p><ul><li><p>如果父类方法无需实现功能，仅仅是为了定义签名，目的是让子类去覆写，那么可以把父类的方法声明为抽象方法。</p></li><li><p>含有抽象方法的类必须定义为抽象类，无法实例化。</p></li><li><p>抽象类本身被设计成只能继承，因此，抽象类可以强迫子类实现其定义的抽象方法，否则编译会报错，相当于定义了规范。</p></li></ul><a id="more"></a><hr><p>java新建类快捷键<code>ctrl</code> <code>alt</code> <code>insert</code></p><hr><p><code>接口</code></p><ul><li>接口（interface）定义了纯抽象规范，一个类可以实现多个接口。</li><li>接口也是数据类型，适用于向上转型和向下转型。</li><li>接口的所有方法都是抽象方法，且不能定义实例字段，可以定义default方法。</li></ul><hr><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br></pre></td><td class="code"><pre><span class="line"> * @ apiNote     : <span class="number">1</span>. 一个.java文件只能有一个<span class="keyword">public</span>类，且这个类的类名必须与文件名保持一致</span><br><span class="line"> *                 <span class="number">2</span>. 一个类或者类中变量不用<span class="keyword">public</span>，<span class="keyword">protected</span>，<span class="keyword">private</span>修饰的，则其作用域为整个包。</span><br><span class="line"> *                 <span class="number">3</span>. <span class="keyword">public</span>修饰的可以被任何其他类访问，<span class="keyword">protected</span>主要是作用于继承关系，子类或子类的子类可以访问。<span class="keyword">private</span>只能在类中访问</span><br><span class="line"> *                 <span class="number">4</span>. 局部变量的定义应遵循最小可用原则</span><br><span class="line"> *                 <span class="number">5</span>. <span class="keyword">final</span>修饰的字段无法修改，修饰的类无法继承，修饰的方法无法重写。</span><br><span class="line"> *                 <span class="number">6</span>. 写的时候应该先写<span class="keyword">public</span>，再写<span class="keyword">private</span>，因为看的时候会先关注一个类暴露给外部的字段和方法。</span><br><span class="line"> */</span><br><span class="line"></span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">oopScope</span>    //和文件名<span class="title">oopScope</span>保持一致，不然报错。</span></span><br><span class="line"><span class="class"></span>&#123;</span><br><span class="line">    </span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="class"><span class="keyword">class</span> <span class="title">Person</span>   // 不能再用<span class="title">public</span>修饰</span></span><br><span class="line"><span class="class"></span>&#123;</span><br><span class="line">    <span class="keyword">final</span> <span class="keyword">int</span> max_age = <span class="number">110</span>; <span class="comment">//无法再重新赋值</span></span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">int</span> age;<span class="comment">//类作用域</span></span><br><span class="line">    <span class="keyword">public</span> String name;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">protected</span> <span class="keyword">void</span> <span class="title">hi</span><span class="params">()</span>  <span class="comment">//子类无法覆写</span></span></span><br><span class="line"><span class="function">    </span>&#123;</span><br><span class="line">        System.out.println(<span class="string">"Hi, "</span>+<span class="keyword">this</span>.name);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/*</span></span><br><span class="line"><span class="comment">**BigDecimal</span></span><br><span class="line"><span class="comment">*/</span></span><br><span class="line"></span><br><span class="line"><span class="comment">//和BigInteger类似，BigDecimal用来精确表示多位小数，源码中的实现为一个BigInteger和一个scale来实现的，前者表示数值，后者表示小数位数</span></span><br><span class="line"><span class="keyword">import</span> java.math.*;</span><br><span class="line"></span><br><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">BigDec</span></span></span><br><span class="line"><span class="class"></span>&#123;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[]args)</span></span></span><br><span class="line"><span class="function">    </span>&#123;</span><br><span class="line">        BigDecimal bd = <span class="keyword">new</span> BigDecimal(<span class="string">"123.456"</span>);</span><br><span class="line">        System.out.println(bd.multiply(bd)); <span class="comment">// 15241.55677489</span></span><br><span class="line">        BigDecimal d1 = <span class="keyword">new</span> BigDecimal(<span class="string">"123.45"</span>);</span><br><span class="line">        BigDecimal d2 = <span class="keyword">new</span> BigDecimal(<span class="string">"123.4500"</span>);</span><br><span class="line">        BigDecimal d3 = <span class="keyword">new</span> BigDecimal(<span class="string">"1234500"</span>);</span><br><span class="line">        System.out.println(d1.scale()); <span class="comment">// 2,两位小数</span></span><br><span class="line">        System.out.println(d2.scale()); <span class="comment">// 4</span></span><br><span class="line">        System.out.println(d3.scale()); <span class="comment">// 0</span></span><br><span class="line"></span><br><span class="line">        <span class="comment">//通过stripTrailingZeros()方法，可以将一个BigDecimal格式化为一个相等的，但去掉了末尾0的BigDecimal</span></span><br><span class="line">        d2 = d2.stripTrailingZeros();</span><br><span class="line">        System.out.println(d2);</span><br><span class="line">        <span class="comment">//如果scale返回负数，例如，-2，表示这个数是整数，并且末尾有2个0</span></span><br><span class="line">        BigDecimal d4 = <span class="keyword">new</span> BigDecimal(<span class="string">"1234500"</span>);</span><br><span class="line">        System.out.println(d4.scale());</span><br><span class="line"></span><br><span class="line">        <span class="comment">//截断和四舍五入</span></span><br><span class="line">        BigDecimal d5 = <span class="keyword">new</span> BigDecimal(<span class="string">"123.456789"</span>);</span><br><span class="line">        BigDecimal d6 = d5.setScale(<span class="number">4</span>,RoundingMode.HALF_UP);<span class="comment">//四舍五入</span></span><br><span class="line">        BigDecimal d7 = d5.setScale(<span class="number">4</span>,RoundingMode.DOWN);</span><br><span class="line"></span><br><span class="line">        <span class="comment">//比较必须用compareTo(),使用equals不仅要求值相等，还要求scale相等，因为equals是对象类实例统一的比较方法，要求对象的实例字段相等</span></span><br><span class="line">        BigDecimal d8 = <span class="keyword">new</span> BigDecimal(<span class="string">"123.456"</span>);</span><br><span class="line">        BigDecimal d9 = <span class="keyword">new</span> BigDecimal(<span class="string">"123.45600"</span>);</span><br><span class="line">        System.out.println(d8.equals(d9)); <span class="comment">// false,因为scale不同</span></span><br><span class="line">        System.out.println(d8.equals(d9.stripTrailingZeros())); <span class="comment">// true,因为d2去除尾部0后scale变为2</span></span><br><span class="line">        System.out.println(d8.compareTo(d9)); <span class="comment">// 0</span></span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p>存在多个catch的时候 catch的顺序十分重要：子类必须要写在前面。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">void</span> <span class="title">main</span><span class="params">(String[] args)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">try</span> &#123;</span><br><span class="line">        process1();</span><br><span class="line">        process2();</span><br><span class="line">        process3();</span><br><span class="line">    &#125; <span class="keyword">catch</span> (UnsupportedEncodingException e) &#123;</span><br><span class="line">        System.out.println(<span class="string">"IO error"</span>);</span><br><span class="line">    &#125; <span class="keyword">catch</span> (IOException e) &#123;</span><br><span class="line">        System.out.println(<span class="string">"Bad encoding"</span>);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><p><strong>excel查找函数–vlookup多条件匹配</strong></p><p><code>=VLOOKUP(条件1&amp;条件2,if({1,0},条件1范围&amp;条件2范围,结果范围),2,0)</code></p><p>注意：</p><p>1、同时按住CTRL+SHIFT+ENTER 三键结束，因为这是数组公式；</p><p>2、条件、结果范围大小要保持一致；</p><p>操作过程如下：</p><p><img src="https://user-images.githubusercontent.com/33156501/75601530-f8274800-5af6-11ea-9d6c-b6ba32c7e5b7.gif" alt="avatar"></p><hr><p>centos 系统默认启动方式更改命令</p><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">systemctl set-default multi-user.target //命令行模式启动</span><br></pre></td></tr></table></figure><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">systemctl set-default graphical.target  //图形界面启动</span><br></pre></td></tr></table></figure><hr><p><strong>后端工程师</strong></p><p> 掌握java基础，设计模式，jvm原理，spring原理及源码，linux，mysql事务隔离与锁机制，mongodb，http/tcp，多线程，分布式架构，弹性计算架构，微服务架构，java性能优化，以及相关的项目管理等 。</p><p>追求<strong>高并发，高可用，高性能</strong>。</p><p>crater detection algorithms（CDAs）</p><p>orthographic projection(正射投影)</p><hr><h3 id="Java-GC-Java-Garbage-Collection"><a href="#Java-GC-Java-Garbage-Collection" class="headerlink" title="Java GC: Java Garbage Collection"></a>Java GC: Java Garbage Collection</h3><h4 id="How-Java-GC-Works"><a href="#How-Java-GC-Works" class="headerlink" title="How Java GC Works"></a>How Java GC Works</h4><ul><li>automatic memory management</li><li>lives in the JVM</li><li>unreferencee objects are identified and marked as ready for gc</li><li>then marked objects are deleted</li></ul><h4 id="The-GC-Heap"><a href="#The-GC-Heap" class="headerlink" title="The GC Heap"></a>The GC Heap</h4><p>  <img src="https://stackify.com/wp-content/uploads/2017/05/Java-Garbage-Collection.png" alt="avatar"></p><ul><li>Young Generation: newly created objects first in eden then moved to survivor space,if gc it’s minor gc event.</li><li>Old Generation: long-lived objects moved from young generation, if gc it’s major gc event.</li><li>Permanent Generation: metadata like classes an methods are stored here, if not used maybe gced.</li></ul><hr><p>Java 集合、数组、字符串</p><ul><li>size() 获取泛型集合长度</li><li>length 获取数组长度</li><li>length() 获取字符串长度</li></ul><hr><p>IDEA Windows快捷键</p><ul><li>一键格式化代码： Ctrl + Alt + L</li><li>代码界面全屏切换： Ctrl +Shift + F12</li><li>删除一整行/选中时为剪切： Ctrl + X</li><li>重命名文件和变量： Shift + F6</li><li>多行同时编辑： 按住Alt + 鼠标左键下拉</li><li>跳转到指定文件： Ctrl + Shift + N</li><li>自动创建getter和setter： Alt + Insert</li><li>变量抽取： Ctrl + Alt + V</li><li>变量加到原文： Ctrl + Alt + N</li><li>快速换行跳过当前所在行代码： Shift + Enter</li><li>不用鼠标选中多项： Shift + ↑/↓/←/→</li><li>切换最近编辑窗口： Ctrl + E</li><li>自动移除无用引用：Ctrl + Alt + O</li><li>跳转到选择变量所在文件：Ctrl + B</li><li>复制光标所在行并将复制内容插入光标下面一行：Ctrl + D</li><li>快速生成for循环： object.for Enter</li><li>当前方法展开、折叠：Ctrl + ‘+/-‘</li><li>全部展开、折叠： Ctrl + Shift + ‘+/-‘</li><li>注释当前行： Ctrl + /</li><li>选中注释： Ctrl + Shift + /</li><li>去除无用引入： Ctrl + alt + O</li></ul><hr><p>POJO: plain old java object(简单java对象)</p><hr><p>字符串equals比较，避免空指针异常</p><ul><li><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br></pre></td><td class="code"><pre><span class="line">String str = <span class="keyword">null</span>;</span><br><span class="line"><span class="keyword">if</span> (str.equals(<span class="string">"test"</span>)) &#123;</span><br><span class="line">    <span class="comment">//*代码不会触发，因为会抛出异常</span></span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line">String str = <span class="keyword">null</span>;</span><br><span class="line"><span class="keyword">if</span> (<span class="string">"test"</span>.equals(str)) &#123;</span><br><span class="line">    <span class="comment">//*正确用例，不会抛出异常</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></li></ul><p>时序图讲解软件推荐<br>visual-paradigm</p><hr><p>Spring Boot<br>CoC: Convention over Configutation<br>惯例优于配置原则</p><hr><p><code>int</code>和<code>Integer</code></p><ul><li><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"></span><br><span class="line">- ```Integer继承了Object类，是对象类型，为int的包装类</span><br></pre></td></tr></table></figure></li></ul><p>区别</p><ul><li>值存储：int存储在栈中；Integer对象的引用存储在栈空间中，对象的数据存储在堆空间中。</li><li>初始化：int初始化值为0；Integer初始化值为null。</li><li>传参：int为值传递，栈中数据不可变；Integer对象为引用传递，引用 不可变，但引用指向的堆空间地址中的值是可以改变的。</li><li>泛型：泛型不支持int，支持Integer。</li><li>运算：int可直接做运算，为类的特性；Integer的对象可以调用该类的方法，但是在拆箱之前不能进行运算，需要转化为基本类型int。</li></ul><p>相同值下int与Integer的比较</p><ul><li>两个通过new生成的变量，结果为false。</li><li>int和Integer的值比较，若值相等，为true。<ul><li>比较时，Integer会自动拆箱为int类型再比较</li></ul></li><li>new的Integer与非new的Integer比较，为false。<ul><li>new 生成的Integer变量的值在堆空间中，非new 生成的Integer变量的值在在常量池中;</li><li>非new生成的Integer变量，会先判断常量池中是否有该对象，若有则共享，若无则在常量池中放入该对象,也叫享元模式</li></ul></li><li>两个非new 生成的Integer对象比较，则结果为true。<ul><li>前提：值的范围在 -128 ~ 127 之间。</li><li>涉及到java对 int 与 Integer 的自动装箱和拆箱的一种模式：享元模式—flyweight，为了加强对简单数字的重复利用。</li><li>在赋值时，其实是执行了Integer的valueOf()方法。<br>当值在 -128 ~ 127之间时，java会进行自动装箱，然后会对值进行缓存，如果下次再有相同的值，会直接在缓存中取出使用。缓存是通过Integer的内部类IntegerCache来完成的。当值超出此范围，会在堆中new出一个对象来存储。</li></ul></li><li>内部类IntegerCache<ul><li>通过此类可以缓存简单数字。</li><li>缓存的数大小可以由 -XX：AutoBoxCacheMax = 控制。</li><li>jvm初始化时，java.lang.Integer.IntegerCache.high属性可以设置并保存在私有系统属性中。规定了low属性的值：-128</li></ul></li></ul><hr><h3 id="如何判断两个字符串是由相同字符组成"><a href="#如何判断两个字符串是由相同字符组成" class="headerlink" title="如何判断两个字符串是由相同字符组成"></a>如何判断两个字符串是由相同字符组成</h3><p>通过辅助数组，统计待比较字符串每个字符的出现次数，然后循环另一个字符串，判断遍历的字符是否出现过。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">static</span> <span class="keyword">boolean</span> <span class="title">sameCompose</span><span class="params">(String s, String t)</span> </span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(s.length() != t.length())</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">    <span class="keyword">int</span>[] count = <span class="keyword">new</span> <span class="keyword">int</span>[<span class="number">256</span>];</span><br><span class="line">    <span class="keyword">for</span>(<span class="keyword">char</span> c:s.toCharArray())</span><br><span class="line">        count[c]++;</span><br><span class="line">    <span class="keyword">for</span>(<span class="keyword">char</span> c:t.toCharArray()) &#123;</span><br><span class="line">        <span class="keyword">if</span>(--count[c] &lt; <span class="number">0</span>)</span><br><span class="line">            <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;notes&quot;&gt;&lt;a href=&quot;#notes&quot; class=&quot;headerlink&quot; title=&quot;notes&quot;&gt;&lt;/a&gt;notes&lt;/h3&gt;&lt;hr&gt;
&lt;p&gt;&lt;code&gt;抽象类&lt;/code&gt;&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;&lt;p&gt;如果父类方法无需实现功能，仅仅是为了定义签名，目的是让子类去覆写，那么可以把父类的方法声明为抽象方法。&lt;/p&gt;
&lt;/li&gt;
&lt;li&gt;&lt;p&gt;含有抽象方法的类必须定义为抽象类，无法实例化。&lt;/p&gt;
&lt;/li&gt;
&lt;li&gt;&lt;p&gt;抽象类本身被设计成只能继承，因此，抽象类可以强迫子类实现其定义的抽象方法，否则编译会报错，相当于定义了规范。&lt;/p&gt;
&lt;/li&gt;
&lt;/ul&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="random stuff" scheme="https://zrbac.github.io/tags/random-stuff/"/>
    
  </entry>
  
  <entry>
    <title>Spring Boot Tutorial</title>
    <link href="https://zrbac.github.io/2019/12/02/Spring-Boot-Tutorial/"/>
    <id>https://zrbac.github.io/2019/12/02/Spring-Boot-Tutorial/</id>
    <published>2019-12-02T06:33:35.000Z</published>
    <updated>2020-06-05T11:07:58.895Z</updated>
    
    <content type="html"><![CDATA[<h3 id="IoC的基本概念"><a href="#IoC的基本概念" class="headerlink" title="IoC的基本概念"></a>IoC的基本概念</h3><h4 id="依赖注入"><a href="#依赖注入" class="headerlink" title="依赖注入"></a>依赖注入</h4><h4 id="构造方法注入-constructor-injection"><a href="#构造方法注入-constructor-injection" class="headerlink" title="构造方法注入(constructor injection)"></a>构造方法注入(constructor injection)</h4><p>被注入对象可通过在其构造方法中声明依赖对象的参数列表，让外部(IoC容器)知道它需要哪些依赖对象。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br></pre></td><td class="code"><pre><span class="line"><span class="function"><span class="keyword">public</span> <span class="title">NewsProvider</span><span class="params">(NewsListener newsListener,NewsPublisher newsPublisher)</span></span>&#123;</span><br><span class="line">    <span class="keyword">this</span>.newsListener = newsListener;</span><br><span class="line">    <span class="keyword">this</span>.NewsPublisher = newsPublisher;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><a id="more"></a><h4 id="setter方法注入"><a href="#setter方法注入" class="headerlink" title="setter方法注入"></a>setter方法注入</h4><p>为当前对象所依赖对象对应的属性添加setter方法，通过setter方法将相应的依赖对象设置到被注入对象中。</p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="class"><span class="keyword">class</span> <span class="title">NewsProvider</span></span>&#123;</span><br><span class="line">    <span class="keyword">private</span> NewsListener newsListener;</span><br><span class="line">    <span class="keyword">private</span> NewsPublisher newsPublisher;</span><br><span class="line"></span><br><span class="line">    <span class="function"><span class="keyword">public</span> NewsListener <span class="title">getNewsListener</span><span class="params">()</span></span>&#123;</span><br><span class="line">        <span class="keyword">return</span> newsListener;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">setNewsListener</span><span class="params">(NewsListener newsListener)</span></span>&#123;</span><br><span class="line">        <span class="keyword">this</span>.newsListener = newsListener;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> NewsPublisher <span class="title">getNewsPublisher</span><span class="params">()</span></span>&#123;</span><br><span class="line">        <span class="keyword">return</span> newsPublisher;</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">setNewsPublisher</span><span class="params">(NewsPublisher newsPublisher)</span></span>&#123;</span><br><span class="line">        <span class="keyword">this</span>.newsPublisher = newsPublisher;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><h4 id="接口注入"><a href="#接口注入" class="headerlink" title="接口注入"></a>接口注入</h4><p>被注入对象如果想要IoC Service Provider为其注入对象，就必须实现某个接口。该接口提供一个方法，用来为其注入依赖对象，IoC Service Provider最终通过这些接口来了解应该为被注入对象注入什么依赖对象。<br>接口注入比较死板和烦琐。</p><h4 id="三种方法比较"><a href="#三种方法比较" class="headerlink" title="三种方法比较"></a>三种方法比较</h4><ul><li>接口注入：现已不提倡使用，因为它强制被注入对象实现不必要的接口，带有侵入性。</li><li>构造方法注入：优点，对象在构造完成后，即可马上使用。缺点，当依赖对象比较多时，构造方法参数列表会比较长，而通过反射构造对象时，对相同类型的参数处理会比较困难，不利于维护和使用。</li><li>setter方法注入：方法可以命名，所以setter方法注入在描述性上要比构造方法注入好，且setter方法可被继承，允许设置默认值，具有良好的IDE支持。缺点，对象无法在构造完成后马上进入就绪状态。</li></ul><h3 id="IoC容器BeanFactory"><a href="#IoC容器BeanFactory" class="headerlink" title="IoC容器BeanFactory"></a>IoC容器BeanFactory</h3><p>表达式层面<br>注册bean定义层面<br>表达依赖注入关系层面</p>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;IoC的基本概念&quot;&gt;&lt;a href=&quot;#IoC的基本概念&quot; class=&quot;headerlink&quot; title=&quot;IoC的基本概念&quot;&gt;&lt;/a&gt;IoC的基本概念&lt;/h3&gt;&lt;h4 id=&quot;依赖注入&quot;&gt;&lt;a href=&quot;#依赖注入&quot; class=&quot;headerlink&quot; title=&quot;依赖注入&quot;&gt;&lt;/a&gt;依赖注入&lt;/h4&gt;&lt;h4 id=&quot;构造方法注入-constructor-injection&quot;&gt;&lt;a href=&quot;#构造方法注入-constructor-injection&quot; class=&quot;headerlink&quot; title=&quot;构造方法注入(constructor injection)&quot;&gt;&lt;/a&gt;构造方法注入(constructor injection)&lt;/h4&gt;&lt;p&gt;被注入对象可通过在其构造方法中声明依赖对象的参数列表，让外部(IoC容器)知道它需要哪些依赖对象。&lt;/p&gt;
&lt;figure class=&quot;highlight java&quot;&gt;&lt;table&gt;&lt;tr&gt;&lt;td class=&quot;gutter&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;1&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;2&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;3&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;4&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;td class=&quot;code&quot;&gt;&lt;pre&gt;&lt;span class=&quot;line&quot;&gt;&lt;span class=&quot;function&quot;&gt;&lt;span class=&quot;keyword&quot;&gt;public&lt;/span&gt; &lt;span class=&quot;title&quot;&gt;NewsProvider&lt;/span&gt;&lt;span class=&quot;params&quot;&gt;(NewsListener newsListener,NewsPublisher newsPublisher)&lt;/span&gt;&lt;/span&gt;&amp;#123;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;    &lt;span class=&quot;keyword&quot;&gt;this&lt;/span&gt;.newsListener = newsListener;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;    &lt;span class=&quot;keyword&quot;&gt;this&lt;/span&gt;.NewsPublisher = newsPublisher;&lt;/span&gt;&lt;br&gt;&lt;span class=&quot;line&quot;&gt;&amp;#125;&lt;/span&gt;&lt;br&gt;&lt;/pre&gt;&lt;/td&gt;&lt;/tr&gt;&lt;/table&gt;&lt;/figure&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>Git 操作指南</title>
    <link href="https://zrbac.github.io/2019/11/25/Git-%E6%93%8D%E4%BD%9C%E6%8C%87%E5%8D%97/"/>
    <id>https://zrbac.github.io/2019/11/25/Git-%E6%93%8D%E4%BD%9C%E6%8C%87%E5%8D%97/</id>
    <published>2019-11-25T09:46:16.000Z</published>
    <updated>2019-12-24T12:36:23.096Z</updated>
    
    <content type="html"><![CDATA[<h2 id="Git基础教程"><a href="#Git基础教程" class="headerlink" title="Git基础教程"></a>Git基础教程</h2><h3 id="Git-核心思想"><a href="#Git-核心思想" class="headerlink" title="Git 核心思想"></a>Git 核心思想</h3><ul><li>工作区(Workspace): 电脑中的实际目录</li><li>暂存区(Index): 类似于缓存区，临时保存改动</li><li>仓库区(Repository): 分为本地和远程仓库</li><li>代码提交步骤: <code>git add</code>, <code>git commit</code>, <code>git push</code></li></ul><a id="more"></a><h3 id="Git-基本操作"><a href="#Git-基本操作" class="headerlink" title="Git 基本操作"></a>Git 基本操作</h3><h4 id="初始化"><a href="#初始化" class="headerlink" title="初始化"></a>初始化</h4><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"># 在当前目录新建一个Git代码库</span><br><span class="line">$ git init</span><br><span class="line"></span><br><span class="line"># 下载一个项目和它的整个代码历史 [Git only]</span><br><span class="line"></span><br><span class="line">$ git clone &lt;url&gt;</span><br></pre></td></tr></table></figure><h4 id="配置"><a href="#配置" class="headerlink" title="配置"></a>配置</h4><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br></pre></td><td class="code"><pre><span class="line"># 列举所有配置</span><br><span class="line">$ git config -l</span><br><span class="line"></span><br><span class="line"># 为命令配置别名</span><br><span class="line">$ git config --global alias.co checout</span><br><span class="line">$ git config --global alias.ci commit</span><br><span class="line">$ git config --global alias.st status</span><br><span class="line">$ git config --global alias.br branch</span><br><span class="line"></span><br><span class="line"># 设置提交代码时的用户信息</span><br><span class="line">$ git config --global user.name &quot;your name&quot;</span><br><span class="line">$ git config --global user.email &quot; your email address&quot;</span><br></pre></td></tr></table></figure><h4 id="增删文件"><a href="#增删文件" class="headerlink" title="增删文件"></a>增删文件</h4><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br></pre></td><td class="code"><pre><span class="line"># 添加当前目录的所有文件到暂存区</span><br><span class="line">$ git add .</span><br><span class="line"></span><br><span class="line"># 添加指定文件到暂存区</span><br><span class="line">$ git add &lt;file1&gt; &lt;file2&gt; ...</span><br><span class="line"></span><br><span class="line"># 添加指定目录到暂存区，包括子目录</span><br><span class="line">$ git add &lt;dir&gt;</span><br><span class="line"></span><br><span class="line"># 删除工作区文件，并将这次删除放入暂存区</span><br><span class="line">$ git rm &lt;file1&gt; &lt;file2&gt; ...</span><br><span class="line"></span><br><span class="line"># 停止追踪指定文件，但该文件会保存在工作区</span><br><span class="line">$ git rm --cached &lt;file&gt;</span><br><span class="line"></span><br><span class="line"># 文件改名，并将改名操作放入暂存区</span><br><span class="line">$ git mv &lt;file-original&gt; &lt;file-changed&gt;</span><br></pre></td></tr></table></figure><h4 id="分支相关"><a href="#分支相关" class="headerlink" title="分支相关"></a>分支相关</h4><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"># 列出所有本地分支</span><br><span class="line">$ git branch</span><br><span class="line"></span><br><span class="line"># 列出所有本地分支和远程分支</span><br><span class="line">$ git branch -a</span><br><span class="line"></span><br><span class="line"># 新建分支，但依旧停留在当前分支区域</span><br><span class="line">$ git branch &lt;branch-name&gt;</span><br><span class="line"></span><br><span class="line"># 新建分支，并切换到新建分支(checkout或switch)</span><br><span class="line">$ git checkout/switch -b &lt;branch-name&gt;</span><br><span class="line"></span><br><span class="line"># 切换到指定分支(checkout或switch)</span><br><span class="line">$ git checkout/switch &lt;branch-name&gt;</span><br><span class="line"></span><br><span class="line"># 合并指定分支到当前分支</span><br><span class="line">$ git merge &lt;branch-name&gt;</span><br><span class="line"></span><br><span class="line"># 删除分支</span><br><span class="line">$ git branch -d &lt;branch-name&gt;</span><br></pre></td></tr></table></figure><h4 id="提交相关"><a href="#提交相关" class="headerlink" title="提交相关"></a>提交相关</h4><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"># 提交暂存区到仓库区</span><br><span class="line">$ git commit -m &lt;&quot;your description&quot;&gt;</span><br><span class="line"></span><br><span class="line"># 提交工作区和暂存区变化到仓库去</span><br><span class="line">$ git commit -a</span><br><span class="line"></span><br><span class="line"># 提交时显示所有diff信息</span><br><span class="line">$ git commit -v</span><br><span class="line"></span><br><span class="line"># 提交暂存区修改到仓库去，合并到上次修改，并修改上次提交信息</span><br><span class="line">$ git commit --amend -m &lt;&quot;your description&quot;&gt;</span><br><span class="line"></span><br><span class="line"># 上传本地分支到远程仓库</span><br><span class="line">$ git push origin &lt;branch-name&gt;</span><br></pre></td></tr></table></figure><h4 id="撤销操作"><a href="#撤销操作" class="headerlink" title="撤销操作"></a>撤销操作</h4><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"># 恢复暂存区的指定文件到工作区</span><br><span class="line">$ git checkout -- &lt;file&gt;</span><br><span class="line"></span><br><span class="line"># 恢复暂存区当前目录所有文件到工作区</span><br><span class="line">$ git checkout -- .</span><br><span class="line"></span><br><span class="line"># 重置暂存区指定文件，但与上次commit保持一致，工作区不变</span><br><span class="line">$ git reset &lt;file&gt;</span><br><span class="line"></span><br><span class="line"># 重置暂存区与工作区，HEAD^上一版本，~n上n版本</span><br><span class="line">$ git reset --hard HEAD^</span><br><span class="line">$ git reset --hard HEAD~100</span><br><span class="line">$ git reset HEAD &lt;filename&gt;</span><br><span class="line">$ git reset --hard &lt;commitID&gt;</span><br></pre></td></tr></table></figure><h4 id="查询操作"><a href="#查询操作" class="headerlink" title="查询操作"></a>查询操作</h4><figure class="highlight plain"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br></pre></td><td class="code"><pre><span class="line"># 查看工作区文件修改状态</span><br><span class="line">$ git status</span><br><span class="line"></span><br><span class="line"># 查看工作区文件修改具体内容</span><br><span class="line">$ git diff &lt;file&gt;</span><br><span class="line"></span><br><span class="line"># 查看暂存区文件修改内容</span><br><span class="line">$ git diff --cached &lt;file&gt;</span><br><span class="line"></span><br><span class="line"># 查看版本库修改记录</span><br><span class="line">$ git log</span><br><span class="line"></span><br><span class="line"># 查看命令记录</span><br><span class="line">$ git relog</span><br><span class="line"></span><br><span class="line"># 查看某人提交记录</span><br><span class="line">$ git log --author=someone</span><br><span class="line"></span><br><span class="line"># 查看某个文件的历史具体修改内容</span><br><span class="line">$ git log -p &lt;file&gt;</span><br><span class="line"></span><br><span class="line"># 查看某次提交的具体修改内容</span><br><span class="line">$ git show &lt;commitID&gt;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;Git基础教程&quot;&gt;&lt;a href=&quot;#Git基础教程&quot; class=&quot;headerlink&quot; title=&quot;Git基础教程&quot;&gt;&lt;/a&gt;Git基础教程&lt;/h2&gt;&lt;h3 id=&quot;Git-核心思想&quot;&gt;&lt;a href=&quot;#Git-核心思想&quot; class=&quot;headerlink&quot; title=&quot;Git 核心思想&quot;&gt;&lt;/a&gt;Git 核心思想&lt;/h3&gt;&lt;ul&gt;
&lt;li&gt;工作区(Workspace): 电脑中的实际目录&lt;/li&gt;
&lt;li&gt;暂存区(Index): 类似于缓存区，临时保存改动&lt;/li&gt;
&lt;li&gt;仓库区(Repository): 分为本地和远程仓库&lt;/li&gt;
&lt;li&gt;代码提交步骤: &lt;code&gt;git add&lt;/code&gt;, &lt;code&gt;git commit&lt;/code&gt;, &lt;code&gt;git push&lt;/code&gt;&lt;/li&gt;
&lt;/ul&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Git" scheme="https://zrbac.github.io/tags/Git/"/>
    
  </entry>
  
  <entry>
    <title>Java 设计模式</title>
    <link href="https://zrbac.github.io/2019/11/25/Java-%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F/"/>
    <id>https://zrbac.github.io/2019/11/25/Java-%E8%AE%BE%E8%AE%A1%E6%A8%A1%E5%BC%8F/</id>
    <published>2019-11-25T02:47:05.000Z</published>
    <updated>2019-12-24T12:36:23.110Z</updated>
    
    <content type="html"><![CDATA[<h3 id="Java设计模式"><a href="#Java设计模式" class="headerlink" title="Java设计模式"></a>Java设计模式</h3><h4 id="设计模式简介"><a href="#设计模式简介" class="headerlink" title="设计模式简介"></a>设计模式简介</h4><p><strong>面向对象设计原则</strong></p><ul><li>对接口编程而不是对实现编程</li><li>优先使用对象组合而不是继承</li></ul><p>使用设计模式目的：重用代码、提高代码可靠性。</p><a id="more"></a><p><strong>设计模式类型(23种,三大类)</strong></p><ul><li>创建型模式<ul><li>工厂、抽象工厂、单例、建造者、原型模式</li></ul></li><li>结构型模式<ul><li>适配器、桥接、过滤器、组合、装饰器、外观、享元、代理模式</li></ul></li><li>行为型模式<ul><li>责任链、命令、解释器、迭代器、中介者、备忘录、观察者、状态、空对象、策略、模板、访问者模式</li></ul></li></ul><p><strong>设计模式的六大原则</strong></p><ul><li>开闭原则<ul><li>对扩展开放、对修改关闭</li></ul></li><li>里氏代换原则<ul><li>任何基类可以出现的地方，子类一定可以出现</li></ul></li><li>依赖倒转原则<ul><li>针对接口编程，依赖抽象而不依赖具体</li></ul></li><li>接口隔离原则<ul><li>使用多个隔离的接口，比使用单个接口要好，降低类之间的耦合度</li></ul></li><li>迪米特法则<ul><li>一个实体应当尽量少地与其他实体之间发生相互作用，使系统功能模块相互独立</li></ul></li><li>合成复用原则<ul><li>尽量使用合成/聚合的方式，而不是使用继承</li></ul></li></ul><p><img src="https://user-images.githubusercontent.com/33156501/69926648-4163fd80-14f0-11ea-8165-dc7f52930ba4.jpg" alt="design patterns"></p>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;Java设计模式&quot;&gt;&lt;a href=&quot;#Java设计模式&quot; class=&quot;headerlink&quot; title=&quot;Java设计模式&quot;&gt;&lt;/a&gt;Java设计模式&lt;/h3&gt;&lt;h4 id=&quot;设计模式简介&quot;&gt;&lt;a href=&quot;#设计模式简介&quot; class=&quot;headerlink&quot; title=&quot;设计模式简介&quot;&gt;&lt;/a&gt;设计模式简介&lt;/h4&gt;&lt;p&gt;&lt;strong&gt;面向对象设计原则&lt;/strong&gt;&lt;/p&gt;
&lt;ul&gt;
&lt;li&gt;对接口编程而不是对实现编程&lt;/li&gt;
&lt;li&gt;优先使用对象组合而不是继承&lt;/li&gt;
&lt;/ul&gt;
&lt;p&gt;使用设计模式目的：重用代码、提高代码可靠性。&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>leetcode backtracking</title>
    <link href="https://zrbac.github.io/2019/11/25/leetcode-backtracking/"/>
    <id>https://zrbac.github.io/2019/11/25/leetcode-backtracking/</id>
    <published>2019-11-25T02:05:08.000Z</published>
    <updated>2019-12-24T12:36:23.113Z</updated>
    
    <content type="html"><![CDATA[<h3 id="A-general-approcach-to-backtracking-questions-in-Java"><a href="#A-general-approcach-to-backtracking-questions-in-Java" class="headerlink" title="A general approcach to backtracking questions in Java"></a>A general approcach to backtracking questions in Java</h3><p>This structure might apply to many other backtracking questions,here are just some examples to demonstrate <code>Subsets</code>, <code>Permutations</code>, and <code>Combination Sum</code>.  </p><a id="more"></a><p><code>Subsets</code>:<a href="https://leetcode.com/problems/subsets/" target="_blank" rel="noopener">https://leetcode.com/problems/subsets/</a></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; subsets(<span class="keyword">int</span>[] nums) &#123;</span><br><span class="line">    List&lt;List&lt;Integer&gt;&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    Arrays.sort(nums);</span><br><span class="line">    backtrack(list, <span class="keyword">new</span> ArrayList&lt;&gt;(), nums, <span class="number">0</span>);</span><br><span class="line">    <span class="keyword">return</span> list;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">backtrack</span><span class="params">(List&lt;List&lt;Integer&gt;&gt; list , List&lt;Integer&gt; tempList, <span class="keyword">int</span> [] nums, <span class="keyword">int</span> start)</span></span>&#123;</span><br><span class="line">    list.add(<span class="keyword">new</span> ArrayList&lt;&gt;(tempList));</span><br><span class="line">    <span class="keyword">for</span>(<span class="keyword">int</span> i = start; i &lt; nums.length; i++)&#123;</span><br><span class="line">        tempList.add(nums[i]);</span><br><span class="line">        backtrack(list, tempList, nums, i + <span class="number">1</span>);</span><br><span class="line">        tempList.remove(tempList.size() - <span class="number">1</span>);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><code>Subsets II</code>(contains duplicates): <a href="https://leetcode.com/problems/subsets-ii/" target="_blank" rel="noopener">https://leetcode.com/problems/subsets-ii/</a></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; subsetsWithDup(<span class="keyword">int</span>[] nums) &#123;</span><br><span class="line">    List&lt;List&lt;Integer&gt;&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    Arrays.sort(nums);</span><br><span class="line">    backtrack(list, <span class="keyword">new</span> ArrayList&lt;&gt;(), nums, <span class="number">0</span>);</span><br><span class="line">    <span class="keyword">return</span> list;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">backtrack</span><span class="params">(List&lt;List&lt;Integer&gt;&gt; list, List&lt;Integer&gt; tempList, <span class="keyword">int</span> [] nums, <span class="keyword">int</span> start)</span></span>&#123;</span><br><span class="line">    list.add(<span class="keyword">new</span> ArrayList&lt;&gt;(tempList));</span><br><span class="line">    <span class="keyword">for</span>(<span class="keyword">int</span> i = start; i &lt; nums.length; i++)&#123;</span><br><span class="line">        <span class="keyword">if</span>(i &gt; start &amp;&amp; nums[i] == nums[i-<span class="number">1</span>]) <span class="keyword">continue</span>; <span class="comment">// skip duplicates</span></span><br><span class="line">        tempList.add(nums[i]);</span><br><span class="line">        backtrack(list, tempList, nums, i + <span class="number">1</span>);</span><br><span class="line">        tempList.remove(tempList.size() - <span class="number">1</span>);</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><p><code>Permutations</code>: <a href="https://leetcode.com/problems/permutations/" target="_blank" rel="noopener">https://leetcode.com/problems/permutations/</a></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; permute(<span class="keyword">int</span>[] nums) &#123;</span><br><span class="line">   List&lt;List&lt;Integer&gt;&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">   <span class="comment">// Arrays.sort(nums); // not necessary</span></span><br><span class="line">   backtrack(list, <span class="keyword">new</span> ArrayList&lt;&gt;(), nums);</span><br><span class="line">   <span class="keyword">return</span> list;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">backtrack</span><span class="params">(List&lt;List&lt;Integer&gt;&gt; list, List&lt;Integer&gt; tempList, <span class="keyword">int</span> [] nums)</span></span>&#123;</span><br><span class="line">   <span class="keyword">if</span>(tempList.size() == nums.length)&#123;</span><br><span class="line">      list.add(<span class="keyword">new</span> ArrayList&lt;&gt;(tempList));</span><br><span class="line">   &#125; <span class="keyword">else</span>&#123;</span><br><span class="line">      <span class="keyword">for</span>(<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; nums.length; i++)&#123; </span><br><span class="line">         <span class="keyword">if</span>(tempList.contains(nums[i])) <span class="keyword">continue</span>; <span class="comment">// element already exists, skip</span></span><br><span class="line">         tempList.add(nums[i]);</span><br><span class="line">         backtrack(list, tempList, nums);</span><br><span class="line">         tempList.remove(tempList.size() - <span class="number">1</span>);</span><br><span class="line">      &#125;</span><br><span class="line">   &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><code>Permutations II</code>(contains duplicates):<a href="https://leetcode.com/problems/permutations-ii/" target="_blank" rel="noopener">https://leetcode.com/problems/permutations-ii/</a></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; permuteUnique(<span class="keyword">int</span>[] nums) &#123;</span><br><span class="line">    List&lt;List&lt;Integer&gt;&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    Arrays.sort(nums);</span><br><span class="line">    backtrack(list, <span class="keyword">new</span> ArrayList&lt;&gt;(), nums, <span class="keyword">new</span> <span class="keyword">boolean</span>[nums.length]);</span><br><span class="line">    <span class="keyword">return</span> list;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">backtrack</span><span class="params">(List&lt;List&lt;Integer&gt;&gt; list, List&lt;Integer&gt; tempList, <span class="keyword">int</span> [] nums, <span class="keyword">boolean</span> [] used)</span></span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(tempList.size() == nums.length)&#123;</span><br><span class="line">        list.add(<span class="keyword">new</span> ArrayList&lt;&gt;(tempList));</span><br><span class="line">    &#125; <span class="keyword">else</span>&#123;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; nums.length; i++)&#123;</span><br><span class="line">            <span class="keyword">if</span>(used[i] || i &gt; <span class="number">0</span> &amp;&amp; nums[i] == nums[i-<span class="number">1</span>] &amp;&amp; !used[i - <span class="number">1</span>]) <span class="keyword">continue</span>;</span><br><span class="line">            used[i] = <span class="keyword">true</span>; </span><br><span class="line">            tempList.add(nums[i]);</span><br><span class="line">            backtrack(list, tempList, nums, used);</span><br><span class="line">            used[i] = <span class="keyword">false</span>; </span><br><span class="line">            tempList.remove(tempList.size() - <span class="number">1</span>);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><p><code>Combination Sum</code>:<a href="https://leetcode.com/problems/combination-sum/" target="_blank" rel="noopener">https://leetcode.com/problems/combination-sum/</a></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; combinationSum(<span class="keyword">int</span>[] nums, <span class="keyword">int</span> target) &#123;</span><br><span class="line">    List&lt;List&lt;Integer&gt;&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    Arrays.sort(nums);</span><br><span class="line">    backtrack(list, <span class="keyword">new</span> ArrayList&lt;&gt;(), nums, target, <span class="number">0</span>);</span><br><span class="line">    <span class="keyword">return</span> list;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">backtrack</span><span class="params">(List&lt;List&lt;Integer&gt;&gt; list, List&lt;Integer&gt; tempList, <span class="keyword">int</span> [] nums, <span class="keyword">int</span> remain, <span class="keyword">int</span> start)</span></span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(remain &lt; <span class="number">0</span>) <span class="keyword">return</span>;</span><br><span class="line">    <span class="keyword">else</span> <span class="keyword">if</span>(remain == <span class="number">0</span>) list.add(<span class="keyword">new</span> ArrayList&lt;&gt;(tempList));</span><br><span class="line">    <span class="keyword">else</span>&#123; </span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = start; i &lt; nums.length; i++)&#123;</span><br><span class="line">            tempList.add(nums[i]);</span><br><span class="line">            backtrack(list, tempList, nums, remain - nums[i], i); <span class="comment">// not i + 1 because we can reuse same elements</span></span><br><span class="line">            tempList.remove(tempList.size() - <span class="number">1</span>);</span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><p><code>Combination Sum II</code>(can’t reuse same element):<a href="https://leetcode.com/problems/combination-sum-ii/" target="_blank" rel="noopener">https://leetcode.com/problems/combination-sum-ii/</a></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;Integer&gt;&gt; combinationSum2(<span class="keyword">int</span>[] nums, <span class="keyword">int</span> target) &#123;</span><br><span class="line">    List&lt;List&lt;Integer&gt;&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">    Arrays.sort(nums);</span><br><span class="line">    backtrack(list, <span class="keyword">new</span> ArrayList&lt;&gt;(), nums, target, <span class="number">0</span>);</span><br><span class="line">    <span class="keyword">return</span> list;</span><br><span class="line">    </span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">private</span> <span class="keyword">void</span> <span class="title">backtrack</span><span class="params">(List&lt;List&lt;Integer&gt;&gt; list, List&lt;Integer&gt; tempList, <span class="keyword">int</span> [] nums, <span class="keyword">int</span> remain, <span class="keyword">int</span> start)</span></span>&#123;</span><br><span class="line">    <span class="keyword">if</span>(remain &lt; <span class="number">0</span>) <span class="keyword">return</span>;</span><br><span class="line">    <span class="keyword">else</span> <span class="keyword">if</span>(remain == <span class="number">0</span>) list.add(<span class="keyword">new</span> ArrayList&lt;&gt;(tempList));</span><br><span class="line">    <span class="keyword">else</span>&#123;</span><br><span class="line">        <span class="keyword">for</span>(<span class="keyword">int</span> i = start; i &lt; nums.length; i++)&#123;</span><br><span class="line">            <span class="keyword">if</span>(i &gt; start &amp;&amp; nums[i] == nums[i-<span class="number">1</span>]) <span class="keyword">continue</span>; <span class="comment">// skip duplicates</span></span><br><span class="line">            tempList.add(nums[i]);</span><br><span class="line">            backtrack(list, tempList, nums, remain - nums[i], i + <span class="number">1</span>);</span><br><span class="line">            tempList.remove(tempList.size() - <span class="number">1</span>); </span><br><span class="line">        &#125;</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure><hr><p><code>Palindrome Partitioning</code>:<a href="https://leetcode.com/problems/palindrome-partitioning/" target="_blank" rel="noopener">https://leetcode.com/problems/palindrome-partitioning/</a></p><figure class="highlight java"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">public</span> List&lt;List&lt;String&gt;&gt; partition(String s) &#123;</span><br><span class="line">   List&lt;List&lt;String&gt;&gt; list = <span class="keyword">new</span> ArrayList&lt;&gt;();</span><br><span class="line">   backtrack(list, <span class="keyword">new</span> ArrayList&lt;&gt;(), s, <span class="number">0</span>);</span><br><span class="line">   <span class="keyword">return</span> list;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">void</span> <span class="title">backtrack</span><span class="params">(List&lt;List&lt;String&gt;&gt; list, List&lt;String&gt; tempList, String s, <span class="keyword">int</span> start)</span></span>&#123;</span><br><span class="line">   <span class="keyword">if</span>(start == s.length())</span><br><span class="line">      list.add(<span class="keyword">new</span> ArrayList&lt;&gt;(tempList));</span><br><span class="line">   <span class="keyword">else</span>&#123;</span><br><span class="line">      <span class="keyword">for</span>(<span class="keyword">int</span> i = start; i &lt; s.length(); i++)&#123;</span><br><span class="line">         <span class="keyword">if</span>(isPalindrome(s, start, i))&#123;</span><br><span class="line">            tempList.add(s.substring(start, i + <span class="number">1</span>));</span><br><span class="line">            backtrack(list, tempList, s, i + <span class="number">1</span>);</span><br><span class="line">            tempList.remove(tempList.size() - <span class="number">1</span>);</span><br><span class="line">         &#125;</span><br><span class="line">      &#125;</span><br><span class="line">   &#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="function"><span class="keyword">public</span> <span class="keyword">boolean</span> <span class="title">isPalindrome</span><span class="params">(String s, <span class="keyword">int</span> low, <span class="keyword">int</span> high)</span></span>&#123;</span><br><span class="line">   <span class="keyword">while</span>(low &lt; high)</span><br><span class="line">      <span class="keyword">if</span>(s.charAt(low++) != s.charAt(high--)) <span class="keyword">return</span> <span class="keyword">false</span>;</span><br><span class="line">   <span class="keyword">return</span> <span class="keyword">true</span>;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]></content>
    
    <summary type="html">
    
      &lt;h3 id=&quot;A-general-approcach-to-backtracking-questions-in-Java&quot;&gt;&lt;a href=&quot;#A-general-approcach-to-backtracking-questions-in-Java&quot; class=&quot;headerlink&quot; title=&quot;A general approcach to backtracking questions in Java&quot;&gt;&lt;/a&gt;A general approcach to backtracking questions in Java&lt;/h3&gt;&lt;p&gt;This structure might apply to many other backtracking questions,here are just some examples to demonstrate &lt;code&gt;Subsets&lt;/code&gt;, &lt;code&gt;Permutations&lt;/code&gt;, and &lt;code&gt;Combination Sum&lt;/code&gt;.  &lt;/p&gt;
    
    </summary>
    
    
      <category term="leetcode" scheme="https://zrbac.github.io/categories/leetcode/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>Java学习路线</title>
    <link href="https://zrbac.github.io/2019/11/23/Java%E5%AD%A6%E4%B9%A0%E8%B7%AF%E7%BA%BF/"/>
    <id>https://zrbac.github.io/2019/11/23/Java%E5%AD%A6%E4%B9%A0%E8%B7%AF%E7%BA%BF/</id>
    <published>2019-11-23T09:03:05.000Z</published>
    <updated>2020-06-01T11:12:07.819Z</updated>
    
    <content type="html"><![CDATA[<h1 id="Java学习路线"><a href="#Java学习路线" class="headerlink" title="Java学习路线"></a>Java学习路线</h1><h2 id="基础知识"><a href="#基础知识" class="headerlink" title="基础知识"></a>基础知识</h2><ul><li>编程语言: Java Python C</li><li>基本语法</li><li>基本设计模式</li><li>基本网络知识: TCP/IP (4层-应用层、传输层、网络层、网络接口层)<br>HTTP/HTTPS(7层-应用层、表示层、会话层、传输层、网络层、数据链路层、物理层)   </li></ul><hr><a id="more"></a><h2 id="工具方面"><a href="#工具方面" class="headerlink" title="工具方面"></a>工具方面</h2><ul><li>操作系统: Linux(CentOS\Ubuntu\Fedora…)</li><li>代码管理: SVN/Git</li><li>持续集成(CI/CD): jenkins</li><li>Java的项目管理工具: Maven/Gradle</li></ul><hr><h2 id="框架方面"><a href="#框架方面" class="headerlink" title="框架方面"></a>框架方面</h2><h4 id="应用层框架"><a href="#应用层框架" class="headerlink" title="应用层框架"></a>应用层框架</h4><ul><li><del>ssh: spring + struct + hibernate</del></li><li>ssm: spring + springmvc + mybatis</li><li>spring boot</li></ul><hr><h4 id="各种中间件"><a href="#各种中间件" class="headerlink" title="各种中间件"></a>各种中间件</h4><ul><li>MQ 消息队列</li><li>RPC 通信框架 gRPC thrit dubbo springcloud</li><li>elesticsearch 数据库 搜索引擎</li></ul><hr><h4 id="数据库"><a href="#数据库" class="headerlink" title="数据库"></a>数据库</h4><ul><li>SQL: MySQL/Postgre SQL</li><li>NoSQL: Redis Memcached mongodb elasticsearch</li></ul><hr><h2 id="架构方面"><a href="#架构方面" class="headerlink" title="架构方面"></a>架构方面</h2><h4 id="分布式-微服务架构"><a href="#分布式-微服务架构" class="headerlink" title="分布式/微服务架构"></a>分布式/微服务架构</h4><ul><li>spring cloud</li><li>dubbo</li><li>rpc通信</li></ul><h4 id="虚拟化-容器化技术"><a href="#虚拟化-容器化技术" class="headerlink" title="虚拟化/容器化技术"></a>虚拟化/容器化技术</h4><ul><li>Docker容器化</li><li>k8s kubernetes</li></ul><hr><h2 id="关注源码-性能"><a href="#关注源码-性能" class="headerlink" title="关注源码/性能"></a>关注源码/性能</h2><ul><li>JDK源码以及部分设计思想</li><li>Spring源码</li><li>JVM 细节与排错</li><li>高并发/高可用</li></ul><p><img src="blog_images/java-path.jpg" alt="java_path"></p>]]></content>
    
    <summary type="html">
    
      &lt;h1 id=&quot;Java学习路线&quot;&gt;&lt;a href=&quot;#Java学习路线&quot; class=&quot;headerlink&quot; title=&quot;Java学习路线&quot;&gt;&lt;/a&gt;Java学习路线&lt;/h1&gt;&lt;h2 id=&quot;基础知识&quot;&gt;&lt;a href=&quot;#基础知识&quot; class=&quot;headerlink&quot; title=&quot;基础知识&quot;&gt;&lt;/a&gt;基础知识&lt;/h2&gt;&lt;ul&gt;
&lt;li&gt;编程语言: Java Python C&lt;/li&gt;
&lt;li&gt;基本语法&lt;/li&gt;
&lt;li&gt;基本设计模式&lt;/li&gt;
&lt;li&gt;基本网络知识: TCP/IP (4层-应用层、传输层、网络层、网络接口层)&lt;br&gt;HTTP/HTTPS(7层-应用层、表示层、会话层、传输层、网络层、数据链路层、物理层)   &lt;/li&gt;
&lt;/ul&gt;
&lt;hr&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Java" scheme="https://zrbac.github.io/tags/Java/"/>
    
  </entry>
  
  <entry>
    <title>Linux学习笔记</title>
    <link href="https://zrbac.github.io/2019/09/23/Linux%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    <id>https://zrbac.github.io/2019/09/23/Linux%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/</id>
    <published>2019-09-23T01:07:49.000Z</published>
    <updated>2020-09-06T11:18:25.987Z</updated>
    
    <content type="html"><![CDATA[<h2 id="Linux常用命令"><a href="#Linux常用命令" class="headerlink" title="Linux常用命令"></a>Linux常用命令</h2><h3 id="文件处理命令"><a href="#文件处理命令" class="headerlink" title="文件处理命令"></a>文件处理命令</h3><hr><blockquote><p>ls       // *list 显示目录文件</p><p>ls -a  // *显示所有文件，包括隐藏文件</p><p>ls -l   // *详细信息显示</p><p>ls -d  // *查看目录属性</p></blockquote><p>文件类型说明</p><a id="more"></a><blockquote><p>-rw-r–r–  // *-开头代表文件 d为目录 l为软连接文件</p><p>rw- r– r–  // *每三位是一个组别，依次为 u所有者 g所属组 o其他人</p><p>-rw-r–r–   // *r(read)表示读权限 w(write)写 权限 x(execute)执行权限</p></blockquote><hr><blockquote><p>mkdir [目录]    // *make directiories 创建目录</p><p>mkdir -p [目录] // *递归创建目录</p><p>rmdir [目录]   // *remove empty directories 删除空目录</p><p>rm -rf [文件或目录] // *remove 删除文件 -r删除目录 -f强制执行</p></blockquote><hr><blockquote><p>pwd // print working directory 显示当前目录</p><p>cd [目录]    // change directory 切换目录</p><p>cp -rp [原文件或目录] [目标目录]  // copy 复制文件或目录 -r复制目录 -p保留属性</p><p>mv [原文件或目录] [目标目录/新名称]  // move 剪切文件、改名</p></blockquote>]]></content>
    
    <summary type="html">
    
      &lt;h2 id=&quot;Linux常用命令&quot;&gt;&lt;a href=&quot;#Linux常用命令&quot; class=&quot;headerlink&quot; title=&quot;Linux常用命令&quot;&gt;&lt;/a&gt;Linux常用命令&lt;/h2&gt;&lt;h3 id=&quot;文件处理命令&quot;&gt;&lt;a href=&quot;#文件处理命令&quot; class=&quot;headerlink&quot; title=&quot;文件处理命令&quot;&gt;&lt;/a&gt;文件处理命令&lt;/h3&gt;&lt;hr&gt;
&lt;blockquote&gt;
&lt;p&gt;ls       // *list 显示目录文件&lt;/p&gt;
&lt;p&gt;ls -a  // *显示所有文件，包括隐藏文件&lt;/p&gt;
&lt;p&gt;ls -l   // *详细信息显示&lt;/p&gt;
&lt;p&gt;ls -d  // *查看目录属性&lt;/p&gt;
&lt;/blockquote&gt;
&lt;p&gt;文件类型说明&lt;/p&gt;
    
    </summary>
    
    
      <category term="学习笔记" scheme="https://zrbac.github.io/categories/%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/"/>
    
    
      <category term="Linux" scheme="https://zrbac.github.io/tags/Linux/"/>
    
  </entry>
  
</feed>